python使用request和re爬取百度资讯
AI 摘要salmon-ai
本文详细解析
教程
首先安装所需的依赖包
sh
pip install request -i https://pypi.tuna.tsinghua.edu.cn/simple 我们可以先看看百度资讯的标签是怎样设计的,打开百度资讯,我这里搜索了特斯拉,链接:https://www.baidu.com/s?ie=utf-8&medium=0&rtt=1&bsst=1&rsv_dl=news_t_sk&cl=2&wd=%E7%89%B9%E6%96%AF%E6%8B%89&tn=news&rsv_bp=1&rsv_sug3=1&rsv_sug1=1&rsv_sug7=100&rsv_sug2=0&oq=&rsv_btype=t&f=8&inputT=6&rsv_sug4=688,可以看到请求路径携带了挺多参数,我们只需要一些必要的参数,如:rtt、bsst、tn、wd等。下面本文主要爬取的标签代码
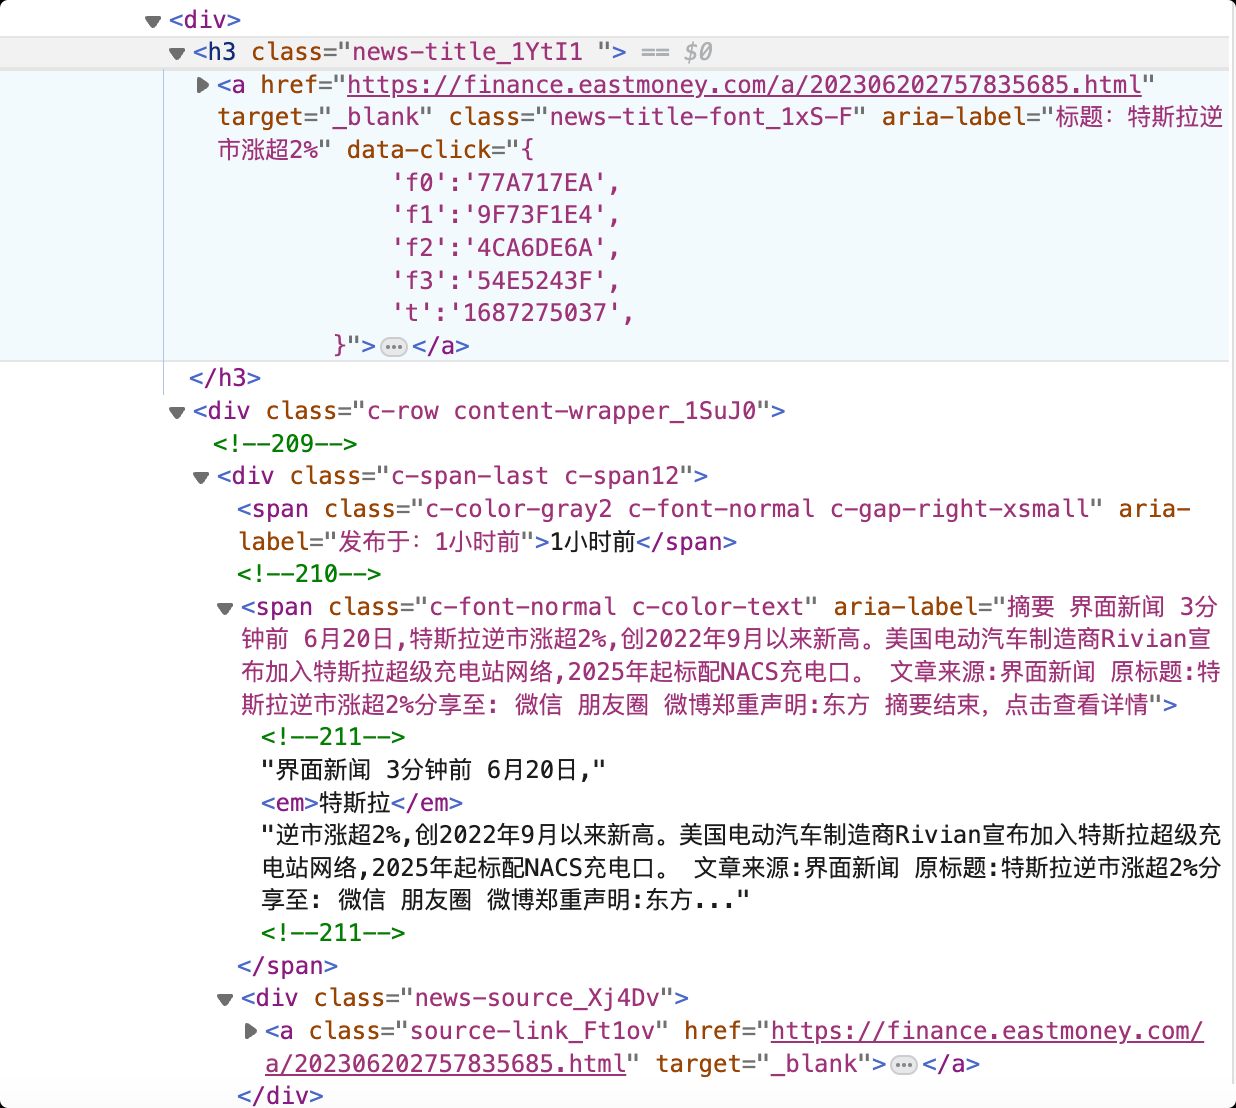
我们根据标签,开始写代码,主要利用正则匹配来找到相应的标签并获取内容,和去除无用的信息
python
import requests
import re

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36'
}


# 爬取方法
def baidu(keyword):
    url = 'http://www.baidu.com/s'
    params = {
        'tn': 'news',
        'rtt': '4', # rtt参数换成4即是按时间排序,默认为1按焦点排序
        'bsst': '1',
        'cl': '2',
        'wd': keyword,
    }
    res = requests.get(url, params=params, headers=headers).text

    p_href = '<h3 class="news-title_1YtI1 "><a href="(.*?)"'
    href = re.findall(p_href, res, re.S)
    p_title = '<h3 class="news-title_1YtI1 ">.*?>(.*?)</a>'
    title = re.findall(p_title, res, re.S)
    p_date = '<span class="c-color-gray2 c-font-normal c-gap-right-xsmall" .*?>(.*?)</span>'
    date = re.findall(p_date, res)
    p_content = '<span class="c-font-normal c-color-text" .*?>(.*?)</span>'
    content = re.findall(p_content, res)
    p_source = '<span class="c-color-gray" .*?>(.*?)</span>'
    source = re.findall(p_source, res)

    for i in range(len(title)):
 	# strip()函数用来取消字符串两端的换行或者空格
        title[i] = title[i].strip()
	# 用re.sub()函数来替换不重要的内容
        title[i] = re.sub('<.*?>', '', title[i])
        content[i] = re.sub('<.*?>', '', content[i])
        print(str(i + 1) + '.' + title[i] + '(' + date[i] + '-' + source[i] + ')')
        print(content[i])
        print(href[i])


# 根据关键字爬取
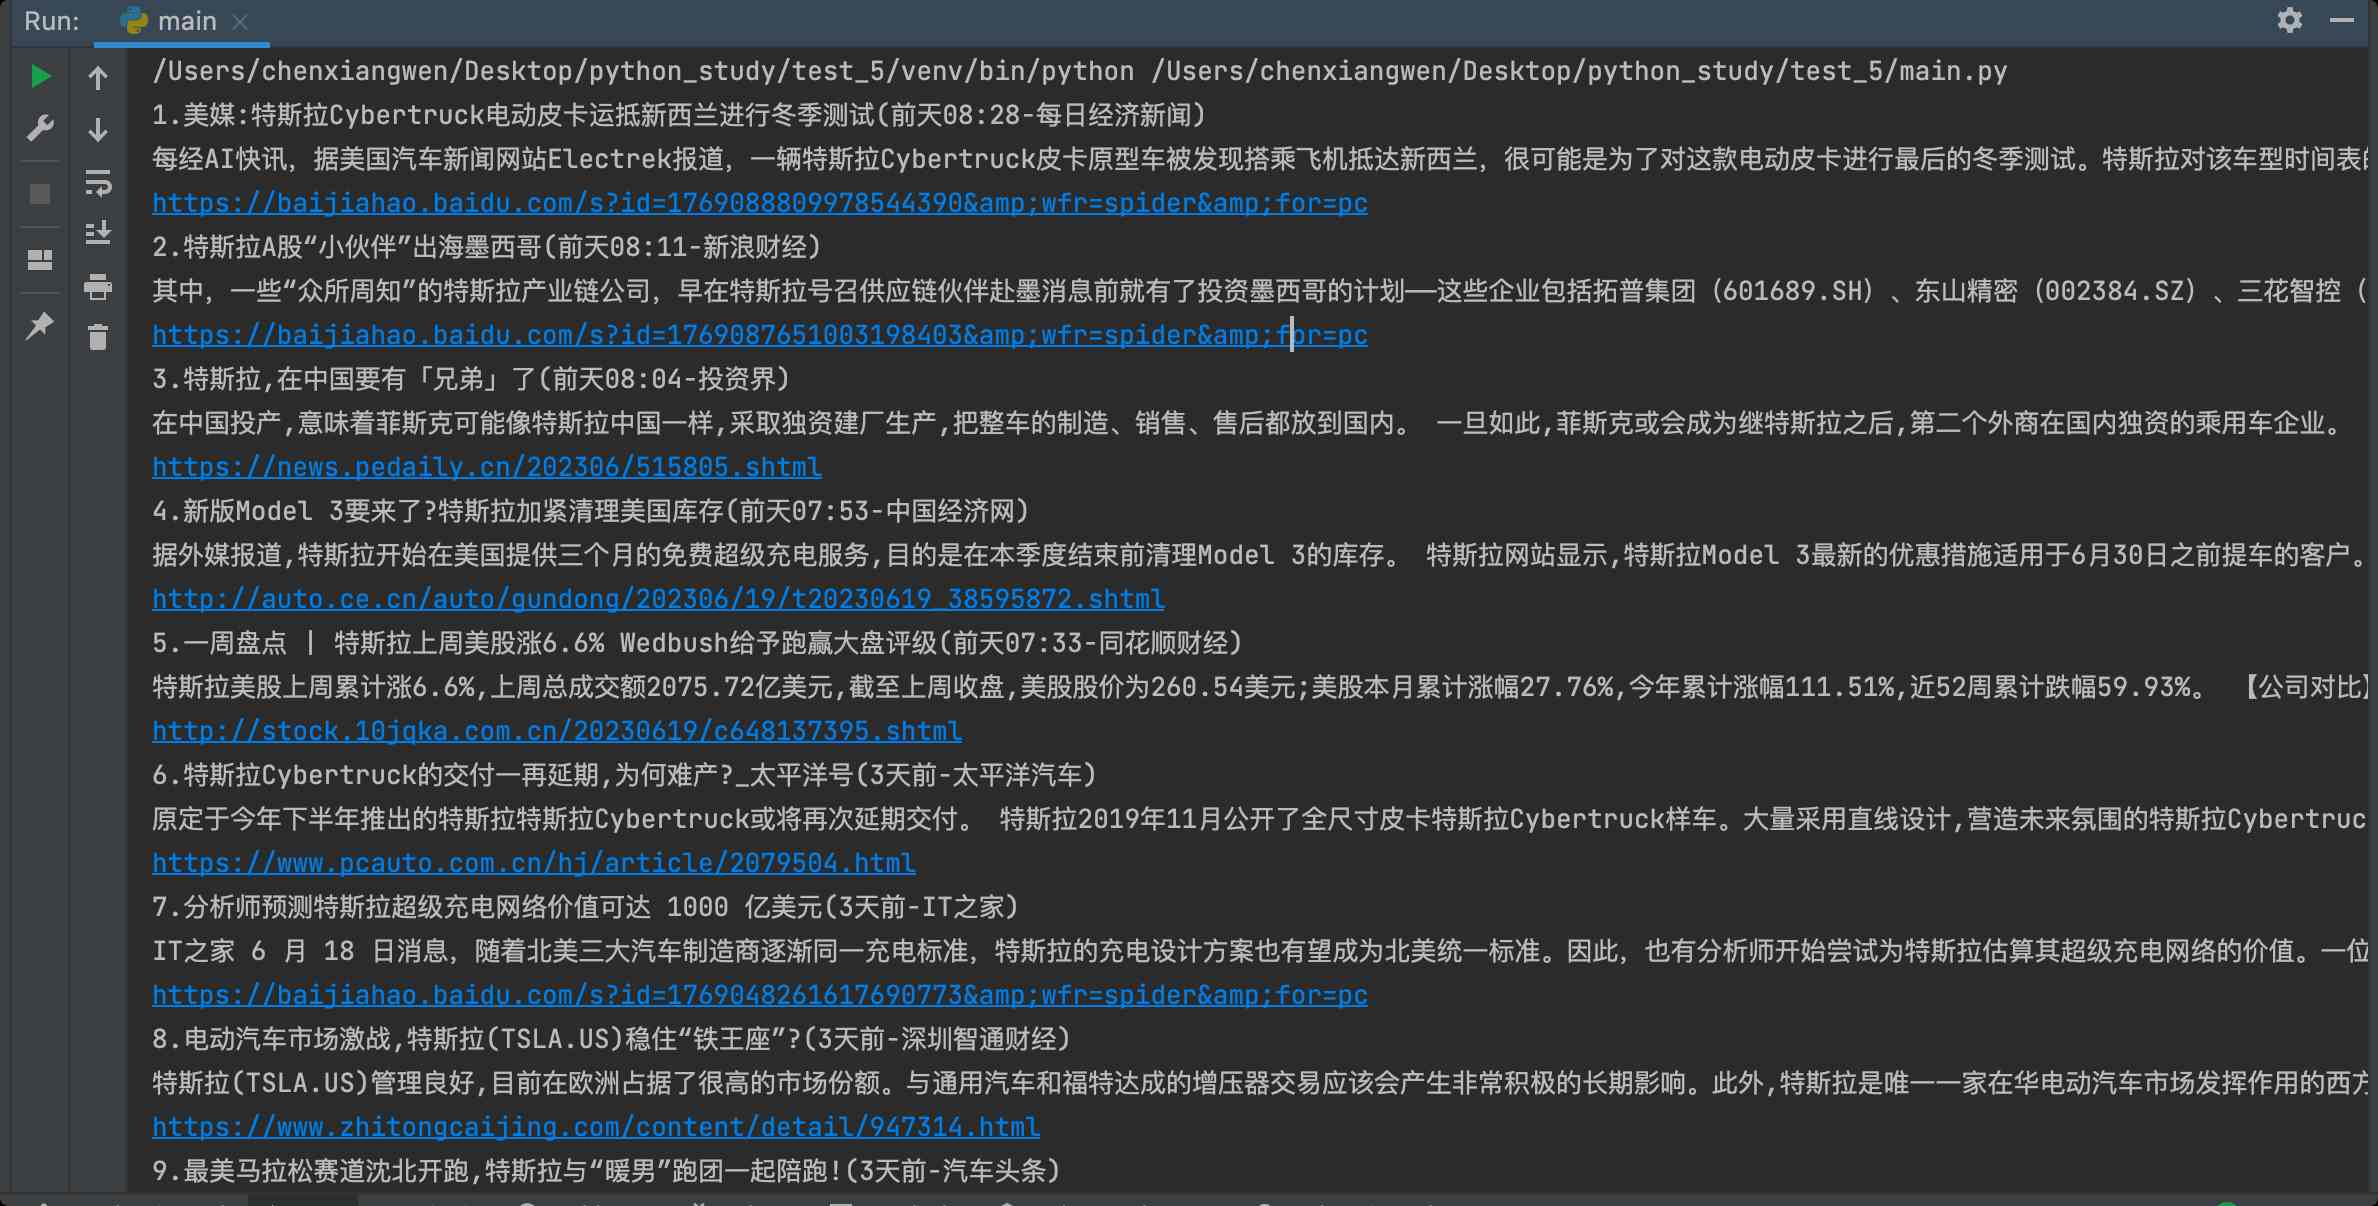
baidu('特斯拉')可以看到成功爬取到相关文章啦
评论
0 条—
还没有评论,来说第一句