哈夫曼树的实现
AI 摘要鱼粮不足,AI 今天先歇着 · 正文在下面
一、概念
哈夫曼树 通常以二叉树的形式出现,所以也称 最优二叉树,是一类带权路径长度最短的树。
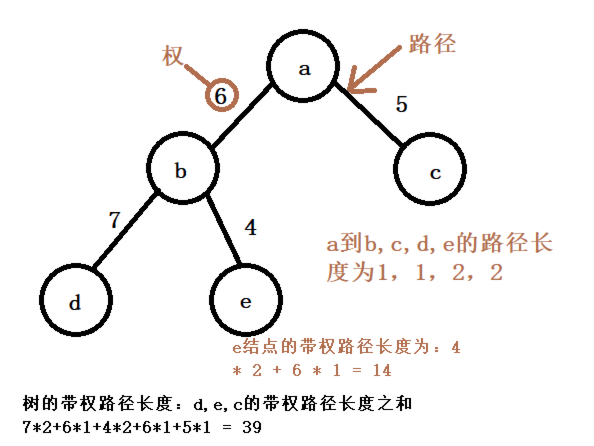
- 路径:从树中的一个结点到另一个结点之间的分支构成这两点之间的路径
- 路径长度:路径上的分支数目称作路径长度
- 树的路径长度:从树根到每一个结点的路径长度之和
- 权:赋予某个实体的一个量
- 结点的带权路径长度:从该结点到树根之间的路径长度与结点上权的乘积
- 树的带权路径长度:树中所有叶子结点的带权路径长度之和
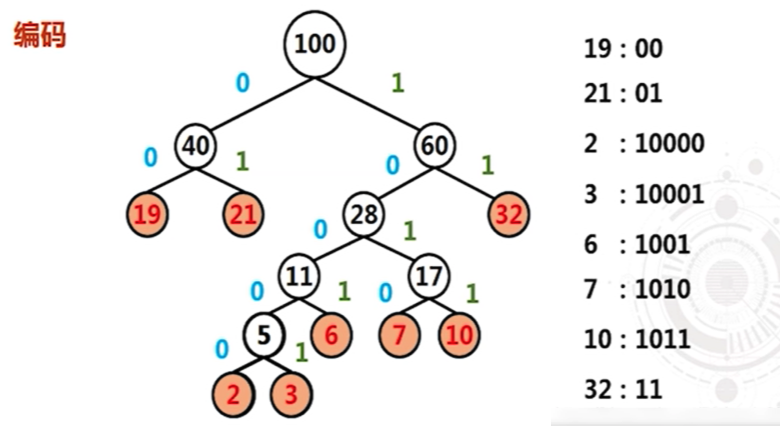
哈夫曼编码,又称霍夫曼编码,是一种编码方式,可变字长编码(VLC)的一种。Huffman 于1952年提出一种编码方法,该方法完全依据字符出现概率来构造异字头的平均长度最短的码字,有时称之为最佳编码,一般就叫做 Huffman 编码(有时也称为霍夫曼编码)。
设待处理的字符集为: C = {c1, c2, ... cn},字符对应的频率集为: W = {w1, w2, ... wn},则哈夫曼编码的流程如下:
- 将
字符集C作为叶子节点; - 将
频率集W作为叶子节点的权值; - 使用
C和W构造哈夫曼树; - 对哈夫曼树的所有分支,左子树分支编码为
0,右子树分支编码为1;
可以看看参考示例图:
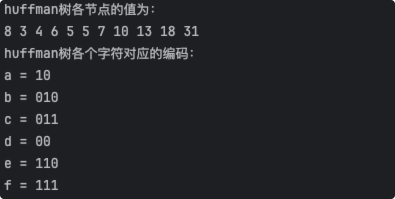
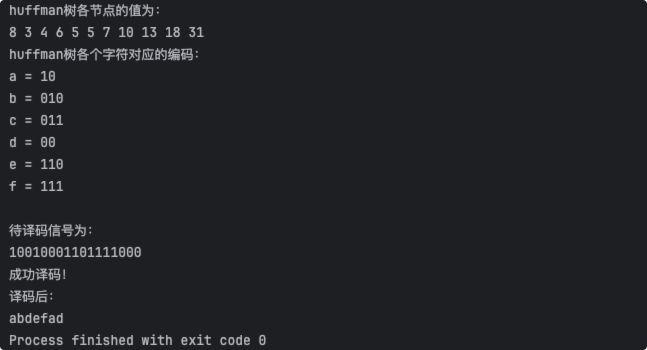
译码,是指将经过哈夫曼编码后的字符进行译码。如:a = 10,b = 010,c = 011,d = 00,e = 110,f = 111,编码后的串为:10010001101111000,则译码后的字符为:abdefad。
译码步骤:从 Huffman树 根开始,从待译码电文中逐位取码。若编码是“0”,则向左走;若编码是“1”,则向右走,一旦到达叶子结点,则译出一个字符;再重新从根出发,直到电文结束。
二、构造哈夫曼树
首先我们创建一个头文件,名为 huffmanTree.h,然后在文件里边,我们定义哈夫曼树的结构体
c++
#include <cstdio>
#include <cfloat>

typedef struct {
    char data;         //节点值
    double weight;    //权值域
    int parent, lchild, rchild;
} HTNode;
定义创建哈夫曼树的函数
c++
void SelectMin(HTNode *HT, int n, int &left, int &right);

/**
 * 创建哈夫曼树
 * @param HT 叶子结点数组
 * @param nums 叶子结点数量
 */
void CreateHT(HTNode *HT, int nums) {
    int i, left = -1, right = -1;
    // 哈夫曼树的所有结点数
    int m = 2 * nums - 1;
    // 初始化后边的每个结点
    for (i = 0; i < m; i++) {
        HT[i].parent = HT[i].lchild = HT[i].rchild = -1;
    }
    // 寻找孩子结点,并标记其父节点
    for (i = nums; i < m; i++) {
        HT[i].weight = 0;
        // 查找 0到 i 之间 parent=0且权值最小的两个结点
        SelectMin(HT, i + 1, left, right);
        HT[i].weight = HT[left].weight + HT[right].weight;
        HT[left].parent = i;
        HT[right].parent = i;
        HT[i].lchild = left;
        HT[i].rchild = right;
    }
}

/**
 * 寻找当前结点的孩子结点
 * @param HT 当前结点数组
 * @param n 当前需检索的结点数量
 * @param left 左孩子结点下标
 * @param right 右孩子结点下标
 */
void SelectMin(HTNode *HT, int n, int &left, int &right) {
    double min1, min2;
    min1 = min2 = DBL_MAX;

    for (int i = 0; i < n; i++) {
        double current = HT[i].weight;
        if (current != 0 && HT[i].parent == -1) {
            if (current < min1) {
                min2 = min1;
                left = i;
                min1 = current;
            } else if (current < min2) {
                right = i;
                min2 = current;
            }
        }
    }
}定义打印结点权值函数
c++
// 打印哈夫曼树各结点的权值
void DispTreeWeight(HTNode *HT, int n) {
    printf("huffman树各结点的值为:\n");
    for (int i = 0; i < 2 * n - 1; i++) {
        printf("%.f ", HT[i].weight);
    }
    printf("\n");
}
测试
c++
#include "huffmanTree.h"

int main() {
    int w[] = {8, 3, 4, 6, 5, 5};
    char c[] = {'a', 'b', 'c', 'd', 'e', 'f'};
    int nums = 6;
    HTNode HT[2 * nums - 1];  //哈夫曼树结点数组
    for (int i = 0; i < nums; i++) {
        HT[i].weight = w[i];
        HT[i].data = c[i];
    }
    CreateHT(HT, nums); //创建哈夫曼树
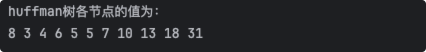
    DispTreeWeight(HT, nums); //打印哈夫曼树各节点值
    return 0;
}
三、哈夫曼树的编码
定义哈夫曼编码结点类型
c++
#define N 10
typedef struct {
    char cd[N];  //存放当前节点的哈夫曼码
    int start;   //存放哈夫曼码在cd中的起始位置
} HCode;    //哈夫曼编码结点类型
定义构建哈夫曼编码函数
c++
/**
 * 构建哈夫曼编码
 * @param HT 节点数组
 * @param HC 哈夫曼编码数组
 * @param n  叶子结点数量
 */
void CreateHCode(HTNode *HT, HCode *HC, int n) {
    int cpIndex;
    for (int i = 0; i < n; i++) {
        // 当前待处理的孩子结点
        int child = i;
        HCode hc;
        hc.start = n;
        cpIndex = HT[i].parent;
        // 判断是否到达根结点,从下往上找
        while (cpIndex != 0) {
            HTNode p = HT[cpIndex];
            // 判断当前结点是父结点的左结点还是右结点
            if (p.lchild == child) {
                hc.cd[hc.start--] = '0';
            } else if (p.rchild == child) {
                hc.cd[hc.start--] = '1';
            }
            // 下一次判断的孩子结点为当前的父节点
            child = cpIndex;
            // 记录下一次结点的父节点下标
            cpIndex = p.parent;
        }
        // 由于最后一次找到后也--了,故将当前 start 加1进行回退
        hc.start++;
        HC[i] = hc;
    }
}定义打印哈夫曼树每个结点的编码函数
c++
/**
 * 打印各节点的哈夫曼编码
 * @param HC
 * @param n
 */
void PrintHCode(HCode *HC, char *c, int n) {
    printf("huffman树各个字符对应的编码:\n");
    for (int i = 0; i < n; i++) {
        printf("%c = ", c[i]);
        HCode hc = HC[i];
        for (int j = hc.start; j <= n; j++) {
            printf("%c", hc.cd[j]);
        }
        printf("\n");
    }
    printf("\n");
}测试
c++
int main() {
    int w[] = {8, 3, 4, 6, 5, 5};
    char c[] = {'a', 'b', 'c', 'd', 'e', 'f'};
    int nums = 6;
    HTNode HT[2 * nums - 1];  //哈夫曼树结点数组
    for (int i = 0; i < nums; i++) {
        HT[i].weight = w[i];
        HT[i].data = c[i];
    }
    CreateHT(HT, nums); //创建哈夫曼树
    DispTreeWeight(HT, nums); //打印哈夫曼树各节点值

    HCode HC[nums];
    CreateHCode(HT, HC, nums); //构建哈夫曼编码
    PrintHCode(HC, c, nums); // 打印各节点的哈夫曼编码
    return 0;
}
四、对输入信号进行译码
定义译码函数
c++
/**
 * 译码
 * @param code 待处理信号
 * @param HT 哈夫曼树
 * @param Decode
 * @param nums
 * @return
 */
bool EnHCode(char *code, HTNode *HT, char *Decode, int nums) {
    // i用于移动待译码的字符串下标,j 用于移动译码后的数组下标
    int i = 0;
    while (*code != '\0') {
        // 每运算一个字符重新从根节点查找
        HTNode root = HT[nums * 2 - 2];
        // 判断是否到达叶子结点
        while (root.rchild != -1 && root.lchild != -1) {
            // 判断当前是往左还是右走
            if (*code == '0') {
                root = HT[root.lchild];
            } else if (*code == '1') {
                root = HT[root.rchild];
            }
            ++code;
        }
        // 存储译码后的字符
        Decode[i++] = root.data;
    }
    // 用于结束当前的译码,防止溢出
    Decode[i] = '\0';
    return true;
}测试
c++
int main() {
    int w[] = {8, 3, 4, 6, 5, 5};
    char c[] = {'a', 'b', 'c', 'd', 'e', 'f'};
    int nums = 6;
    HTNode HT[2 * nums - 1];  //哈夫曼树结点数组
    for (int i = 0; i < nums; i++) {
        HT[i].weight = w[i];
        HT[i].data = c[i];
    }
    CreateHT(HT, nums); //创建哈夫曼树
    DispTreeWeight(HT, nums); //打印哈夫曼树各节点值

    HCode HC[nums];
    CreateHCode(HT, HC, nums); //构建哈夫曼编码
    PrintHCode(HC, c, nums); // 打印各节点的哈夫曼编码

    char code[] = "10010001101111000"; //abdefad
    printf("待译码信号为:\n");
    for (int k = 0; code[k] != '\0'; k++) {
        printf("%c", code[k]);
    }
    char DeCode[20]; //保存译码后的字符串
    if (EnHCode(code, HT, DeCode, nums)) {
        printf("\n成功译码!\n");
        printf("译码后:\n");
        int i = 0;
        while (DeCode[i] != '\0') {
            printf("%c", DeCode[i]);
            i++;
        }
    } else {
        printf("\n代码错误!");
    }
    return 0;
}
评论
0 条—
还没有评论,来说第一句