L2-007 家庭房产(Java)
AI 摘要salmon-ai
本文详细解析了 PAT L2-007“家庭房产”这道题的并查集解法:先
问题
给定每个人的家庭成员和其自己名下的房产,请你统计出每个家庭的人口数、人均房产面积及房产套数。
输入格式:
输入第一行给出一个正整数,随后行,每行按下列格式给出一个人的房产:
sh
编号 父 母 k 孩子1 ... 孩子k 房产套数 总面积其中编号是每个人独有的一个4位数的编号;父和母分别是该编号对应的这个人的父母的编号(如果已经过世,则显示-1);k是该人的子女的个数;孩子i是其子女的编号。
输出格式:
首先在第一行输出家庭个数(所有有亲属关系的人都属于同一个家庭)。随后按下列格式输出每个家庭的信息:
sh
家庭成员的最小编号 家庭人口数 人均房产套数 人均房产面积其中人均值要求保留小数点后3位。家庭信息首先按人均面积降序输出,若有并列,则按成员编号的升序输出。
输入样例:
sh
10
6666 5551 5552 1 7777 1 100
1234 5678 9012 1 0002 2 300
8888 -1 -1 0 1 1000
2468 0001 0004 1 2222 1 500
7777 6666 -1 0 2 300
3721 -1 -1 1 2333 2 150
9012 -1 -1 3 1236 1235 1234 1 100
1235 5678 9012 0 1 50
2222 1236 2468 2 6661 6662 1 300
2333 -1 3721 3 6661 6662 6663 1 100输出样例:
sh
3
8888 1 1.000 1000.000
0001 15 0.600 100.000
5551 4 0.750 100.000
sh
代码长度限制					16 KB
时间限制						400 ms
内存限制						64 MB
题解
该题其实就是一道并查集问题,这里使用一个data来存储数据,用vis标记已经出现的编号,并用parent来标记每个编号的根节点。
代码实现:
java
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.util.Arrays;

// L2-007 家庭房产
public class Main {
	private static int[] parent = new int[10001]; // 记录对应编号的根节点
	private static boolean[] vis = new boolean[10001]; // 用来标记输入时所有出现的编号

	public static void main(String[] args) throws IOException {
		BufferedReader br = new BufferedReader(new InputStreamReader(System.in));

		// 按照编号存储
		Node[] node = new Node[10001];
		// 并查集:初始化
		for (int i = 0; i < 10001; i++) {
			parent[i] = i;
			node[i] = new Node();
		}
		int n = Integer.parseInt(br.readLine());
		Data[] data = new Data[n];

		for (int i = 0; i < n; i++) {
			// 编号 父 母 k 孩子1 ... 孩子k 房产套数 总面积
			String str = br.readLine();
			String[] arr = str.split(" ");
			data[i] = new Data();
			data[i].id = Integer.parseInt(arr[0]);
			data[i].fid = Integer.parseInt(arr[1]);
			data[i].mid = Integer.parseInt(arr[2]);
			data[i].k = Integer.parseInt(arr[3]);

			// 标记已经处理过的编号
			vis[data[i].id] = true;

			// 把父母融入到一个大集合中
			if (data[i].fid != -1) {
				vis[data[i].fid] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].fid);
			}
			if (data[i].mid != -1) {
				vis[data[i].mid] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].mid);
			}

			// 处理孩子
			for (int j = 0; j < data[i].k; j++) {
				data[i].cid[j] = Integer.parseInt(arr[j + 4]);
				vis[data[i].cid[j]] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].cid[j]);
			}

			data[i].house = Integer.parseInt(arr[arr.length - 2]);
			data[i].area = Integer.parseInt(arr[arr.length - 1]);
		}

		// 先记录最小编号,累加房产套数 面积
		for (int i = 0; i < n; i++) {
			int root = find(data[i].id); // 找到当前编号的根节点
			node[root].flag = true; // 在树的根节点标记是一个大家庭
			node[root].avgHouse += data[i].house; // 人均房产套数
			node[root].minNum = root; // 家庭成员的最小编号
			node[root].avgArea += data[i].area; // 人均房产面积
		}

		// 累加家庭成员
		int family_count = 0;
		for (int i = 0; i < 10001; i++) {
			if (vis[i]) {
				int root = find(i);
				node[root].count++; // 计算每个大家庭总人数
			}
			if (node[i].flag) {
				family_count++; // 计算有几个大家庭
			}
		}

		// 算人均房产套数 人均房产面积
		for (int i = 0; i < 10001; i++) {
			if (node[i].flag) {
				node[i].avgHouse = node[i].avgHouse * 1.0 / node[i].count;
				node[i].avgArea = node[i].avgArea * 1.0 / node[i].count;
			}
		}

		// 排序
		Arrays.sort(node);

		System.out.println(family_count);
		for (int i = 0; i < family_count; i++) {
			// 家庭成员的最小编号 家庭人口数 人均房产套数 人均房产面积
			System.out.printf("%04d %d %.3f %.3f\n", node[i].minNum, node[i].count, node[i].avgHouse, node[i].avgArea);
		}
	}

	// 合并
	private static void union(int id, int cid) {
		// 找到这两个编号所在树中的根节点
		int ra = find(id);
		int rb = find(cid);

		// 让最小的编号作为根节点
		if (ra > rb) {
			parent[ra] = rb;
		} else {
			parent[rb] = ra;
		}
	}

	// 查找
	private static int find(int id) {
		int root = id;
		// 循环找到当前数的根节点,即根节点的 parent 指向自己
		// 这样做的目的是找到元素 id 所在的集合的根节点
		while (parent[root] != root) {
			// 获取当前结点的根编号
			root = parent[root];
		}
		// 压缩路径,减少树的层数,防止树的退化。
		// 将 x 到根节点的路径上的所有节点直接连接到根节点上,从而减少树的深度
		while (parent[id] != root) {
			int temp = parent[id]; // 拿到当前节点的根节点编号
			parent[id] = root; // 连接到新的根节点
			id = temp; // 继续处理下一个节点
		}
		return root;
	}

}

class Data {
	int id; // 当前编号
	int fid, mid; // 父母编号
	int k, house, area;
	int[] cid = new int[10]; // 家庭
}

class Node implements Comparable<Node> {
	int minNum; // 家庭最小编号
	int count; // 家庭人口数
	double avgHouse; // 人均房产套数
	double avgArea; // 人均房产面积
	boolean flag = false;

	@Override
	public int compareTo(Node other) {
		if (this.avgArea < other.avgArea)
			return 1;
		else if (this.avgArea > other.avgArea)
			return -1;
		else // 如果 avgArea 相等,比较 minNum
			return Integer.compare(this.minNum, other.minNum);
	}

}发现超时了。
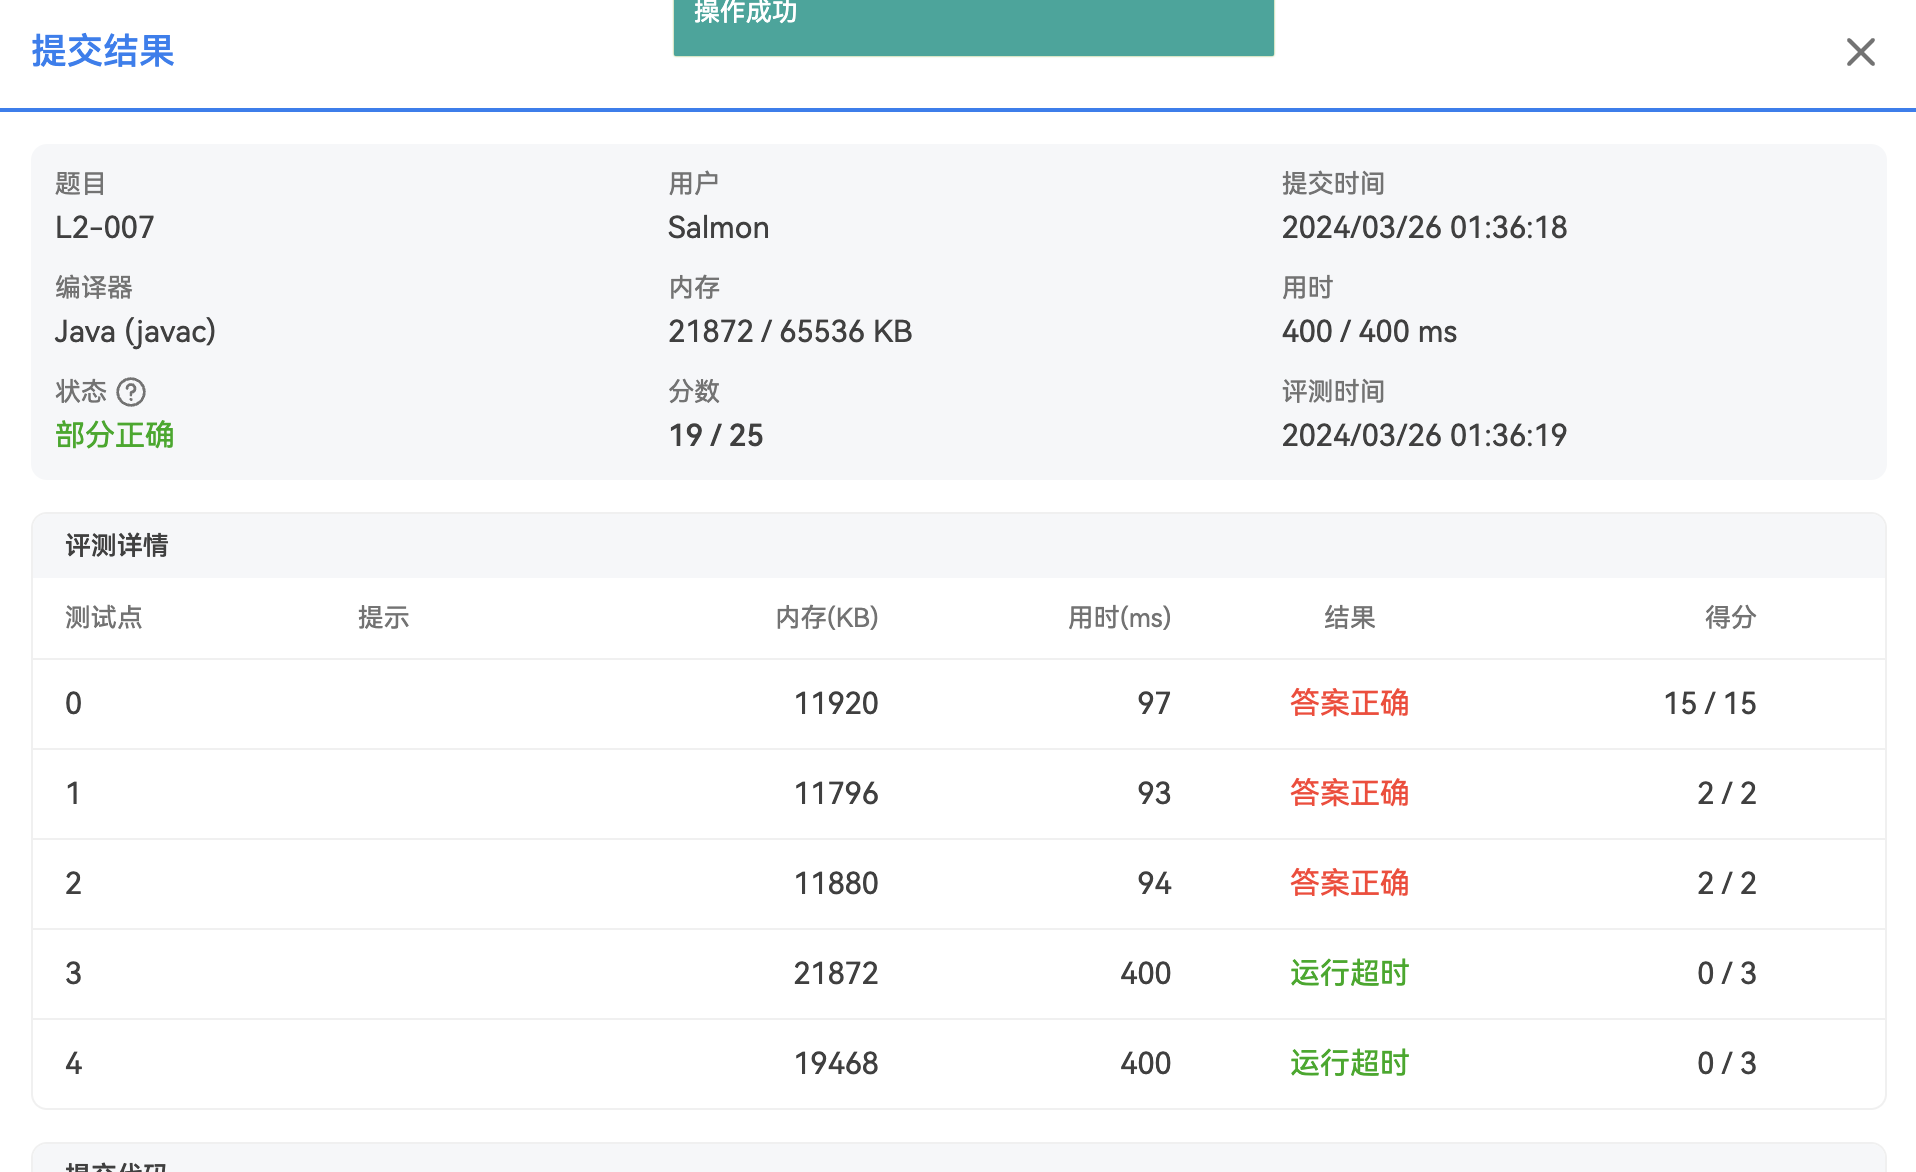
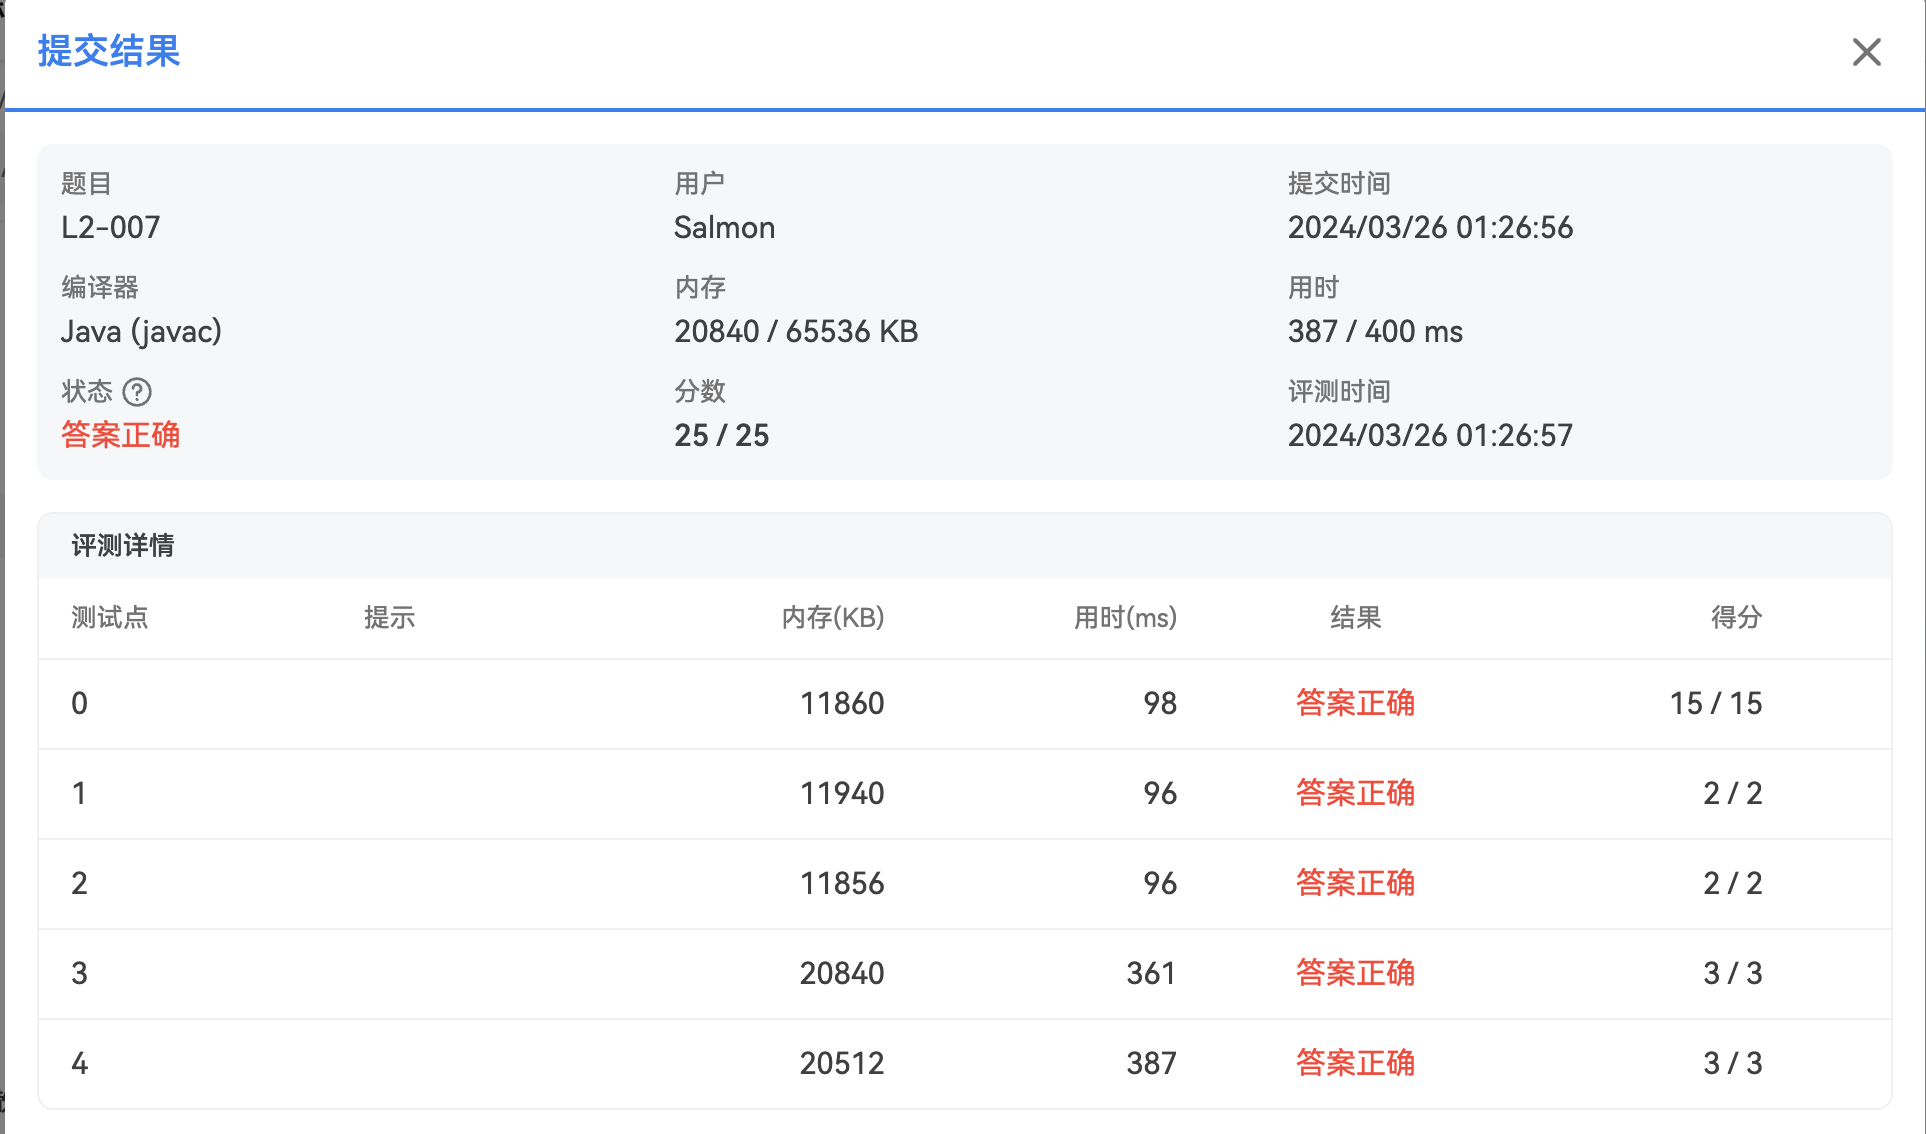
这里我们可以从 io 上进行优化,这里 BufferedReader 读入数据还不够快,我们改为使用 StreamTokenizer。当数据比较大的时候读取很慢!所以需要使用快读。我们快读主要是使用 java.io 包的 StreamTokenizer 类。
优化后:
java
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.io.StreamTokenizer;
import java.util.Arrays;

// L2-007 家庭房产
public class L2_7 {
	private static int[] parent = new int[10001]; // 记录对应编号的根节点
	private static boolean[] vis = new boolean[10001]; // 用来标记输入时所有出现的编号

	public static void main(String[] args) throws IOException {
		StreamTokenizer tokenizer = new StreamTokenizer(new BufferedReader(new InputStreamReader(System.in)));

		// 按照编号存储
		Node[] node = new Node[10001];
		// 并查集:初始化
		for (int i = 0; i < 10001; i++) {
			parent[i] = i;
			node[i] = new Node();
		}
		tokenizer.nextToken();
		int n = (int)tokenizer.nval;
		Data[] data = new Data[n];

		for (int i = 0; i < n; i++) {
			// 编号 父 母 k 孩子1 ... 孩子k 房产套数 总面积
			data[i] = new Data();
			tokenizer.nextToken();
			data[i].id = (int) tokenizer.nval;
			tokenizer.nextToken();
			data[i].fid = (int) tokenizer.nval;
			tokenizer.nextToken();
			data[i].mid = (int) tokenizer.nval;
			tokenizer.nextToken();
			data[i].k = (int) tokenizer.nval;

			// 标记已经处理过的编号
			vis[data[i].id] = true;

			// 把父母融入到一个大集合中
			if (data[i].fid != -1) {
				vis[data[i].fid] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].fid);
			}
			if (data[i].mid != -1) {
				vis[data[i].mid] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].mid);
			}
			// 处理孩子
			for (int j = 0; j < data[i].k; j++) {
				tokenizer.nextToken();
				data[i].cid[j] = (int) tokenizer.nval;
				vis[data[i].cid[j]] = true; // 标记已经处理过的编号
				union(data[i].id, data[i].cid[j]);
			}

			tokenizer.nextToken();
			data[i].house = (int) tokenizer.nval;
			tokenizer.nextToken();
			data[i].area = (int) tokenizer.nval;
		}

		// 先记录最小编号,累加房产套数 面积
		for (int i = 0; i < n; i++) {
			int root = find(data[i].id); // 找到当前编号的根节点
			node[root].flag = true; // 在树的根节点标记是一个大家庭
			node[root].avgHouse += data[i].house; // 人均房产套数
			node[root].minNum = root; // 家庭成员的最小编号
			node[root].avgArea += data[i].area; // 人均房产面积
		}

		// 累加家庭成员
		int family_count = 0;
		for (int i = 0; i < 10001; i++) {
			if (vis[i]) {
				int root = find(i);
				node[root].count++; // 计算每个大家庭总人数
			}
			if (node[i].flag) {
				family_count++; // 计算有几个大家庭
			}
		}

		// 算人均房产套数 人均房产面积
		for (int i = 0; i < 10001; i++) {
			if (node[i].flag) {
				node[i].avgHouse = node[i].avgHouse * 1.0 / node[i].count;
				node[i].avgArea = node[i].avgArea * 1.0 / node[i].count;
			}
		}

		// 排序
		Arrays.sort(node);

		System.out.println(family_count);
		for (int i = 0; i < family_count; i++) {
			// 家庭成员的最小编号 家庭人口数 人均房产套数 人均房产面积
			System.out.printf("%04d %d %.3f %.3f\n", node[i].minNum, node[i].count, node[i].avgHouse, node[i].avgArea);
		}
	}

	// 合并
	private static void union(int id, int cid) {
		// 找到这两个编号所在树中的根节点
		int ra = find(id);
		int rb = find(cid);

		// 让最小的编号作为根节点
		if (ra > rb) {
			parent[ra] = rb;
		} else {
			parent[rb] = ra;
		}
	}

	// 查找
	private static int find(int id) {
		int root = id;
		// 循环找到当前数的根节点,即根节点的 parent 指向自己
		// 这样做的目的是找到元素 id 所在的集合的根节点
		while (parent[root] != root) {
			// 获取当前结点的根编号
			root = parent[root];
		}
		// 压缩路径,减少树的层数,防止树的退化。
		// 将 x 到根节点的路径上的所有节点直接连接到根节点上,从而减少树的深度
		while (parent[id] != root) {
			int temp = parent[id]; // 拿到当前节点的根节点编号
			parent[id] = root; // 连接到新的根节点
			id = temp; // 继续处理下一个节点
		}
		return root;
	}

}

class Data {
	int id; // 当前编号
	int fid, mid; // 父母编号
	int k, house, area;
	int[] cid = new int[10]; // 家庭
}

class Node implements Comparable<Node> {
	int minNum; // 家庭最小编号
	int count; // 家庭人口数
	double avgHouse; // 人均房产套数
	double avgArea; // 人均房产面积
	boolean flag = false;

	@Override
	public int compareTo(Node other) {
		if (this.avgArea < other.avgArea)
			return 1;
		else if (this.avgArea > other.avgArea)
			return -1;
		else // 如果 avgArea 相等,比较 minNum
			return Integer.compare(this.minNum, other.minNum);
	}

}
评论
0 条—
还没有评论,来说第一句