常见算法模板
本文详细解析了常见算法模板的核心用法与Java实现,包括IO优化、GCD/LCM、快速幂、素数筛与质因数分解、斐波那契、DFS/BFS、并查集、组合与排列枚举、
IO
字符串输入、输出
数据量少,可以使用 import java.util.Scanner;
java
Scanner sc = new Scanner(System.in);数据量多,则使用 import java.io.* 下的 BufferedReader,利用 StringTokenizer 读取大量字符串(缓冲流),会很高效。
java
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
StringTokenizer st = new StringTokenizer(br.readLine());
String s=st.nextToken();
输出只需几行,可以直接使用 sout
java
System.out.println("aaaa");如果需要大量打印,则可以使用 import java.io.* 下的 PrintWriter 会更高效。
java
PrintWriter pw = new PrintWriter(new OutputStreamWriter(System.out));
pw.print("hhh");
数学
最大公约数(GCD)
同时能整除整数 a 和 b 的 最大整数,比如:15 和 81 的最大公约数是 3,0 和 44 的最大公约数是 44,-17 和 289 的最大公约数是 -17。
java
private static int gcd(int a, int b) {
	return b == 0 ? a : gcd(b, a % b);
}
最小公倍数(LCM)
a 与 b 相乘,然后除以它们的最大公约数。
java
private static int gcd(int a, int b) {
	return b == 0 ? a : gcd(b, a % b);
}

private static int gcm(int a, int b) {
	return a / gcd(a, b) * b; // 先做除法再做乘法防止溢出
}
快速幂
比暴力计算快,特别是指数很大的情况,通过位运算快速计算,同时避免溢出。
java
/**
 * 如果无需取模,则把模板中的取模去掉即可
 *
 * @param a
 * @param n
 * @param mod
 */
private static long fastPow(long a, long n, long mod) {
	long ans = 1;
	a %= mod;
	while (n > 0) {
		if ((n & 1) == 1) {
			ans = (ans * a) % mod;
		}
		a = (a * a) % mod;
		n >>= 1;
	}
	return ans;
}素数
只能被 1 和自己本身整除的正整数是素数,注意:1 不是素数,最小素数是 2。
java
/**
 * 判断一个数是不是素数
 *
 * @param n
 * @return
 */
private static boolean isPrime(int n) {
	if (n <= 1) {
		return false; // 1 不是素数
	}
	for (int i = 2; i <= Math.sqrt(n); i++) {

		if (n % i == 0) {
			return false;
		}
	}
	return true;
}埃氏筛,如果需要获取某个范围内的素数或者质数,可以考虑这个方法
java
static int[] primes; // 存放素数
static boolean[] noPrime; // 标记是否非素数
static int cnt; // 素数个数

/**
 * 如果需要获取某个范围内的素数或者质数,可以考虑这个方法
 *
 * @param n
 */
private static void getPrime(int n) {
	primes = new int[n + 1];
	noPrime = new boolean[n + 1];
	// 先初始化所有数都是素数
	Arrays.fill(noPrime, false);
	// 0和1不是素数
	noPrime[0] = true;
	noPrime[1] = true;
	// 注意这里包含 n
	for (int i = 2; i <= n; i++) {
		// 如果该数还未被标记为是否素数
		if (!noPrime[i]) {
			primes[cnt++] = i; // 标记为素数
			// 计算以 i 为倍速的数,都不是素数
			for (int j = i * 2; i <= n; j += i) {
				noPrime[j] = true; // 标记为不是素数
			}
		}
	}
}分解质因子
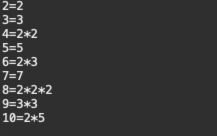
把 n 分解成最小的质因数,如:、、、、、 、、。
java
static int[] p = new int[20]; // 记录因子,p[1]是最小因子。一个 int 数的质因子最多有 10 几个
static int[] c = new int[40]; // 记录第 i 个因子的个数,一个因子的个数最多有 30 几个

public static void main(String[] args) throws IOException {
	fenjie(2, 10);
}


/**
 * 将 a 到 b所有整数的质因子分解
 *
 * @param a
 * @param b
 */
private static void fenjie(int a, int b) {
	for (int i = a; i <= b; i++) {
		int m = factor(i); // 得到质因子的个数
		System.out.print(i + "=");
		// 从最小质因子开始,第 j 个因子
		for (int j = 1; j <= m; j++) {
			// 第 j 个因子的个数
			for (int k = 1; k <= c[j]; k++) {
				System.out.print(p[j]);
				if (k != c[j]) {
					System.out.print("*");
				}
			}
			if (j < m) {
				System.out.print("*");
			}
		}
		System.out.println();
	}
}

/**
 * 返回当前 n 的因子的个数
 *
 * @param n
 * @return
 */
private static int factor(int n) {
	int m = 0;
	// 逐个检查 2 到根号n 中所有的素数
	for (int i = 2; i <= Math.sqrt(n); i++) {
		// 如果 i 能整除 n,就是最小质因子
		if (n % i == 0) {
			++m;
			p[m] = i; // 记录 i 为 n 的质因子
			c[m] = 0; // 初始因子 i 的个数
			// 循环获取当前这个因子在 n 中有多少个,直到余数不为 0
			while (n % i == 0) {
				n /= i; // 去掉 n 中重复的因子 i
				c[m]++; // 累加因子 i 个个数
			}
		}
	}
	// 走到这里 n 还大于1,说明它是素数
	if (n > 1) {
		m++;
		p[m] = n; // 素数的因子为自己本身
		c[m] = 1; // 这个位置的数的因子只有 1 个
	}
	return m;
}
因式分解
java
大数分解
java
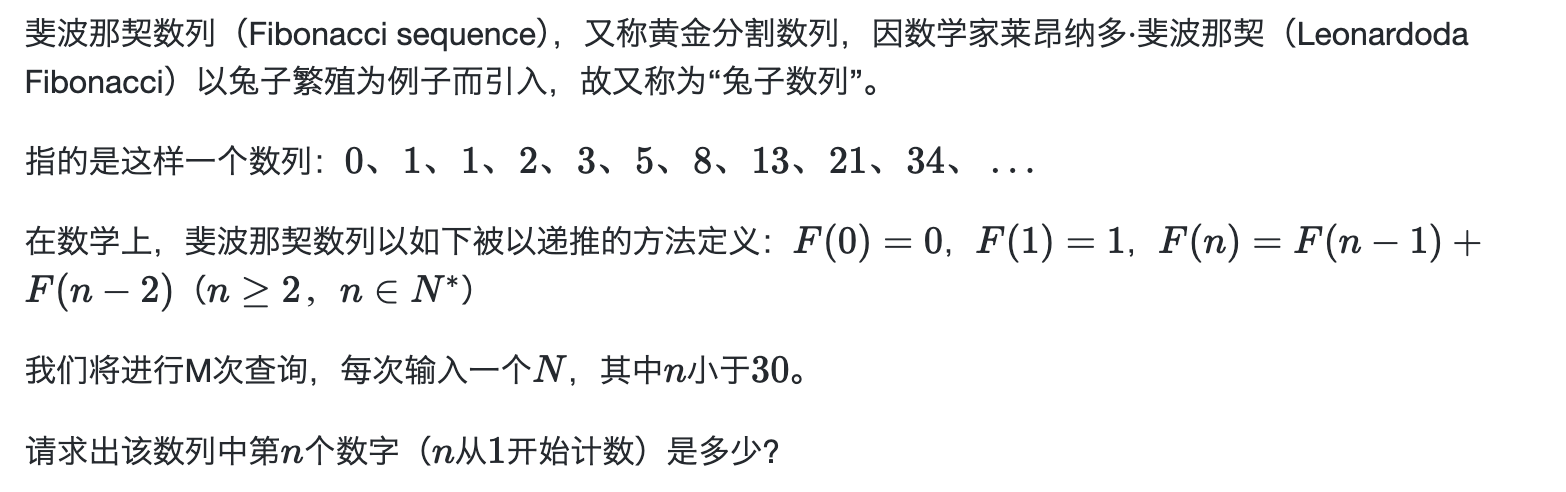
斐波那契数列
java
static final int N = 31;
static int[] f = new int[N];

public static void main(String[] args) throws IOException {
	f[0] = 0;
	f[1] = 1;
	for (int i = 2; i < N; i++) {
		f[i] = f[i - 1] + f[i - 2];
	}
	System.out.print(f[9]);
}
搜索
dfs
java
boolean check(参数)
{
    if(满足条件)
        return true;
    return false;
}
boolean pd(参数){
    相应操作
}
void dfs(int step)
{
        判断边界pd()
        {
            不在边界内,即回溯
        }
        尝试每一种可能
        {
               满足check条件

               标记

               继续下一步dfs(step+1)

               恢复初始状态(回溯的时候要用到)
        }
}bfs
java
boolean check(参数)
{
    if(满足条件)
        return true;
    return false;
}
boolean pd(参数){
    相应操作
}
void bfs()
{
    1. 把根节点放入队列尾端
    2. 每次从队列中取出一个节点
    3. Check 判断是不是答案,如果是结束算法 return;
    4. 把当前取出的节点扩展,如果扩展后的节点经Pd()后符合要求,就放入队列,不符合就不放。
    5. 转到步骤2,循环执行
}

如果所有节点被扩展完了,没有找到答案就无解。并查集
- 判断图的连通性
- 区间问题
- 连续子序列问题
- 最小生成树 kruskal 算法
java
static final int MAXN = 200;
static int[] father = new int[MAXN + 1];

/**
 * 查找根节点
 */
private static void findRoot() {
	for (int i = 1; i <= MAXN; i++) {
		// 根节点的自身
		if (father[i] == i) {

		}
	}
}

/**
 * 初始化并查集
 *
 * @param n
 */
private static void init() {
	// 初始化每个节点的根节点为自己
	for (int i = 0; i <= MAXN; i++) {
		father[i] = i;
	}
}

/**
 * 合并 x、y节点
 *
 * @param x
 * @param y
 */
private static void merge(int x, int y) {
	int a = find(x);
	int b = find(y);
	if (a != b) {
		// 往根节点小的合并
//		if (a > b) {
//			father[a] = b;
//		} else {
//			father[b] = a;
//		}
		// 一般这样即可
		father[b] = a;
	}
}

/**
 * 查找x的根节点
 *
 * @param x
 * @return
 */
private static int find(int x) {
	if (father[x] == x) {
		return x;
	}
	father[x] = find(father[x]);
	return father[x];
}枚举
组合型枚举
在 n 个元素中随机选取出 m 个元素的问题。我们需要确定选择了哪 m 个元素,这就是组合型枚举。
java
import java.util.Scanner;
import java.util.Vector;
public class Main {

    static int n;
    static int m; // 选m个数
    static Vector<Integer> chosen = new Vector<Integer>();

    private static void calc(int x) {
	// 当前元素选够,或者当前选择的元素,加上剩余未选的元素还不够要求,那就没必要走下去了
        if (chosen.size() > m || chosen.size() + (n - x + 1) < m) //剪枝
            return;
        if (chosen.size() == m) { //选够了m个数输出
            String ansTem = "";
            for (int i = 0; i < chosen.size(); i++)
                System.out.print(chosen.get(i)+" ");
            System.out.println("");
            return;
        }
	// 包含这个元素的组合情况
        chosen.addElement(x);
        calc(x + 1);
	// 不包含这个元素的组合情况
        chosen.remove((Object)x);
        calc(x + 1);
    }

    public static void main(String[] args) {
        Scanner in = new Scanner(System.in);
        n = in.nextInt();
        m = in.nextInt();
        calc(1);
    }
}排列型枚举
n 个排列情况。
java
  static int n;
  static int[] order =new int[20];
  static boolean[] chosen =new boolean[20];

  private static void calc(int x) {
      // 选够了 n 个数输出
      if (x == n + 1) {
	  // 排列结果
          String ansTem = "";
          for (int i = 1; i <=n ; i++)
              System.out.println(order[i]);
          return;
      }
      for (int i = 1; i <= n; i++) {
	  // 跳过当前排序中已选择的节点
          if (chosen[i]) continue;
          order[x] = i; // 当前排序第 x 个的元素的下标为 i
          chosen[i] =true;
          calc(x + 1); // 找到下一个组合的结点
          chosen[i] = false;
          order[x] = 0; // 取消当前第 x 序号的
      }
  }

  public static void main(String[] args) {
      Scanner in = new Scanner(System.in);
      n = in.nextInt();
      for (int i = 0; i < n; i++) {
          String s = in.next();
          name.addElement(s);
      }
      calc(1);
}尺取法
java
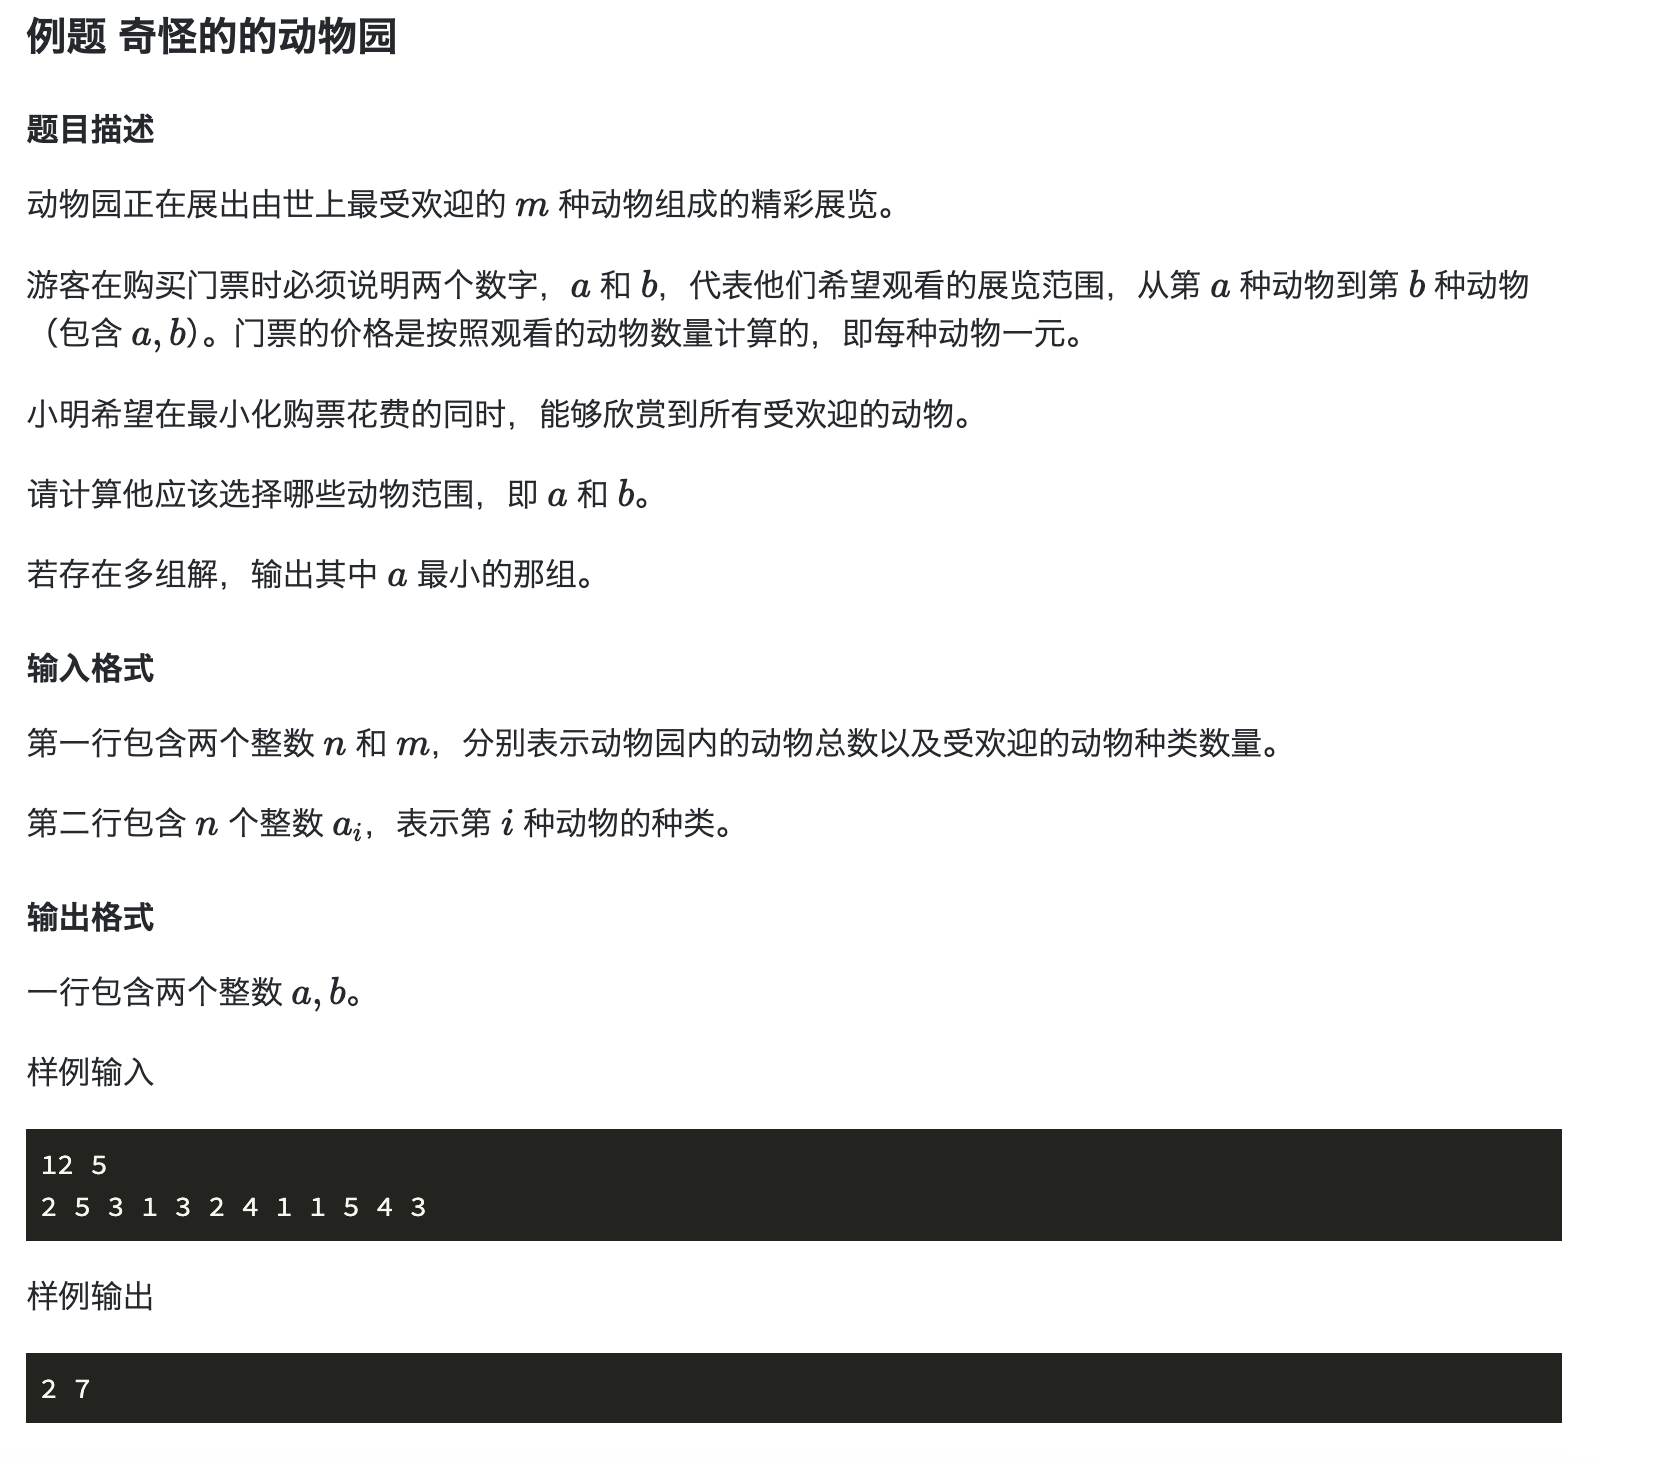
// 奇怪的动物园
public class Main {

	static final int MAXN = 10000005;
	static int[] animals = new int[MAXN]; // 记录每一个动物的种类类型
	static int[] looks = new int[MAXN]; // 观看动物的类型的次数
	static int count; // 累计不同动物的类型数

	/**
	 * 插入这种动物类型
	 *
	 * @param type 动物类型
	 */
	private static void insert(int type) {
		// 如果这种动物之前没有看过,则记录类型数量
		if (looks[type] == 0) {
			count++;
		}
		// 累加这种动物的数量
		looks[type]++;
	}

	/**
	 * 删除这种动物类型
	 *
	 * @param type 动物类型
	 */
	private static void delete(int type) {
		// 如果删除后这个动物不再记录中,则类型数量减去这种动物的
		if (looks[type] == 1) {
			count--;
		}
		// 减去这种动物的数量
		looks[type]--;
	}

	public static void main(String[] args) {
		Scanner sc = new Scanner(System.in);
		int n = sc.nextInt(); // n种动物
		int m = sc.nextInt(); // 最受欢迎的动物种类数量

		for (int i = 1; i <= n; i++) {
			animals[i] = sc.nextInt();
		}

		int ans = n; // 默认观看的动物种类为

		// 滑动窗口:每次扩大窗口范围,当满足某个条件时,收缩窗口
		int left = 0, right = 0;
		// 初始左右边界
		// 每次循环右边界移动,扩大窗口范围(可观看的动物)
		for (int l = 1, r = 1; r <= n; r++) {
			// 插入第 r 个动物
			insert(animals[r]);

			while (true) {
				delete(animals[l]);
				// 删了这个动物后,如果不影响,则缩小窗口,看的越多费用越高
				if (count == m) {
					l++;
				} else {
					// 删除了会减少观看种类的数量,则重新加回去
					insert(animals[l]);
					break;
				}
			}
			// 如果观看了 m 种动物,并且区间比之前的小
			if (count == m && r - l + 1 < ans) {
				left = l;
				right = r;
				ans = r - l + 1;
			}
		}
		// 输出最小窗口的左右边界,如果没有找到符合条件的窗口,则输出整个序列
		if (left != 0)
			System.out.println(left + " " + right);
		else
			System.out.println("1 " + n); // 特殊情况,输出 1~n
	}

}差分前缀和
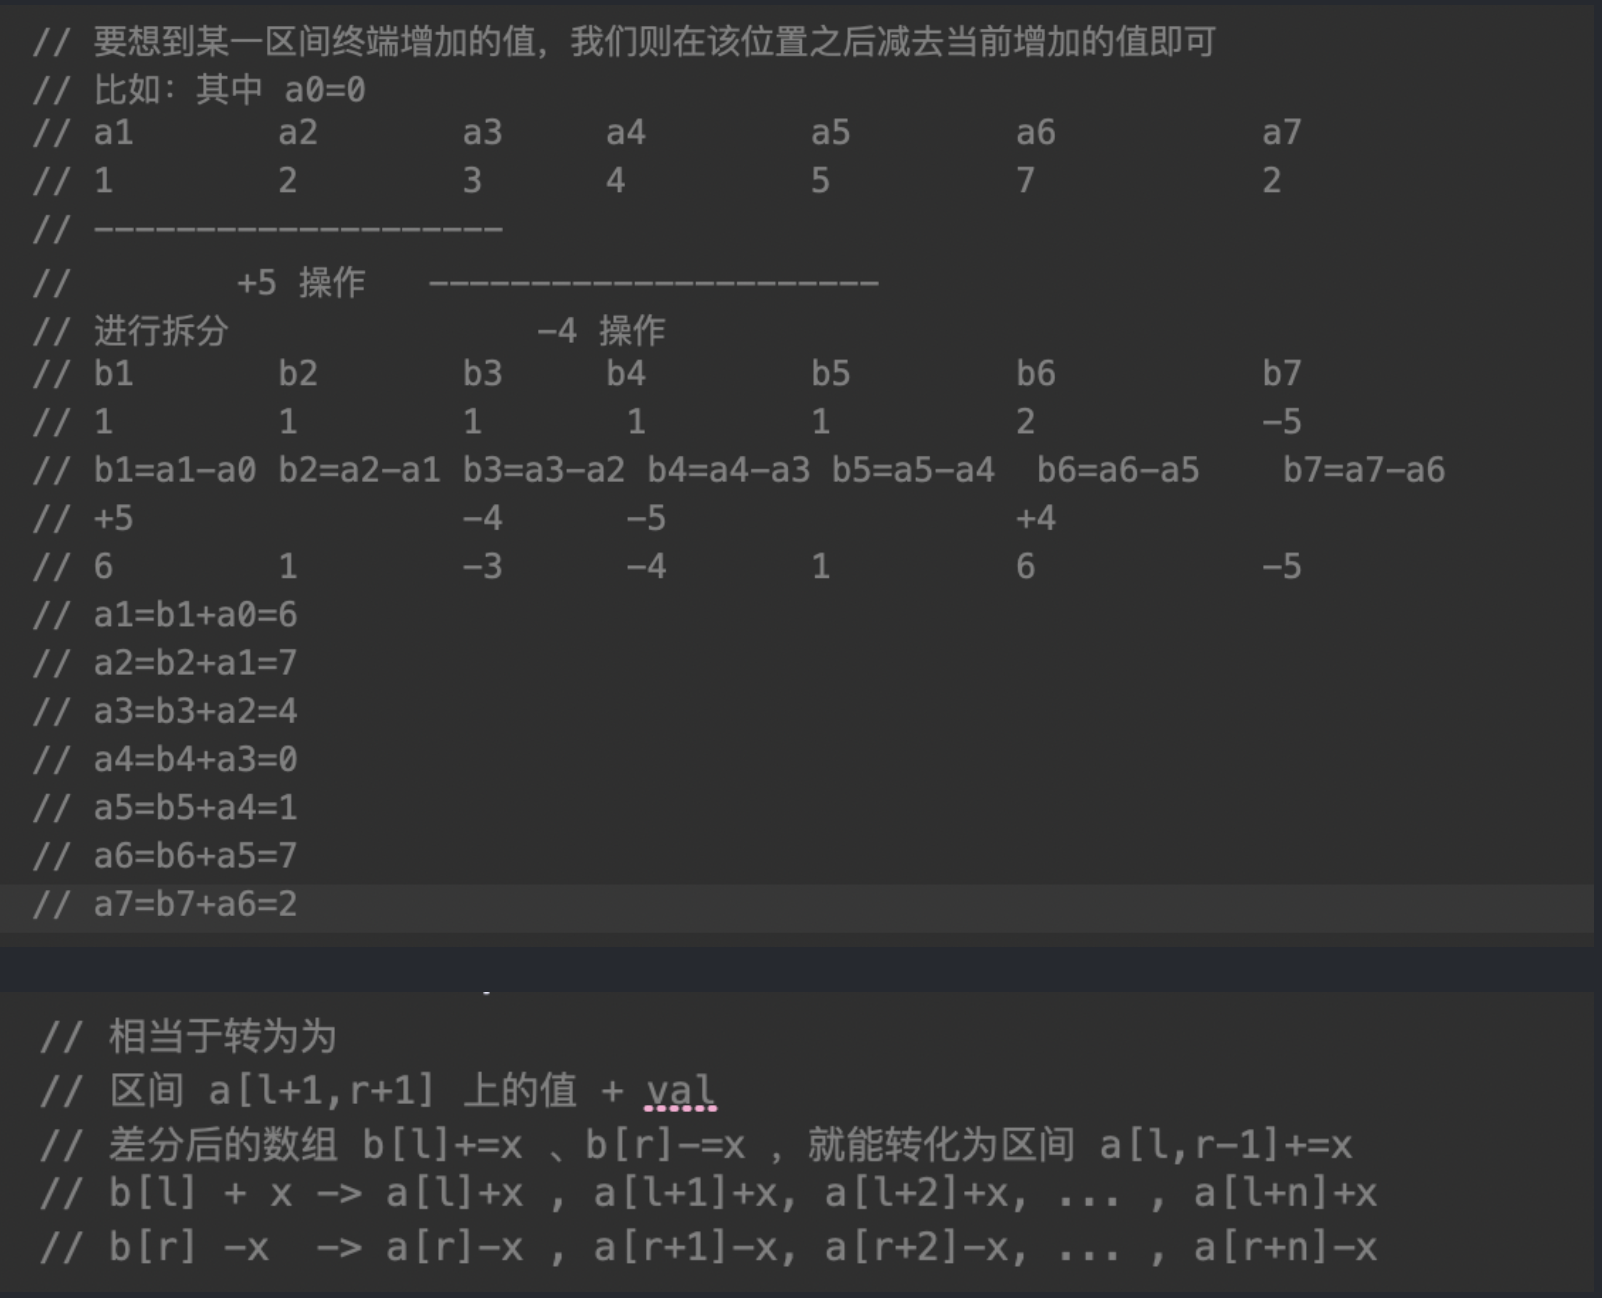
一维差分与前缀和
java
public class Main {

	static int[] b = new int[8];
	static int[] a = { 0, 1, 2, 3, 4, 5, 7, 2 };

	public static void main(String[] args) {
		// 初始化拆分区间b
		for (int i = 1; i <= 7; i++) {
			b[i] = a[i] - a[i - 1];
		}
		// 对区间 1到 3 做 +5 操作
		b[1] += 5;
		b[3 + 1] -= 5;
		// 对区间 3 到5 做 -4 操作
		b[3] += -4;
		b[5 + 1] -= -4;
		// 则变化后的 a 为:
		// 编号从1开始输出
		for (int i = 1; i < 8; i++) {
			a[i] = b[i] + a[i - 1];
			System.out.printf("a%d = b%d + a%d = %d\n", i, i, i - 1, a[i]);
		}
	}

}二维差分与前缀和
java
二分
整数二分
java
// 在单调递增序列 a 中查找>=x的数中最小的一个(即x或x的后继)
while (low < high) {
    int mid = (low + high) / 2;

    if (a[mid] >= x)
      high= mid;
    else
      low = mid + 1;
}

// 在单调递增序列 a 中查找<=x的数中最大的一个(即x或x的前驱)
while (low < high) {
    int mid = (low + high + 1) / 2;

    if (a[mid] <= x)
      low = mid;
    else
      high = mid - 1;
}实数二分
java
//令eps 为小于题目精度一个数即可。

//比如有些题目说保留4位小数,0.0001 这种的。那么eps 就可以设置为五位小数的任意一个数 0.00001- 0.00009 等等都可以。一般为了保证精度我们选取精度 /100 的那个小数,即设置  eps= 0.0001/100 =1e-6。

while (l + eps < r) {
    double mid = (l + r) / 2;

    if (pd(mid))
      r = mid;
  else
      l = mid;
}

// 实数域二分,规定循环次数法

//通过循环一定次数达到精度要求,这个一般log2N< 精度即可。N为循环次数,在不超过时间复杂度的情况下,可以选择给N乘一个系数使得精度更高。

for (int i = 0; i < 100; i++) {

    double mid = (l + r) / 2;
    if (pd(mid))
      r = mid;
  else
      l = mid;
}M次方根
java
import java.util.Scanner;

// M次方根
public class Main {

	static int n;
	// 题目要精确到九位小数,这里我用9位去算,避免影响7位的精度
	static double eps = 1e-9;

	private static boolean pd(double x, int m) {
		double sum = 1;
		// 计算 x 的 m 次方
		while (m-- > 0) {
			sum *= x;
		}
		// 如果 x 的 m 次方大于 n,说明这个数满足条件
		if (sum >= n) {
			return true;
		}

		return false;
	}

	public static void main(String[] args) {
		Scanner sc = new Scanner(System.in);
		n = sc.nextInt();
		int m = sc.nextInt();

		// 定义二分上下界
		double l = 0;
		double r = n;

		double mid = 0;

		// 实数二分
		while (l + eps < r) {
			mid = (l + r) / 2;
			// 判断该数的 m 次方是否大于等于 n
			if (pd(mid, m)) {
				// 大于等于n,让这个数作为上限,继续缩小范围
				r = mid;
			} else {
				// m次方 小于 n,说明该数太小,应作为下限,缩小范围
				l = mid;
			}
		}
		// 左右指针相遇,输出结果
		System.out.printf("%.7f\n", l);
		// 当然,题目可以直接用数学工具解决这题
//		 System.out.printf("%.7f\n", Math.pow(n, (double) 1 / m));
	}
}贪心
java
while(Q.hasNextStep) {
    // 选择新的最好的选择
    Select(Q.nowBestSelect);
    Q.NextStep
}

Select(Q.nowBestSelect);
LIS 最长公共子序列
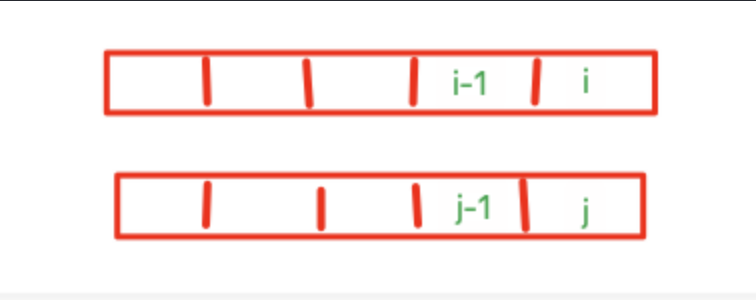
简单理解就是, i 和 j 位置的元素不是公共子序列,故不选它,那么当前存储的最优解来自上一次未考虑第 i 个元素与第 j 个元素时的最优解,也就是:dp[i - 1][j]、dp[i][j - 1],找到两者的最大值作为当前长度为 i 和 j 时最优解。
java
int[][] dp = new int[Max][Max];

dp[0][0] = 0;
for (int i = 0; i < n; i++) {
	for (int j = 0; j < m; j++) {
		if (a[i] == b[j]) {
			dp[i + 1][j + 1] = dp[i][j] + 1;
		} else {
			dp[i + 1][j + 1] = Math.max(dp[i + 1][j], dp[i][j + 1]);
		}
	}
}

System.out.print(dp[n][m]);
LIS 最长递增子序列
这题是一道递增序列的例题,从数组找出最长的递增子序列。故理解代码即可。
java
import java.util.Scanner;

// 蓝桥骑士
public class Main {

	static int N;
	static int[] arr;
	static int[] dp; // 存储处理到第 i 个元素时的最长递增子序列长度

	public static void main(String[] args) {
		Scanner sc = new Scanner(System.in);
		N = sc.nextInt();
		arr = new int[N];
		dp = new int[N];
		for (int i = 0; i < N; i++) {
			arr[i] = sc.nextInt();
			// 初值,每个位置的递增子序列长度为1
			dp[i] = 1;
		}

		// 找到终点为 i 的最长递增子序列长度
		for (int i = 0; i < N; i++) {
			for (int j = 0; j < i; j++) {
				// 如果前 i 个元素中,比终点 i 位置的元素值小
				// 那它对于终点 i 是递增的
				// 且终点为 j 时的最优解加上当前的 i 如果比现在的最优解好,则更新。
				if (arr[i] > arr[j] && dp[j] + 1 > dp[i]) {
					dp[i] = dp[j] + 1;
				}
			}
		}
		System.out.print(dp[N - 1]);
	}
}LCS 最近公共祖先
java
背包问题
0/1背包
java
// 初始化细节
//装满
Arrays.fill(dp, -0x3f3f3f3f);
dp[0]=0;

//不装满
Arrays.fill(dp, 0);

for (int i = 0; i < n; i++) //遍历每一件物品
{
      for (int j = C; j >= c[i]; j--)
            //遍历背包容量,表示在上一层的基础上,容量为J时,第i件物品装或不装的最优解;
           dp[j] = max(dp[j - c[i]] + w[i], dp[j]);
}

System.out.println(dp[C]);完全背包
java
//装满
Arrays.fill(dp, -0x3f3f3f3f);
dp[0]=0;

//不装满
Arrays.fill(dp, 0);

for (int i = 0; i < n; i++) //遍历每一件物品
{
	for(int j=c[i];j<=C;j++)
      		//遍历背包容量,表示在上一层的基础上,容量为J时,第i件物品装或不装的最优解;
                dp[j] = max(dp[j - c[i]] + w[i], dp[j]);
}
System.out.println(dp[C]);
多重背包
java
//装满
Arrays.fill(dp, -0x3f3f3f3f);
dp[0]=0;

//不装满
Arrays.fill(dp, 0);

//遍历每一个物品
for(int i=0;i<n;i++) {
    //遍历物品的数量
    for(int j=0;j<=s[i];j++) {
        //当做01背包来处理
        for(int k=C;k>=c[i];k--) {
            //取01背包情况的dp[k]和dp[k-c[i]]+w[i]的最大值
            dp[k]=max(dp[k],dp[k-c[i]]+w[i]);
        }
    }
}
System.out.println(dp[C]);最短路径
Floyd
求多源最短路径
java
for(int k=1; k<=n; k++)         //floyd的三重循环
    for(int i=1; i<=n; i++)
        for(int j=1; j<=n; j++)      // k循环在i、j循环外面
            dp[i][j] = min(dp[i][j], dp[i][k] + dp[k][j]);
Dijkstra
求单源最短路径,无负权值
java
import java.util.*;
import java.io.*;

public class Main {
    static final long INF = 0x3f3f3f3f3f3f3f3fL;
    static final int N = 300005;
    static ArrayList<Edge>[] e = new ArrayList[N];
    static int n, m;
    static int[] pre = new int[N];
    static long[] dis = new long[N];
    static boolean[] done = new boolean[N];

    static class Edge {
        int from, to;
        long w;

        Edge(int a, int b, long c) {
            from = a;
            to = b;
            w = c;
        }
    }

    static class SNode implements Comparable<SNode> {
        int id;
        long n_dis;

        SNode(int b, long c) {
            id = b;
            n_dis = c;
        }

        public int compareTo(SNode o) {
            return Long.compare(n_dis, o.n_dis);
        }
    }

    static void printPath(int s, int t) {
        if (s == t) {
            System.out.print(s + " ");
            return;
        }
        printPath(s, pre[t]);
        System.out.print(t + " ");
    }

    static void dijkstra() {
        int s = 1;
        PriorityQueue<SNode> Q = new PriorityQueue<>();
        Arrays.fill(dis, INF);
        dis[s] = 0;
        Q.offer(new SNode(s, dis[s]));
        while (!Q.isEmpty()) {
            SNode u = Q.poll();
            if (done[u.id])
                continue;
            done[u.id] = true;
            for (Edge y : e[u.id]) {
                if (done[y.to])
                    continue;
                if (dis[y.to] > y.w + u.n_dis) {
                    dis[y.to] = y.w + u.n_dis;
                    Q.offer(new SNode(y.to, dis[y.to]));
                    pre[y.to] = u.id;
                }
            }
        }
        // printPath(s, n);
    }

    public static void main(String[] args) throws Exception {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        StringTokenizer st = new StringTokenizer(br.readLine());
        n = Integer.parseInt(st.nextToken());
        m = Integer.parseInt(st.nextToken());
        for (int i = 1; i <= n; i++)
            e[i] = new ArrayList<>();
        for (int i = 1; i <= m; i++) {
            st = new StringTokenizer(br.readLine());
            int u = Integer.parseInt(st.nextToken());
            int v = Integer.parseInt(st.nextToken());
            long w = Long.parseLong(st.nextToken());
            e[u].add(new Edge(u, v, w));
            // e[v].add(new Edge(v, u, w)); //本题是单向道路
        }
        dijkstra();
        for (int i = 1; i <= n; i++) {
            if (dis[i] >= INF)
                System.out.print("-1 ");
            else
                System.out.print(dis[i] + " ");
        }
    }
}SPFA
求单源最短路径,无负权环
java
import java.util.*;

public class Main {
    static final long INF = 0x3f3f3f3f3f3f3f3fL;
    static final int N = 5010;

    static long[] dist = new long[N];
    static int[] inq = new int[N];
    static List<edge>[] e = new ArrayList[N];

    static class edge {
        int to;
        long w;

        public edge(int tt, long ww) {
            to = tt;
            w = ww;
        }
    }

    static void spfa(int s) {
        Arrays.fill(dist, INF);
        dist[s] = 0;
        Queue<Integer> q = new LinkedList<>();
        q.add(s);
        inq[s] = 1;
        while (!q.isEmpty()) {
            int u = q.poll();
            inq[u] = 0;
            if (dist[u] == INF) continue;
            for (int i = 0; i < e[u].size(); i++) {
                int v = e[u].get(i).to;
                long w = e[u].get(i).w;
                if (dist[v] > dist[u] + w) {
                    dist[v] = dist[u] + w;
                    if (inq[v] == 0) {
                        q.add(v);
                        inq[v] = 1;
                    }
                }
            }
        }
    }

    public static void main(String[] args) {
        Scanner in = new Scanner(System.in);
        int n = in.nextInt();
        int m = in.nextInt();
        int s = in.nextInt();
        for (int i = 1; i <= n; i++) {
            e[i] = new ArrayList<>();
        }
        for (int i = 1; i <= m; i++) {
            int u = in.nextInt();
            int v = in.nextInt();
            long w = in.nextLong();
            e[u].add(new edge(v, w));
        }
        spfa(s);
        for (int i = 1; i <= n; i++) {
            if (dist[i] == INF) System.out.print("-1 ");
            else System.out.print(dist[i] + " ");
        }
    }
}最小生成树
Prim
最小生成树(稠密图,很多边)
java
import java.util.ArrayList;
import java.util.List;
import java.util.Scanner;

public class Main {

	// 定义常量 INF 表示无穷大
	private static final int INF = 0x3f3f3f3f;
	// 定义常量 MAXN 表示顶点的最大数量
	private static final int MAXN = 1005;

	// 存储与顶点 i 最近的结点编号(边权值最小)
	private static int[] closest = new int[MAXN];
	// 存储已经形成的生成树中某个顶点到 i 的最小权值
	private static int[] lowcost = new int[MAXN];

	// 定义二维数组存储图的边权值
	private static int[][] G = new int[MAXN][MAXN];
	private static int m; // 顶点数量

	// 定义列表存储 Prim 算法中生成树的边权值
	private static List<Integer> demo = new ArrayList<>();

	public static void main(String[] args) {
		Scanner sc = new Scanner(System.in);
		// 读取顶点数量 m 和边的数量 n
		m = sc.nextInt();
		int n = sc.nextInt();

		// 读取每条边的起点、终点和权值,并存储到二维数组 G 中
		for (int i = 0; i < n; ++i) {
			int a = sc.nextInt();
			int b = sc.nextInt();
			int c = sc.nextInt();
			G[b][a] = G[a][b] = c;
		}

		// 调用 prim 方法求解最小生成树的权值并输出
		System.out.println(prim());

		// 输出存储在 demo 中的边权值
		for (int i = 0; i < m - 1; i++) {
			System.out.print(demo.get(i) + " ");
		}
	}

	// Prim 算法实现
	private static int prim() {
		// 初始化数组 lowcost 和 closest
		for (int i = 0; i < m; i++) {
			// 存储已经形成的生成树中某个顶点到 i 的最小权值
			// 默认无穷大
			lowcost[i] = INF;
			// 存储与顶点 i 最近的结点编号
			closest[i] = 0;
		}

		// 将第一个顶点加入生成树中,标记为 -1,表示在集合 U 中
		closest[0] = -1;

		int num = 0; // 处理第几条边
		int ans = 0; // 最小生成树的总权值
		int e = 0; // e 为最新加入最小生成树的的点

		// 每次加入一条边,直到加入 m-1 条边为止
		// (最小生成树,那总边数是节点数-1)
		while (num < m - 1) {
			int min_w = INF; // 当前找到的边的最小权值
			int min_num = -1; // 当前找到的最小权值的节点编号

			// 找到当前集合 U 中与集合 V 中最近的顶点
			for (int i = 0; i < m; i++) {
				// 如果 i 已经加入最小生成树,则不处理
				if (closest[i] != -1) {
					// 找到 e 与 i 的边的权值
					int temp = G[e][i];
					// 如果当前边的最短路径比之前最小生成树到 i 的最短路径小,则更新
					if (temp < lowcost[i]) {
						// 更新最小生成树到节点 i 的最短路径为 temp
						lowcost[i] = temp;
						// 更新 i 最近的(权值最小的邻接点) 为 e
						closest[i] = e;
					}
					// 如果当前边的权值,比之前记录的权值小,则更新
					if (lowcost[i] < min_w) {
						min_num = i; // 更新 e 最近节点的编号
						min_w = lowcost[min_num]; // 更新当前的最小权值
					}
				}
			}
			// 将找到的最小权值加入 demo 中
			ans += min_w;
			// 用于之后打印与每个顶点相邻的边的最小权值
			demo.add(min_w);
			// 下次从该顶点找到权值最小的边的节点
			e = min_num;
			// 将找到的顶点标记为已加入生成树的状态,即在集合 U 中
			closest[e] = -1;
			num++;
		}
		// 返回最小生成树的总权值
		return ans;
	}

}Kruskal
最小生成树(稀疏图,比较少的边)
java
import java.util.Arrays;
import java.util.Scanner;

public class Main {
    static int n, m;
    static int[] father; // 记录并查集中每个节点的父节点
    static Node[] Q; // 存储边的信息,包括起点、终点和权值

    static class Node {
        int x; // 边的起点
        int y; // 边的终点
        int k; // 边的权值

        public Node(int x, int y, int k) {
            this.x = x;
            this.y = y;
            this.k = k;
        }
    }

    public static void main(String[] args) {
        Scanner scanner = new Scanner(System.in);
        n = scanner.nextInt(); // 顶点数量
        m = scanner.nextInt(); // 边的数量

        father = new int[n + 1]; // 初始化并查集
        Q = new Node[m]; // 初始化边的数组

        int cont = 0, sum = 0, st = 0; // cont用于统计边的数量,sum为最小生成树的权值,st为边的数量

        // 读取边的信息,并统计所有边的权值总和
        for (int i = 0; i < m; i++) {
            int x = scanner.nextInt(); // 边的起点
            int y = scanner.nextInt(); // 边的终点
            int k = scanner.nextInt(); // 边的权值
            Q[i] = new Node(x, y, k); // 将边的信息存储到数组中
            cont += k; // 统计边的权值总和
        }

        Arrays.sort(Q, (a, b) -> a.k - b.k); // 根据边的权值进行排序

        for (int i = 1; i <= n; i++)
            father[i] = i; // 初始化并查集,每个顶点的父节点都是自己

        // 遍历所有边,并使用并查集找出最小生成树
        for (int i = 0; i < m; i++) {
            int tx = find(Q[i].x); // 找到起点的根节点
            int ty = find(Q[i].y); // 找到终点的根节点
            if (tx != ty) { // 如果起点和终点的根节点不相同,说明加入这条边不会形成环
                sum += Q[i].k; // 将这条边的权值加入到最小生成树的权值中
                st++; // 边的数量加一
                father[tx] = ty; // 将起点的根节点指向终点的根节点,表示它们在同一个连通分量中
                if (st == n - 1) // 如果边的数量等于顶点数量减一,说明最小生成树已经构建完成
                    break;
            }
        }

        System.out.println(sum); // 输出最小生成树的权值
    }

    // 并查集的查找函数,用于查找节点的根节点
    static int find(int x) {
        if (father[x] == x) // 如果节点的父节点就是它自己,说明它是根节点
            return x;
        return father[x] = find(father[x]); // 否则递归查找父节点,同时进行路径压缩
    }

}#构建二叉树
前序遍历+中序遍历构建二叉树
快速记忆:
- 前序的左右指针相遇或者中序的左右指针相遇,则终止。
- 否则拿到当前前序指针范围内的第一个节点,作为根节点
- 找到这个节点在中序遍历的位置(index)
- 接着算出当前中序的左边剩下那部份未处理(leftSize=index-inStart)
- 然后左节点的部分:中序 inStart = 原来的(inStart),而结束下标则为当前根节点(inEnd = Index),前序的起始下标则在原来基础上右移一位(preStart = preStart+1),终点则是当前右移后的起点加上中序左边剩余部分(preEnd=preStart+1+leftSize)。
- 右边则是:inStart:index+1,inEnd:不变,preStart:preStart+1+leftSize,preEnd:不变。
java
class TreeNode {
	int val;
	TreeNode left;
	TreeNode right;

	TreeNode(int x) {
		val = x;
	}
}


	/**
	 * 根据前序中序构建二叉树
	 *
	 * @param inorder  中序遍历
	 * @param inStart  中序开始的下标
	 * @param inEnd    中序结束的下标
	 * @param preorder 前序遍历
	 * @param preStart 前序开始的下标
	 * @param preEnd   前序结束的下标
	 * @return
	 */
	private static TreeNode buildTreeByPreAndInHelper(int[] inorder, int inStart, int inEnd, int[] preorder,
			int preStart, int preEnd) {
		System.out.println(preStart);
		if (preStart >= preEnd || inStart >= inEnd) {
			return null;
		}
		// 每次取前序遍历的第一个元素作为根节点
		TreeNode root = new TreeNode(preorder[preStart]);
		System.out.println(root.val + " " + preStart);
		// 从中序遍历中找到当前根节点的下标
		int index;
		for (index = inStart; index < inEnd; index++) {
			if (inorder[index] == root.val) {
				break;
			}
		}
		int leftSize = index - inStart;

		root.left = buildTreeByPreAndInHelper(
		inorder,
		inStart,
		index,
		preorder,
		preStart + 1,
		preStart + leftSize+1);

		root.right = buildTreeByPreAndInHelper(
		inorder,
		index + 1,
		inEnd,
		preorder,
		preStart + 1 + leftSize,
		preEnd);

		return root;
}中序遍历+后序遍历构建二叉树
快速记忆:中序部分下标的变化是是一样的,只不过后序是从后序的右指针位置获取根节点,以及左右节点的指针分别为:
- 起始指针 ~ 起始指针 + leftSize
- 起始指针+leftSize ~ 终点指针 - 1(左移)
java
	/**
	 * 根据中序后序构建二叉树
	 *
	 * @param inorder   中序遍历
	 * @param inStart   中序开始的下标
	 * @param inEnd     中序结束的下标
	 * @param postorder 后序遍历
	 * @param postStart 后序开始的下标
	 * @param postEnd   后序结束的下标
	 * @return
	 */
	private static TreeNode buildTreeByInAndPostHelper(int[] inorder, int inStart, int inEnd, int[] postorder,
			int postStart, int postEnd) {
		// 下标越界,则说明没有可处理的节点
		if (inStart >= inEnd || postStart >= postEnd) {
			return null;
		}

		// 每次取后序遍历中的最后一个节点作为根节点
		int rootVal = postorder[postEnd - 1];
		TreeNode root = new TreeNode(rootVal);

		// 在中序遍历中找到根节点的位置,
		int index;
		for (index = inStart; index < inEnd; index++) {
			if (inorder[index] == rootVal) {
				break;
			}
		}

		// 以中序遍历中的根节点位置为分界线,
		// 左边为左子树,右边为右子树

		// 当前根节点的左子树中节点个数
		int leftSize = index - inStart;

		// 递归构建左子树
		root.left = buildTreeByInAndPostHelper(
		inorder,
		inStart,
		index,
 		postorder,
		postStart,
		postStart + leftSize);

		// 递归构建右子树
		root.right = buildTreeByInAndPostHelper(
		inorder,
		index + 1,
		inEnd,
 		postorder,
		postStart + leftSize,
		postEnd - 1);

		return root;
}前序遍历构建二叉搜索树
java
private static TreeNode ininSearchTree(int start, int end, int[] preorder) {
	if (start >= end) {
		return null;
	}
	TreeNode root = new TreeNode();
	root.value = preorder[start];

	// 根据二叉搜索树特性,左子树的值比根节点的小,右子树比根节点的大
	// 找到第一个值比根节点大的,它的右边就是右子树部分
	int index;
	for (index = start + 1; index < end; index++) {
		if (root.value < preorder[index]) {
			break;
		}
	}
	root.left = ininSearchTree(start + 1, index, preorder);
	root.right = ininSearchTree(index, end, preorder);
	return root;
}二叉树遍历
快速记忆:
- 前:根(打印 val)左右
- 中:左根(打印 val)右
- 后:左右根(打印 val)
- 层:根放队列,然后顺序放左右节点进队列,接下来一趟循环遍历当前队列中所有节点(顺便打印 val),每个节点判断是否有左右节点,有的话继续放进队列,反复执行此操作,直到没有节点需要处理。
前序遍历
java
	/**
	 * 打印前序遍历 (根左右)
	 *
	 * @param root
	 */
	private static void preOrderTraversal(TreeNode root) {
		if (root != null) {
			System.out.print(root.val + " ");
		}
		if (root.left != null) {
			preOrderTraversal(root.left);
		}

		if (root.right != null) {
			preOrderTraversal(root.right);
		}
}中序遍历
java
	/**
	 * 打印中序遍历 (左根右)
	 *
	 * @param root
	 */
	private static void inOrderTraversal(TreeNode root) {
		if (root.left != null) {
			inOrderTraversal(root.left);
		}
		if (root != null) {
			System.out.print(root.val + " ");
		}
		if (root.right != null) {
			inOrderTraversal(root.right);
		}
}后序遍历
java
	/**
	 * 打印后序遍历 (左右根)
	 *
	 * @param root
	 */
	private static void postOrderTraversal(TreeNode root) {
		if (root.left != null) {
			postOrderTraversal(root.left);
		}
		if (root.right != null) {
			postOrderTraversal(root.right);
		}
		if (root != null) {
			System.out.print(root.val + " ");
		}
}层序遍历
java
	/**
	 * 打印层序遍历
	 *
	 * @param root
	 */
	private static void levelOrderTraversal(TreeNode root) {
		if (root == null) {
			return;
		}
		// 利用队列先进先出的特点,先对当前根节点打印,然后接着存放其左右节点
		// 之后每次进来都重新判断其左右节点非空,并对其进行处理
		// 与层序遍历的逻辑相符
		Queue<TreeNode> queue = new LinkedList<>();
		queue.offer(root);
		while (!queue.isEmpty()) {
			int size = queue.size();
//	        System.out.println("size的大小为:"+size);
			for (int i = 0; i < size; i++) {
				TreeNode node = queue.poll();
				System.out.print(node.val + " ");
				if (node.left != null) {
					queue.offer(node.left);
				}
				if (node.right != null) {
					queue.offer(node.right);
				}
			}
		}
	}