扩展板 RPC 框架开发
本文详细解析了扩展版 RPC 框架的三项基础能力:通过
全局配置加载
一、需求分析
在 RPC 框架运行的过程中,会涉及到很多的配置信息,比如注册中心的地址、序列化方式、网络服务器端口号等等。
之前的简易版 RPC 项目中,我们是在程序里硬编码了这些配置,不利于维护。
而且 RPC 框架是需要被其他项目作为服务提供者或者服务消费者引入的,我们应当允许引入框架的项目通过编写配置文件来 自定义配置。并且一般情况下,服务提供者和服务消费者需要编写相同的 RPC 配置。
因此,我们需要一套全局配置加载功能。能够让 RPC 框架轻松地从配置文件中读取配置,并且维护一个全局配置对象,便于框架快速获取到一致的配置。
二、设计方案
配置项
首先我们梳理需要的配置项,刚开始就一切从简,只提供以下几个配置项即可:
- name 名称
- version 版本号
- serverHost 服务器主机名
- serverPort 服务器端口号
后续随着框架功能的扩展,我们会不断地新增配置项,还可以适当地对配置项进行分组。
比如以下是一些常见的 RPC 框架配置项,仅做了解即可:
- 注册中心地址:服务提供者和服务消费者都需要指定注册中心的地址,以便进行服务的注册和发现。
- 服务接口:服务提供者需要指定提供的服务接口,而服务消费者需要指定要调用的服务接口。
- 序列化方式:服务提供者和服务消费者都需要指定序列化方式,以便在网络中传输数据时进行序列化和反序列化。
- 网络通信协议:服务提供者和服务消费者都需要选择合适的网络通信协议,比如 TCP、HTTP 等。
- 超时设置:服务提供者和服务消费者都需要设置超时时间,以便在调用服务时进行超时处理。
- 负载均衡策略:服务消费者需要指定负载均衡策略,以决定调用哪个服务提供者实例。
- 服务端线程模型:服务提供者需要指定服务端线程模型,以决定如何处理客户端请求。
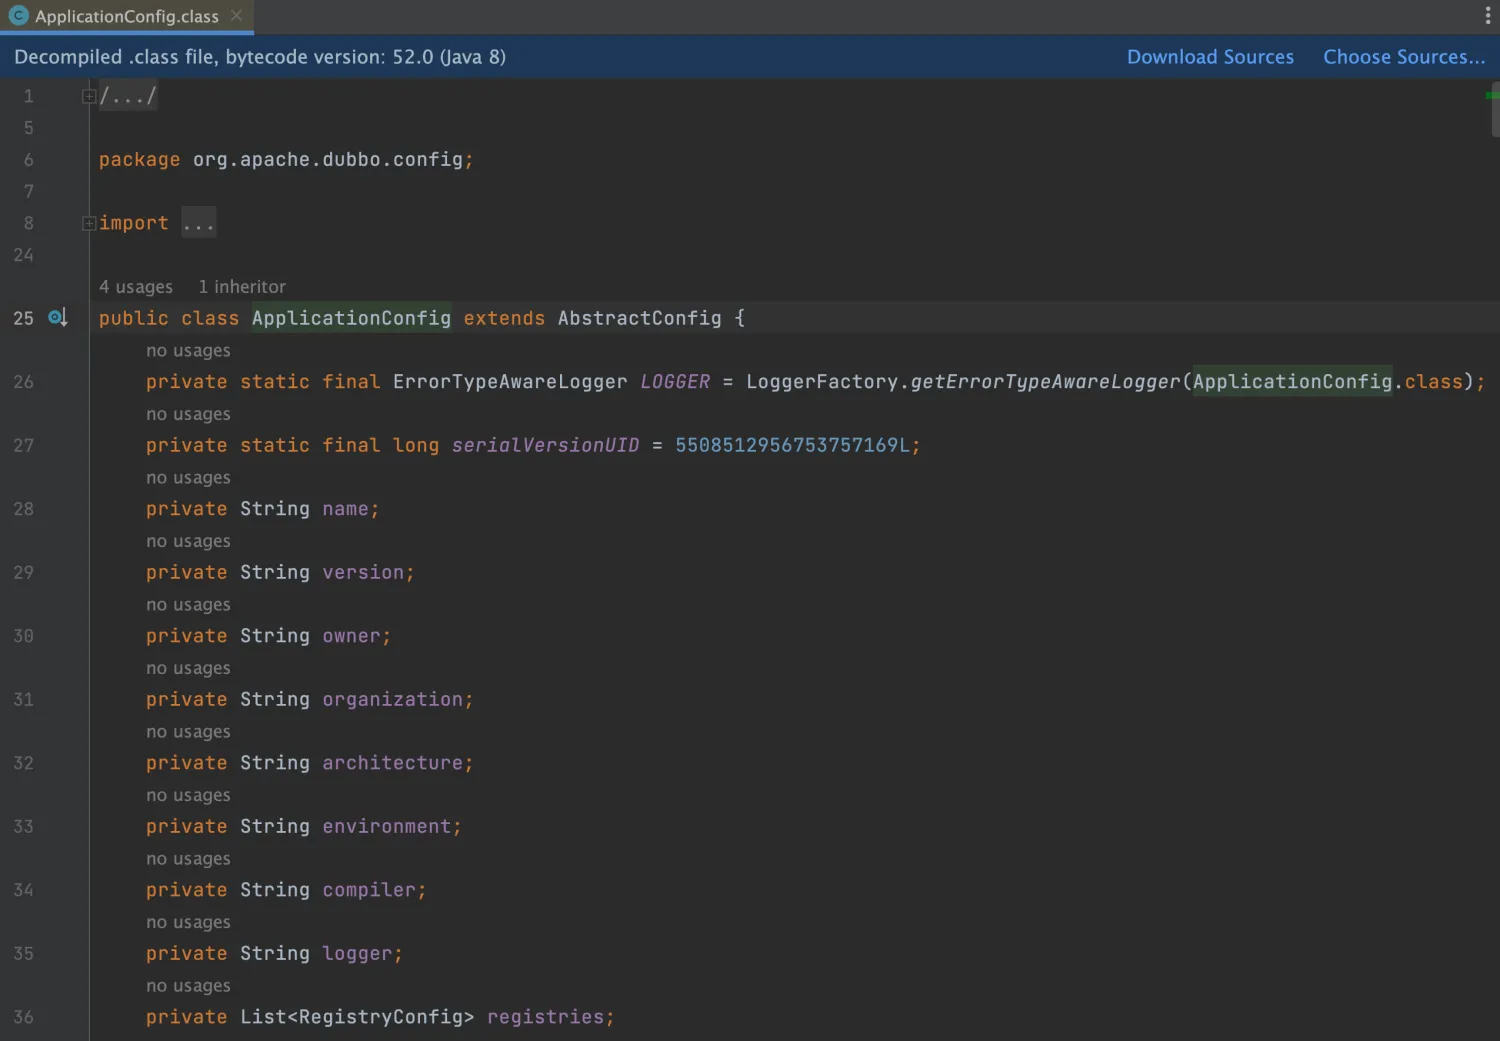
感兴趣的同学可以了解下 Dubbo RPC 框架的配置项,包括应用配置、注册中心配置、服务配置等。
参考 Dubbo:https://cn.dubbo.apache.org/zh-cn/overview/mannual/java-sdk/reference-manual/config/api/
任意项目引入 Dubbo 依赖后,就可以查看到 ApplicationConfig 配置类,如图:
读取配置文件
如何读取配置文件呢?这里可以使用 Java 的 Properties 类自行编写,但是更推荐使用一些第三方工具库,比如 Hutool 的 Setting 模块,可以直接读取指定名称的配置文件中的部分配置信息,并且转换成 Java 对象,非常方便。
参考官方文档:https://doc.hutool.cn/pages/Props/。
一般情况下,我们读取的配置文件名称为 application.properties,还可以通过指定文件名称后缀的方式来区分多环境,比如 application-prod.properties 表示生产环境、 application-test.properties 表示测试环境。
三、开发实现
1、项目初始化
1)先新建 salmon-rpc-core 模块,后面的 RPC 项目开发及扩展均在该项目进行。
可以直接复制 salmon-rpc-easy 的代码并改名,就得到了这个项目。
2)然后给项目引入日志库和单元测试依赖,便于后续开发:
xml
<!-- https://mvnrepository.com/artifact/ch.qos.logback/logback-classic -->
<dependency>
    <groupId>ch.qos.logback</groupId>
    <artifactId>logback-classic</artifactId>
    <version>1.3.12</version>
</dependency>
<dependency>
    <groupId>junit</groupId>
    <artifactId>junit</artifactId>
    <version>RELEASE</version>
    <scope>test</scope>
</dependency>
3)将 example-consumer 和 example-provider 项目引入的 RPC 依赖都替换成 salmon-rpc-core,代码如下:
xml
<dependency>
    <groupId>com.salmon</groupId>
    <artifactId>salmon-rpc-core</artifactId>
    <version>1.0-SNAPSHOT</version>
</dependency>
2、配置加载
1)在 config 包下新建配置类 RpcConfig,用于保存配置信息。
可以给属性指定一些默认值,完整代码如下:
java
package com.salmon.config;

import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;
}2)在 utils 包下新建工具类 ConfigUtils,作用是读取配置文件并返回配置对象,可以简化调用。
工具类应当尽量通用,和业务不强绑定,提高使用的灵活性。比如支持外层传入要读取的配置内容前缀、支持传入环境等。
完整代码如下:
java
package com.salmon.utils;

import cn.hutool.core.util.StrUtil;
import cn.hutool.setting.dialect.Props;

/**
 * 配置工具类
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ConfigUtils {

    /**
     * @param tClass 指定配置类
     * @param prefix 配置文件加载前缀
     * @param <T>    类
     * @return 配置对象
     */
    public static <T> T loadConfig(Class<T> tClass, String prefix) {
        return loadConfig(tClass, prefix, "");
    }

    /**
     * 加载配置
     *
     * @param tClass      指定配置类
     * @param prefix      配置文件加载前缀
     * @param environment 运行环境:如prod、dev、test
     * @param <T>         类
     * @return 配置对象
     */
    public static <T> T loadConfig(Class<T> tClass, String prefix, String environment) {
        StringBuilder configFileBuilder = new StringBuilder("application");
        if (StrUtil.isNotBlank(environment)) {
            configFileBuilder.append("-").append(environment);
        }
        // application-dev.properties
        configFileBuilder.append(".properties");
        Props props = new Props(configFileBuilder.toString());
        return props.toBean(tClass, prefix);
    }
}之后,调用 ConfigUtils 的静态方法就能读取配置了。
3)在 constant 包中新建 RpcConstant 接口,用于存储 RPC 框架相关的常量。
比如默认配置文件的加载前缀为 rpc:
java
package com.salmon.constant;

/**
 * RPC 相关常量
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class RpcConstant {

    /**
     * 默认配置文件加载前缀
     */
    String DEFAULT_CONFIG_PREFIX = "rpc";
}
可以读取到类似下面的配置:
properties
rpc.name=salmon
rpc.version=2.0
rpc.serverPort=8081
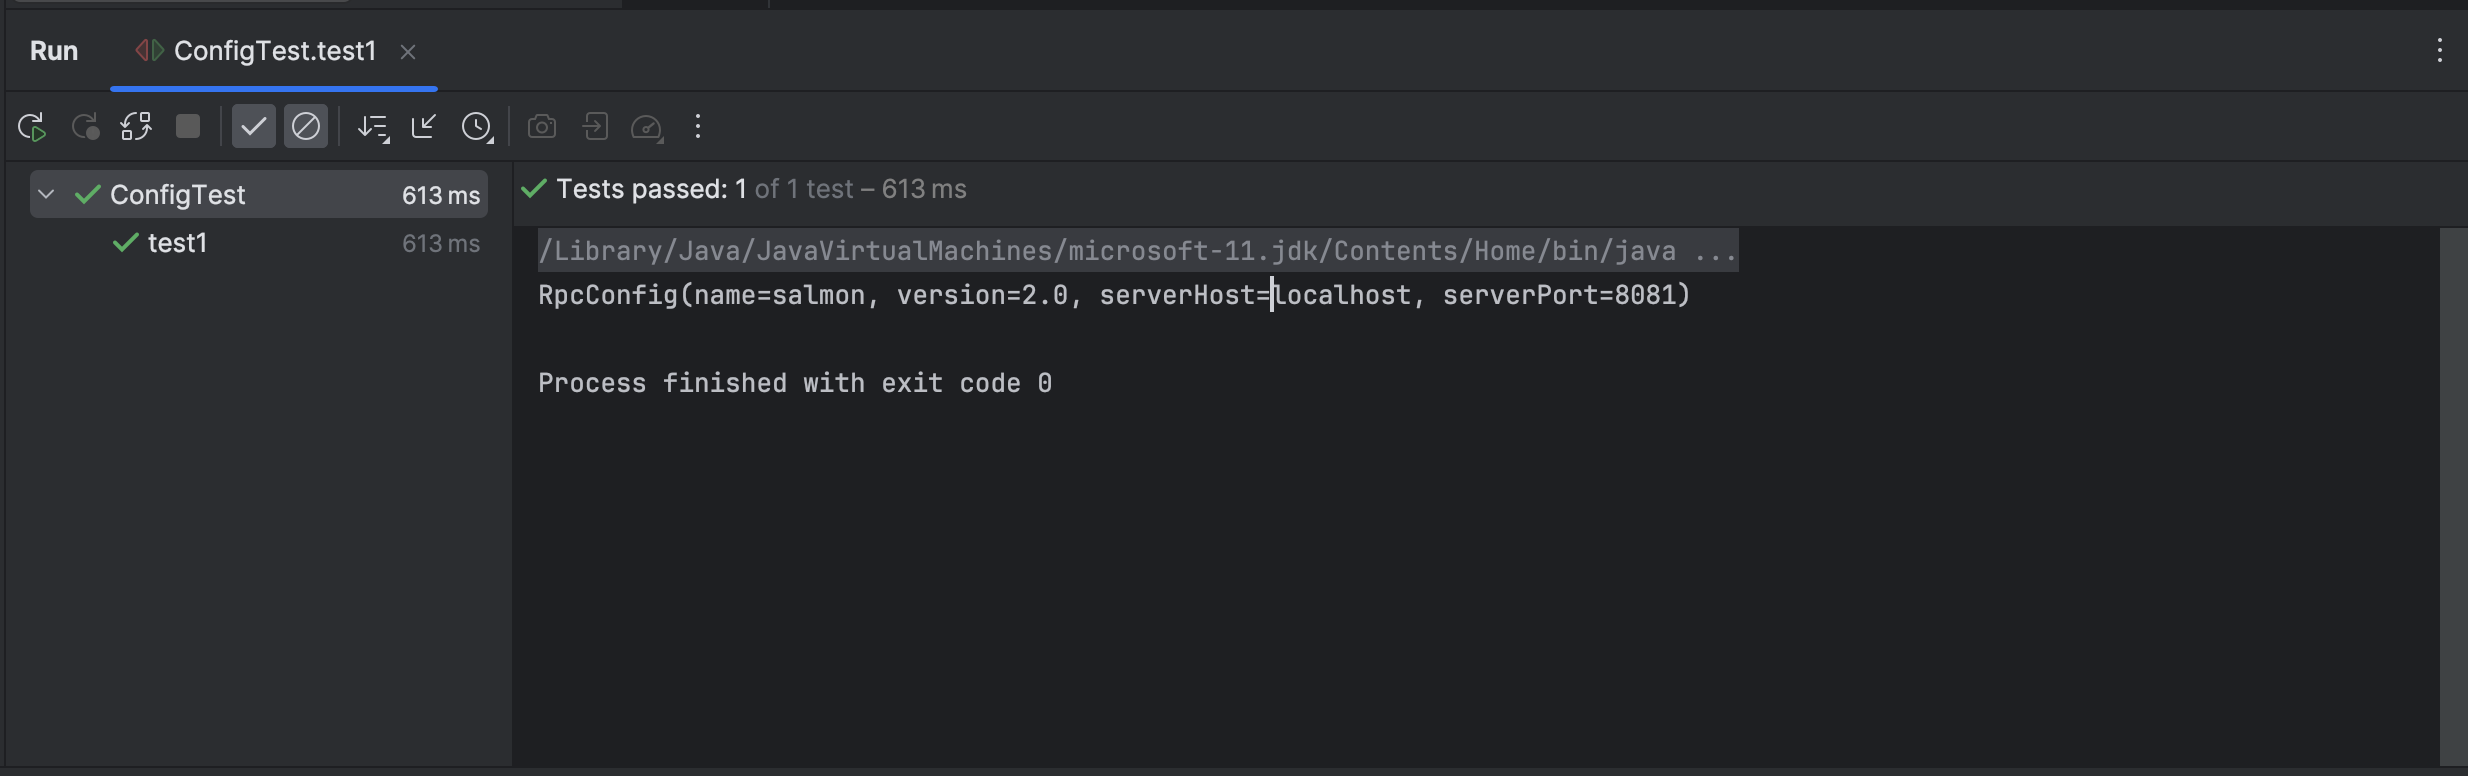
4)测试工具类,可以看到正常获取到数据
java
@Test
public void test1(){
    RpcConfig rpcConfig = ConfigUtils.loadConfig(RpcConfig.class, RpcConstant.DEFAULT_CONFIG_PREFIX);
    System.out.println(rpcConfig);
}
3、维护全局配置对象
RPC 框架中需要维护一个全局的配置对象。在引入 RPC 框架的项目启动时,从配置文件中读取配置并创建对象实例,之后就可以集中地从这个对象中获取配置信息,而不用每次加载配置时再重新读取配置、并创建新的对象,减少了性能开销。
使用设计模式中的 单例模式,就能够很轻松地实现这个需求了。
一般情况下,我们会使用 holder 来维护全局配置对象实例。在我们的项目中,可以换一个更优雅的命名,使用 RpcApplication 类作为 RPC 项目的启动入口、并且维护项目全局用到的变量。
完整代码如下:
java
package com.salmon;

import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.utils.ConfigUtils;
import lombok.extern.slf4j.Slf4j;

/**
 * RPC 框架应用
 * 相当于 holder,存放了项目全局用到的变量。双检锁单例模式实现
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Slf4j
public class RpcApplication {

    private static volatile RpcConfig rpcConfig;

    /**
     * 初始化
     */
    public static void init() {
        RpcConfig newRpcConfig;
        try {
            newRpcConfig = ConfigUtils.loadConfig(RpcConfig.class, RpcConstant.DEFAULT_CONFIG_PREFIX);
        } catch (Exception e) {
            // 配置加载失败,使用默认值
            newRpcConfig = new RpcConfig();
        }
        init(newRpcConfig);
    }

    /**
     * 传入自定义配置
     *
     * @param newRpcConfig 配置
     */
    public static void init(RpcConfig newRpcConfig) {
        rpcConfig = newRpcConfig;
        log.info("rpc init, config = {}", newRpcConfig);
    }

    /**
     * 获取配置
     *
     * @return 配置
     */
    public static RpcConfig getRpcConfig() {
        // 双检锁检测
        if (rpcConfig == null) {
            synchronized (RpcApplication.class) {
                if (rpcConfig == null) {
                    init();
                }
            }
        }
        return rpcConfig;
    }
}上述代码其实就是 双检锁单例模式 的经典实现,支持在获取配置时才调用 init 方法实现懒加载。
为了便于扩展,还支持自己传入配置对象;如果不传入,则默认调用前面写好的 ConfigUtils 来加载配置。
以后 RPC 框架内只需要写一行代码,就能正确加载到配置:
java
RpcConfig rpc = RpcApplication.getRpcConfig();四、测试
1、测试配置文件读取
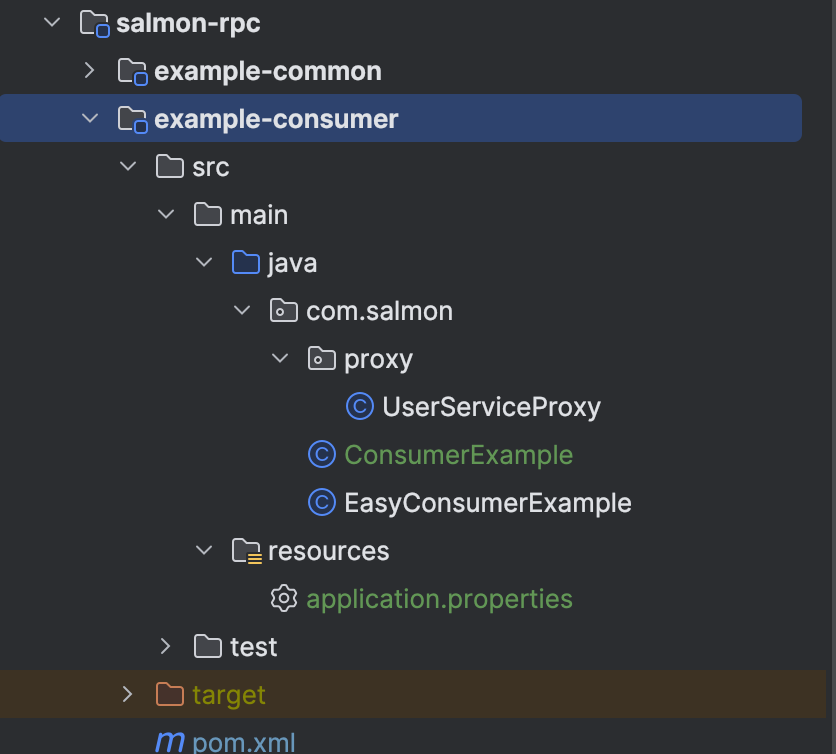
在 example-consumer 项目的 resources 目录下编写配置文件 application.properties,代码如下:
如图:
创建 ConsumerExample 作为扩展后 RPC 项目的示例消费者类,测试配置文件读取。
代码如下:
java
package com.salmon;

import com.salmon.config.RpcConfig;
import com.salmon.utils.ConfigUtils;

/**
 * 简易服务消费者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ConsumerExample {
    public static void main(String[] args) {
        RpcConfig rpc = ConfigUtils.loadConfig(RpcConfig.class, "rpc");
        System.out.println(rpc);
        ...
    }
}能够正确输出配置。
2、测试全局配置对象加载
在 example-provider 项目中创建 ProviderExample 服务提供者示例类,能够根据配置动态地在不同端口启动 web 服务。
代码如下:
java
package com.salmon;

import com.salmon.impl.UserServiceImpl;
import com.salmon.registry.LocalRegistry;
import com.salmon.server.HttpServer;
import com.salmon.server.impl.VertxHttpServerImpl;
import com.salmon.service.UserService;

/**
 * 简易服务提供者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ProviderExample {
    public static void main(String[] args) {
        // RPC 框架初始化
        RpcApplication.init();

        // 注册服务
        LocalRegistry.registry(UserService.class.getName(), UserServiceImpl.class);

        // 启动 web 服务
        HttpServer httpServer = new VertxHttpServerImpl();
        httpServer.doStart(RpcApplication.getRpcConfig().getServerPort());
    }
}五、扩展
提供以下扩展思路,可自行实现:
1)支持读取 application.yml、application.yaml 等不同格式的配置文件。
2)支持监听配置文件的变更,并自动更新配置对象。
参考思路:使用 Hutool 工具类的 props.autoLoad() 可以实现配置文件变更的监听和自动加载。
3)配置文件支持中文。
参考思路:需要注意编码问题
4)配置分组。后续随着配置项的增多,可以考虑对配置项进行分组。
参考思路:可以通过嵌套配置类实现。
接口 Mock
一、需求分析
什么是 Mock?
RPC 框架的核心功能是调用其他远程服务。但是在实际开发和测试过程中,有时可能无法直接访问真实的远程服务,或者访问真实的远程服务可能会产生不可控的影响,例如网络延迟、服务不稳定等。在这种情况下,就需要使用 mock 服务来模拟远程服务的行为,以便进行接口的测试、开发和调试。
mock 是指模拟对象,通常用于测试代码中,特别是在单元测试中,便于我们跑通业务流程。
举个例子,用户服务要调用订单服务,伪代码如下:
java
class UserServiceImpl {

    void test() {
        doSomething();
        orderService.order();
        doSomething();
    }
}
如果订单服务还没上线,那么这个流程就跑不通,只能先把调用订单服务的代码注释掉。
但如果给 orderService 设置一个模拟对象,调用它的 order 方法时,随便返回一个值,就能继续执行后续代码,这就是 mock 的作用。
为什么要支持 Mock?
虽然 mock 服务并不是 RPC 框架的核心能力,但是它的开发成本并不高。而且给 RPC 框架支持 mock 后,开发者就可以轻松调用服务接口、跑通业务流程,不必依赖真实的远程服务,提高使用体验,何乐而不为呢?
我们希望能够用最简单的方式 —— 比如一个配置,就让开发者使用 mock 服务。
二、设计方案
前面也提到了,mock 的本质就是为要调用的服务创建模拟对象。
如何创建模拟对象呢?
在 RPC 项目简易版中,我们就提到了一种动态创建对象的方法 —— 动态代理。之前是通过动态代理创建远程调用对象。同理,我们通过动态代理创建一个 调用方法时返回固定值 的对象,不就好了?
三、开发实现
1)我们可以支持开发者通过修改配置文件的方式开启 mock,那么首先给全局配置类 RpcConfig 新增 mock 字段,默认值为 false。
java
package com.salmon.config;

import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;
}2)在 Proxy 包下新增 MockServiceProxy 类,用于生成 mock 代理服务。
在这个类中,需要提供一个根据服务接口类型返回固定值的方法。
完整代码如下:
java
package com.salmon.proxy;

import lombok.extern.slf4j.Slf4j;

import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;

/**
 * Mock 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Slf4j
public class MockServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  the proxy instance that the method was invoked on
     * @param method the {@code Method} instance corresponding to
     *               the interface method invoked on the proxy instance.  The declaring
     *               class of the {@code Method} object will be the interface that
     *               the method was declared in, which may be a superinterface of the
     *               proxy interface that the proxy class inherits the method through.
     * @param args   an array of objects containing the values of the
     *               arguments passed in the method invocation on the proxy instance,
     *               or {@code null} if interface method takes no arguments.
     *               Arguments of primitive types are wrapped in instances of the
     *               appropriate primitive wrapper class, such as
     *               {@code java.lang.Integer} or {@code java.lang.Boolean}.
     * @return 方法返回的默认值
     * @throws Throwable
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 根据方法的返回值类型,生成特定的默认值对象
        Class<?> methodReturnType = method.getReturnType();
        log.info("mock invoke {}", method.getName());
        return getDefaultObject(methodReturnType);
    }

    /**
     * 生成指定类型的默认值对象(可自行完善默认值逻辑)
     *
     * @param type 返回值类型
     * @return 默认值
     */
    private Object getDefaultObject(Class<?> type) {
        // 基本类型
        if (type.isPrimitive()) {
            if (type == boolean.class) {
                return false;
            } else if (type == short.class) {
                return (short) 0;
            } else if (type == int.class) {
                return 0;
            } else if (type == long.class) {
                return 0L;
            }
        }
        // 对象类型
        return null;
    }
}在上述代码中,通过 getDefaultObject 方法,根据代理接口的 class 返回不同的默认值,比如针对 boolean 类型返回 false、对象类型返回 null 等。
3)给 ServiceProxyFactory 服务代理工厂新增获取 mock 代理对象的方法 getMockProxy。可以通过读取已定义的全局配置 mock 来区分创建哪种代理对象。
修改 `ServiceProxyFactory``,完整代码如下:
java
package com.salmon.proxy;

import com.salmon.RpcApplication;

import java.lang.reflect.Proxy;

/**
 * 服务代理工厂(用于创建代理对象)
 *
 * @author Salmon
 * @since 2024-04-26
 */
public class ServiceProxyFactory {

    /**
     * 根据服务类来获取代理对象
     *
     * @param serviceClass 代理的接口的 Class 对象
     * @param <T>          代理对象的目标类型
     * @return 代理对象
     */
    public static <T> T getProxy(Class<T> serviceClass) {
        if (RpcApplication.getRpcConfig().isMock()) {
            return getMockProxy(serviceClass);
        }
        return (T) Proxy.newProxyInstance(
                serviceClass.getClassLoader(),
                new Class[]{serviceClass},
                new ServiceProxy());
    }

    /**
     * 根据服务类来获取 Mock 代理对象
     *
     * @param serviceClass 代理的接口的 Class 对象
     * @param <T>          代理对象的目标类型
     * @return 代理对象
     */
    public static <T> T getMockProxy(Class<T> serviceClass) {
        return (T) Proxy.newProxyInstance(
                serviceClass.getClassLoader(),
                new Class[]{serviceClass},
                new MockServiceProxy()
        );
    }
}有些视频教程是把 mock 的逻辑写在之前的远程调用动态代理中,我会建议大家单独针对 mock 的场景写一套新的动态代理和代理工厂,不要和真实请求的代理逻辑混在一起。
四、测试
1)可以在 example-common 模块的 UserService 中写个具有默认实现的新方法。等下需要调用该方法来测试 mock 代理服务是否生效,即查看调用的是模拟服务还是真实服务。
代码如下:
java
package com.salmon.service;

import com.salmon.model.User;

/**
 * 用户服务
 *
 * @author Salmon
 * @since 2024-04-25
 */
public interface UserService {

    /**
     * 获取用户
     *
     * @param user 查询条件
     * @return 用户信息
     */
    User getUser(User user);

    /**
     * 新方法 - 获取数字
     *
     * @return 短整型数字
     */
    default short getNumber() {
        return 1;
    }
}2)修改示例服务消费者模块中的 application.properties 配置文件,将 mock 设置为 true:
properties
rpc.name=salmon
rpc.version=2.0
rpc.serverPort=8081
rpc.mock=true
3)修改 ConsumerExample 类,编写调用 userService.getNumber 的测试代码。
代码如下:
java
package com.salmon;

import com.salmon.model.User;
import com.salmon.proxy.ServiceProxyFactory;
import com.salmon.service.UserService;

/**
 * 简易服务消费者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ConsumerExample {
    public static void main(String[] args) {
        // 获取代理
        UserService userService = ServiceProxyFactory.getProxy(UserService.class);
        User user = new User();
        user.setName("Salmon");
        // 调用
        User newUser = userService.getUser(user);
        if (newUser != null) {
            System.out.println(user.getName());
        } else {
            System.out.println("user == null");
        }
        long number = userService.getNumber();
        System.out.println(number);
    }
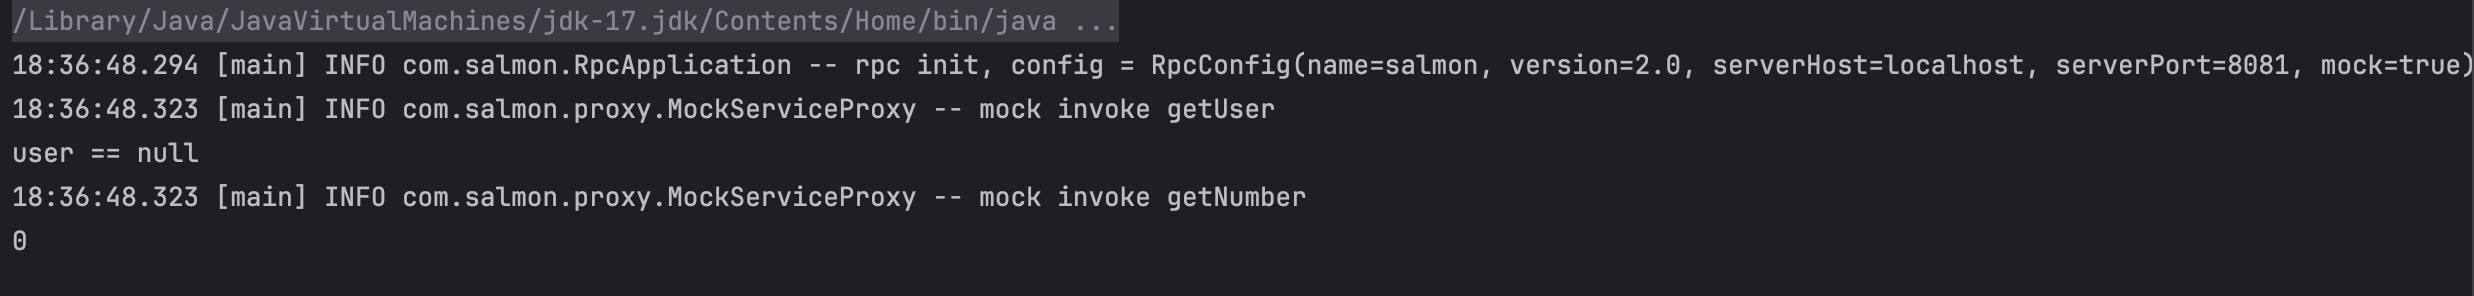
}应该能看到输出的结果值为 0,而不是 1,说明调用了 MockServiceProxy 模拟服务代理。当然也可以通过 Debug 的方式进行验证。
五、扩展
1)完善 Mock 的逻辑,支持更多返回类型的默认值生成。
参考思路:使用 Faker 之类的伪造数据生成库,来生成默认值。
序列化器与 SPI 机制
一、需求分析
在简易版中,我们已经讲过了序列化器的作用:无论是请求或响应,都会涉及参数的传输。而 Java 对象是存活在 JVM 虚拟机中的,如果想在其他位置存储并访问、或者在网络中进行传输,就需要进行序列化和反序列化。
我们还编写了通用的序列化器接口,并且已经实现了基于 Java 原生序列化的序列化器。但是对于一个完善的 RPC 框架,我们还要思考以下 3 个问题:
- 有没有更好的序列化器实现方式?
- 如何让使用框架的开发者指定使用的序列化器?
- 如何让使用框架的开发者自己定制序列化器?
二、设计方案
依次分析这三个问题的实现方案。
1、序列化器实现方式
我们所追求的 “更好的” 序列化器,可以是具有更高的性能、或者更小的序列化结果,这样就能够更快地完成 RPC 的请求和响应。
之前是为了方便,我们使用 Java 原生序列化实现序列化器,但这未必是最好的。市面上还有很多种主流的序列化方式,比如 JSON、Hessian、Kryo、protobuf 等。
下面简单列举它们的优缺点:
主流序列化方式对比
1)JSON
优点:
- 易读性好,可读性强,便于人类理解和调试。
- 跨语言支持广泛,几乎所有编程语言都有 JSON 的解析和生成库。
缺点:
- 序列化后的数据量相对较大,因为 JSON 使用文本格式存储数据,需要额外的字符表示键、值和数据结构。
- 不能很好地处理复杂的数据结构和循环引用,可能导致性能下降或者序列化失败。
2)Hessian:https://hessian.caucho.com/
优点:
- 二进制序列化,序列化后的数据量较小,网络传输效率高。
- 支持跨语言,适用于分布式系统中的服务调用。
缺点:
- 性能较 JSON 略低,因为需要将对象转换为二进制格式。
- 对象必须实现 Serializable 接口,限制了可序列化的对象范围。
3)Kryo:https://github.com/EsotericSoftware/kryo
优点:
- 高性能,序列化和反序列化速度快。
- 支持循环引用和自定义序列化器,适用于复杂的对象结构。
- 无需实现 Serializable 接口,可以序列化任意对象。
缺点:
- 不跨语言,只适用于 Java。
- 对象的序列化格式不够友好,不易读懂和调试。
4)Protobuf:
优点:
- 高效的二进制序列化,序列化后的数据量极小。
- 跨语言支持,并且提供了多种语言的实现库。
- 支持版本化和向前 / 向后兼容性。
缺点:
- 配置相对复杂,需要先定义数据结构的消息格式。
- 对象的序列化格式不易读懂,不便于调试。
这几种序列化方式中,大家最熟悉的莫过于 JSON 了,下边我将会实现 JSON、Kryo 和 Hessian 这三种序列化器。
2、动态使用序列化器
之前我们是在代码中硬编码了序列化器,比如:
java
Serializer serializer = new JdkSerializer();如果开发者想要替换为别的序列化器,就必须修改所有的上述代码,太麻烦了!
理想情况下,应该可以通过配置文件来指定使用的序列化器。在使用序列化器时,根据配置来获取不同的序列化器实例即可。
参考 Dubbo 替换序列化协议的方式:https://cn.dubbo.apache.org/zh-cn/overview/mannual/java-sdk/reference-manual/serialization/hessian/
这个操作并不难,我们只需要定义一个 序列化器名称 => 序列化器实现类对象 的 Map,然后根据名称从 Map 中获取对象即可。
3、自定义序列化器
如果开发者不想使用我们框架内置的序列化器,想要自己定义一个新的序列化器实现,但不能修改我们写好的框架代码,应该怎么办呢?
思路很简单:只要我们的 RPC 框架能够读取到用户自定义的类路径,然后加载这个类,作为 Serializer 序列化器接口的实现即可。
但是如何实现这个操作呢?
这就需要我们学习一个新的概念,也是 Java 中的重要特性 —— SPI 机制。
什么是 SPI?
SPI(Service Provider Interface)服务提供接口是 Java 的机制,主要用于实现模块化开发和插件化扩展。
SPI 机制允许服务提供者通过特定的配置文件将自己的实现注册到系统中,然后系统通过反射机制动态加载这些实现,而不需要修改原始框架的代码,从而实现了系统的解耦、提高了可扩展性。
一个典型的 SPI 应用场景是 JDBC(Java 数据库连接库),不同的数据库驱动程序开发者可以使用 JDBC 库,然后定制自己的数据库驱动程序。
此外,我们使用的主流 Java 开发框架中,几乎都使用到了 SPI 机制,比如 Servlet 容器、日志框架、ORM 框架、Spring 框架。所以这是 Java 开发者必须掌握的一个重要特性!
如何实现 SPI?
分为系统实现和自定义实现。
系统实现
其实 Java 内已经提供了 SPI 机制相关的 API 接口,可以直接使用,这种方式最简单。
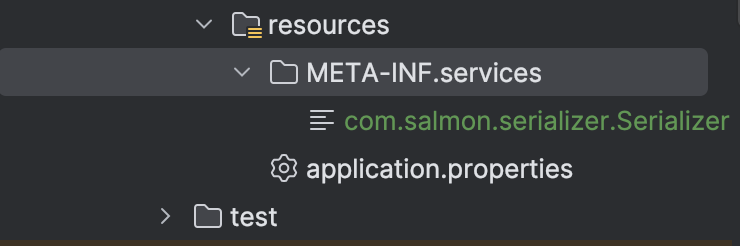
1)首先在 resources 资源目录下创建 META-INF/services 目录,并且创建一个名称为要实现的接口的空文件,如:com.salmon.serializer.Serializer
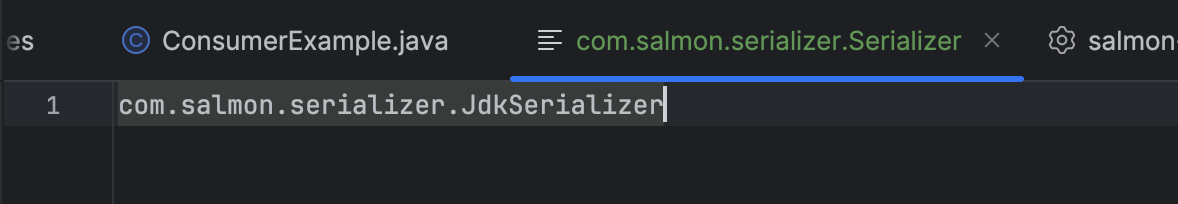
2)在文件中填写自己定制的接口实现类的 完整类路径,如图:
3)直接使用系统内置的 ServiceLoader 动态加载指定接口的实现类,代码如下:
java
// 指定序列化器
Serializer serializer = null;
ServiceLoader<Serializer> serviceLoader = ServiceLoader.load(Serializer.class);
for (Serializer service : serviceLoader) {
    serializer = service;
}
上述代码能够获取到所有文件中编写的实现类对象,选择一个使用即可。
自定义 SPI 实现
系统实现 SPI 虽然简单,但是如果我们想定制多个不同的接口实现类,就没办法在框架中指定使用哪一个了,也就无法实现我们 “通过配置快速指定序列化器” 的需求。
所以我们需要自己定义 SPI 机制的实现,只要能够根据配置加载到类即可。
比如读取如下配置文件,能够得到一个 序列化器名称 => 序列化器实现类对象 的映射,之后不就可以根据用户配置的序列化器名称动态加载指定实现类对象了么?
properties
jdk=com.salmon.serializer.JdkSerializer
hessian=com.salmon.serializer.HessianSerializer
json=com.salmon.serializer.JsonSerializer
kryo=com.salmon.serializer.KryoSerializer
三、开发实现
明确了方案后,我们来依次开发实现。
1、多种序列化器实现
我们要分别实现 JSON、Kryo 和 Hessian 这三种主流的序列化器。
1)首先给项目的 pom.xml 中引入依赖:
xml
<!-- 序列化 -->
<dependency>
    <groupId>com.fasterxml.jackson.core</groupId>
    <artifactId>jackson-databind</artifactId>
    <version>2.13.4.2</version>
</dependency>
<!-- https://mvnrepository.com/artifact/com.caucho/hessian -->
<dependency>
    <groupId>com.caucho</groupId>
    <artifactId>hessian</artifactId>
    <version>4.0.66</version>
</dependency>
<!-- https://mvnrepository.com/artifact/com.esotericsoftware/kryo -->
<dependency>
    <groupId>com.esotericsoftware</groupId>
    <artifactId>kryo</artifactId>
    <version>5.6.0</version>
</dependency>2)然后在序列化器包 serializer 中分别实现这三种序列化器,此处大家参考网上的代码、或者利用 AI 生成即可,不需要死记硬背。
JSON 序列化器
JSON 序列化器的实现相对复杂,要考虑一些对象转换的兼容性问题,比如 Object 数组在序列化后会丢失类型。
代码如下:
java
package com.salmon.serializer;

import com.fasterxml.jackson.databind.ObjectMapper;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;

import java.io.IOException;

/**
 * Json 序列化器
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class JsonSerializer implements Serializer {

    private static final ObjectMapper OBJECT_MAPPER = new ObjectMapper();

    @Override
    public <T> byte[] serialize(T object) throws IOException {
        return OBJECT_MAPPER.writeValueAsBytes(object);
    }

    @Override
    public <T> T deserialize(byte[] bytes, Class<T> classType) throws IOException {
        T obj = OBJECT_MAPPER.readValue(bytes, classType);
        if (obj instanceof RpcRequest) {
            return handleRequest((RpcRequest) obj, classType);
        }
        if (obj instanceof RpcResponse) {
            return handleResponse((RpcResponse) obj, classType);
        }
        return obj;
    }

    /**
     * 由于 Object 的原始对象会被擦除,导致反序列化时会被作为 LinkedHashMap 无法转换成原始对象,因此这里做了特殊处理
     *
     * @param rpcRequest rpc 请求
     * @param type       类型
     * @param <T>        反序列化的类型
     * @return 反序列化数据
     * @throws IOException IO异常
     */
    private <T> T handleRequest(RpcRequest rpcRequest, Class<T> type) throws IOException {
        Class<?>[] parameterTypes = rpcRequest.getParameterTypes();
        Object[] args = rpcRequest.getArgs();

        // 循环处理每个参数的类型
        for (int i = 0; i < parameterTypes.length; i++) {
            // 获取当前参数类型
            Class<?> aClass = parameterTypes[i];
            // 数据类型不匹配,则需要处理下类型
            if (!aClass.isAssignableFrom(args[i].getClass())) {
                // 重新对该参数数据做序列化
                byte[] argBytes = OBJECT_MAPPER.writeValueAsBytes(args[i]);
                // 再反序列化为正确类型
                args[i] = OBJECT_MAPPER.readValue(argBytes, aClass);
            }
        }
        return type.cast(rpcRequest);
    }

    /**
     * 由于 Object 的原始对象会被擦除,导致反序列化时会被作为 LinkedHashMap 无法转换成原始对象,因此这里做了特殊处理
     *
     * @param rpcResponse rpc 响应
     * @param type        类型
     * @param <T>         反序列化的类型
     * @return 反序列化数据
     * @throws IOException IO异常
     */
    private <T> T handleResponse(RpcResponse rpcResponse, Class<T> type) throws IOException {
        // 响应数据重新序列化
        byte[] dataBytes = OBJECT_MAPPER.writeValueAsBytes(rpcResponse.getData());
        // 根据响应携带的数据类型重新反序列化为正确的数据
        Object data = OBJECT_MAPPER.readValue(dataBytes, rpcResponse.getDataType());
        rpcResponse.setData(data);
        return type.cast(rpcResponse);
    }
}Kryo 序列化器
Kryo 本身是线程不安全的,所以需要使用 ThreadLocal 保证每个线程有一个单独的 Kryo 对象实例。
代码如下:
java
package com.salmon.serializer;

import com.esotericsoftware.kryo.Kryo;
import com.esotericsoftware.kryo.io.Input;
import com.esotericsoftware.kryo.io.Output;

import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
import java.io.IOException;

/**
 * Kryo 序列化器
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class KryoSerializer implements Serializer {

    /**
     * kryo 线程不安全,使用 ThreadLocal 保证每个线程只有一个 Kryo
     * 简单的回顾下:ThreadLocal 如果调用 get() 后无数据,会触发 initialValue() 方法的调用,以获取一个初始值
     */
    private static final ThreadLocal<Kryo> KRYO_THREAD_LOCAL = ThreadLocal.withInitial(() -> {
        Kryo kryo = new Kryo();
        // 设置动态动态序列化和反序列化类,不提前注册所有类(可能有安全问题)
        kryo.setRegistrationRequired(false);
        return kryo;
    });

    @Override
    public <T> byte[] serialize(T object) throws IOException {
        ByteArrayOutputStream byteArrayOutputStream = new ByteArrayOutputStream();
        Output output = new Output(byteArrayOutputStream);
        // 序列化数据
        KRYO_THREAD_LOCAL.get().writeObject(output, object);
        output.close();
        return byteArrayOutputStream.toByteArray();
    }

    @Override
    public <T> T deserialize(byte[] bytes, Class<T> type) throws IOException {
        ByteArrayInputStream byteArrayInputStream = new ByteArrayInputStream(bytes);
        Input input = new Input(byteArrayInputStream);
        // 反序列化数据
        T result = KRYO_THREAD_LOCAL.get().readObject(input, type);
        input.close();
        return result;
    }
}Hessian 序列化器
实现比较简单,完整代码如下:
java
package com.salmon.serializer;

import com.caucho.hessian.io.HessianInput;
import com.caucho.hessian.io.HessianOutput;

import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
import java.io.IOException;

/**
 * Hessian 序列化器
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class HessianSerializer implements Serializer {
    @Override
    public <T> byte[] serialize(T object) throws IOException {
        ByteArrayOutputStream byteArrayOutputStream = new ByteArrayOutputStream();
        HessianOutput hessianOutput = new HessianOutput(byteArrayOutputStream);
        hessianOutput.writeObject(object);
        return byteArrayOutputStream.toByteArray();
    }

    @Override
    public <T> T deserialize(byte[] bytes, Class<T> type) throws IOException {
        ByteArrayInputStream byteArrayInputStream = new ByteArrayInputStream(bytes);
        HessianInput hessianInput = new HessianInput(byteArrayInputStream);
        return (T) hessianInput.readObject();
    }
}2、动态使用序列化器
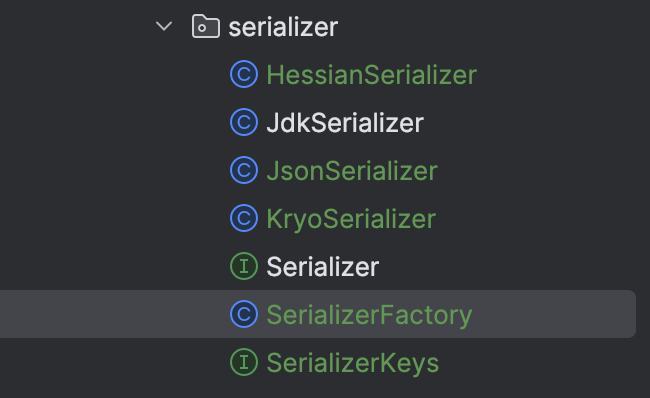
以下所有代码均放在 serializer 包下,便于维护和扩展。
1)首先定义序列化器名称的常量,使用接口实现。
代码如下:
java
package com.salmon.serializer;

/**
 * 序列化器键名
 *
 * @author Salmon
 * @since 2024-05-03
 */
public interface SerializerKeys {
    String JDK = "jdk";
    String JSON = "json";
    String KRYO = "kryo";
    String HESSIAN = "hessian";
}
2)定义序列化器工厂。
序列化器对象是可以复用的,没必要每次执行序列化操作前都创建一个新的对象。所以我们可以使用设计模式中的 工厂模式 + 单例模式 来简化创建和获取序列化器对象的操作。
序列化器工厂代码如下,使用 Map 来维护序列化器实例:
java
package com.salmon.serializer;

import java.util.HashMap;
import java.util.Map;

/**
 * 序列化器工厂(用于获取序列化器对象)
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class SerializerFactory {

    /**
     * 序列化映射(用于实现单例)
     */
    public static final Map<String, Serializer> KEY_SERIALIZER_MAP = new HashMap<String, Serializer>() {
        {
            put(SerializerKeys.JDK, new JdkSerializer());
            put(SerializerKeys.JSON, new JsonSerializer());
            put(SerializerKeys.KRYO, new KryoSerializer());
            put(SerializerKeys.HESSIAN, new HessianSerializer());
        }
    };

    /**
     * 默认序列化器
     */
    private static final Serializer DEFAULT_SERIALIZER = KEY_SERIALIZER_MAP.get("jdk");

    /**
     * 获取实例
     *
     * @param key 指定序列化器键名
     * @return 序列化实现实例
     */
    public static Serializer getInstance(String key) {
        return KEY_SERIALIZER_MAP.getOrDefault(key, DEFAULT_SERIALIZER);
    }

}
3)在全局配置类 RpcConfig 中补充序列化器的配置,代码如下:
java
package com.salmon.config;

import com.salmon.serializer.SerializerKeys;
import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;

    /**
     * 序列化器
     */
    private String serializer = SerializerKeys.JDK;
}4)动态获取序列化器。
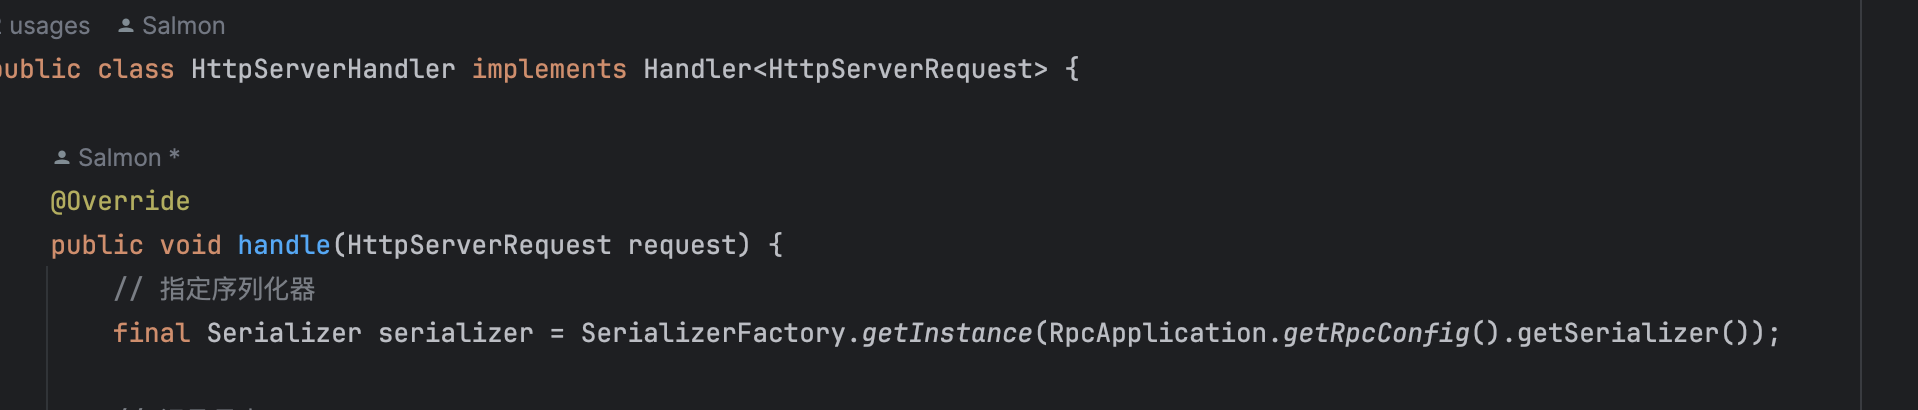
需要将之前代码中所有用到序列化器的位置更改为 “使用工厂 + 读取配置” 来获取实现类。
要更改的类:
- ServiceProxy
- HttpServerHandler
更改代码如下:
java
// 指定序列化器
final Serializer serializer = SerializerFactory.getInstance(RpcApplication.getRpcConfig().getSerializer());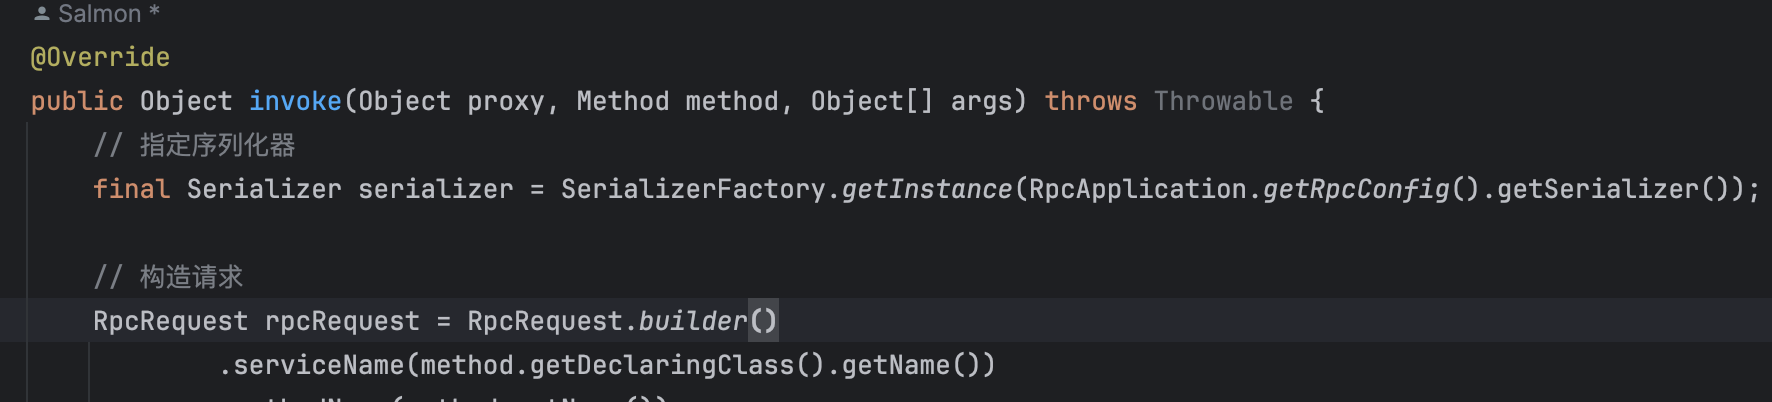
3、自定义序列化器
我们使用自定义的 SPI 机制实现,支持用户自定义序列化器并指定键名。
1)指定 SPI 配置目录。
系统内置的 SPI 机制会加载 resources 资源目录下的 META-INF/services 目录,那我们自定义的序列化器可以如法炮制,改为读取 META-INF/rpc 目录。
我们还可以将 SPI 配置再分为系统内置 SPI 和用户自定义 SPI,即目录如下:
- 用户自定义 SPI:
META-INF/rpc/custom。用户可以在该目录下新建配置,加载自定义的实现类。 - 系统内置 SPI:
META-INF/rpc/system。RPC 框架自带的实现类,比如我们之前开发好的JdkSerializer。
这样一来,所有接口的实现类都可以通过 SPI 动态加载,不用在代码中硬编码 Map 来维护实现类了。
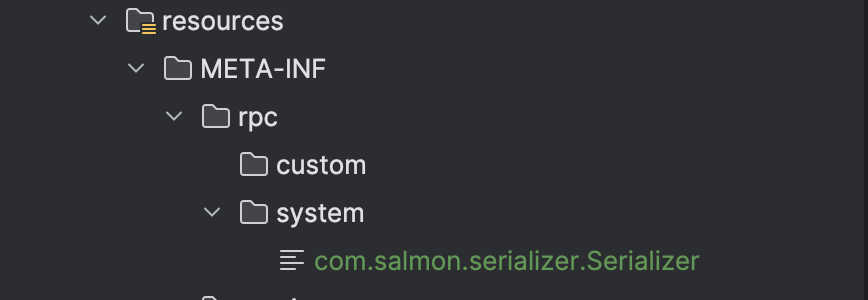
让我们编写一个系统扩展配置文件,内容为我们之前写好的序列化器。
文件名称为 com.salmon.serializer.Serializer,如图:
代码如下:
properties
jdk=com.salmon.serializer.JdkSerializer
hessian=com.salmon.serializer.HessianSerializer
json=com.salmon.serializer.JsonSerializer
kryo=com.salmon.serializer.KryoSerializer
2)编写 SpiLoader 加载器。
相当于一个工具类,提供了读取配置并加载实现类的方法。
关键实现如下:
- 用 Map 来存储已加载的配置信息
键名 => 实现类。 - 扫描指定路径,读取每个配置文件,获取到
键名 => 实现类信息并存储在 Map 中。 - 定义获取实例方法,根据用户传入的接口和键名,从 Map 中找到对应的实现类,然后通过反射获取到实现类对象。可以维护一个对象实例缓存,创建过一次的对象从缓存中读取即可。
java
package com.salmon.spi;

import cn.hutool.core.io.resource.ResourceUtil;
import com.salmon.serializer.Serializer;
import lombok.extern.slf4j.Slf4j;

import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.lang.reflect.InvocationTargetException;
import java.net.URL;
import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;

/**
 * SPI 加载器(支持键值对映射)
 *
 * @author Salmon
 * @since 2024-05-03
 */
@Slf4j
public class SpiLoader {
    /**
     * 存储已加载的类:接口名 =>(key => 实现类)
     */
    private static Map<String, Map<String, Class<?>>> LOADER_MAP = new ConcurrentHashMap<>();

    /**
     * 对象实例缓存(避免重复 new),类路径 => 对象实例,单例模式
     */
    private static Map<String, Object> INSTANCE_CACHE = new ConcurrentHashMap<>();

    /**
     * 系统 SPI 目录
     */
    private static final String RPC_SYSTEM_SPI_DIR = "META-INF/rpc/system/";

    /**
     * 用户自定义 SPI 目录
     */
    private static final String RPC_CUSTOM_SPI_DIR = "META-INF/rpc/custom/";

    /**
     * 扫描路径
     */
    private static final String[] SCAN_DIRS = new String[]{RPC_SYSTEM_SPI_DIR, RPC_CUSTOM_SPI_DIR};

    /**
     * 动态加载的类列表
     */
    private static final List<Class<?>> LOAD_CLASS_LIST = Arrays.asList(Serializer.class);


    /**
     * 加载所有类型
     */
    public static void loadAll() {
        log.info("加载所有 SPI");
        for (Class<?> aClass : LOAD_CLASS_LIST) {
            load(aClass);
        }
    }

    /**
     * 加载某个类型
     *
     * @param loadClass 待加载的类
     */
    public static Map<String, Class<?>> load(Class<?> loadClass) {
        log.info("加载类型为 {} 的 SPI", loadClass.getName());
        // 扫描路径,用户自定义的 SPI 优先级高于系统 SPI
        Map<String, Class<?>> keyClassMap = new HashMap<>();
        for (String scanDir : SCAN_DIRS) {
            // 获取该类型的实现类配置文件
            List<URL> resources = ResourceUtil.getResources(scanDir + loadClass.getName());
            // 读取每个资源文件
            for (URL resource : resources) {
                try {
                    InputStreamReader inputStreamReader = new InputStreamReader(resource.openStream());
                    BufferedReader bufferedReader = new BufferedReader(inputStreamReader);
                    String line;
                    // 读取每一行
                    while ((line = bufferedReader.readLine()) != null) {
                        String[] strArray = line.split("=");
                        if (strArray.length > 1) {
                            // 实现类关键字 如:jdk
                            String key = strArray[0];
                            // 实现类全路径名称 如:com.salmon.serializer.JdkSerializer
                            String className = strArray[1];
                            // key -> 实现类
                            keyClassMap.put(key, Class.forName(className));
                        }
                    }
                } catch (Exception e) {
                    log.error("spi resource load error", e);
                }
            }
        }
        // 接口名称 -> (key -> 实现类)
        LOADER_MAP.put(loadClass.getName(), keyClassMap);
        return keyClassMap;
    }


    /**
     * 获取某个接口的实例
     *
     * @param tClass 接口类型
     * @param key    指定实现类
     * @param <T>    实现类类型
     * @return 实现类实例
     */
    public static <T> T getInstance(Class<?> tClass, String key) {
        String tClassName = tClass.getName();
        Map<String, Class<?>> keyClassMap = LOADER_MAP.get(tClassName);
        if (keyClassMap == null) {
            throw new RuntimeException(String.format("SpiLoader 未加载 %s 类型", tClassName));
        }
        if (!keyClassMap.containsKey(key)) {
            throw new RuntimeException(String.format("SpiLoader 的 %s 不存在 key=%s 的类型", tClassName, key));
        }
        // 获取到要加载的实现类型
        Class<?> implClass = keyClassMap.get(key);
        // 从实例缓存中加载指定类型的实例
        String implClassName = implClass.getName();
        if (!INSTANCE_CACHE.containsKey(implClassName)) {
            try {
                INSTANCE_CACHE.put(key, implClass.getDeclaredConstructor().newInstance());
            } catch (InvocationTargetException | NoSuchMethodException | IllegalAccessException |
                     InstantiationException e) {
                String errorMsg = String.format("%s 类实例化失败", implClassName);
                throw new RuntimeException(errorMsg, e);
            }
        }
        return (T) INSTANCE_CACHE.get(implClassName);
    }

}上述代码中,虽然提供了 loadAll 方法,扫描所有路径下的文件进行加载,但其实没必要使用。更推荐使用 load 方法,按需加载指定的类。
注意,上述代码中获取配置文件是使用了 ResourceUtil.getResources,而不是通过文件路径获取。因为如果框架作为依赖被引入,是无法得到正确文件路径的。
3)重构序列化器工厂。
之前,我们是通过在工厂中硬编码 HashMap 来存储序列化器和实现类的,有了 SPI 后,就可以改为从 SPI 加载指定的序列化器对象。
完整代码如下:
java
package com.salmon.serializer;

import cn.hutool.core.util.StrUtil;
import com.salmon.spi.SpiLoader;

/**
 * 序列化器工厂(用于获取序列化器对象)
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class SerializerFactory {

    static {
        SpiLoader.load(Serializer.class);
    }

    /**
     * 默认序列化器
     */
    private static final Serializer DEFAULT_SERIALIZER = new JdkSerializer();

    /**
     * 获取实例
     *
     * @param key 指定序列化器键名
     * @return 序列化实现实例
     */
    public static Serializer getInstance(String key) {
        if (StrUtil.isBlank(key)) {
            return DEFAULT_SERIALIZER;
        }
        return SpiLoader.getInstance(Serializer.class, key);
    }

}使用静态代码块,在工厂首次加载时,就会调用 SpiLoader 的 load 方法加载序列化器接口的所有实现类,之后就可以通过调用 getInstance 方法获取指定的实现类对象了。
四、测试
1、SPI 加载测试
修改框架 custom 和 system 下的 SPI 配置文件,任意指定键名和实现类路径,验证能否正常加载。
比如下图的配置:
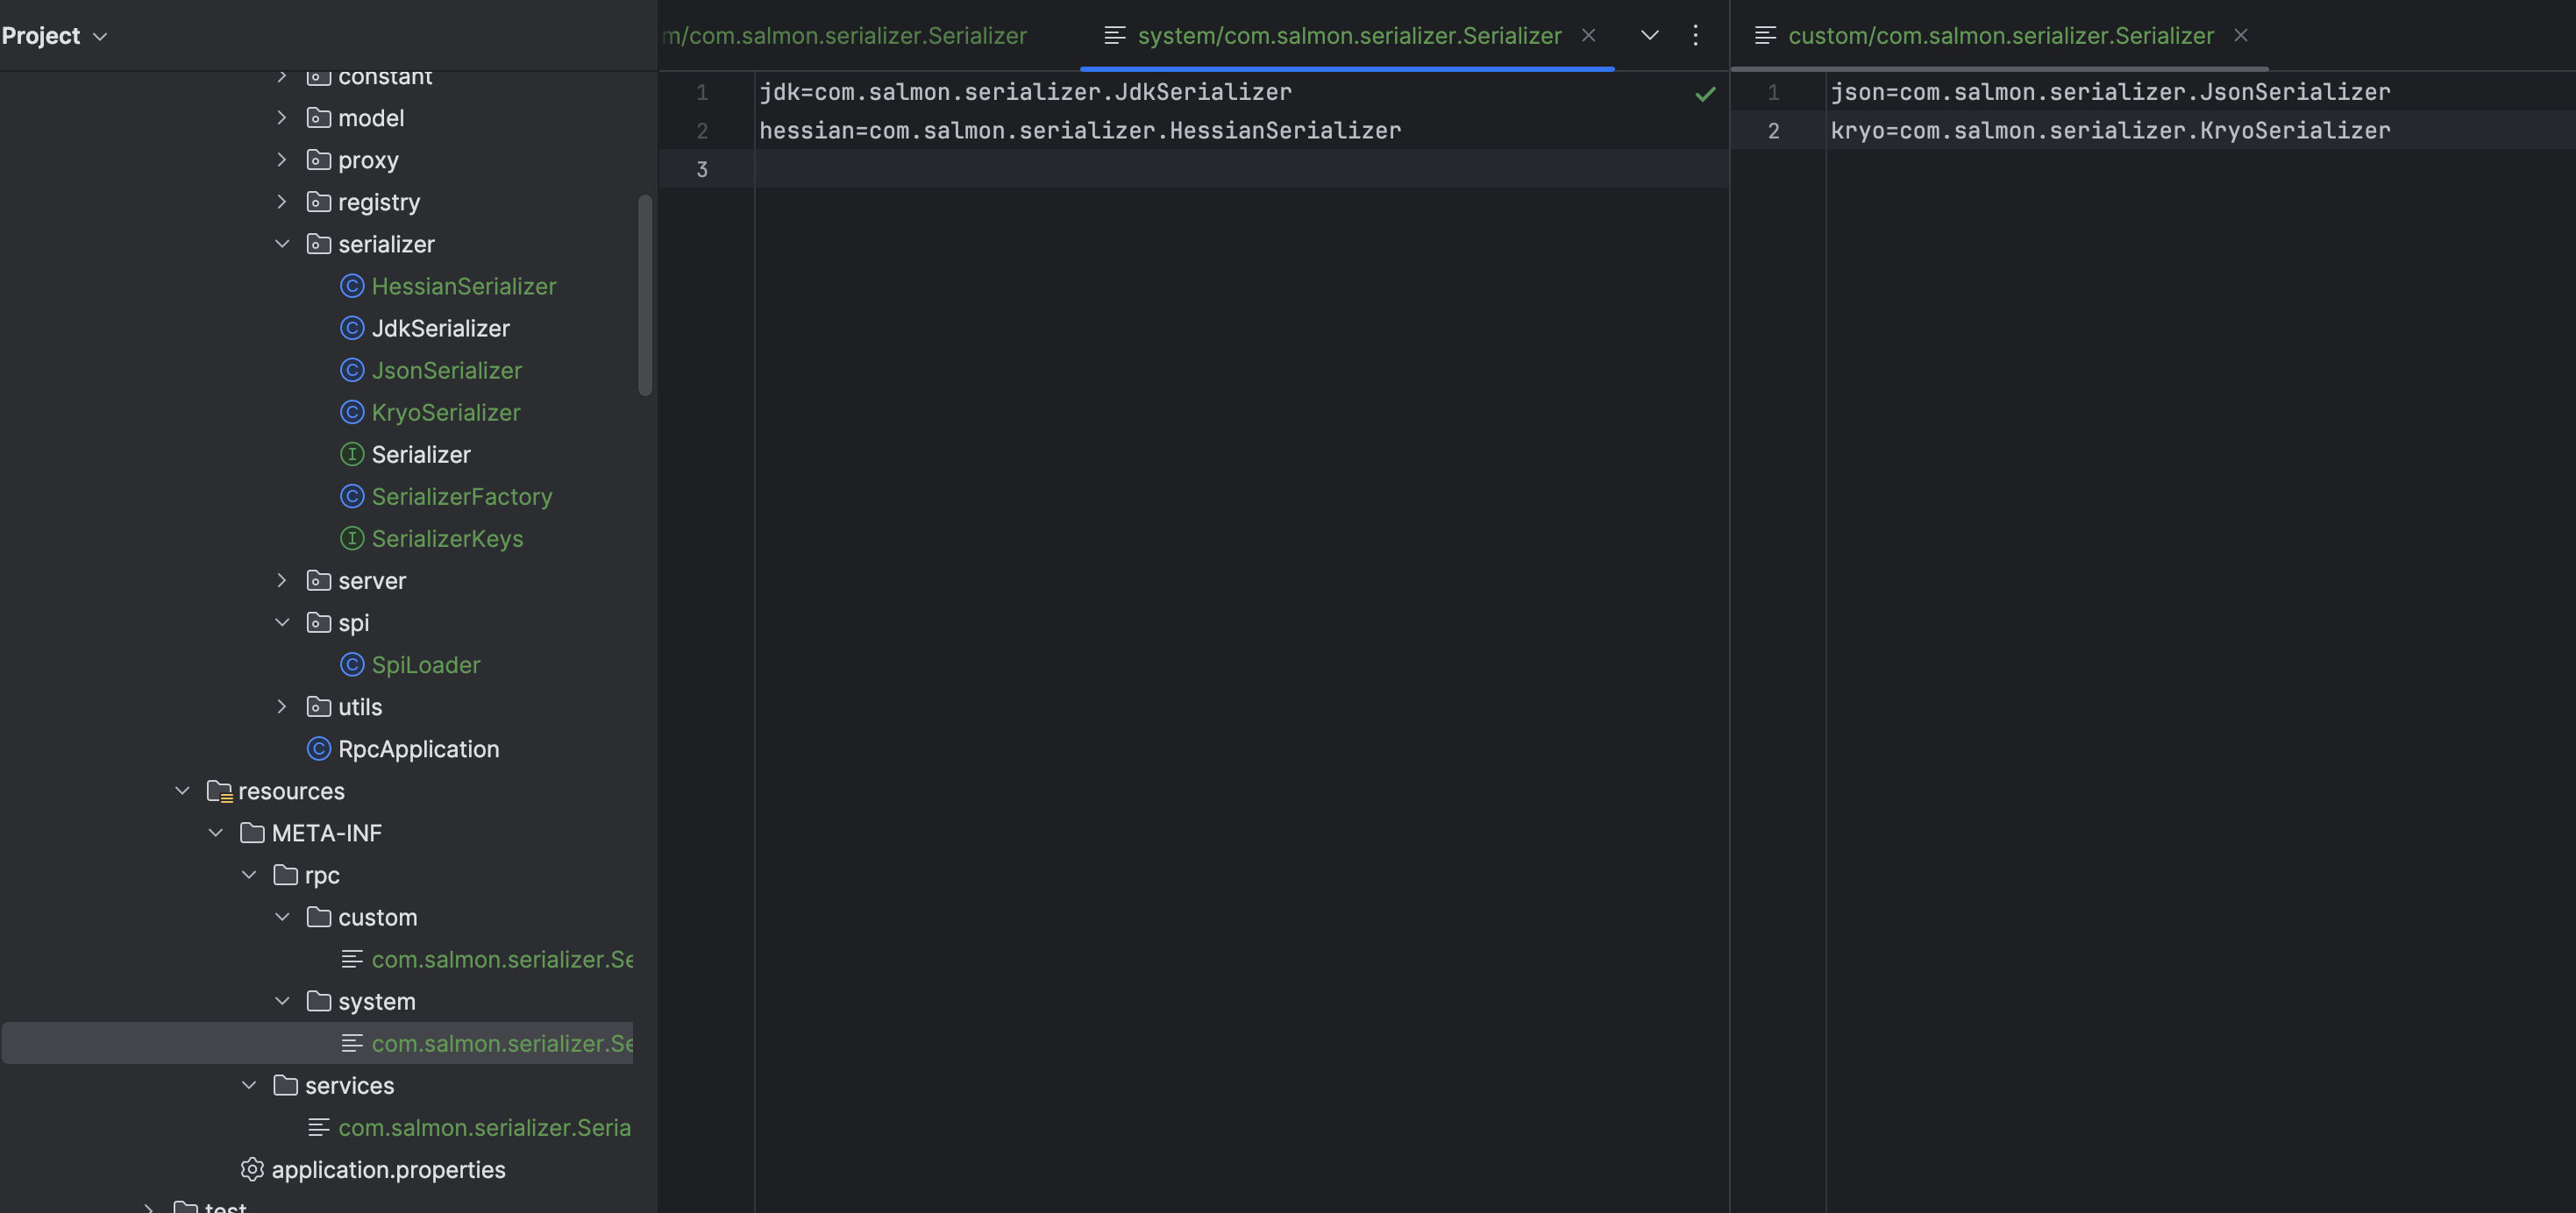
还可以进行如下测试:
- 分别测试正常(存在 key)和异常(不存在 key)的情况
- 测试 key 相同时,自定义配置能否覆盖系统配置
2、完整测试
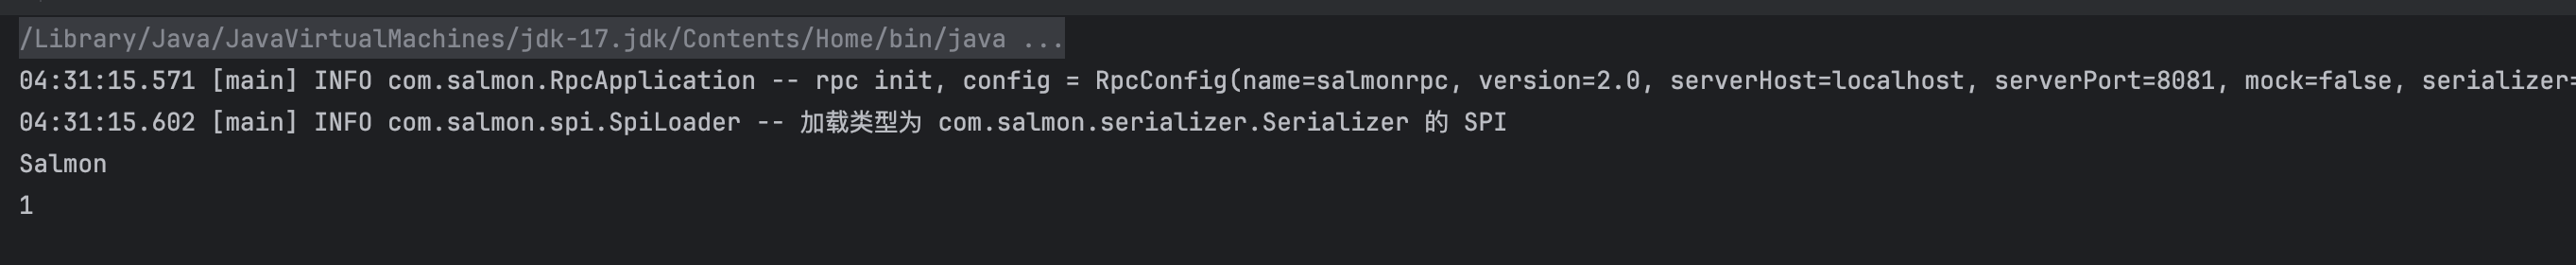
1)修改消费者和生产者示例项目中的配置文件,指定不同的序列化器,比如 hessian:
properties
rpc.name=salmonrpc
rpc.version=2.0
rpc.mock=false
rpc.serializer=hessian
2)然后依次启动生产者和消费者,验证能否正常完成 RPC 请求和响应。
3、自定义序列化器
之后,我们如果要实现自定义的序列化器,只需要进行以下步骤:
- 写一个类实现 Serializer 接口
- 在 custom 目录下编写 SPI 配置文件,加载自己写的实现类
五、扩展
1)实现更多不同协议的序列化器。
参考思路:由于序列化器是单例,要注意序列化器的线程安全性(比如 Kryo 序列化库),可以使用 ThreadLocal。
2)序列化器工厂可以使用懒加载(懒汉式单例)的方式创建序列化器实例。
参考思路:目前是通过 static 静态代码块初始化的。
3)SPI Loader 支持懒加载,获取实例时才加载对应的类。
参考思路:可以使用双检索单例模式。
注册中心基本实现
一、需求分析
RPC 框架的一个核心模块是注册中心,目的是帮助服务消费者获取到服务提供者的调用地址,而不是将调用地址硬编码到项目中。
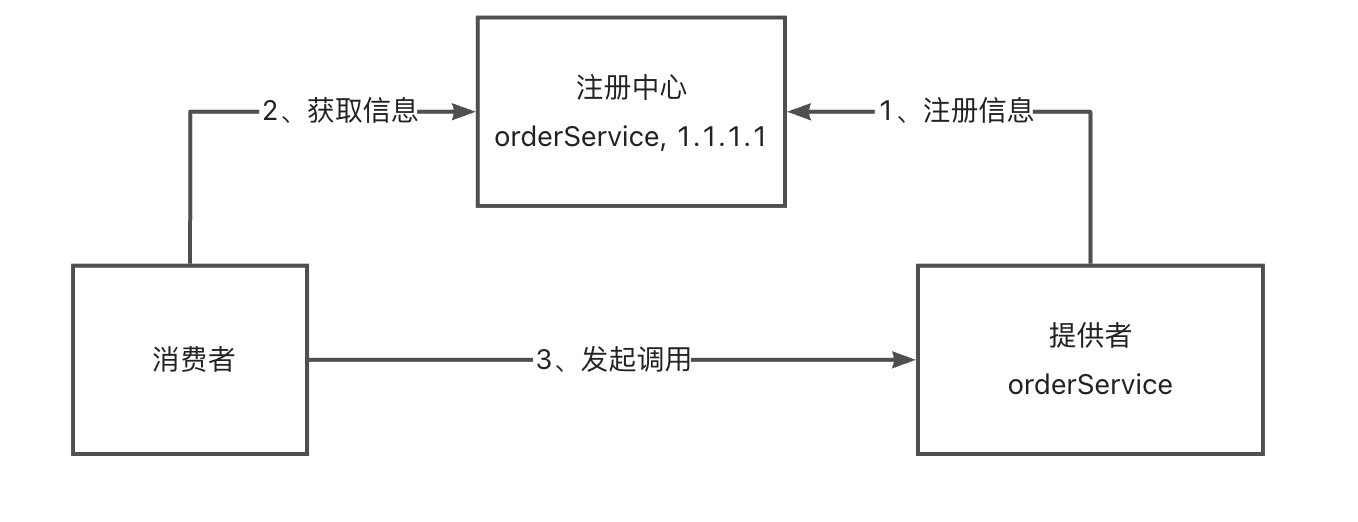
接下来,我们先来实现一个具有基本功能的注册中心,跑通注册中心的流程,之后再优化。
二、设计方案
注册中心核心能力
我们先明确注册中心的几个实现关键(核心能力):
- 数据分布式存储:集中的注册信息数据存储、读取和共享
- 服务注册:服务提供者上报服务信息到注册中心
- 服务发现:服务消费者从注册中心拉取服务信息
- 心跳检测:定期检查服务提供者的存活状态
- 服务注销:手动剔除节点、或者自动剔除失效节点
- 更多优化点:比如注册中心本身的容错、服务消费者缓存等。
技术选型
明确了注册中心的核心能力后,我们可以根据这些能力进行技术选型。
第一点是最重要的,我们首先需要一个能够集中存储和读取数据的中间件。此外,它还需要有数据过期、数据监听的能力,便于我们移除失效节点、更新节点列表等。
此外,对于注册中心的技术选型,我们还要考虑它的性能、高可用性、高可靠性、稳定性、数据一致性、社区的生态和活跃度等。注册中心的可用性和可靠性尤其重要,因为一旦注册中心本身都挂了,会影响到所有服务的调用。
主流的注册中心实现中间件有 ZooKeeper、Redis 等。在本次 RPC 框架教程中,我们使用云原生中间件 Etcd 来实现注册中心。
Etcd 入门
Etcd 介绍
GitHub:https://github.com/etcd-io/etcd
Etcd 是一个 Go 语言实现的、开源的、分布式 的键值存储系统,它主要用于分布式系统中的服务发现、配置管理和分布式锁等场景。
提到 Go 语言实现,有经验的同学应该就能想到,Etcd 的性能是很高的,而且它和云原生有着密切的关系,通常被作为云原生应用的基础设施,存储一些元信息。比如经典的容器管理平台 k8s 就使用了 Etcd 来存储集群配置信息、状态信息、节点信息等。
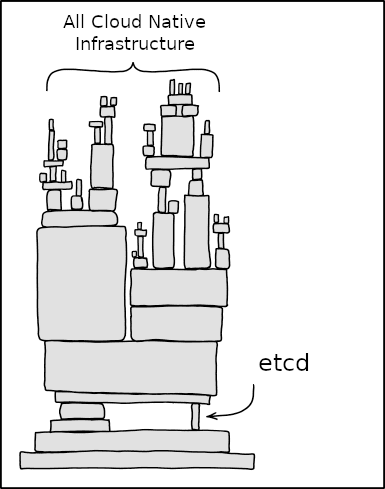
除了性能之外,Etcd 采用 Raft 一致性算法来保证数据的一致性和可靠性,具有高可用性、强一致性、分布式特性等特点。
最可气的是,Etcd 还非常简单易用!提供了简单的 API、数据的过期机制、数据的监听和通知机制等,完美满足注册中心的实现诉求。
Etcd 的入门成本是极低的,只要你学过 Redis、ZooKeeper 或者对象存储中的一个,就能够很快理解 Etcd 并投入实战运用。我们学知识的一个技巧,就是把新知识和老知识进行类比和关联。
Etcd 数据结构与特性
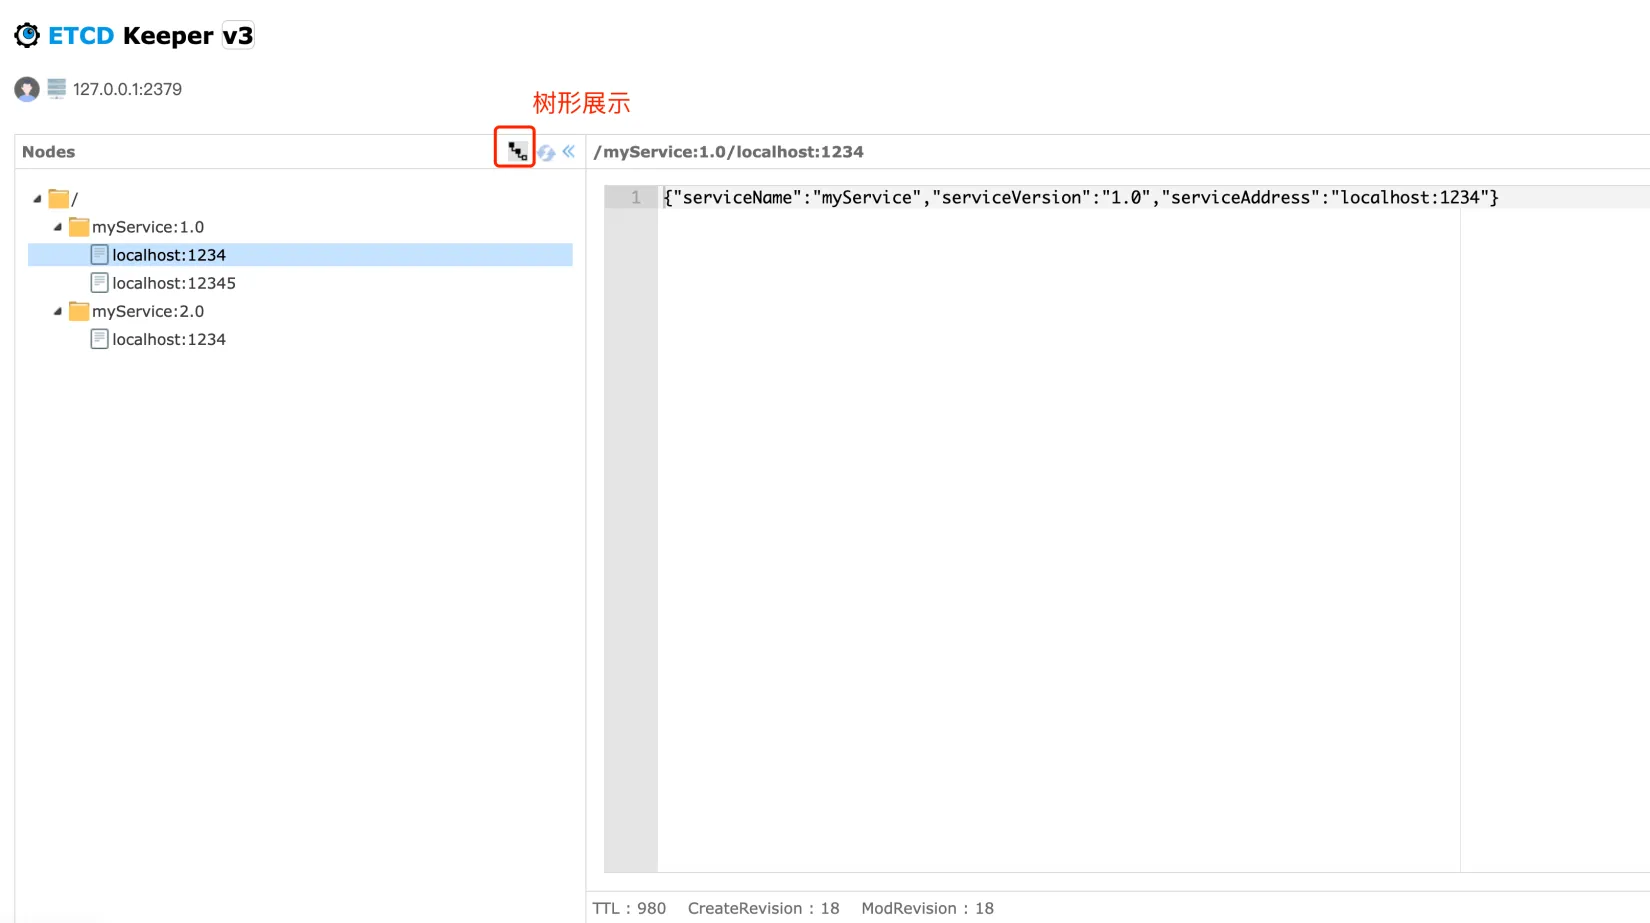
Etcd 在其数据模型和组织结构上更接近于 ZooKeeper 和对象存储,而不是 Redis。它使用层次化的键值对来存储数据,支持类似于文件系统路径的层次结构,能够很灵活地单 key 查询、按前缀查询、按范围查询。
如下图:
Etcd 的核心数据结构包括:
- Key(键):Etcd 中的基本数据单元,类似于文件系统中的文件名。每个键都唯一标识一个值,并且可以包含子键,形成类似于路径的层次结构。
- Value(值):与键关联的数据,可以是任意类型的数据,通常是字符串形式。
只有 key、value,是不是比 Redis 好理解多了?我们可以将数据序列化后写入 value。
Etcd 有很多核心特性,其中,应用较多的特性是:
- Lease(租约):用于对键值对进行 TTL 超时设置,即设置键值对的过期时间。当租约过期时,相关的键值对将被自动删除。
- Watch(监听):可以监视特定键的变化,当键的值发生变化时,会触发相应的通知。
有了这些特性,我们就能够实现注册中心的服务提供者节点过期和监听了。
此外,Etcd 的一大优势就是能够保证数据的强一致性。
Etcd 如何保证数据一致性?
从表层来看,Etcd 支持事务操作,能够保证数据一致性。
从底层来看,Etcd 使用 Raft 一致性算法来保证数据的一致性。
Raft 是一种分布式一致性算法,它确保了分布式系统中的所有节点在任何时间点都能达成一致的数据视图。
具体来说,Raft 算法通过选举机制选举出一个领导者(Leader)节点,领导者负责接收客户端的写请求,并将写操作复制到其他节点上。当客户端发送写请求时,领导者首先将写操作写入自己的日志中,并将写操作的日志条目分发给其他节点,其他节点收到日志后也将其写入自己的日志中。一旦 大多数节点(即半数以上的节点)都将该日志条目成功写入到自己的日志中,该日志条目就被视为已提交,领导者会向客户端发送成功响应。在领导者发送成功响应后,该写操作就被视为已提交,从而保证了数据的一致性。
如果领导者节点宕机或失去联系,Raft 算法会在其他节点中 选举出新的领导者,从而保证系统的可用性和一致性。新的领导者会继续接收客户端的写请求,并负责将写操作复制到其他节点上,从而保持数据的一致性。
上面这段不理解也没关系,我们可以使用官方提供的 Etcd Playground 来可视化操作 Etcd,便于学习。
Playground 地址:http://play.etcd.io/play
比如我们可以尝试停止主节点,其余节点为从节点:
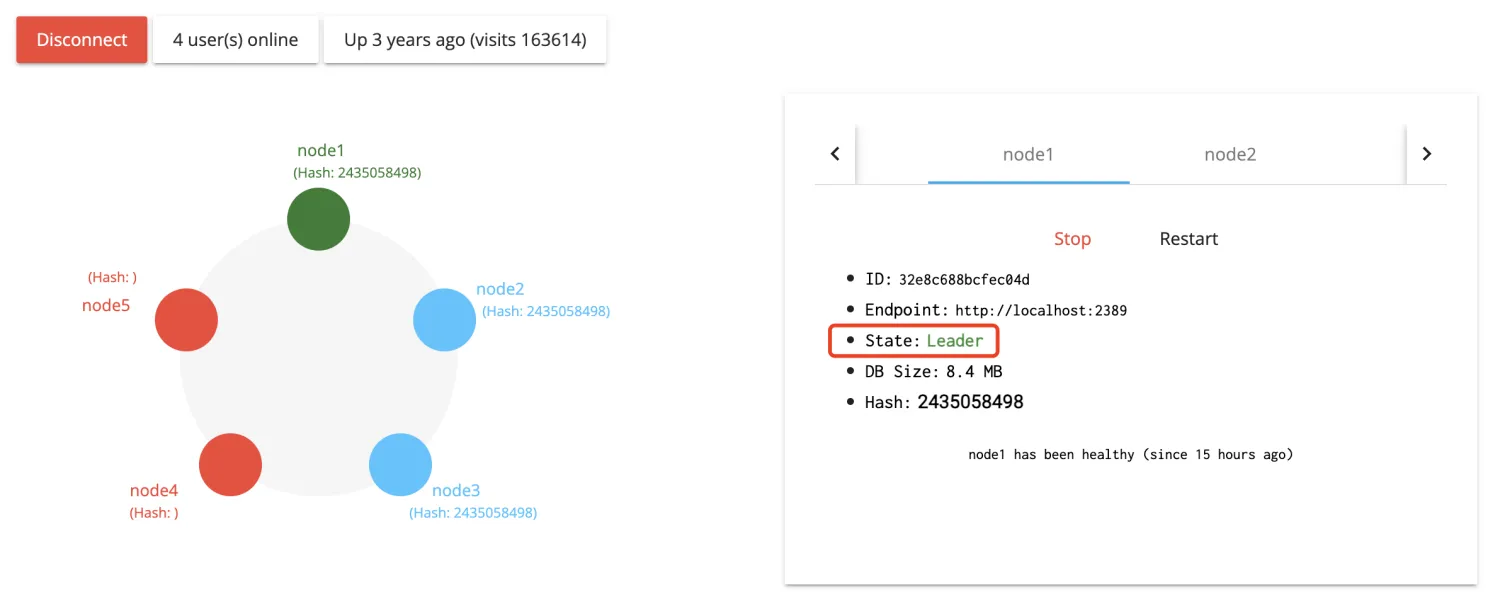
然后会发现主节点挂掉后,并没有新的从节点成为主节点,因为还剩 2 个节点,一人一票,谁都不服谁!这种现象也称为 “脑裂”。
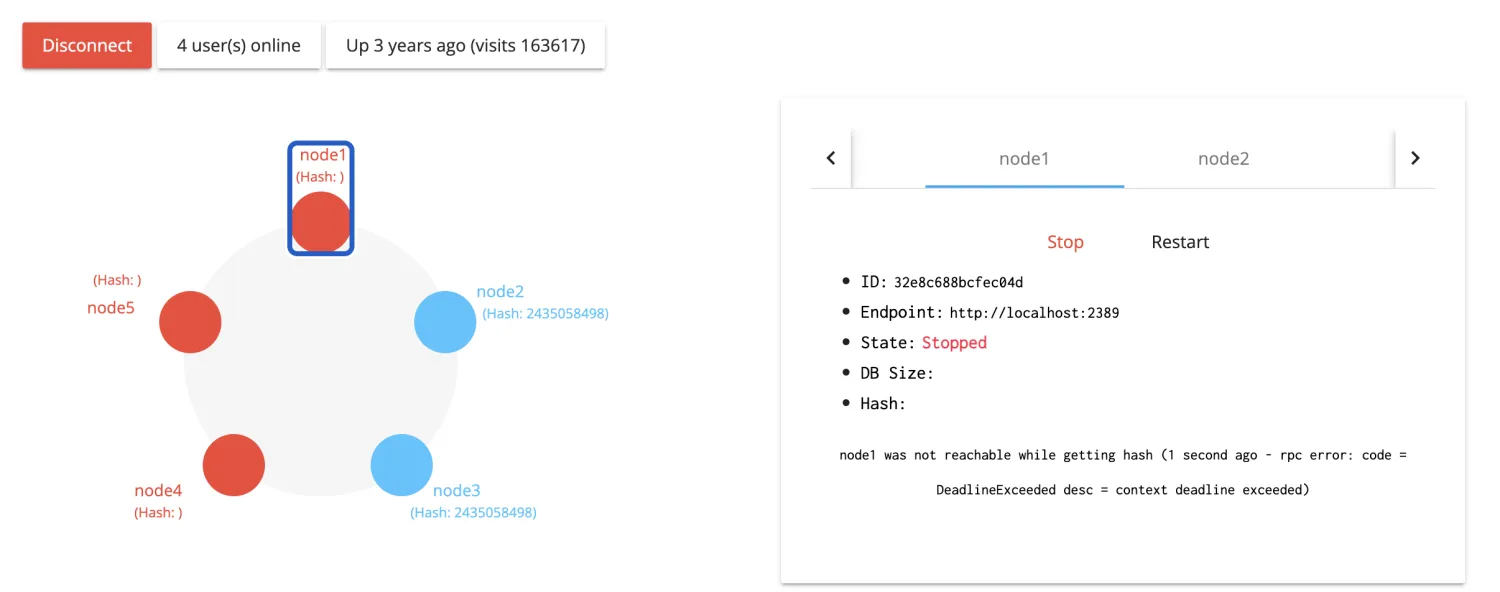
然后我们启动 node4,会发现 node3 成为了主节点,因为 3 个节点,不会出现选举主节点时的平票情况。
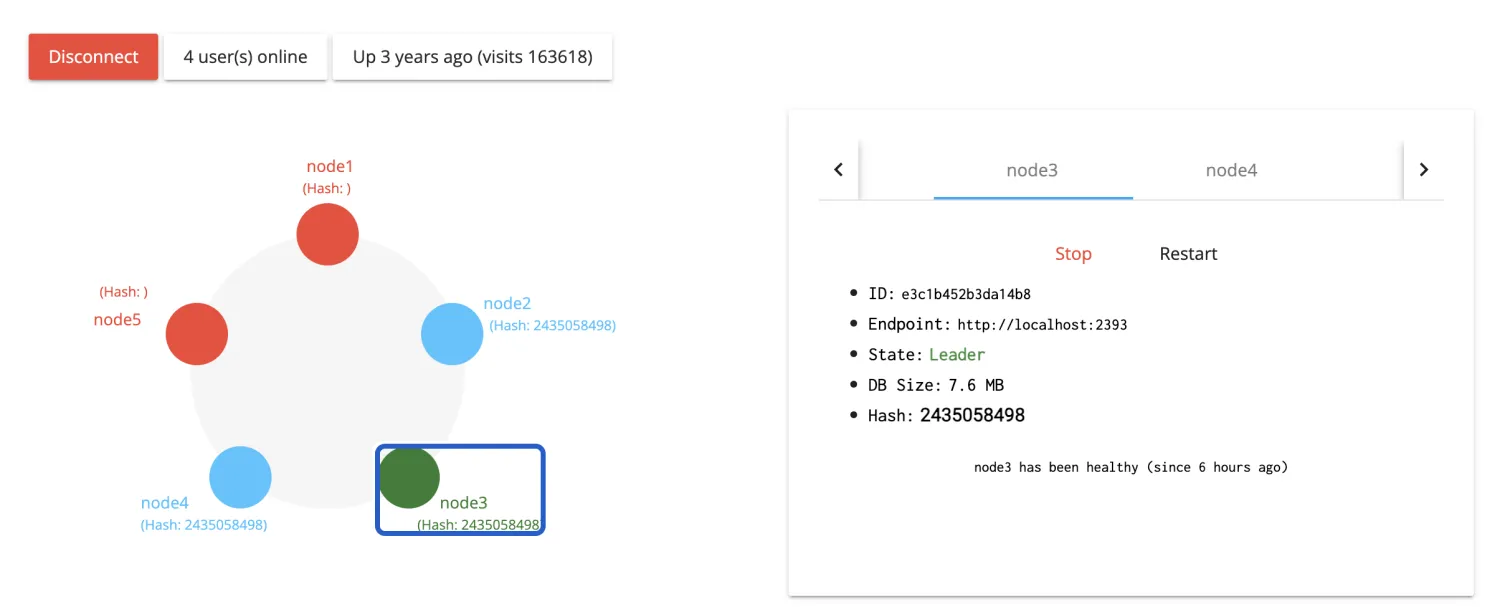
大概就是这样,初学者没必要深究背后的算法了,能理解大致流程即可。
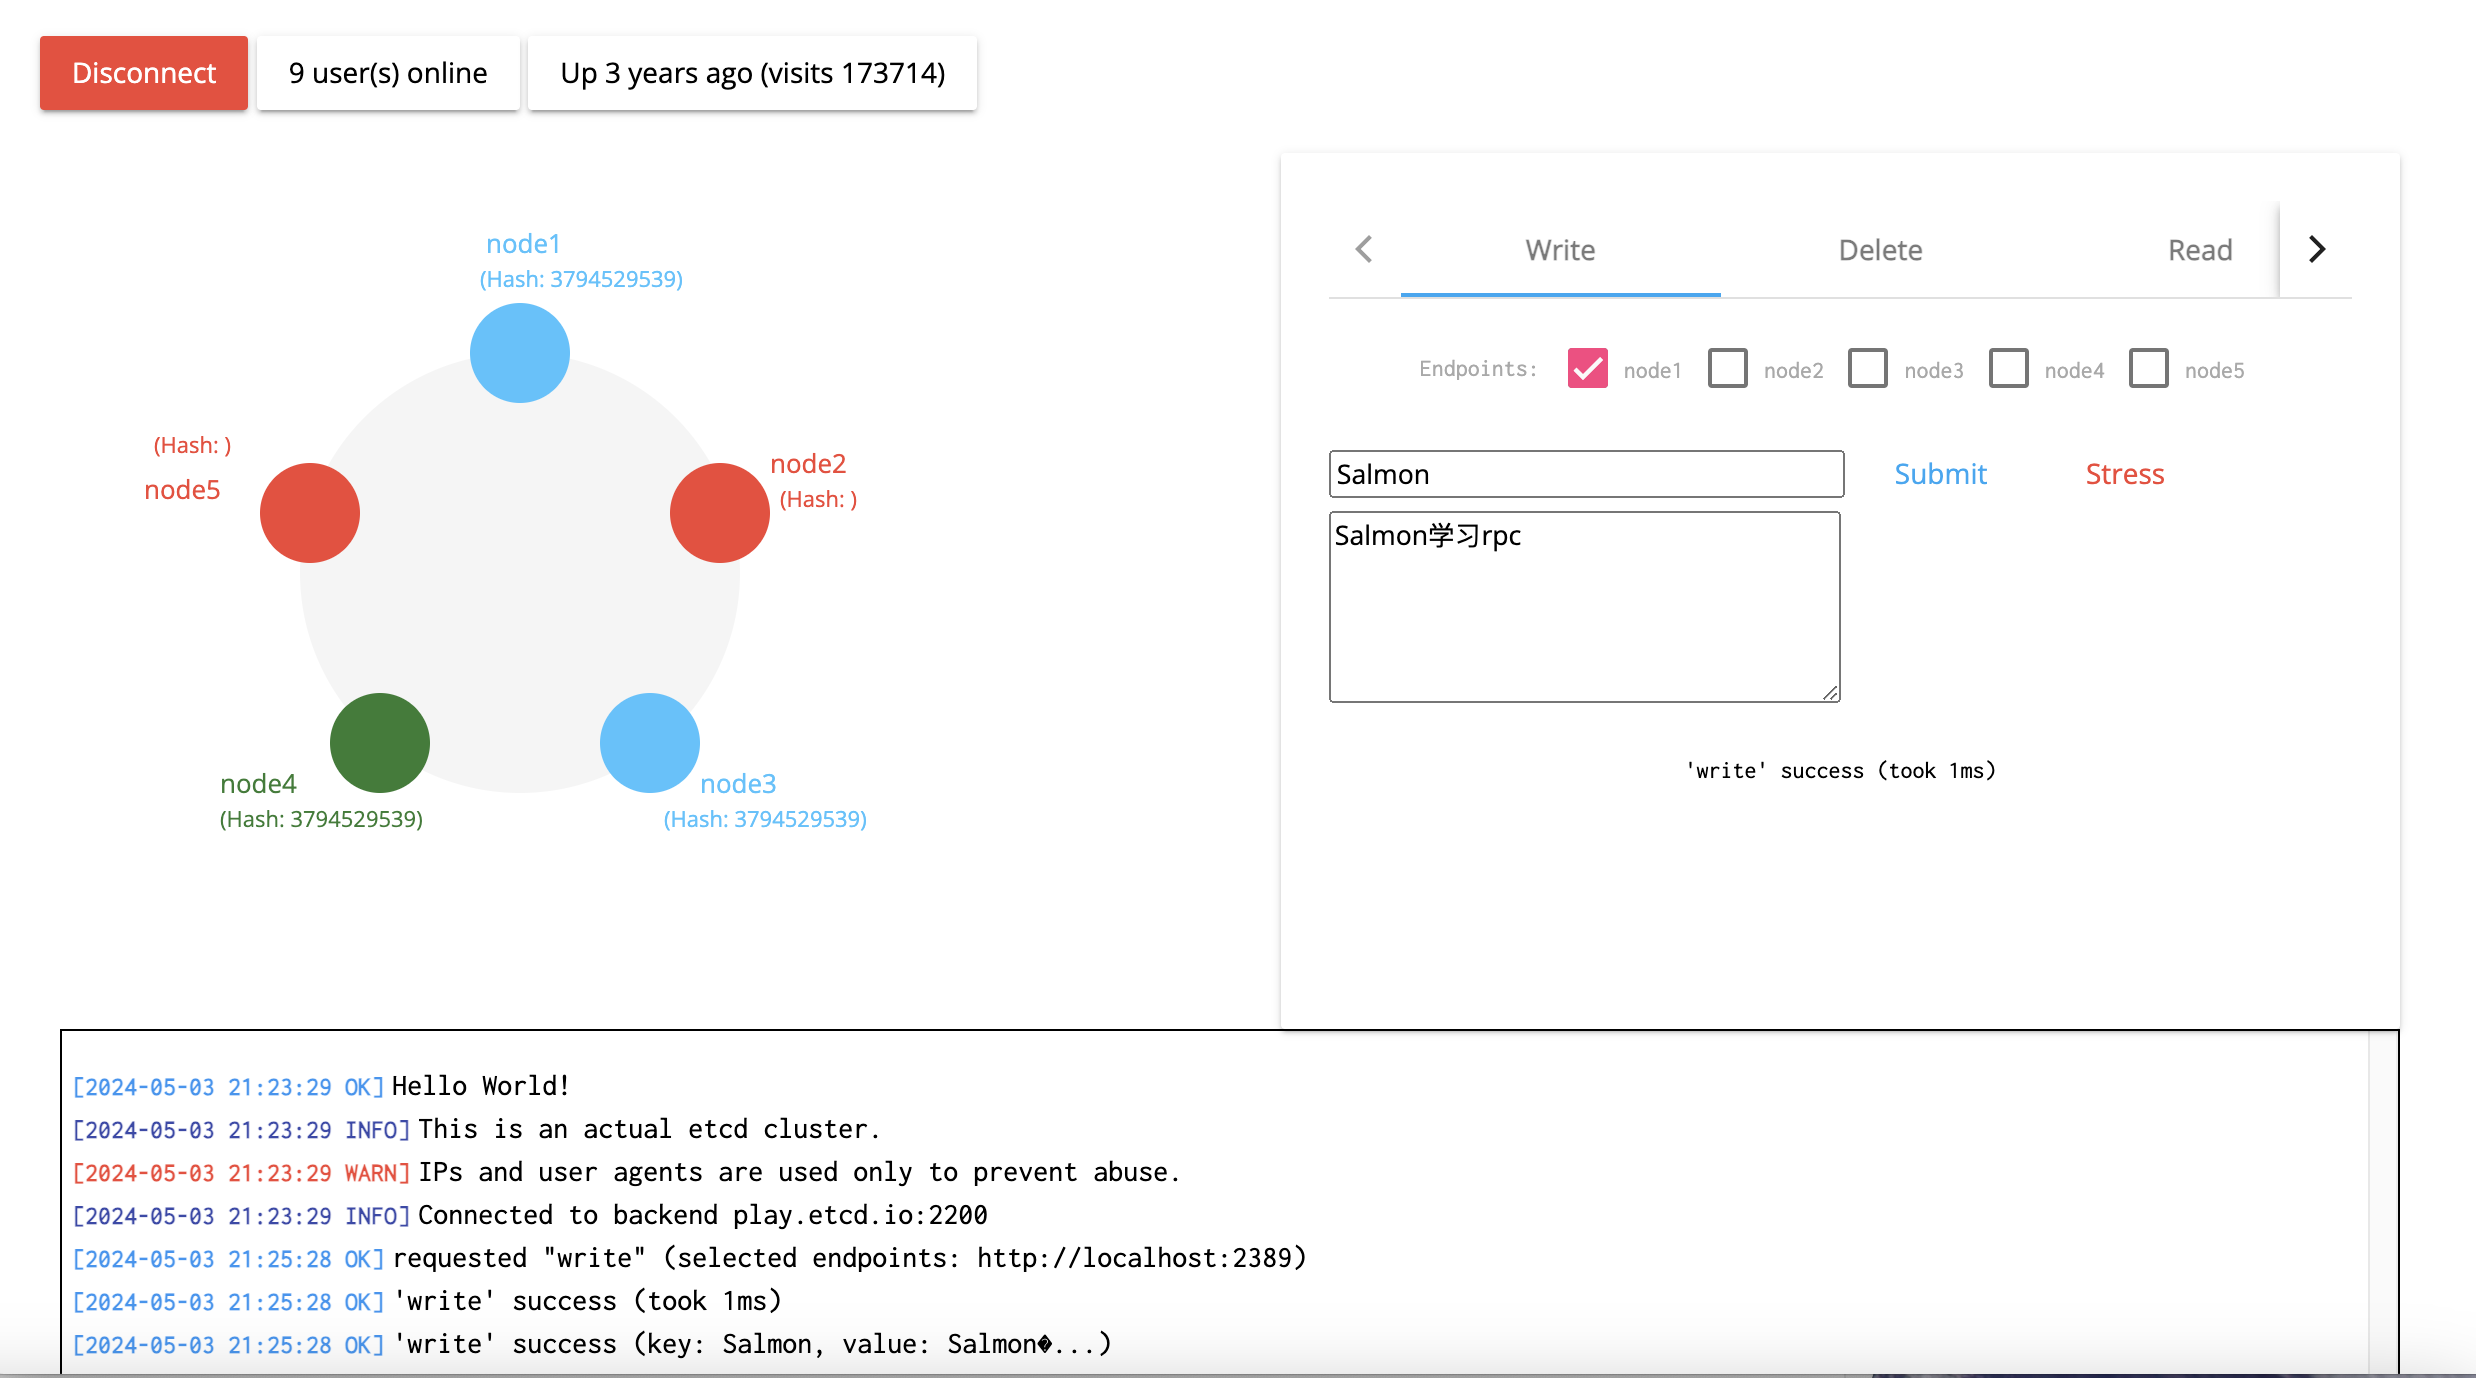
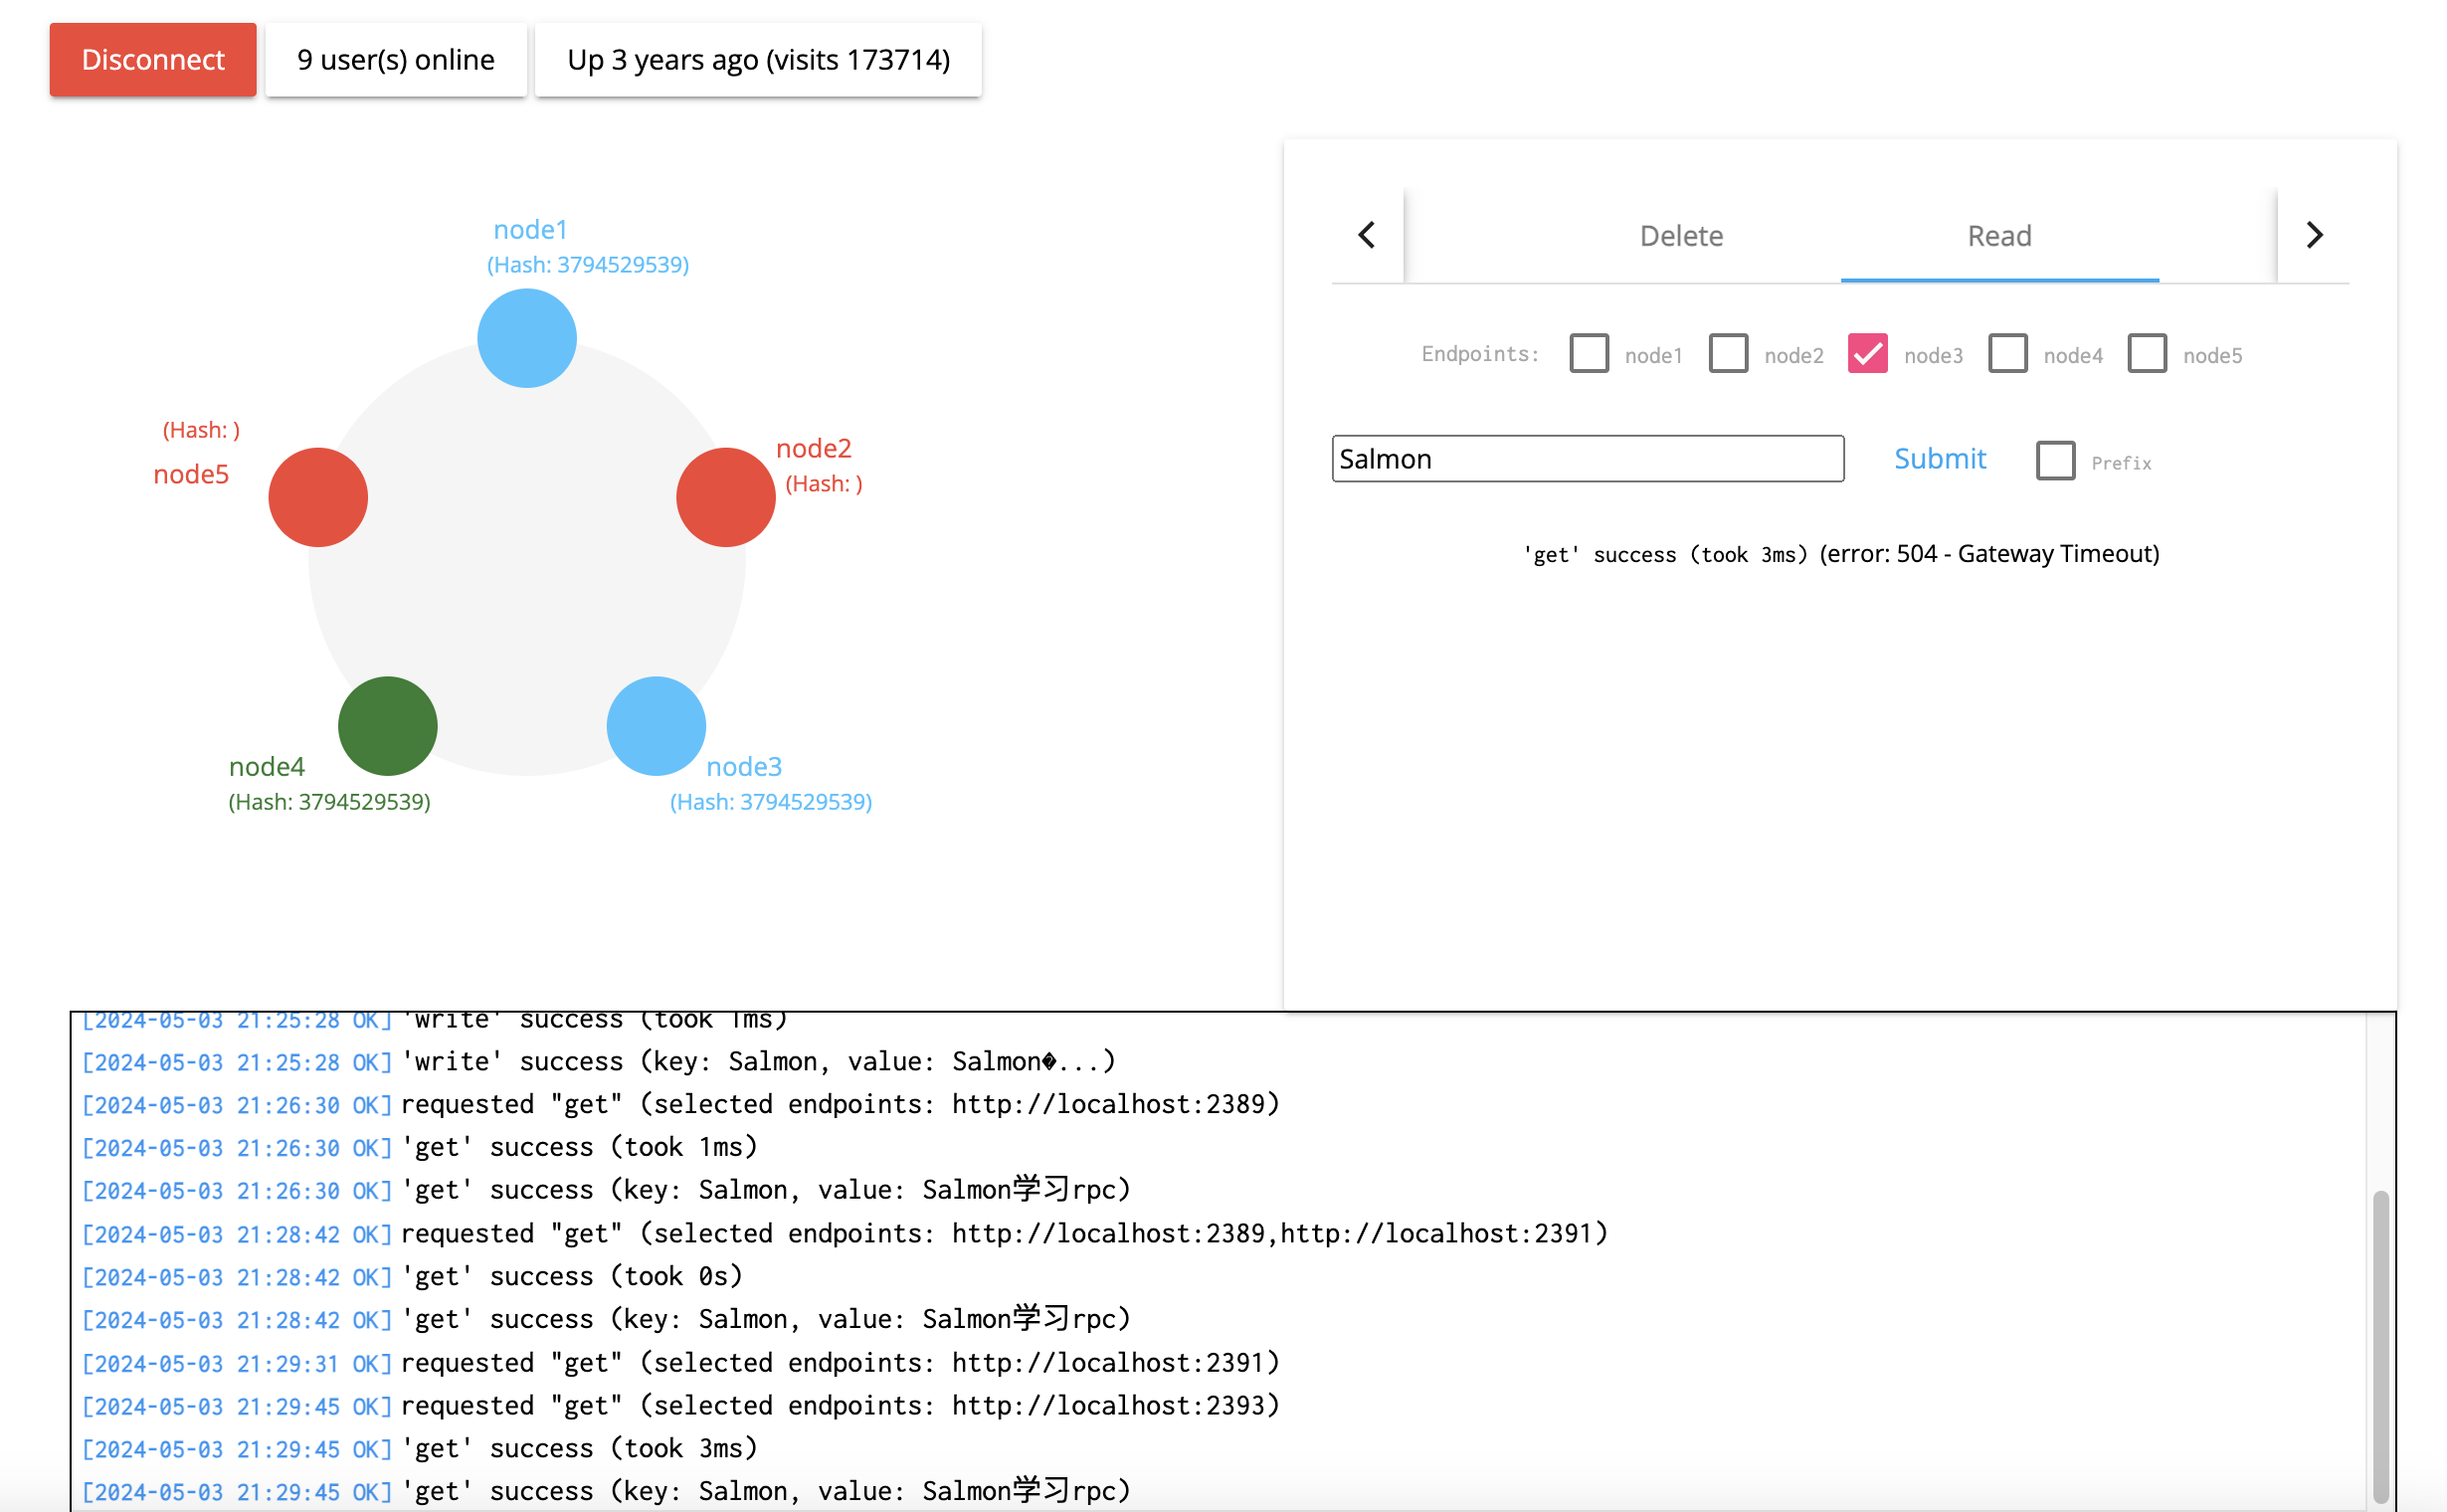
Etcd 基本操作
和所有数据存储中间件一样,基本操作无非就是:增删改查。
可以用可视化界面模拟操作,比如 write 写数据(更新数据):
然后读取数据:
还支持根据前缀搜索数据:
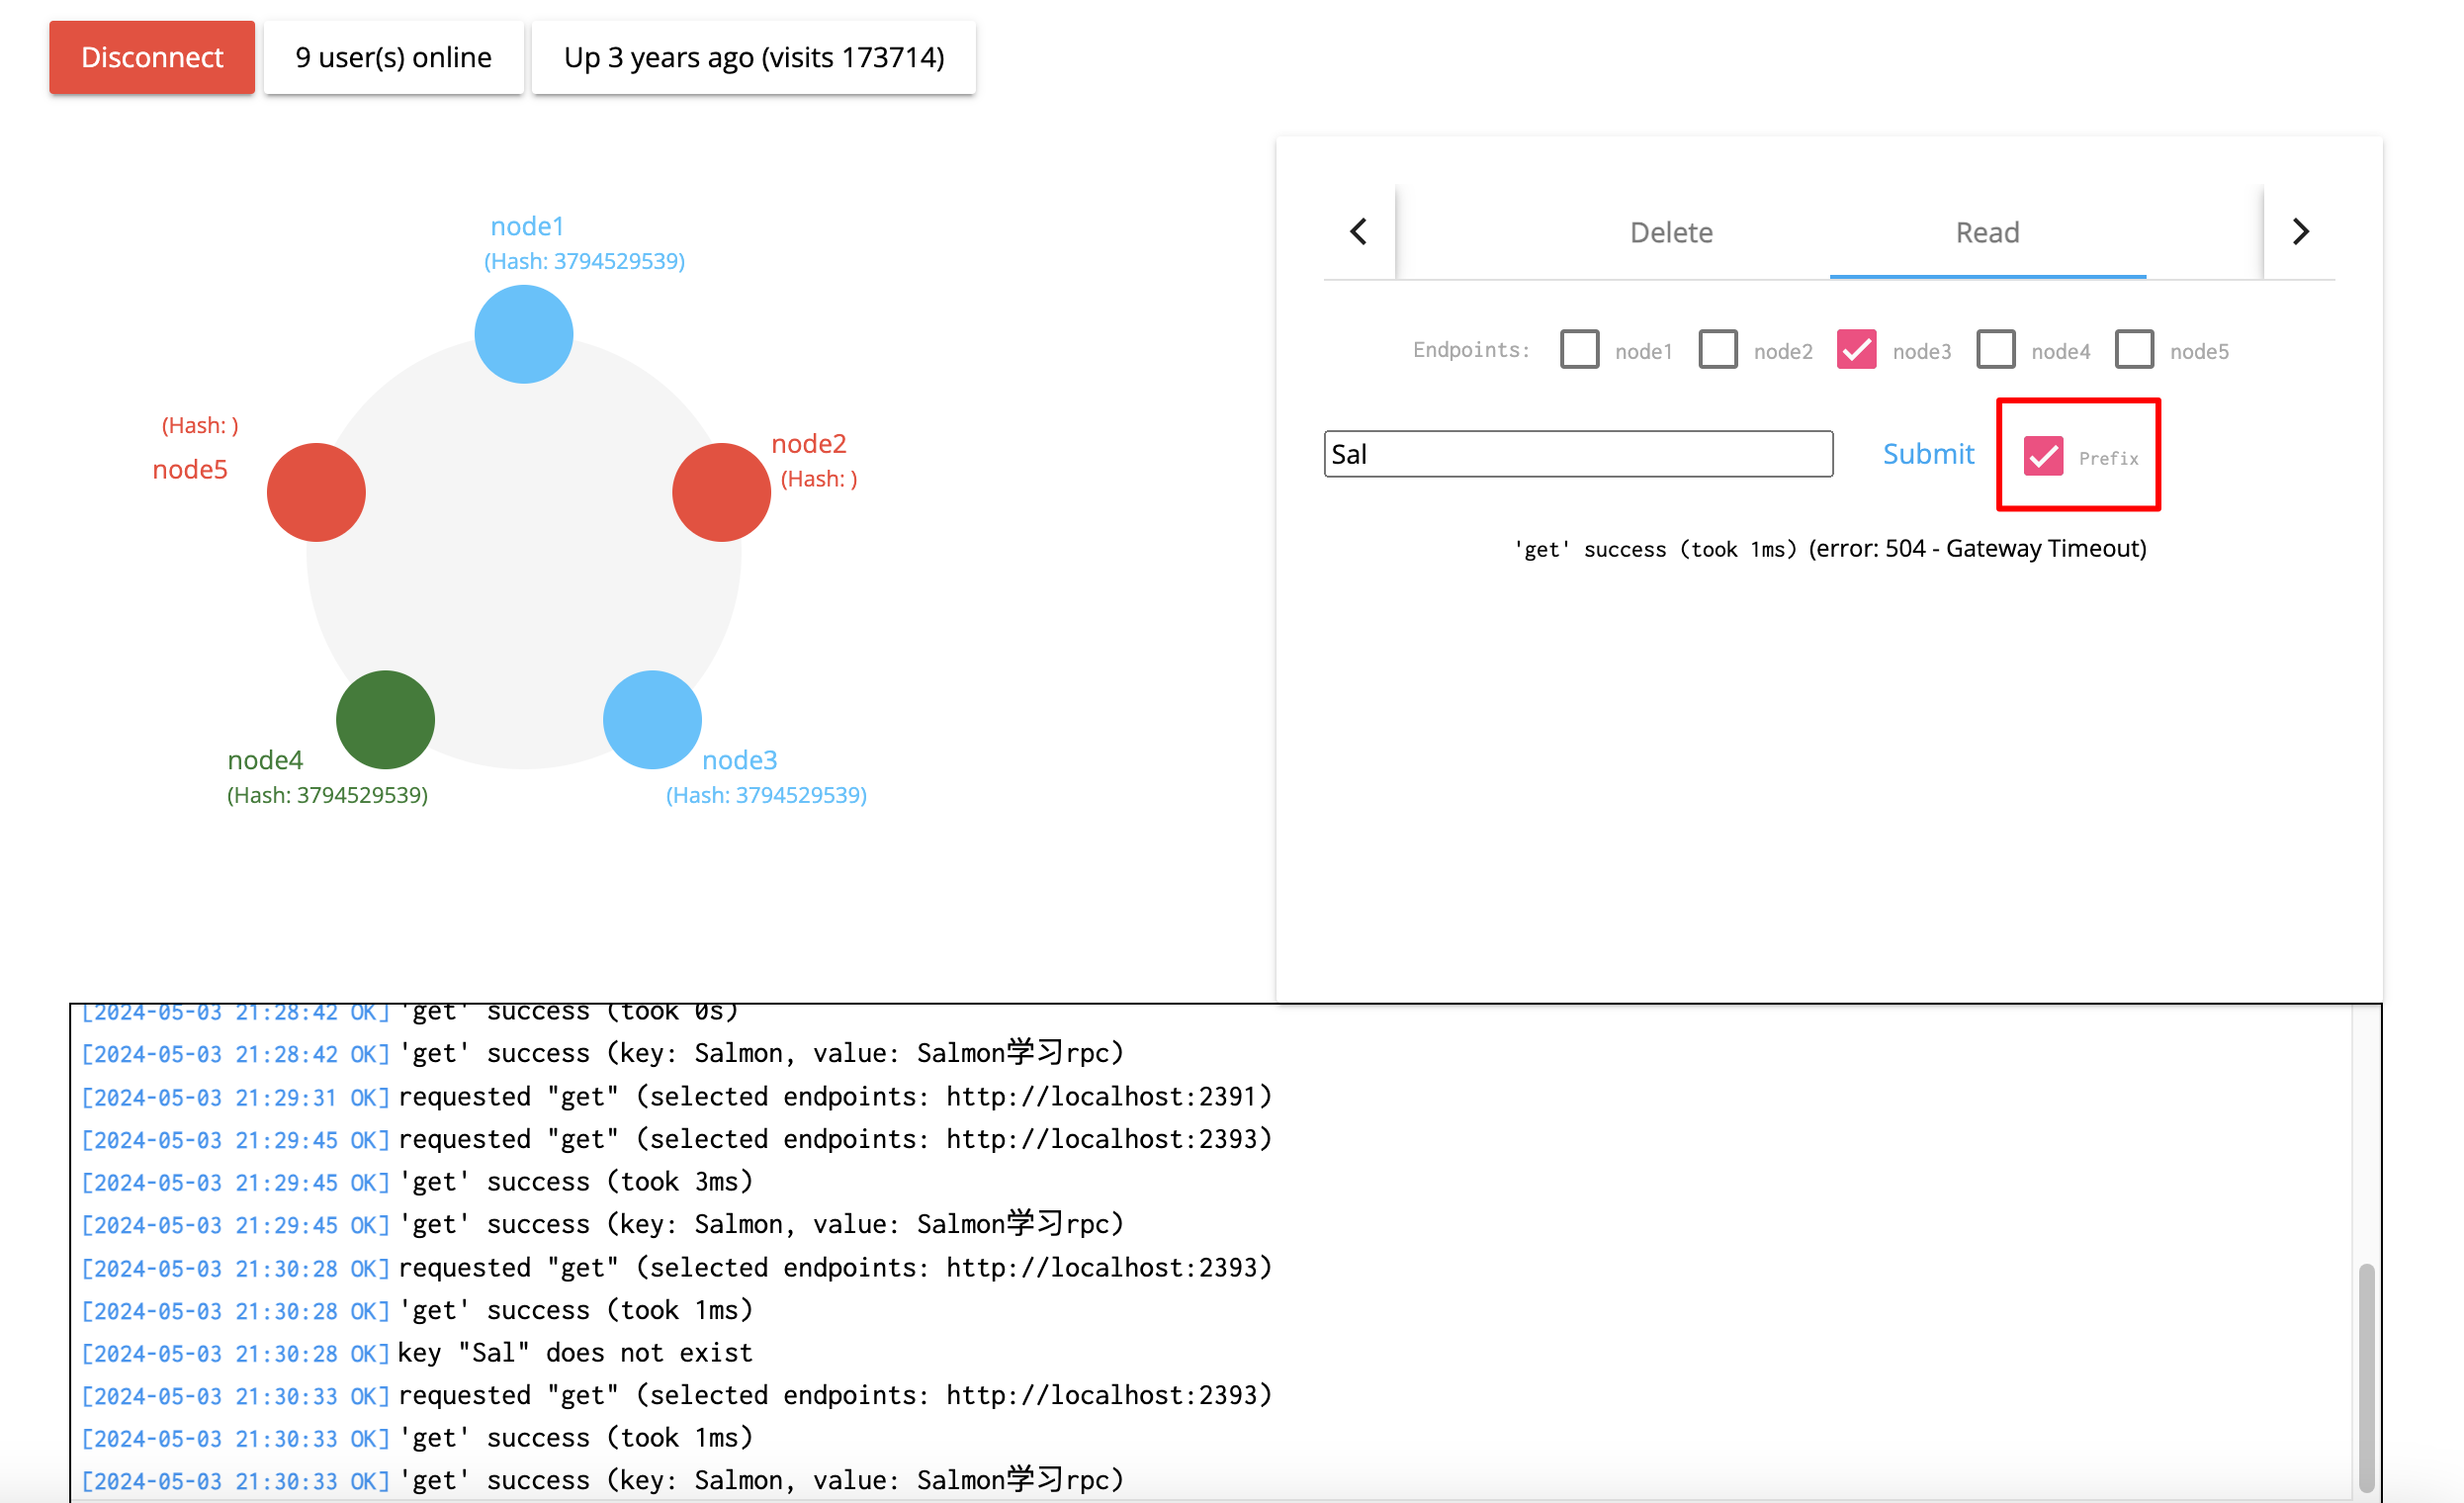
还有一些其他操作,比如租约、监听等,后续会给大家演示。
Etcd 安装
进入 Etcd 官方的下载页:https://github.com/etcd-io/etcd/releases
也可以在这里下载:https://etcd.io/docs/v3.2/install/
找到自己操作系统的版本执行即可:
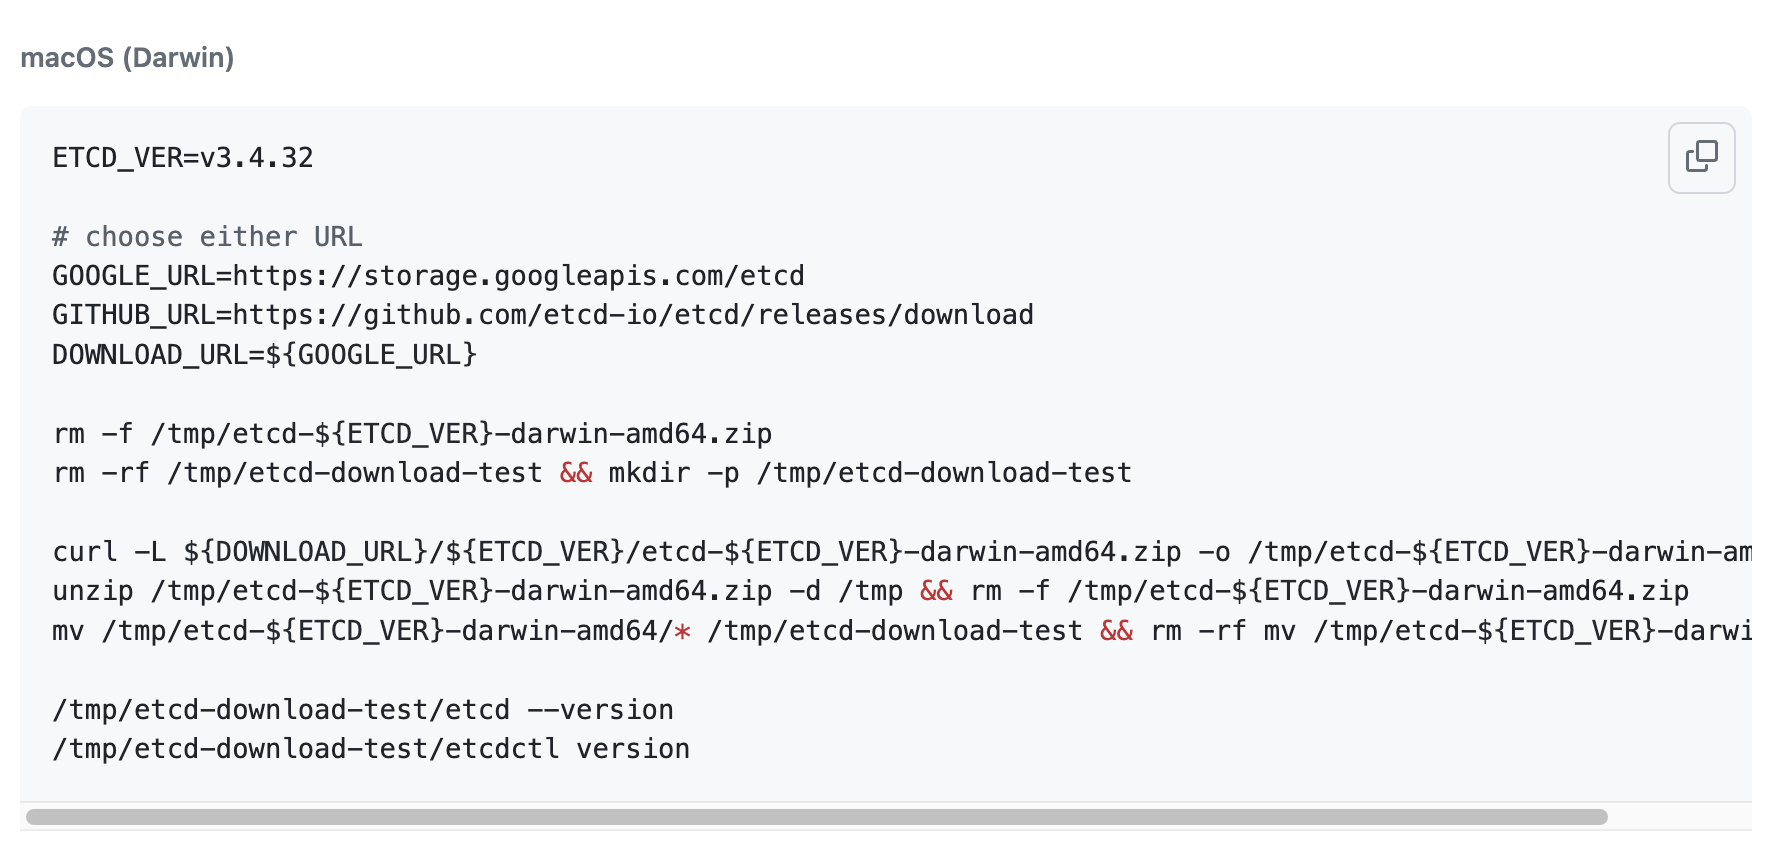
安装完成后,会得到 3 个脚本:
- etcd:etcd 服务本身
- etcdctl:客户端,用于操作 etcd,比如读写数据
- etcdutl:备份恢复工具
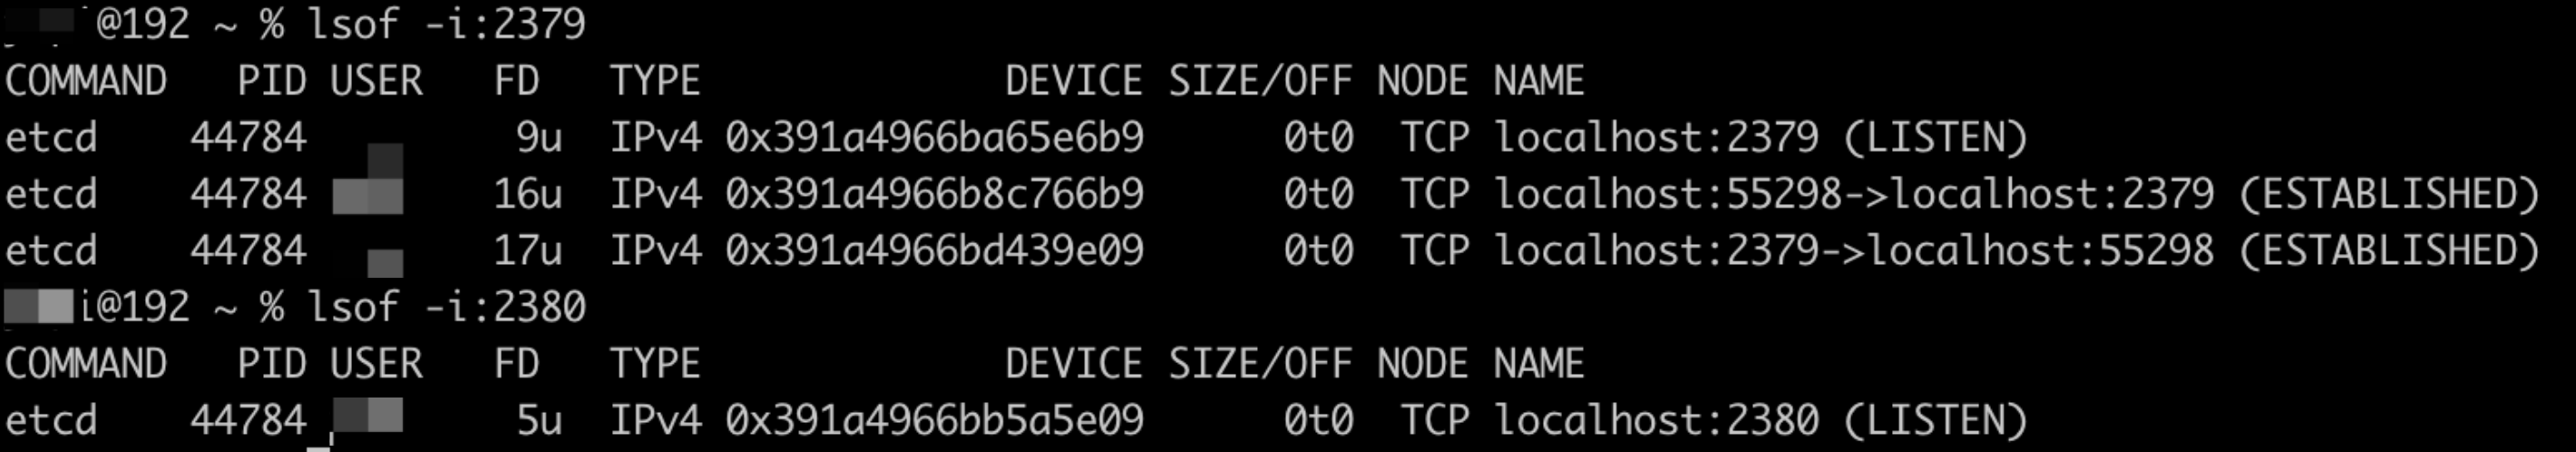
执行 etcd 脚本后,可以启动 etcd 服务,服务默认占用 2379 和 2380 端口,作用分别如下:
- 2379:提供 HTTP API 服务,和 etcdctl 交互
- 2380:集群中节点间通讯
Etcd 可视化工具
一般情况下,我们使用数据存储中间件时,一定要有一个可视化工具,能够更直观清晰地管理已经存储的数据。比如 Redis 的 Redis Desktop Manager。
同样的,Etcd 也有一些可视化工具,比如:
- etcdkeeper:️https://github.com/evildecay/etcdkeeper/
- kstone:https://github.com/kstone-io/kstone/tree/master/charts
更推荐 etcdkeeper,安装成本更低,学习使用更方便。
进入项目的 GitHub,就能看到安装方式,直接按照指引下载、解压、运行脚本即可:
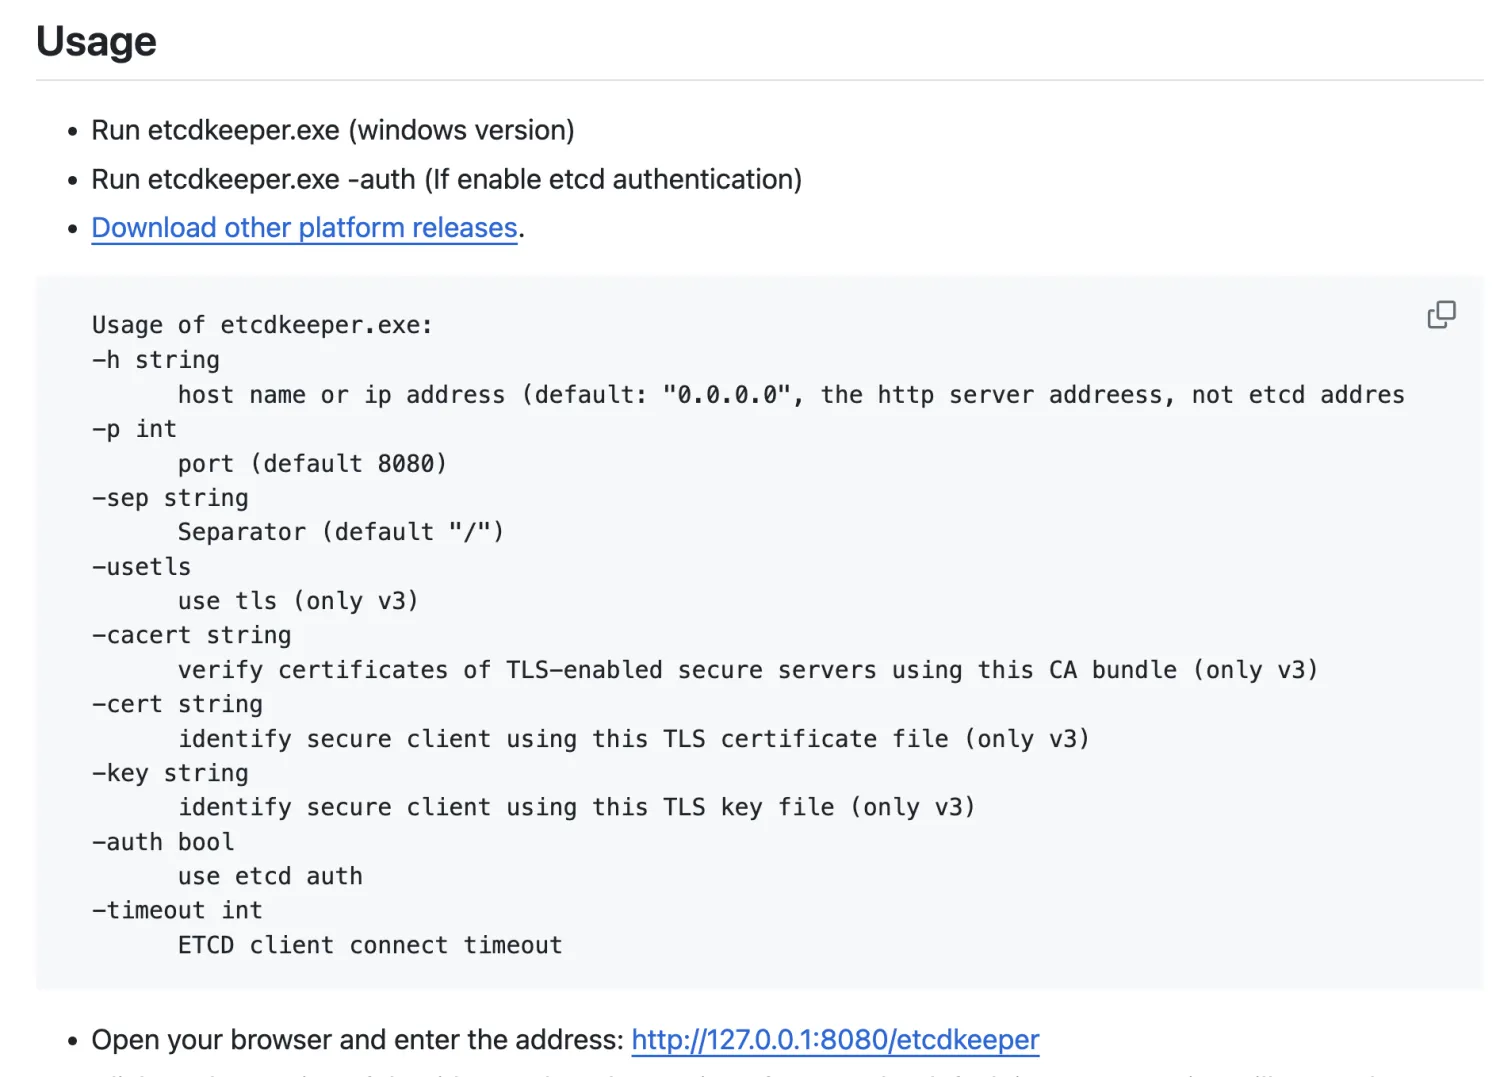
安装后,执行命令,可以在指定端口启动可视化界面(默认是 8080 端口),比如我这里在 8081 端口启动。
sh
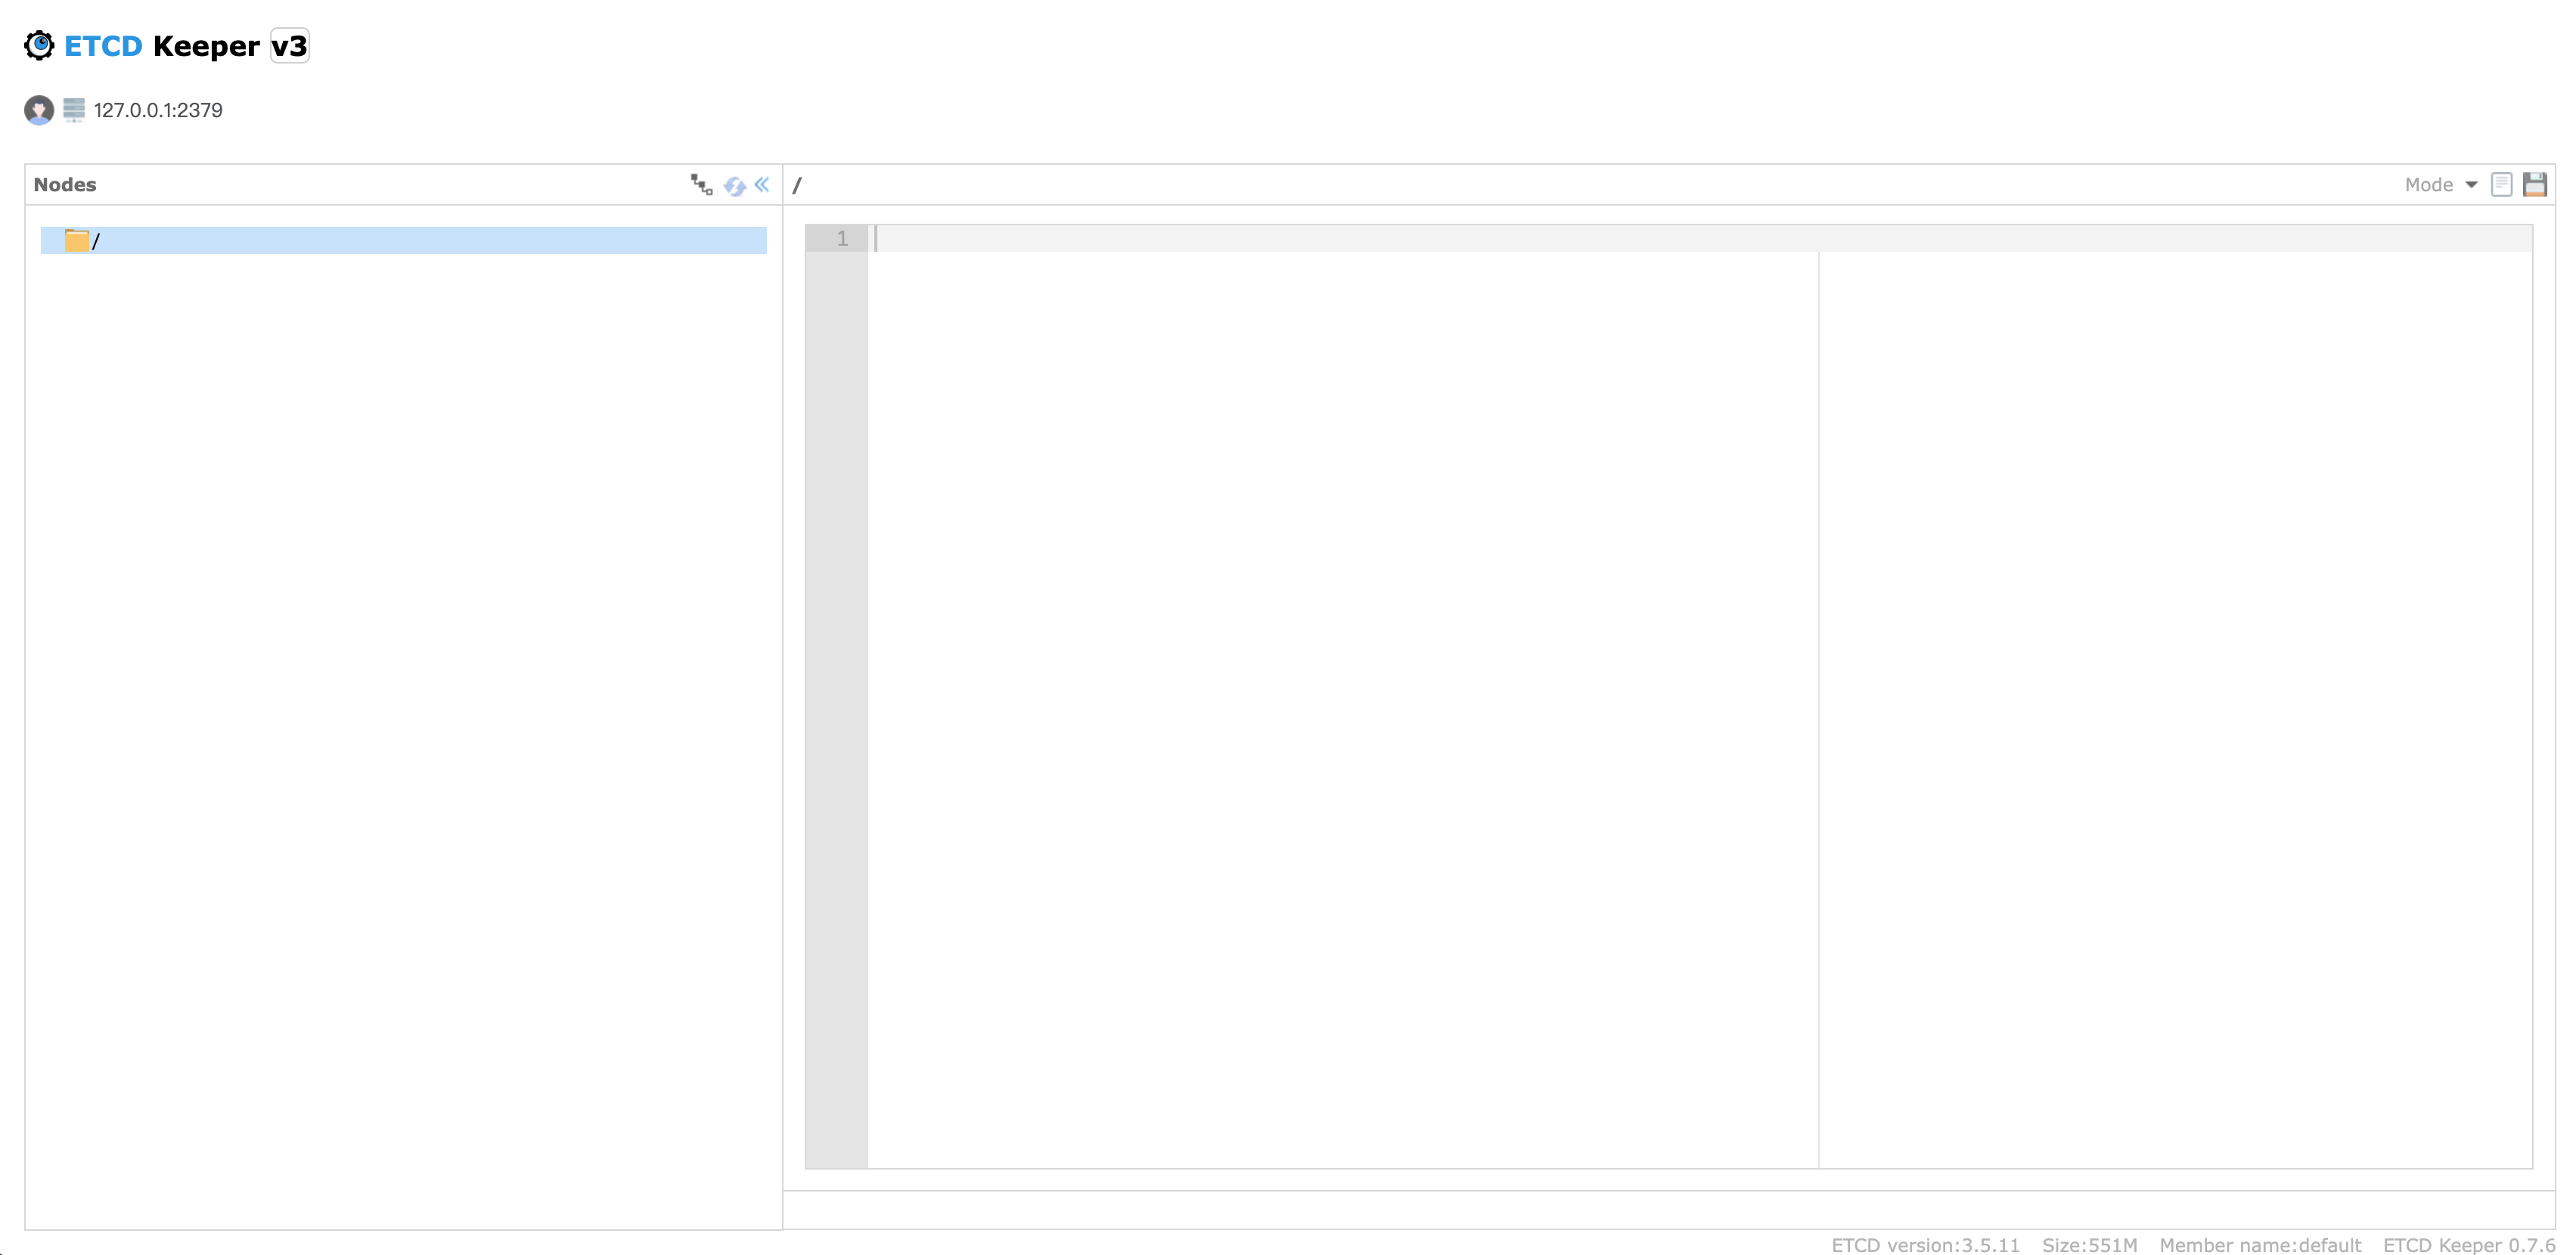
./etcdkeeper -p 8081安装后,访问本地 http://127.0.0.1:8081/etcdkeeper/,就能看到可视化页面了,如图:
Etcd Java 客户端
所谓客户端,就是操作 Etcd 的工具。
etcd 主流的 Java 客户端是 jetcd:https://github.com/etcd-io/jetcd。
注意,Java 版本必须大于 11!
用法非常简单,就像 curator 能够操作 ZooKeeper、jedis 能够操作 Redis 一样。
1)首先在项目中引入 jetcd:
xml
<!-- https://mvnrepository.com/artifact/io.etcd/jetcd-core -->
<dependency>
    <groupId>io.etcd</groupId>
    <artifactId>jetcd-core</artifactId>
    <version>0.7.7</version>
</dependency>
2)按照官方文档的示例写 Demo:
java
package com.salmon.registry;

import io.etcd.jetcd.ByteSequence;
import io.etcd.jetcd.Client;
import io.etcd.jetcd.KV;
import io.etcd.jetcd.kv.GetResponse;

import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;

/**
 * etcd demo
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class EtcdRegistry {
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        // create client using endpoints
        Client client = Client.builder().endpoints("http://127.0.0.1:2379").build();

        KV kvClient = client.getKVClient();
        ByteSequence key = ByteSequence.from("test_key".getBytes());
        ByteSequence value = ByteSequence.from("test_value".getBytes());

        // put the key-value
        kvClient.put(key, value).get();

        // get the CompletableFuture
        CompletableFuture<GetResponse> getFuture = kvClient.get(key);

        // get the value from CompletableFuture
        GetResponse response = getFuture.get();

        // delete the key
//        kvClient.delete(key).get();
    }
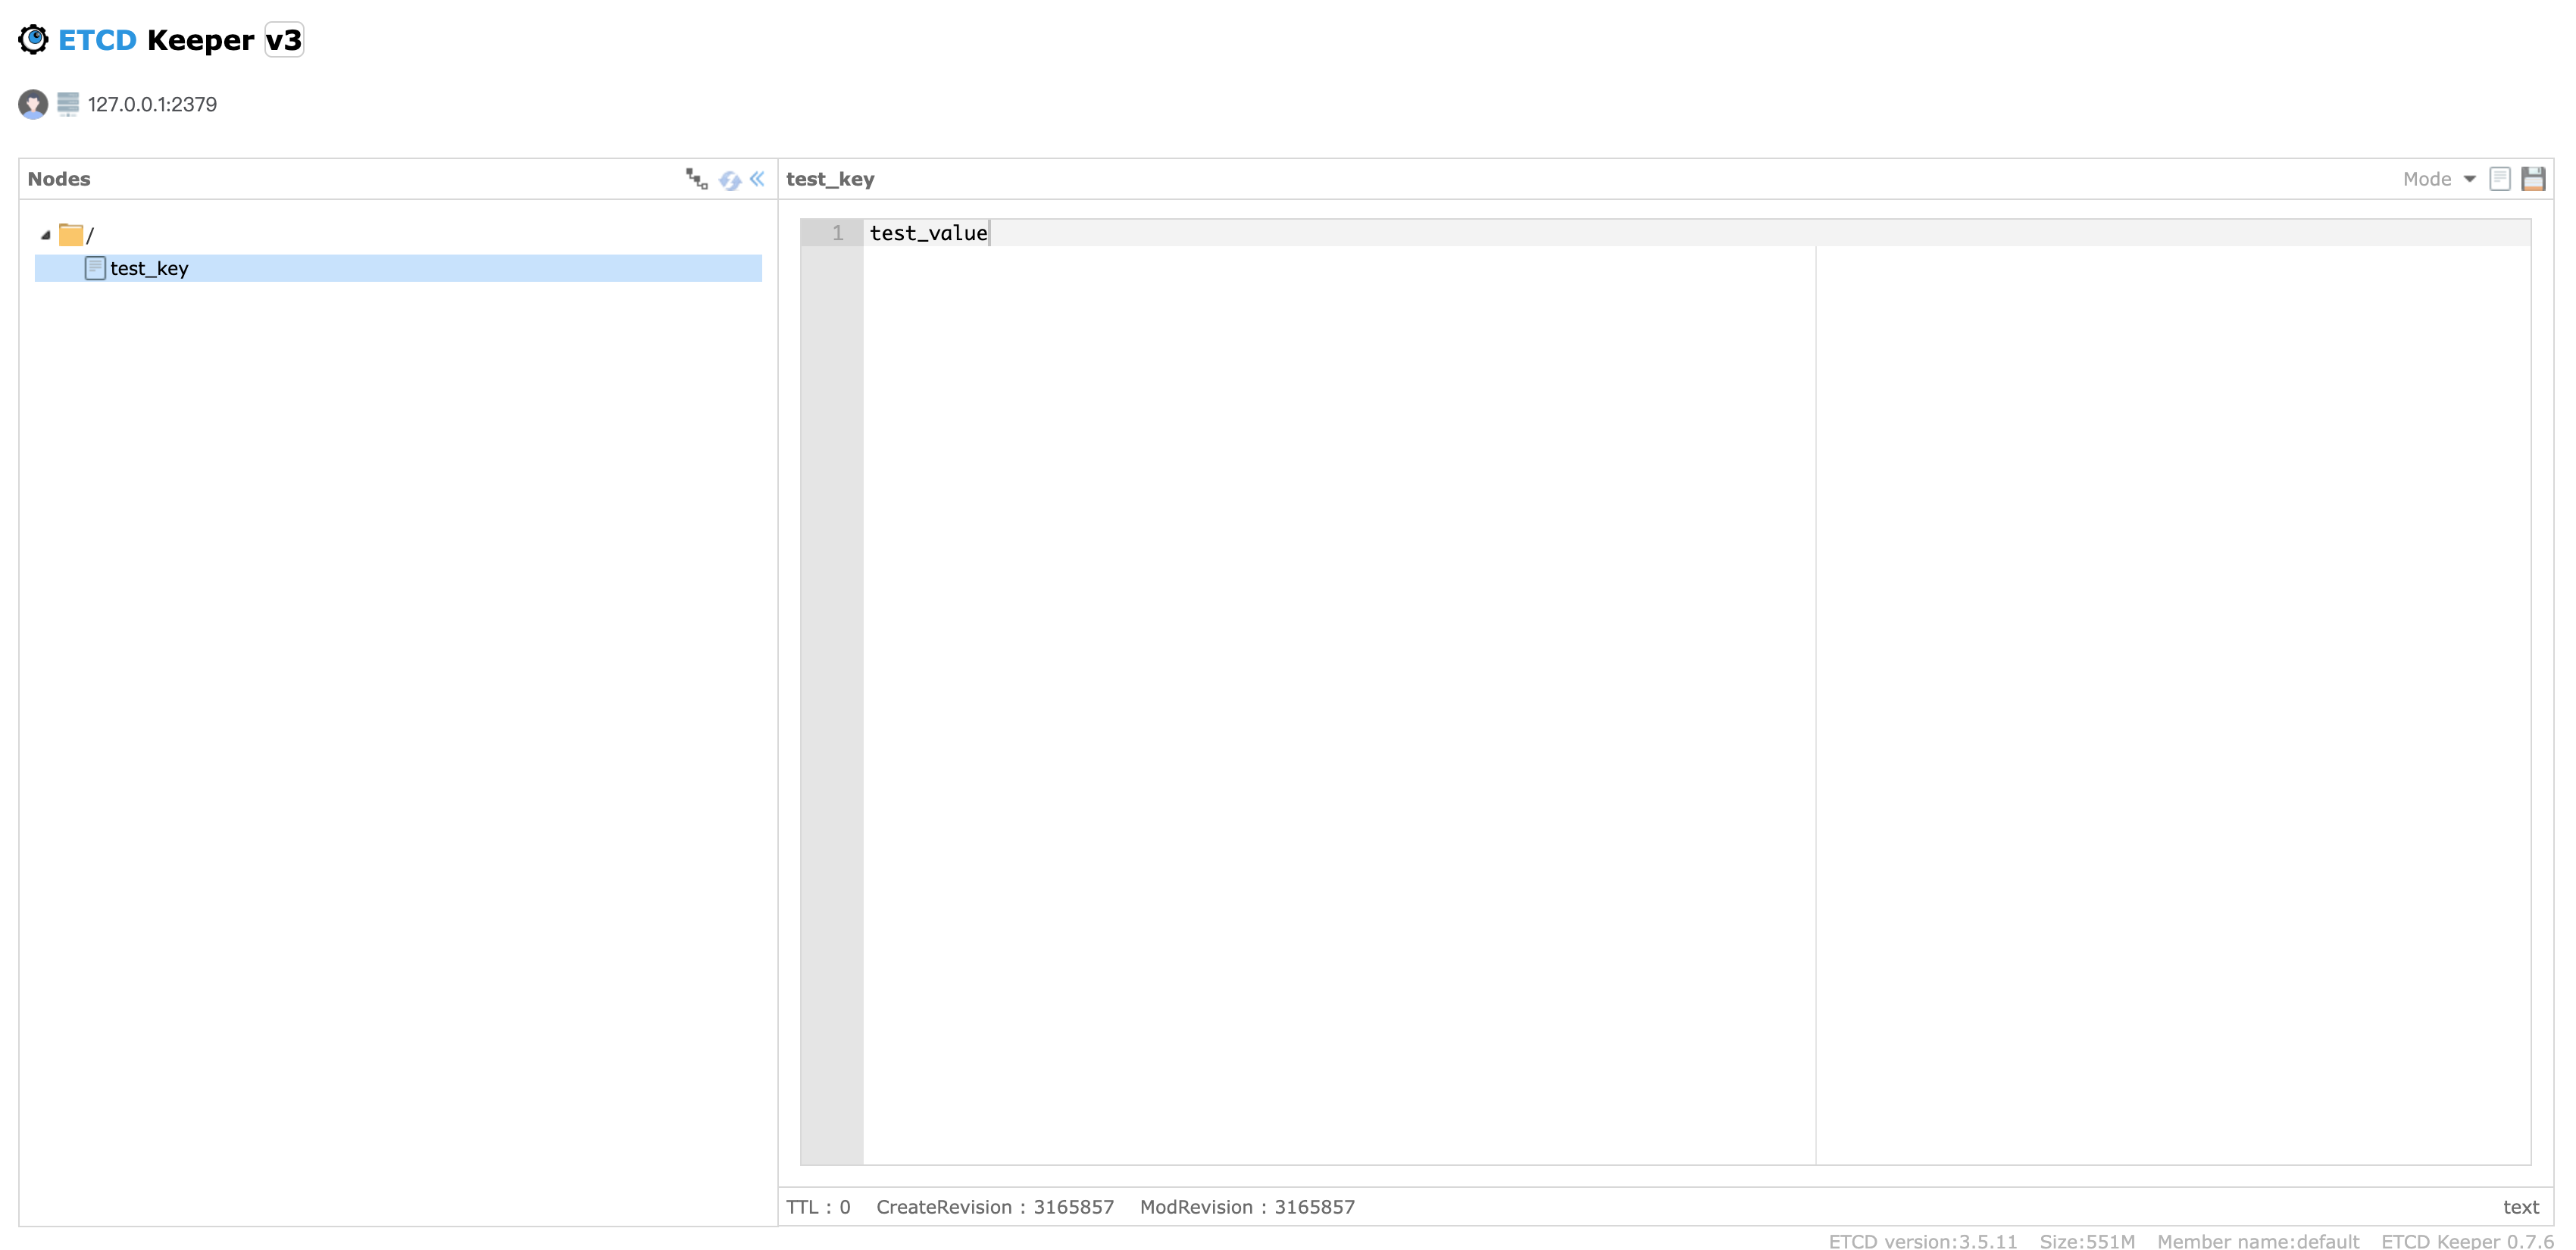
}
在上述代码中,我们使用 KVClient 来操作 etcd 写入和读取数据。除了 KVClient 客户端外,Etcd 还提供了很多其他客户端。
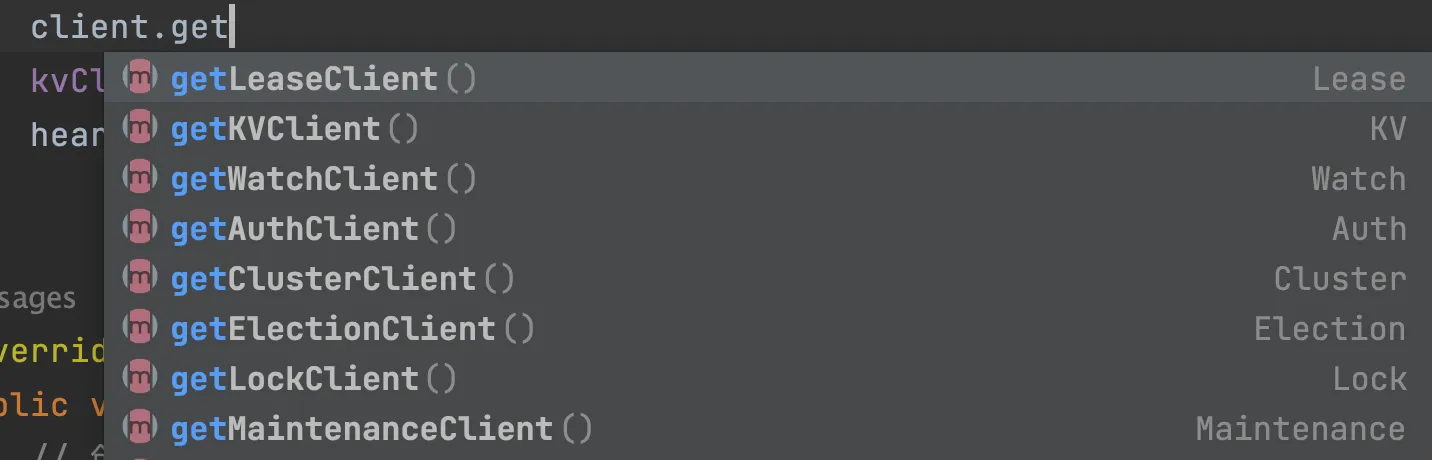
常用的客户端和作用如下,仅作了解即可:
- kvClient:用于对 etcd 中的键值对进行操作。通过 kvClient 可以进行设置值、获取值、删除值、列出目录等操作。
- leaseClient:用于管理 etcd 的租约机制。租约是 etcd 中的一种时间片,用于为键值对分配生存时间,并在租约到期时自动删除相关的键值对。通过 leaseClient 可以创建、获取、续约和撤销租约。
- watchClient:用于监视 etcd 中键的变化,并在键的值发生变化时接收通知。
- clusterClient:用于与 etcd 集群进行交互,包括添加、移除、列出成员、设置选举、获取集群的健康状态、获取成员列表信息等操作。
- authClient:用于管理 etcd 的身份验证和授权。通过 authClient 可以添加、删除、列出用户、角色等身份信息,以及授予或撤销用户或角色的权限。
- maintenanceClient:用于执行 etcd 的维护操作,如健康检查、数据库备份、成员维护、数据库快照、数据库压缩等。
- lockClient:用于实现分布式锁功能,通过 lockClient 可以在 etcd 上创建、获取、释放锁,能够轻松实现并发控制。
- electionClient:用于实现分布式选举功能,可以在 etcd 上创建选举、提交选票、监视选举结果等。
绝大多数情况下,用前 3 个客户端就足够了。
3)使用 Debug 执行上述代码,观察 Etcd 的数据结构,如图:
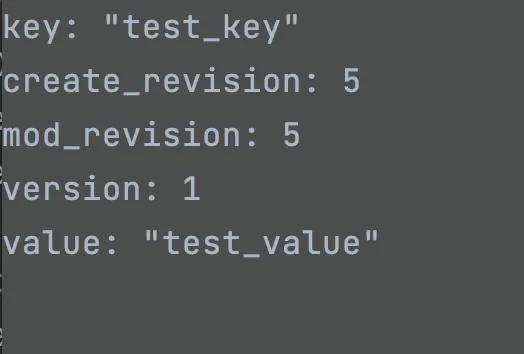
发现除了 key 和 value 外,还能看到版本、创建版本、修改版本字段。这是因为 etcd 中的每个键都有一个与之关联的版本号,用于跟踪键的修改历史。当一个键的值发生变化时,其版本号也会增加。
通过使用 etcd 的 Watch API,可以监视键的变化,并在发生变化时接收通知。这种版本机制使得 etcd 在分布式系统中能够实现乐观并发控制、一致性和可靠性的数据访问。
OK,了解了 Etcd 的基础用法后,我们还要设计服务注册信息如何存储在注册中心内。
存储结构设计
存储结构设计的几个要点:
- key 如何设计?
- value 如何设计?
- key 什么时候过期?
由于一个服务可能有多个服务提供者(负载均衡),我们可以有两种结构设计:
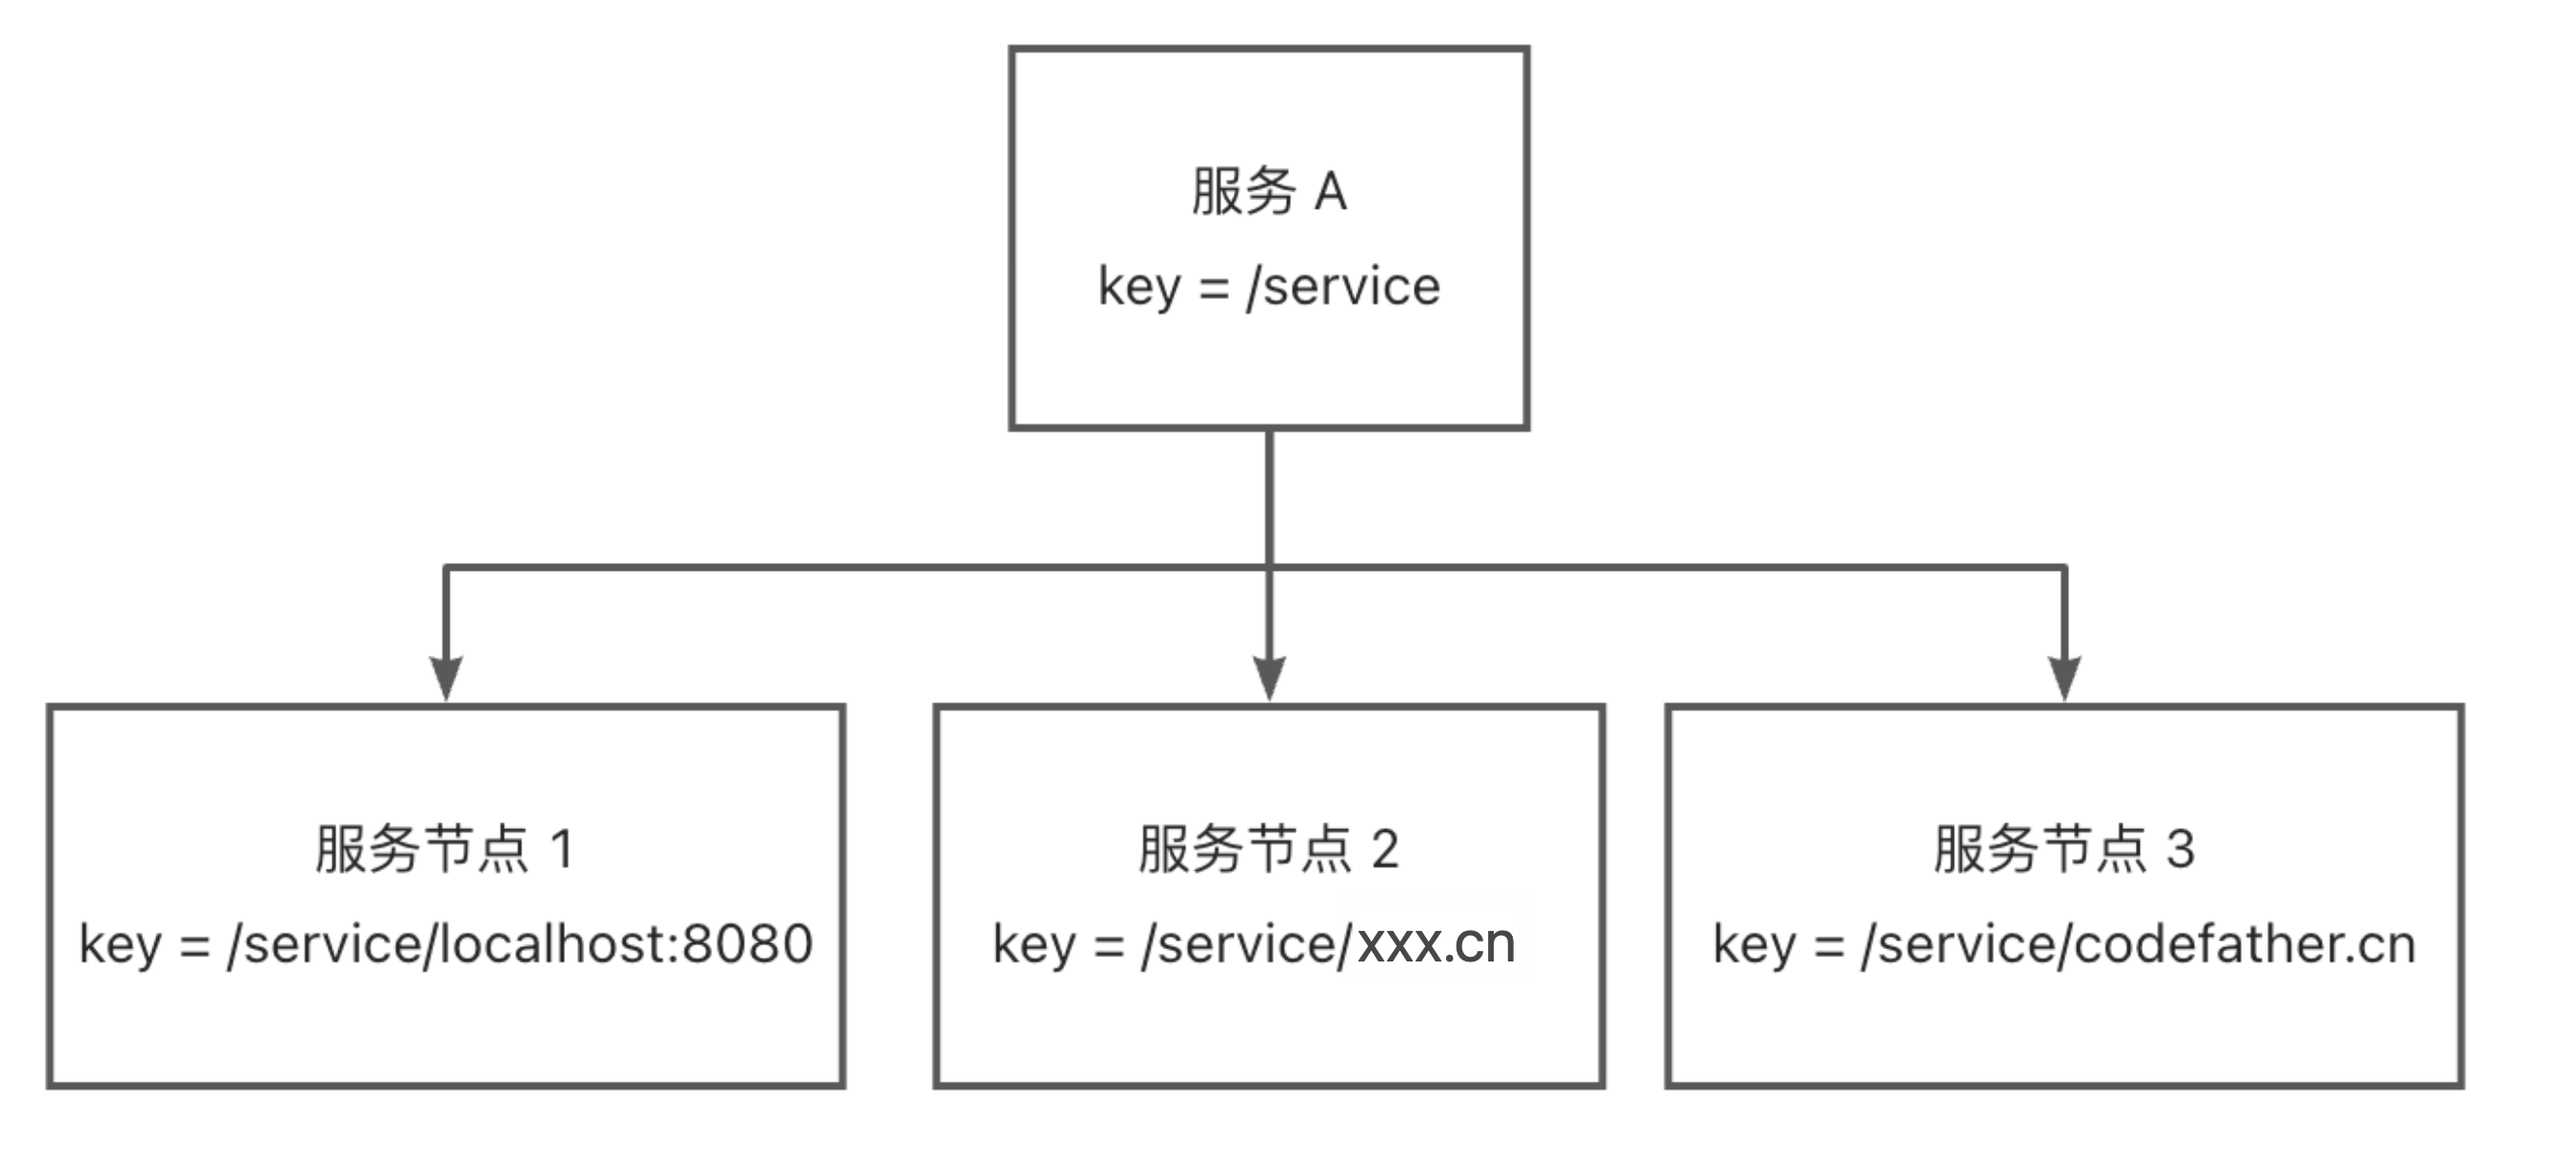
1)层级结构。将服务理解为文件夹、将服务对应的多个节点理解为文件夹下的文件,那么可以通过服务名称,用前缀查询的方式查询到某个服务的所有节点。
如图,键名的规则可以是 /业务前缀/服务名/服务节点地址:
2)列表结构。将所有的服务节点以列表的形式整体作为 value。
如图:
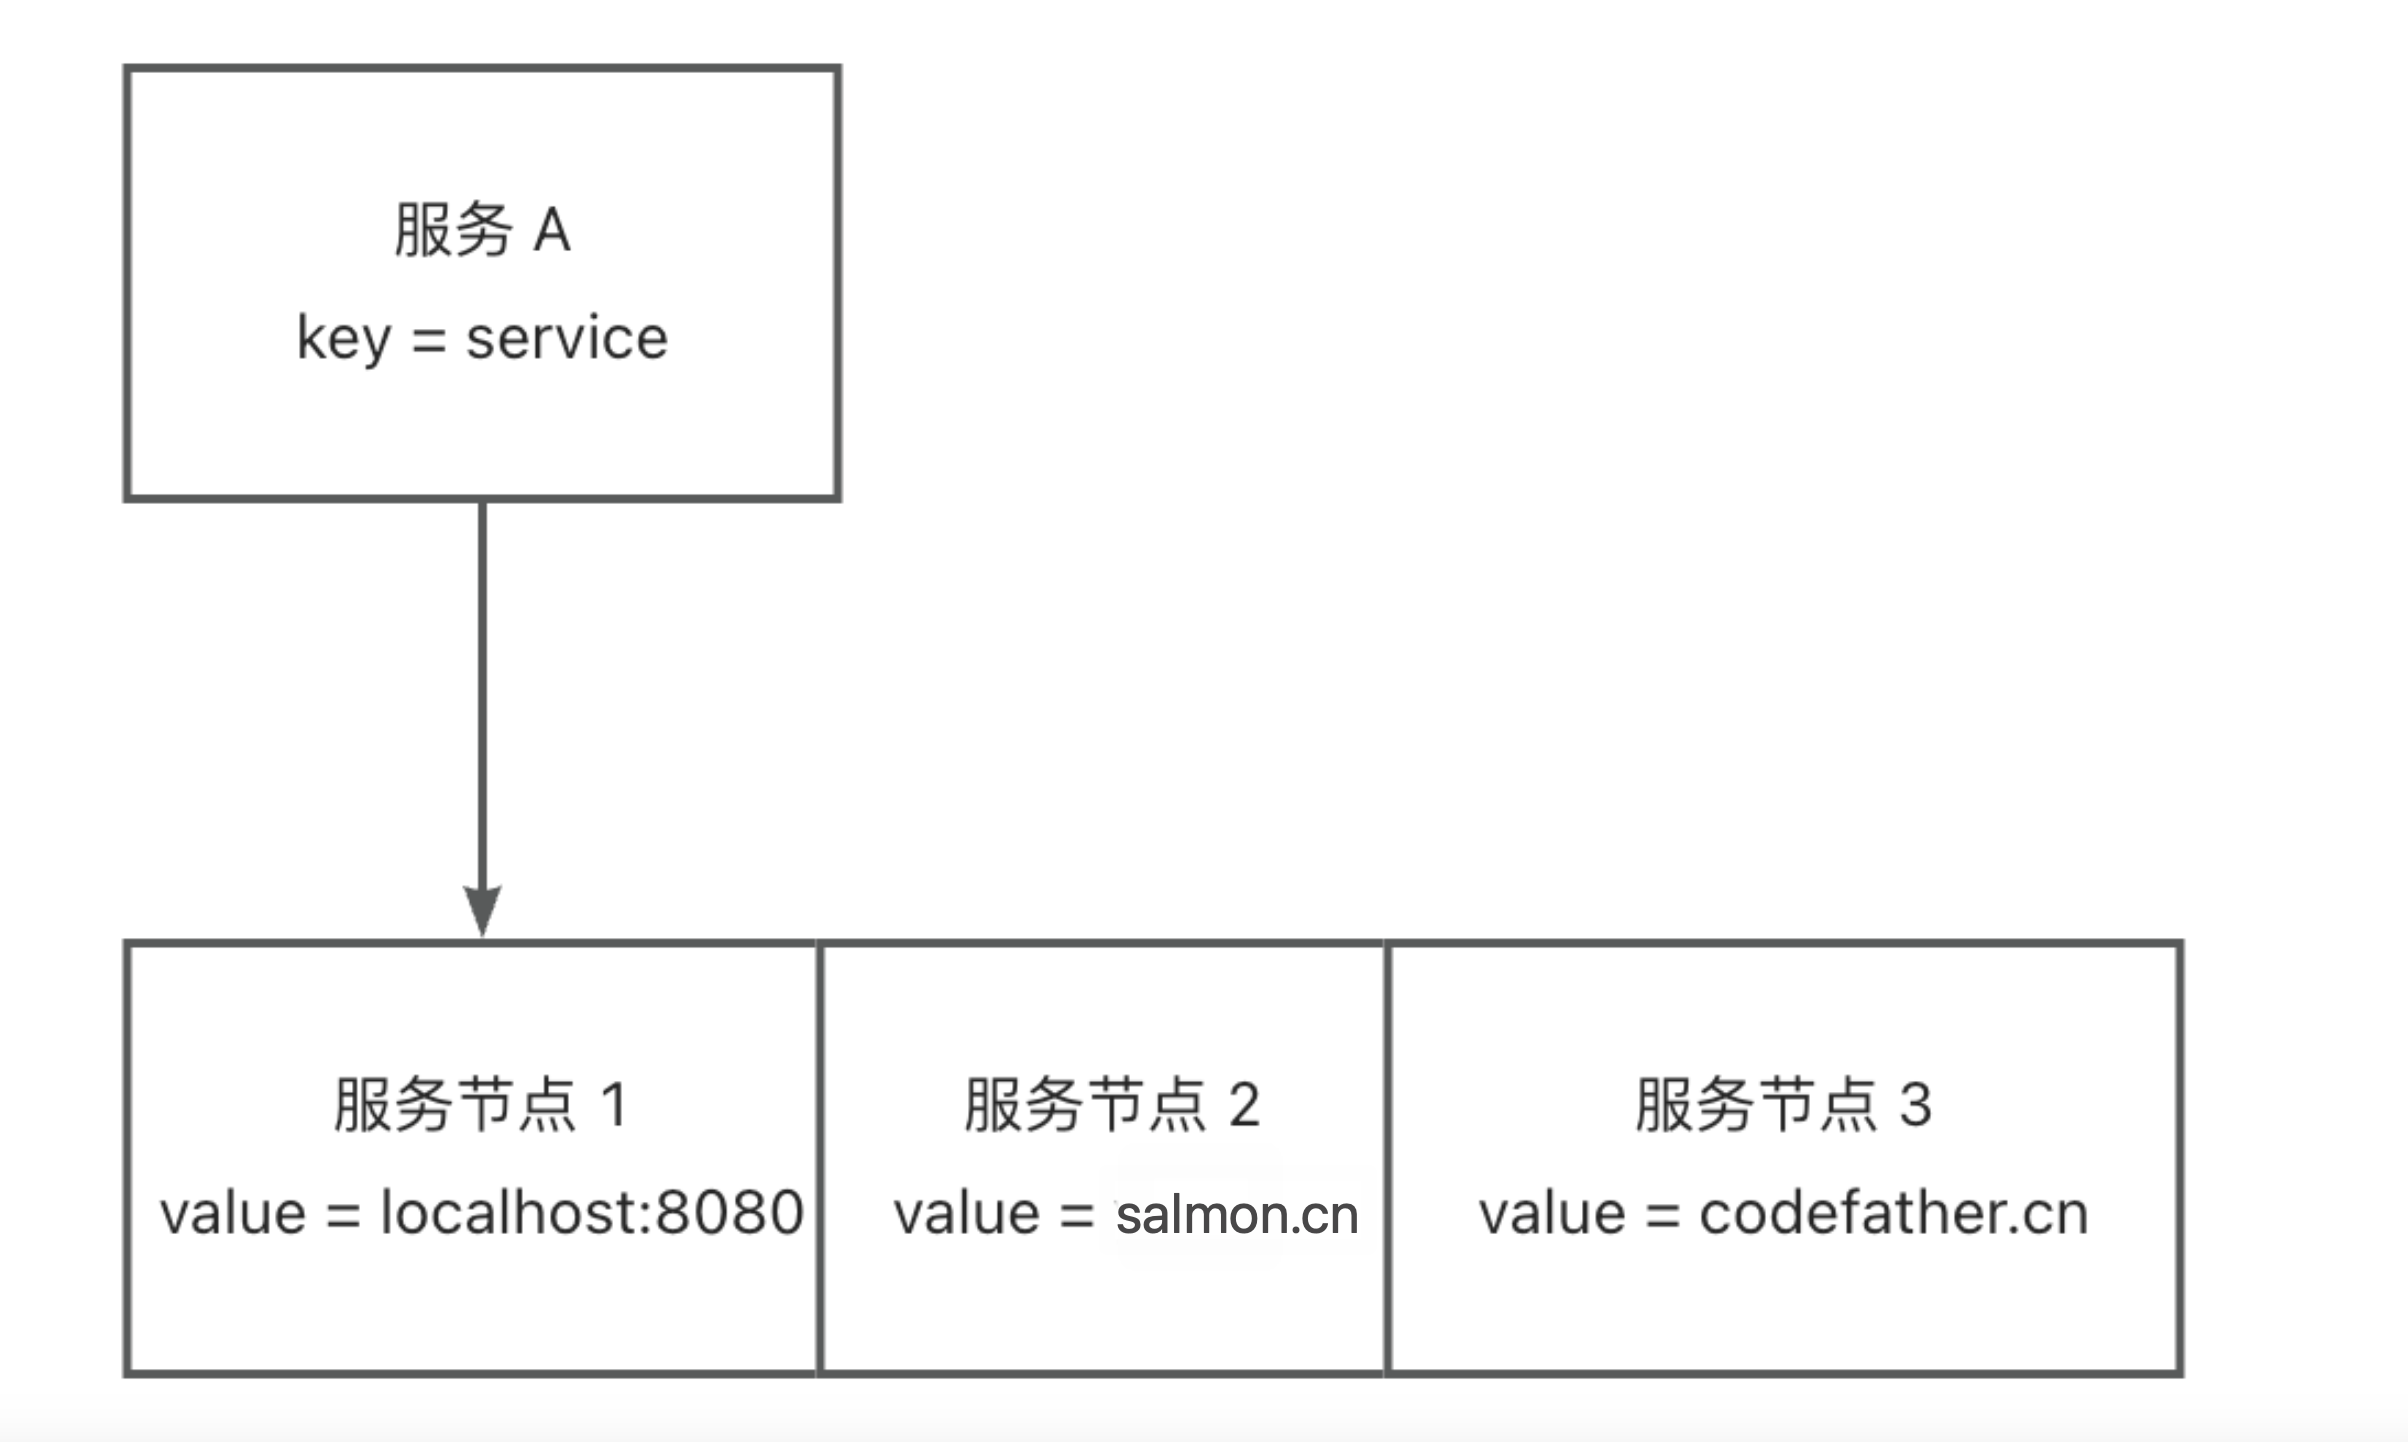
选择哪种存储结构呢?这个也会跟我们的技术选型有关。对于 ZooKeeper 和 Etcd 这种支持层级查询的中间件,用第一种结构会更清晰;对于 Redi`s,由于本身就支持列表数据结构,可以选择第二种结构。
最后,一定要给 key 设置过期时间,比如默认 30 秒过期,这样如果服务提供者宕机了,也可以超时后自动移除。
做好整体的方案设计后,下面我们开发实现。
三、开发实现
1、注册中心开发
1)注册信息定义。
在 model 包下新建 ServiceMetaInfo 类,封装服务的注册信息,包括服务名称、服务版本号、服务地址(域名和端口号)、服务分组等。
java
package com.salmon.model;

import lombok.Data;

/**
 * 服务元信息(注册信息)
 *
 * @author Salmon
 * @since 2024-05-04
 */
@Data
public class ServiceMetaInfo {

    /**
     * 服务名称
     */
    private String serviceName;

    /**
     * 服务版本号
     */
    private String serviceVersion = "1.0";

    /**
     * 服务域名
     */
    private String serviceHost;

    /**
     * 服务端口号
     */
    private Integer servicePort;

    /**
     * 服务分组(暂未实现)
     */
    private String serviceGroup = "default";

}需要给 ServiceMetaInfo 增加一些工具方法,用于获取服务注册键名、获取服务注册节点键名等。
可以把版本号和分组都放到服务键名中,就可以在查询时根据这些参数获取对应版本和分组的服务了。
代码如下:
java
/**
 * 获取服务键名
 *
 * @return key
 */
public String getServiceKey() {
    // 后续可扩展服务分组
    // return String.format("%s:%s:%s", serviceName, serviceVersion, serviceGroup);
    return String.format("%s:%s", serviceName, serviceVersion);
}
/**
 * 获取服务注册节点键名
 *
 * @return key
 */
public String getServiceNodeKey() {
    return String.format("%s/%s:%s", getServiceKey(), serviceHost, servicePort);
}由于注册信息里包含了服务版本号字段,所以我们也可以给 RpcRequest 对象补充服务版本号字段,可以先作为预留字段,默认值为 "1.0",后续再自行实现。
在 RpcConstant 常量类中补充默认服务版本常量:
java
package com.salmon.constant;

/**
 * RPC 相关常量
 *
 * @author Salmon
 * @since 2024-05-02
 */
public interface RpcConstant {

    /**
     * 默认配置文件加载前缀
     */
    String DEFAULT_CONFIG_PREFIX = "rpc";

    /**
     * 默认服务版本
     */
    String DEFAULT_SERVICE_VERSION = "1.0";
}在 RpcRequest 请求类中使用该常量,代码如下:
java
package com.salmon.model;

import com.salmon.constant.RpcConstant;
import lombok.AllArgsConstructor;
import lombok.Builder;
import lombok.Data;
import lombok.NoArgsConstructor;

import java.io.Serializable;

/**
 * RPC 请求
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Data
@Builder
@AllArgsConstructor
@NoArgsConstructor
public class RpcRequest implements Serializable {

    /**
     * 服务名称
     */
    private String serviceName;

    /**
     * 方法名称
     */
    private String methodName;

    /**
     * 服务版本
     */
    private String serviceVersion = RpcConstant.DEFAULT_SERVICE_VERSION;

    /**
     * 参数类型列表
     */
    private Class<?>[] parameterTypes;

    /**
     * 参数列表
     */
    private Object[] args;
}2)注册中心配置。
在 config 包下编写注册中心配置类 RegistryConfig,让用户配置连接注册中心所需的信息,比如注册中心类别、注册中心地址、用户名、密码、连接超时时间等。
代码如下:
java
package com.salmon.config;

import lombok.Data;

/**
 * RPC 框架注册中心配置
 *
 * @author Salmon
 * @since 2024-05-04
 */
@Data
public class RegistryConfig {
    /**
     * 注册中心类别
     */
    private String registry = "etcd";

    /**
     * 注册中心地址
     */
    private String address = "http://localhost:2380";

    /**
     * 用户名
     */
    private String username;

    /**
     * 密码
     */
    private String password;

    /**
     * 超时时间(单位毫秒)
     */
    private Long timeout = 10000L;
}还要为 RpcConfig 全局配置补充注册中心配置,代码如下:
java
package com.salmon.config;

import com.salmon.serializer.SerializerKeys;
import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;

    /**
     * 序列化器
     */
    private String serializer = SerializerKeys.JDK;

    /**
     * 注册中心配置
     */
    private RegistryConfig registryConfig = new RegistryConfig();
}3)注册中心接口。
遵循可扩展设计,我们先写一个注册中心接口,后续可以实现多种不同的注册中心,并且和序列化器一样,可以使用 SPI 机制动态加载。
注册中心接口代码如下,主要是提供了初始化、注册服务、注销服务、服务发现(获取服务节点列表)、服务销毁等方法。
java
package com.salmon.registry;

import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;

/**
 * 注册中心
 *
 * @author Salmon
 * @since 2024-05-04
 */
public interface Registry {

    /**
     * 初始化
     *
     * @param registryConfig 初始化配置
     */
    void init(RegistryConfig registryConfig);

    /**
     * 注册服务(服务端)
     *
     * @param serviceMetaInfo 服务注册信息
     * @throws Exception 异常
     */
    void register(ServiceMetaInfo serviceMetaInfo) throws Exception;

    /**
     * 注销服务(服务端)
     *
     * @param serviceMetaInfo 待注销的服务信息
     */
    void unRegister(ServiceMetaInfo serviceMetaInfo);

    /**
     * 服务发现(获取某服务的所有节点,消费端)
     *
     * @param serviceKey 服务键名
     * @return 某服务的所有节点信息
     */
    List<ServiceMetaInfo> serviceDiscovery(String serviceKey);

    /**
     * 服务销毁
     */
    void destroy();
}4)Etcd 注册中心实现。
在 registry 目录下新建 EtcdRegistry 类,实现注册中心接口,先完成初始化方法,读取注册中心配置并初始化客户端对象。
代码如下:
java
package com.salmon.registry;

import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;
import io.etcd.jetcd.Client;
import io.etcd.jetcd.KV;

import java.time.Duration;
import java.util.List;

/**
 * Etcd 注册中心
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class EtcdRegistry implements Registry {

    private Client client;
    private KV kvClient;

    /**
     * 根节点
     */
    private static final String ETCD_ROOT_PATH = "/rpc/";

    @Override
    public void init(RegistryConfig registryConfig) {
        client = Client.builder()
                .endpoints(registryConfig.getAddress())
                .connectTimeout(Duration.ofMillis(registryConfig.getTimeout()))
                .build();
        kvClient = client.getKVClient();
    }
}上述代码中,我们定义 Etcd 键存储的根路径为 /rpc/,为了区分不同的项目。
依次实现不同的方法,首先是服务注册,创建 key 并设置过期时间,value 为服务注册信息的 JSON 序列化。代码如下:
java
@Override
public void register(ServiceMetaInfo serviceMetaInfo) throws Exception {
    // 创建 Lease 和 KV 客户端
    Lease leaseClient = client.getLeaseClient();
    // 创建一个 30 秒的租约
    long leaseId = leaseClient.grant(30).get().getID();
    // 设置要存储的键值对
    // /rpc/userService:1.0:localhost:8080
    String registerKey = ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey();
    ByteSequence key = ByteSequence.from(registerKey, StandardCharsets.UTF_8);
    ByteSequence value = ByteSequence.from(JSONUtil.toJsonStr(serviceMetaInfo), StandardCharsets.UTF_8);
    // 将键值对与租约关联起来,并设置过期时间
    PutOption putOption = PutOption.builder().withLeaseId(leaseId).build();
    kvClient.put(key, value, putOption);
}
然后是服务注销,删除 key:
java
@Override
public void unRegister(ServiceMetaInfo serviceMetaInfo) {
    kvClient.delete(ByteSequence.from(ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey(), StandardCharsets.UTF_8));
}
然后是服务发现,根据服务名称作为前缀,从 Etcd 获取服务下的节点列表:
java
@Override
public List<ServiceMetaInfo> serviceDiscovery(String serviceKey) {
    // 前缀搜索,结尾一定要加 '/'
    String searchPrefix = ETCD_ROOT_PATH + serviceKey + "/";
    try {
        // 前缀查询
        GetOption getOption = GetOption.builder().isPrefix(true).build();
        List<KeyValue> keyValues = kvClient.get(
                ByteSequence.from(searchPrefix, StandardCharsets.UTF_8),
                getOption
        ).get().getKvs();
        // 解析服务信息
        return keyValues.stream().map(keyValue -> {
            String value = keyValue.getValue().toString(StandardCharsets.UTF_8);
            return JSONUtil.toBean(value, ServiceMetaInfo.class);
        }).collect(Collectors.toList());
    } catch (Exception e) {
        throw new RuntimeException("获取服务列表失败", e);
    }
}最后是注册中心销毁,用于项目关闭后释放资源:
java
@Override
public void destroy() {
    System.out.println("当前节点下线");
    // 释放资源
    if (kvClient != null) {
        kvClient.close();
    }
    if (client != null) {
        client.close();
    }
}
注册中心实现类的完整代码如下:
java
package com.salmon.registry;

import cn.hutool.json.JSONUtil;
import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;
import io.etcd.jetcd.*;
import io.etcd.jetcd.options.GetOption;
import io.etcd.jetcd.options.PutOption;

import java.nio.charset.StandardCharsets;
import java.time.Duration;
import java.util.List;
import java.util.stream.Collectors;

/**
 * Etcd 注册中心
 *
 * @author Salmon
 * @since 2024-05-03
 */
public class EtcdRegistry implements Registry {

    private Client client;
    private KV kvClient;

    /**
     * 根节点
     */
    private static final String ETCD_ROOT_PATH = "/rpc/";

    @Override
    public void init(RegistryConfig registryConfig) {
        client = Client.builder()
                .endpoints(registryConfig.getAddress())
                .connectTimeout(Duration.ofMillis(registryConfig.getTimeout()))
                .build();
        kvClient = client.getKVClient();
    }

    @Override
    public void register(ServiceMetaInfo serviceMetaInfo) throws Exception {
        // 创建 Lease 和 KV 客户端
        Lease leaseClient = client.getLeaseClient();

        // 创建一个 30 秒的租约
        long leaseId = leaseClient.grant(30).get().getID();

        // 设置要存储的键值对
        // /rpc/userService:1.0:localhost:8080
        String registerKey = ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey();
        ByteSequence key = ByteSequence.from(registerKey, StandardCharsets.UTF_8);
        ByteSequence value = ByteSequence.from(JSONUtil.toJsonStr(serviceMetaInfo), StandardCharsets.UTF_8);

        // 将键值对与租约关联起来,并设置过期时间
        PutOption putOption = PutOption.builder().withLeaseId(leaseId).build();
        kvClient.put(key, value, putOption);
    }

    @Override
    public void unRegister(ServiceMetaInfo serviceMetaInfo) {
        kvClient.delete(ByteSequence.from(ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey(), StandardCharsets.UTF_8));
    }

    @Override
    public List<ServiceMetaInfo> serviceDiscovery(String serviceKey) {
        // 前缀搜索,结尾一定要加 '/'
        String searchPrefix = ETCD_ROOT_PATH + serviceKey + "/";

        try {
            // 前缀查询
            GetOption getOption = GetOption.builder().isPrefix(true).build();
            List<KeyValue> keyValues = kvClient.get(
                    ByteSequence.from(searchPrefix, StandardCharsets.UTF_8),
                    getOption
            ).get().getKvs();
            // 解析服务信息
            return keyValues.stream().map(keyValue -> {
                String value = keyValue.getValue().toString(StandardCharsets.UTF_8);
                return JSONUtil.toBean(value, ServiceMetaInfo.class);
            }).collect(Collectors.toList());
        } catch (Exception e) {
            throw new RuntimeException("获取服务列表失败", e);
        }
    }

    @Override
    public void destroy() {
        System.out.println("当前节点下线");
        // 释放资源
        if (kvClient != null) {
            kvClient.close();
        }
        if (client != null) {
            client.close();
        }
    }
}2、支持配置和扩展注册中心
一个成熟的 RPC 框架可能会支持多个注册中心,像序列化器一样,我们的需求是,让开发者能够填写配置来指定使用的注册中心,并且支持自定义注册中心,让框架更易用、更利于扩展。
要实现这点,开发方式和序列化器也是一样的,都可以使用工厂创建对象、使用 SPI 动态加载自定义的注册中心。
1)注册中心常量。
在 registry 包下新建 RegistryKeys 类,列举所有支持的注册中心键名。
代码如下:
java
package com.salmon.config;

/**
 * 注册中心键名常量
 *
 * @author Salmon
 * @since 2024-05-04
 */
public interface RegistryKeys {

    String ETCD = "etcd";

    String ZOOKEEPER = "zookeeper";
}
2)使用工厂模式,支持根据 key 从 SPI 获取注册中心对象实例。
在 registry 包下新建 RegistryFactory 类,代码如下:
java
package com.salmon.registry;

import cn.hutool.core.util.StrUtil;
import com.salmon.spi.SpiLoader;

/**
 * 注册中心工厂(用于获取注册中心对象)
 *
 * @author Salmon
 * @since 2024-05-04
 */
public class RegistryFactory {

    static {
        SpiLoader.load(Registry.class);
    }

    /**
     * 默认注册中心
     */
    private static final Registry DEFAULT_REGISTRY = new EtcdRegistry();

    /**
     * 获取注册中心实例
     *
     * @param key 指定的注册中心
     * @return 注册中心实例
     */
    public static Registry getInstance(String key) {
        if (StrUtil.isBlank(key)) {
            return DEFAULT_REGISTRY;
        }
        return SpiLoader.getInstance(Registry.class, key);
    }
}这个类可以直接复制之前的 SerializerFactory,然后略做修改。可以发现,只要跑通了 SPI 机制,后续的开发就很简单了~
3)在 META-INF 的 rpc/system 目录下编写注册中心接口的 SPI 配置文件,文件名称为 com.salmon.registry.Registry。
如图:
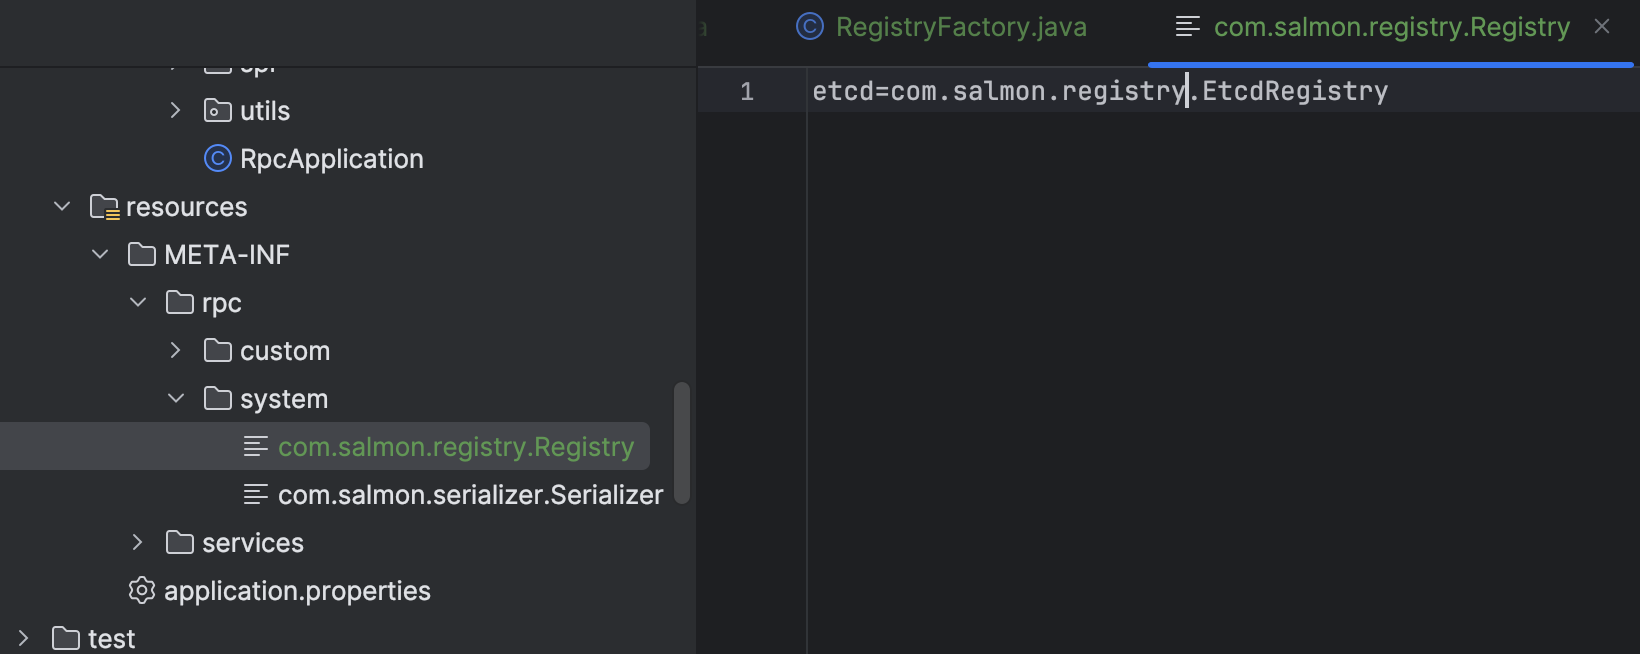
代码如下:
properties
etcd=com.salmon.registry.EtcdRegistry4)最后,我们需要一个位置来初始化注册中心。由于服务提供者和服务消费者都需要和注册中心建立连接,是一个 RPC 框架启动必不可少的环节,所以可以将初始化流程放在 RpcApplication 类中。
修改其 init 方法代码如下:
java
/**
 * 框架初始化,支持传入自定义配置
 *
 * @param newRpcConfig 配置
 */
public static void init(RpcConfig newRpcConfig) {
    rpcConfig = newRpcConfig;
    log.info("rpc init, config = {}", newRpcConfig);
    // 注册中心初始化
    RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
    // 根据注册中心类别获取注册中心实例
    Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());
    registry.init(registryConfig);
    log.info("registry init, config = {}", registryConfig);
}
3、完成调用流程
下面我们要改造服务消费者调用服务的代码,跑通整个动态获取节点并调用的流程。
1)服务消费者需要先从注册中心获取节点信息,再得到调用地址并执行。
需要给 ServiceMetaInfo 类增加一个方法,便于获取可调用的地址,代码如下:
java
/**
 * 获取完整服务地址
 *
 * @return 服务地址
 */
public String getServiceAddress() {
    // 如果不包含 http,则要加上
    if (!StrUtil.contains(serviceHost, "http")) {
        return String.format("http://%s:%s", serviceHost, servicePort);
    }
    return String.format("%s:%s", serviceHost, servicePort);
}
2)修改服务代理 ServiceProxy 类,更改调用逻辑。
修改的部分代码如下:
java
...

// 序列化
byte[] bodyBytes = serializer.serialize(rpcRequest);
// 从注册中心获取服务提供者请求地址
RpcConfig rpcConfig = RpcApplication.getRpcConfig();
// 获取到具体的注册中心实例
Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
// 封装服务注册信息
ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
serviceMetaInfo.setServiceName(serviceName);
serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
// 获取该服务的所有节点
List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
if (CollUtil.isEmpty(serviceMetaInfoList)) {
    throw new RuntimeException("暂无服务地址");
}
// todo 暂时先取第一个节点,后续通过负载均衡来获取
ServiceMetaInfo selectedServiceMetaInfo = serviceMetaInfoList.get(0);
// 发起 HTTP 请求,远程调用服务的方法
try (HttpResponse httpResponse = HttpRequest.post(selectedServiceMetaInfo.getServiceAddress())
        .body(bodyBytes)
        .execute()) {
    if (httpResponse.isOk()) {
        byte[] result = httpResponse.bodyBytes();
        // 反序列化 RPC 响应
        RpcResponse rpcResponse = serializer.deserialize(result, RpcResponse.class);
        return rpcResponse.getData();
    }
}

...注意,从注册中心获取到的服务节点地址可能是多个。上述代码中,我们为了方便,暂时先取第一个,之后会带大家对这里的代码进行优化。
ServiceProxy 的完整代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import cn.hutool.http.HttpRequest;
import cn.hutool.http.HttpResponse;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;

import java.io.IOException;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.List;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 指定序列化器
        final Serializer serializer = SerializerFactory.getInstance(RpcApplication.getRpcConfig().getSerializer());

        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();
        try {
            // 序列化
            byte[] bodyBytes = serializer.serialize(rpcRequest);

            // 从注册中心获取服务提供者请求地址
            RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 获取到具体的注册中心实例
            Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
            // 获取该服务的所有节点
            List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
            if (CollUtil.isEmpty(serviceMetaInfoList)) {
                throw new RuntimeException("暂无服务地址");
            }
            // todo 暂时先取第一个节点,后续通过负载均衡来获取
            ServiceMetaInfo selectedServiceMetaInfo = serviceMetaInfoList.get(0);

            // 发起 HTTP 请求,远程调用服务的方法
            try (HttpResponse httpResponse = HttpRequest.post(selectedServiceMetaInfo.getServiceAddress())
                    .body(bodyBytes)
                    .execute()) {
                if (httpResponse.isOk()) {
                    byte[] result = httpResponse.bodyBytes();
                    // 反序列化 RPC 响应
                    RpcResponse rpcResponse = serializer.deserialize(result, RpcResponse.class);
                    return rpcResponse.getData();
                }
            }
        } catch (IOException e) {
            e.printStackTrace();
        }
        return null;
    }
}四、测试
1、注册中心测试
首先验证注册中心能否正常完成服务注册、注销、服务发现。
编写单元测试类 RegistryTest,代码如下:
java
import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.EtcdRegistry;
import com.salmon.registry.Registry;
import org.junit.Assert;
import org.junit.Before;
import org.junit.Test;

import java.util.List;

/**
 * 注册中心测试
 *
 * @author Salmon
 * @since 2024-05-04
 */
public class RegistryTest {

    final Registry registry = new EtcdRegistry();

    @Before
    public void init() {
        RegistryConfig registryConfig = new RegistryConfig();
        registryConfig.setAddress("http://localhost:2379");
        registry.init(registryConfig);
    }

    @Test
    public void register() throws Exception {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.register(serviceMetaInfo);

        serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1235);
        registry.register(serviceMetaInfo);

        serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("2.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.register(serviceMetaInfo);
    }

    @Test
    public void unRegister() {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.unRegister(serviceMetaInfo);
    }

    @Test
    public void serviceDiscovery() {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        String serviceKey = serviceMetaInfo.getServiceKey();
        List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceKey);
        Assert.assertNotNull(serviceMetaInfoList);
    }
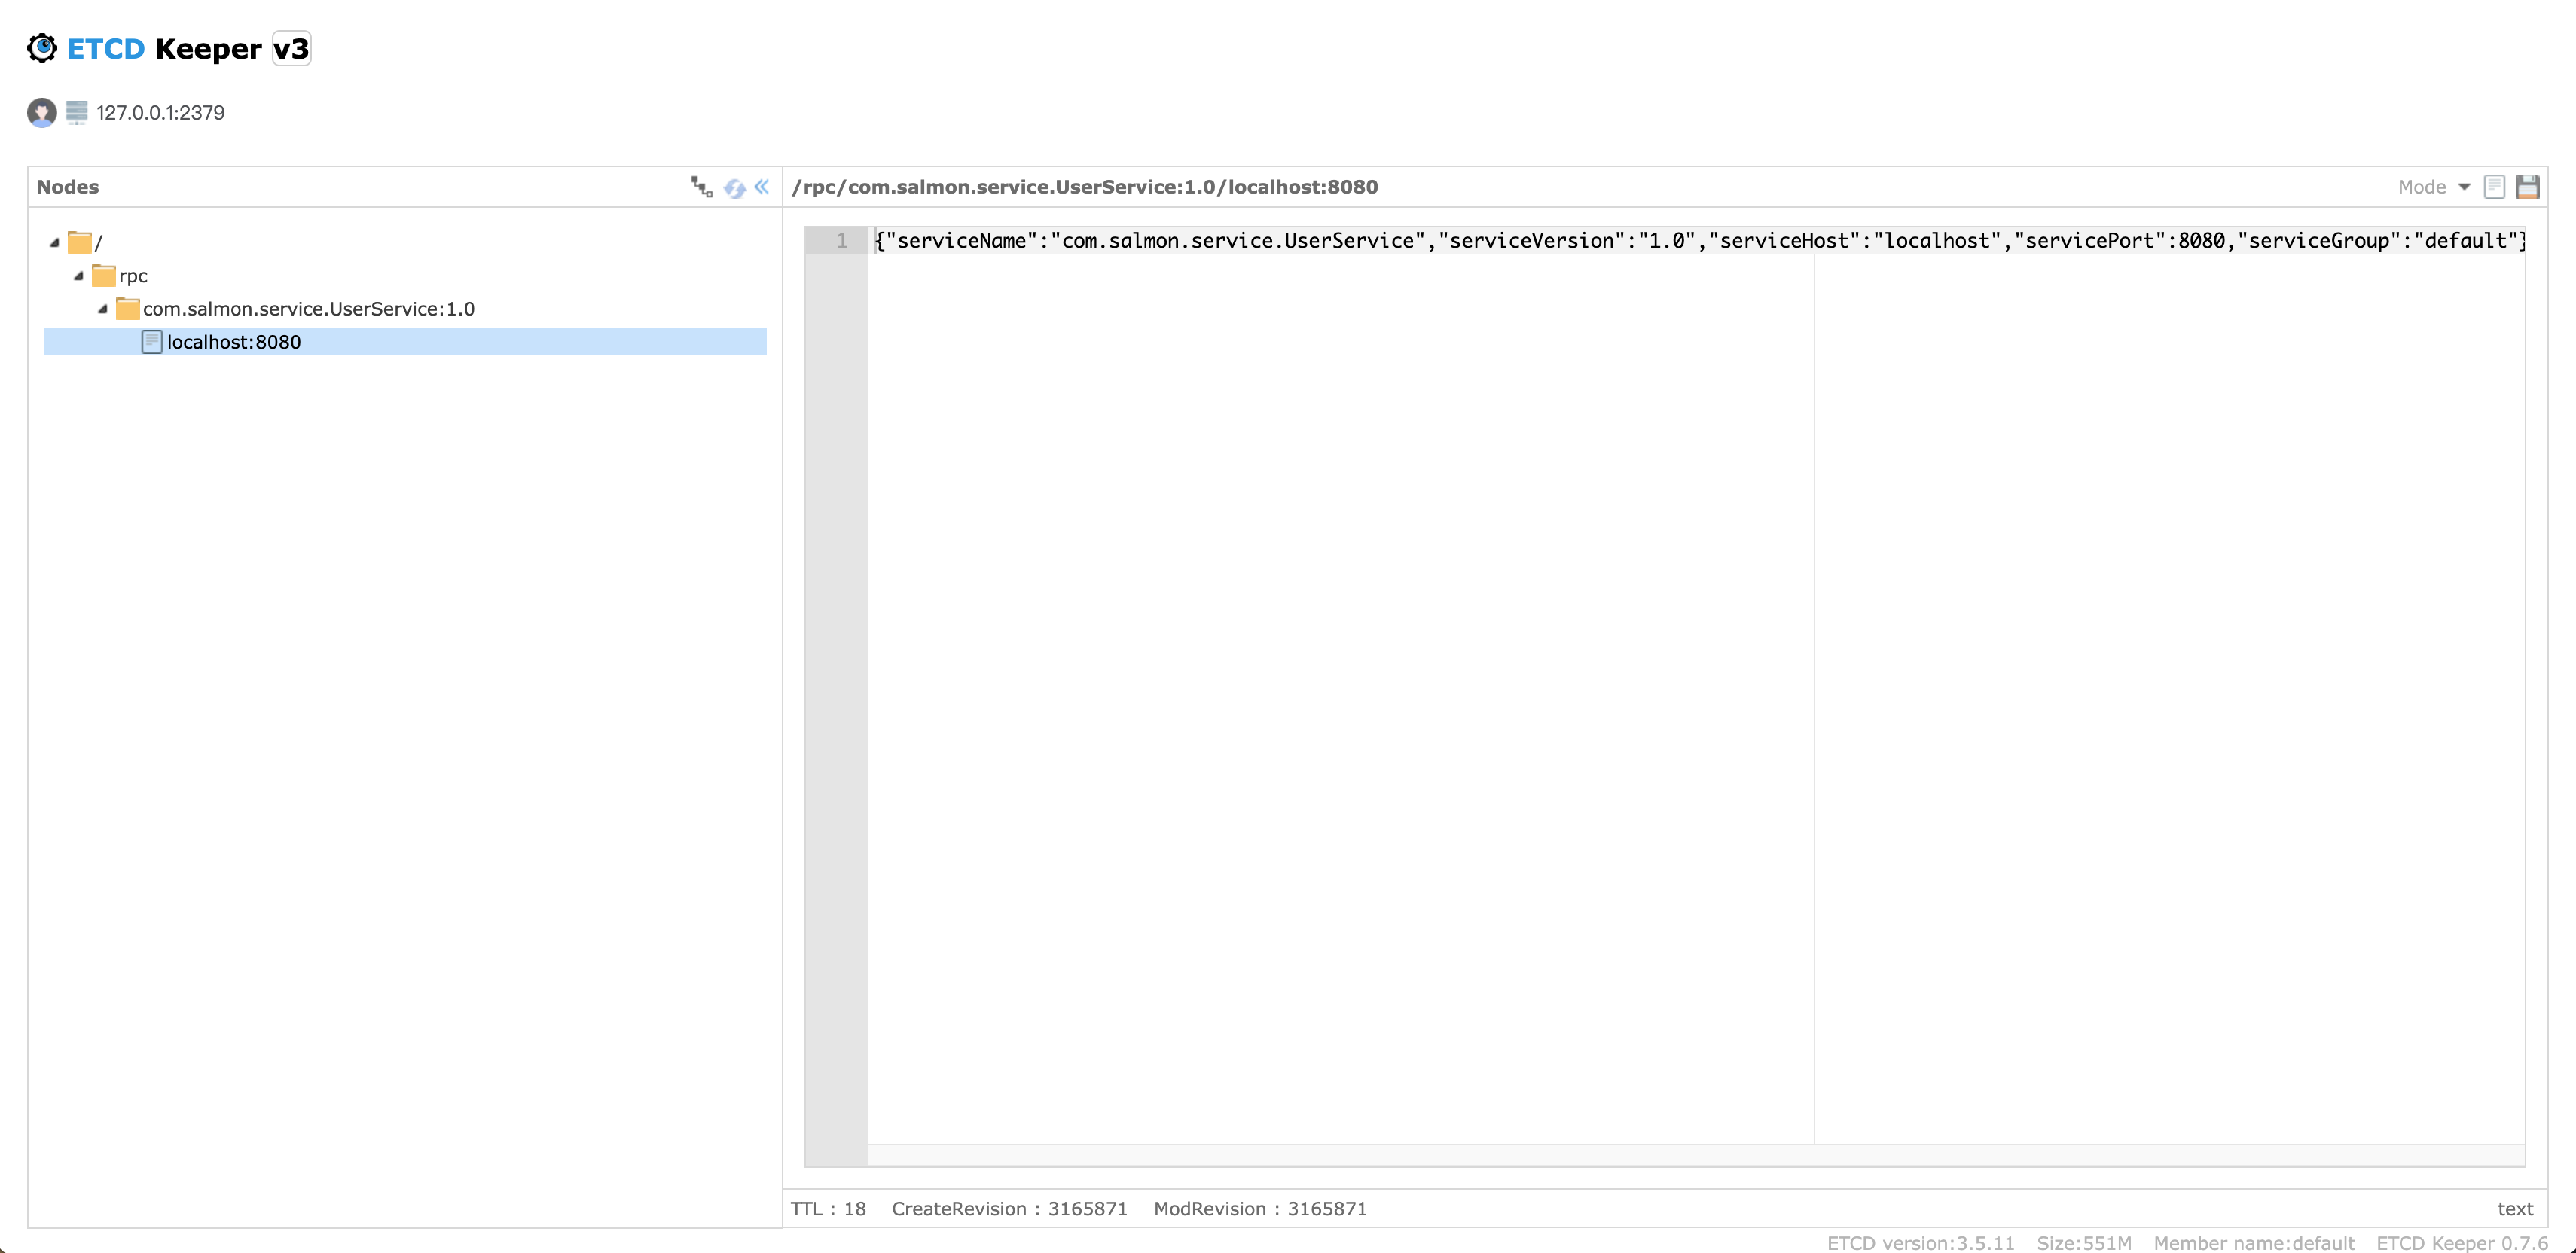
}服务注册后,打开 EtcdKeeper 可视化界面,能够看到注册成功的服务节点信息,如图:
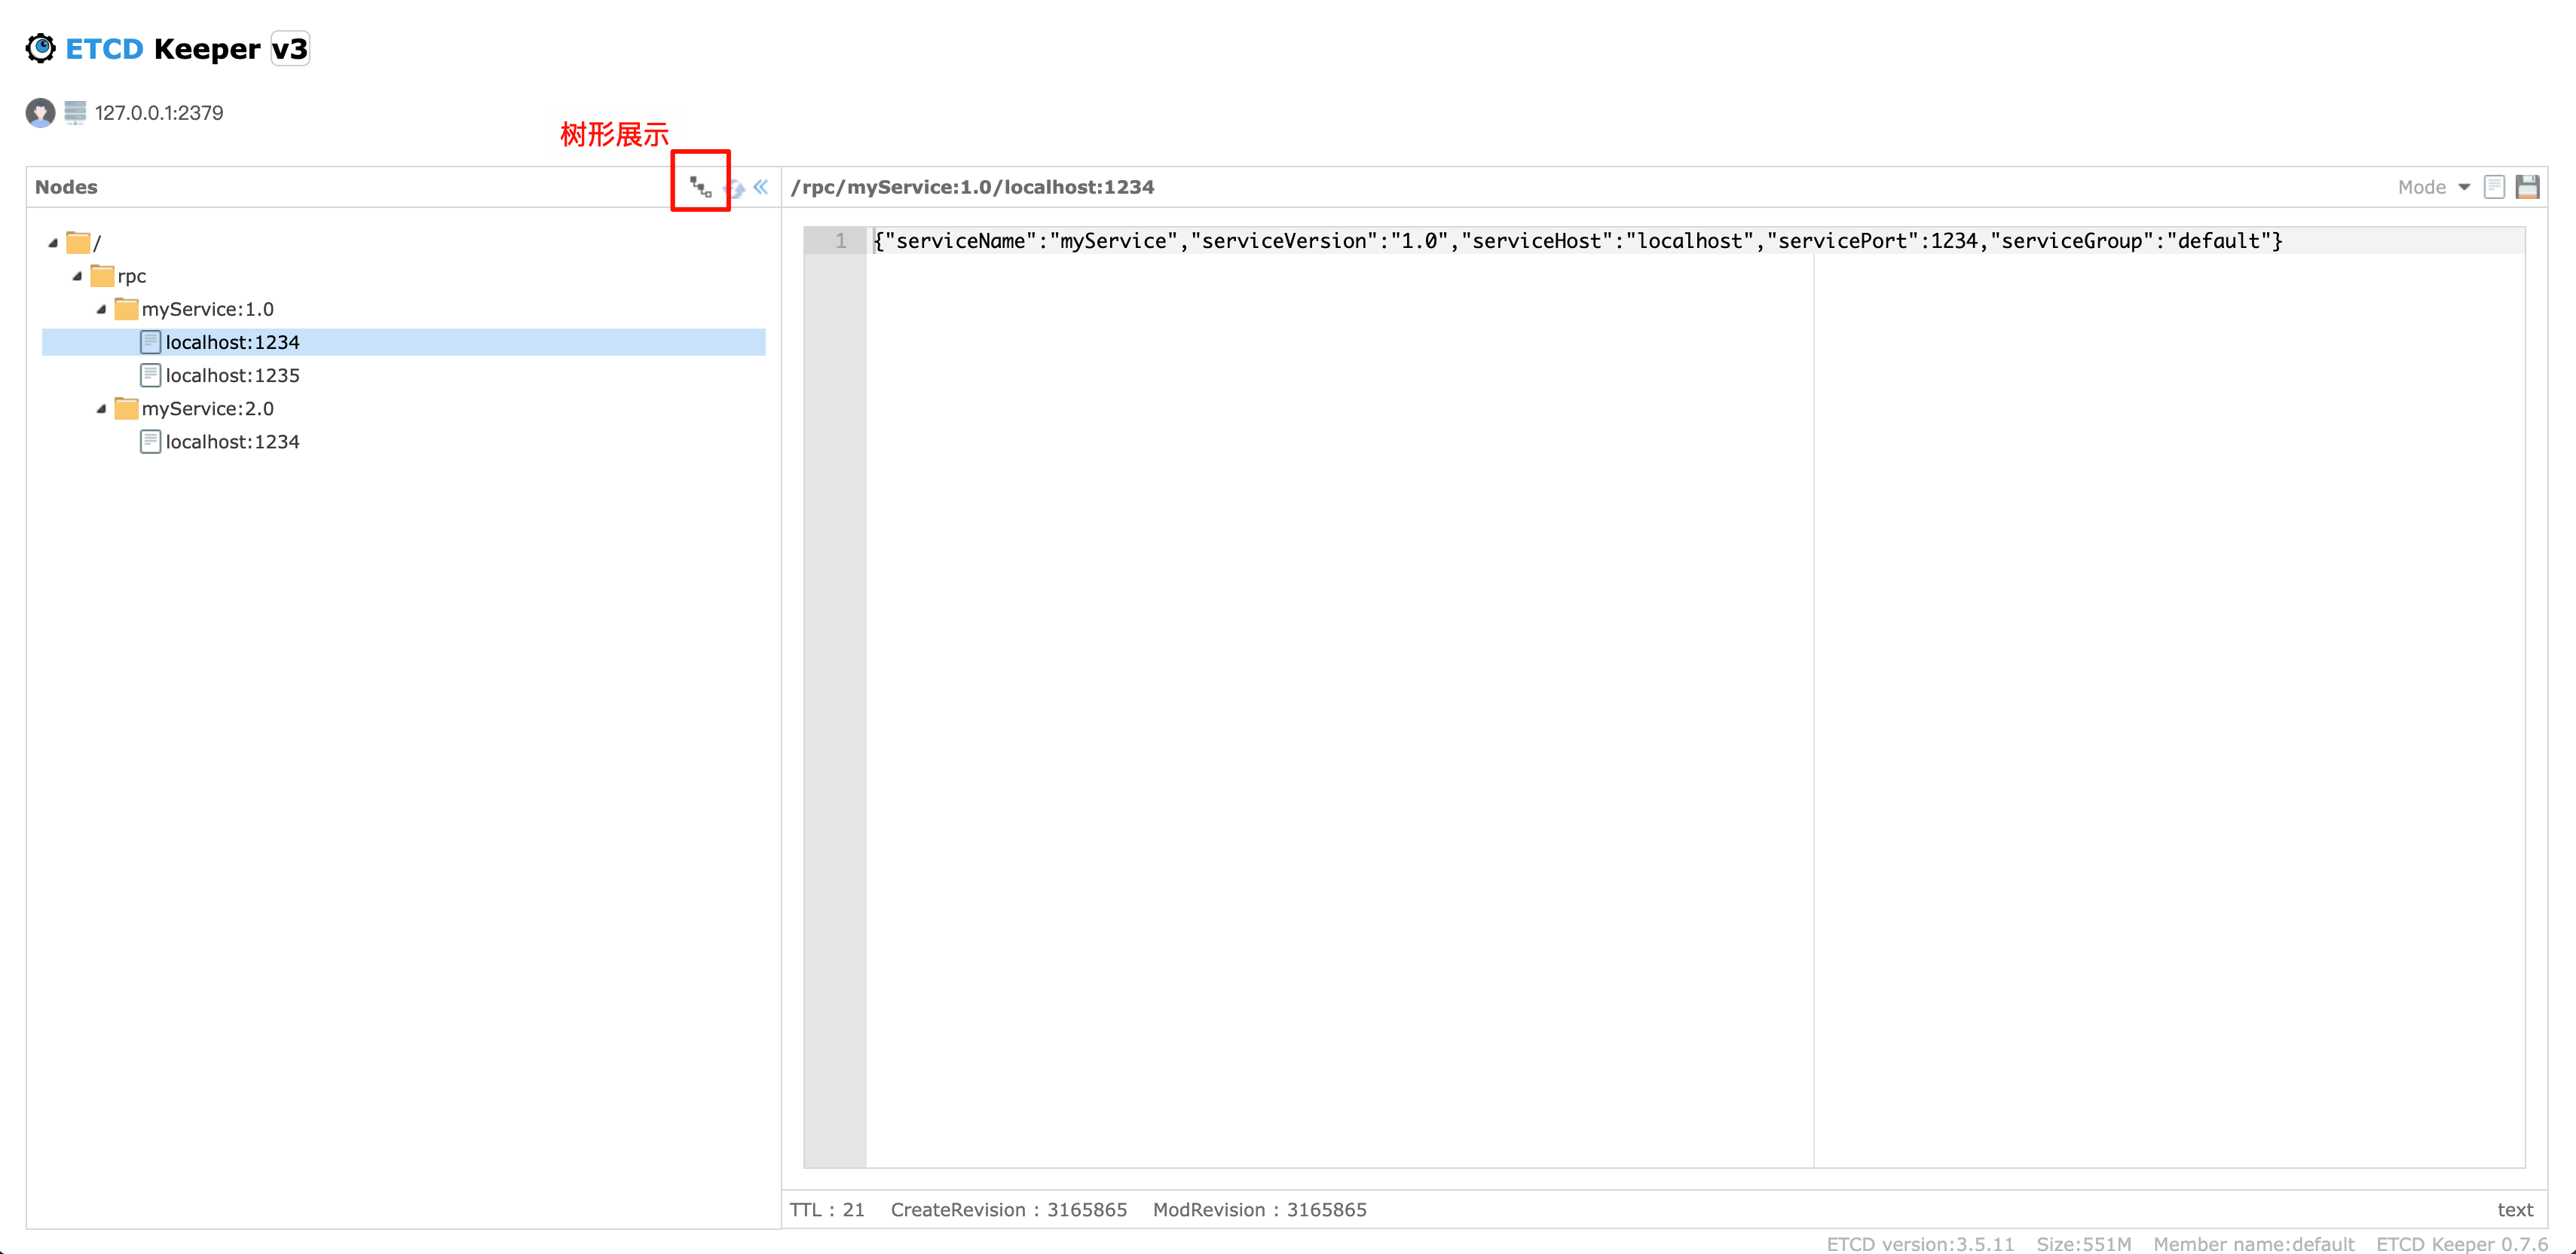
可以发现 key 列表是树形展示的,因为 Etcd 是层级结构,很清晰。
2、完整流程测试
在 example-provider 模块下新增服务提供者示例类,需要初始化 RPC 框架并且将服务手动注册到注册中心上。
代码如下:
java
package com.salmon;

import com.salmon.config.RegistryConfig;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.impl.UserServiceImpl;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.LocalRegistry;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.server.HttpServer;
import com.salmon.server.impl.VertxHttpServerImpl;
import com.salmon.service.UserService;

/**
 * 简易服务提供者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ProviderExample {
    public static void main(String[] args) {
        // RPC 框架初始化
        RpcApplication.init();

        // 注册服务
        String serviceName = UserService.class.getName();
        LocalRegistry.registry(serviceName, UserServiceImpl.class);

        // 注册服务到注册中心
        RpcConfig rpcConfig = RpcApplication.getRpcConfig();
        RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
        registryConfig.setAddress("http://localhost:2379");
        // 获取注册中心实例
        Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());

        // 封装服务注册信息
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName(serviceName);
        serviceMetaInfo.setServiceHost(rpcConfig.getServerHost());
        serviceMetaInfo.setServicePort(rpcConfig.getServerPort());

        try {
            // 注册服务
            registry.register(serviceMetaInfo);
        } catch (Exception e) {
            throw new RuntimeException(e);
        }

        // 启动 web 服务
        HttpServer httpServer = new VertxHttpServerImpl();
        httpServer.doStart(rpcConfig.getServerPort());
    }
}服务消费者的代码不用改动,我们依然是先启动提供者、再启动消费者,验证流程能否正常跑通。
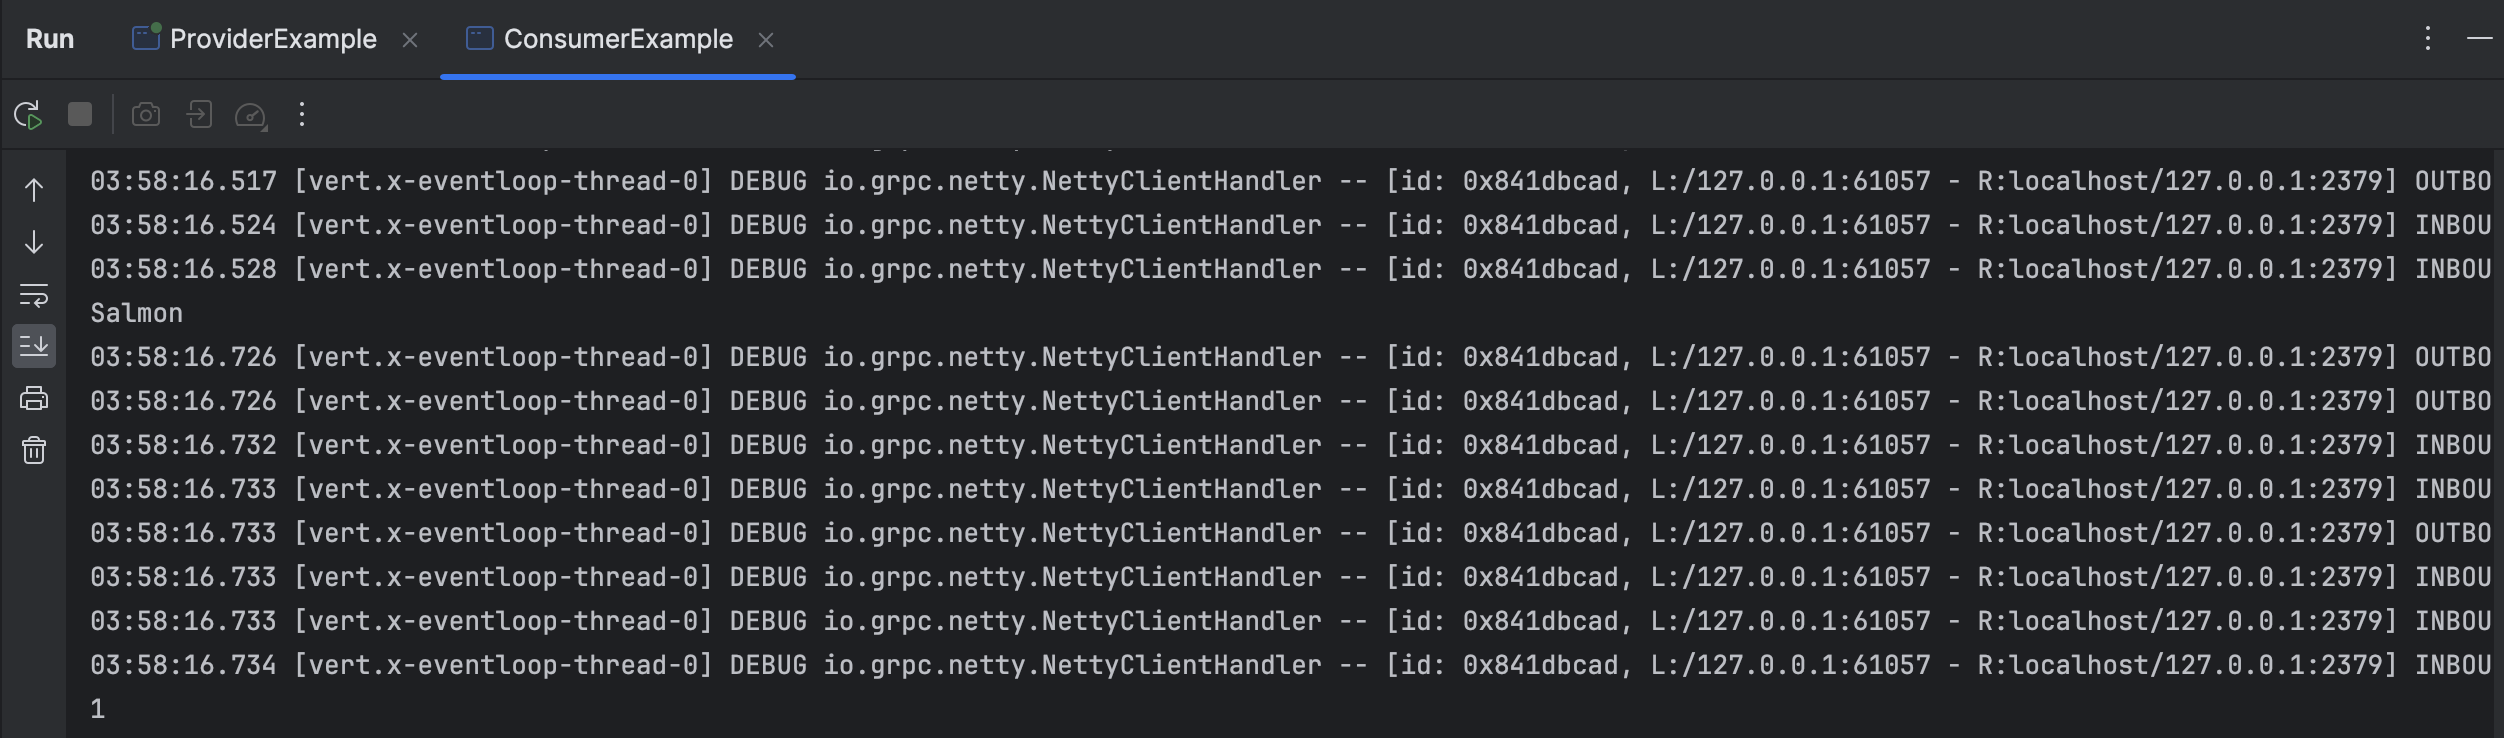
五、扩展
至此,我们完成基本的注册中心开发。大家可以思考下注册中心还有哪些值得去完善和优化的地方,下面将继续扩展注册中心。
注册中心优化
一、需求分析
之前我们基于 Etcd 完成了基础的注册中心,能够注册和获取服务和节点信息。
但目前系统仅仅是处于可用的程度,还有很多需要解决的问题和可优化点:
- 数据一致性:服务提供者如果下线了,注册中心需要即时更新,剔除下线节点。否则消费者可能会调用到已经下线的节点。
- 性能优化:服务消费者每次都需要从注册中心获取服务,可以使用缓存进行优化。
- 高可用性:保证注册中心本身不会宕机。
- 可扩展性:实现更多其他种类的注册中心。
下面,我将带大家实践 4 个注册中心的优化点:
- 心跳检测和续期机制
- 服务节点下线机制
- 消费端服务缓存
- 基于 ZooKeeper 的注册中心实现
二、注册中心优化
心跳检测和续期机制
心跳检测介绍
心跳检测(俗称 heartBeat)是一种用于监测系统是否正常工作的机制。它通过定期发送 心跳信号(请求)来检测目标系统的状态。
如果接收方在一定时间内没有收到心跳信号或者未能正常响应请求,就会认为目标系统故障或不可用,从而触发相应的处理或告警机制。
心跳检测的应用场景非常广泛,尤其是在分布式、微服务系统中,比如集群管理、服务健康检查等。
之前有同学问,我们怎么检测自己做的 web 后端是否正常运行呢?
一个最简单的方法,就是写一个心跳检测接口,比如:
java
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
public class HealthCheckController {

    // 健康检查接口
    @GetMapping("/actuator/health")
    public String healthCheck() {
        // 在这里可以添加其他健康检查逻辑,例如检查数据库连接、第三方服务等

        // 返回一个简单的健康状态
        return "OK";
    }
}然后我们只需要执行一个脚本,定期调用这个接口,如果调用失败,就知道系统故障了。
方案设计
1)从心跳检测的概念来看,实现心跳检测一般需要 2 个关键:定时、网络请求。
但是使用 Etcd 实现心跳检测会更简单一些,因为 Etcd 自带了 key 过期机制,我们不妨换个思路:给节点注册信息一个 “生命倒计时”,让节点定期 续期,重置 自己的 倒计时。如果节点已宕机,一直不续期,Etcd 就会对 key 进行过期删除。
一句话总结:到时间还不续期就是寄了。
在 Etcd 中,我们要实现心跳检测和续期机制,可以遵循如下步骤:
- 服务提供者向 Etcd 注册自己的服务信息,并在注册时设置 TTL(生存时间)。
- Etcd 在接收到服务提供者的注册信息后,会自动维护服务信息的 TTL,并在 TTL 过期时删除该服务信息。
- 服务提供者定期请求 Etcd 续签自己的注册信息,重写 TTL。
需要注意的是,续期时间一定要小于过期时间,允许一次容错的机会。
2)每个服务提供者都需要找到自己注册的节点、续期自己的节点,但问题是,怎么找到当前服务提供者项目自己的节点呢?
那就充分利用本地的特性,在服务提供者本地维护一个 已注册节点集合,注册时添加节点 key 到集合中,只需要续期集合内的 key 即可。
开发实现
1)给注册中心 Registry 接口补充心跳检测方法,代码如下:
java
package com.salmon.registry;

import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;

/**
 * 注册中心
 *
 * @author Salmon
 * @since 2024-05-04
 */
public interface Registry {

    ...

    /**
     * 心跳检测(服务端)
     */
    void heartBeat();
}2)维护续期节点集合。
定义一个本机注册的节点 key 集合,用于维护续期:
java
/**
 * 本机注册的节点 key 集合(用于维护续期)
 */
private final Set<String> localRegisterNodeKeySet = new HashSet<>();
在服务注册时,需要将节点添加到集合中,代码如下:
java
@Override
public void register(ServiceMetaInfo serviceMetaInfo) throws Exception {
    // 创建 Lease 和 KV 客户端
    Lease leaseClient = client.getLeaseClient();
    // 创建一个 30 秒的租约
    long leaseId = leaseClient.grant(30).get().getID();
    // 设置要存储的键值对
    // /rpc/userService:1.0:localhost:8080
    String registerKey = ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey();

    ByteSequence key = ByteSequence.from(registerKey, StandardCharsets.UTF_8);
    ByteSequence value = ByteSequence.from(JSONUtil.toJsonStr(serviceMetaInfo), StandardCharsets.UTF_8);
    // 将键值对与租约关联起来,并设置过期时间
    PutOption putOption = PutOption.builder().withLeaseId(leaseId).build();
    kvClient.put(key, value, putOption);
    // 添加节点信息到本地缓存
    localRegisterNodeKeySet.add(registerKey);
}同理,在服务注销时,也要从集合中移除对应节点:
java
@Override
public void unRegister(ServiceMetaInfo serviceMetaInfo) {
    String registerKey = ETCD_ROOT_PATH + serviceMetaInfo.getServiceNodeKey();
    kvClient.delete(ByteSequence.from(registerKey, StandardCharsets.UTF_8));
    // 也要从本地缓存移除
    localRegisterNodeKeySet.remove(registerKey);
}
3)在 EtcdRegistry 中实现 heartBeat 方法。
可以使用 Hutool 工具类的 CronUtil 实现定时任务,对所有集合中的节点执行 重新注册 操作,这是一个小 trick,就相当于续签了。
心跳检测方法的代码如下:
java
@Override
public void heartBeat() {
    // 每 10 秒续签一次
    CronUtil.schedule("*/10 * * * * *", new Task() {
        @Override
        public void execute() {
            for (String key : localRegisterNodeKeySet) {
                try {
                    List<KeyValue> keyValues = kvClient.get(ByteSequence.from(key, StandardCharsets.UTF_8)).get().getKvs();
                    // 该节点已过期(需要重启节点才能重新注册)
                    if (CollUtil.isEmpty(keyValues)) {
                        continue;
                    }
                    // 节点未过期,重新注册(相当于续签)
                    KeyValue keyValue = keyValues.get(0);
                    String value = keyValue.getValue().toString(StandardCharsets.UTF_8);
                    ServiceMetaInfo serviceMetaInfo = JSONUtil.toBean(value, ServiceMetaInfo.class);
                    register(serviceMetaInfo);
                } catch (Exception e) {
                    throw new RuntimeException(key + "续签失败", e);
                }
            }
        }
    });
    // 支持秒级别定时任务
    CronUtil.setMatchSecond(true);
    CronUtil.start();
}采用这种实现方案的好处是,即时 Etcd 注册中心的数据出现了丢失,通过心跳检测机制也会重新注册节点信息。
4)开启 heartBeat。
在注册中心初始化的 init 方法中,调用 heartBeat 方法即可。
代码如下:
java
@Override
public void init(RegistryConfig registryConfig) {
    client = Client.builder()
            .endpoints(registryConfig.getAddress())
            .connectTimeout(Duration.ofMillis(registryConfig.getTimeout()))
            .build();
    kvClient = client.getKVClient();
    heartBeat();
}
测试
完善之前的 RegistryTest 单元测试代码:
java
import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.EtcdRegistry;
import com.salmon.registry.Registry;
import org.junit.Assert;
import org.junit.Before;
import org.junit.Test;

import java.util.List;

/**
 * 注册中心测试
 *
 * @author Salmon
 * @since 2024-05-04
 */
public class RegistryTest {

    final Registry registry = new EtcdRegistry();

    @Before
    public void init() {
        RegistryConfig registryConfig = new RegistryConfig();
        registryConfig.setAddress("http://localhost:2379");
        registry.init(registryConfig);
    }

    @Test
    public void register() throws Exception {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.register(serviceMetaInfo);

        serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1235);
        registry.register(serviceMetaInfo);

        serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("2.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.register(serviceMetaInfo);
    }

    @Test
    public void unRegister() {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        serviceMetaInfo.setServiceHost("localhost");
        serviceMetaInfo.setServicePort(1234);
        registry.unRegister(serviceMetaInfo);
    }

    @Test
    public void serviceDiscovery() {
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName("myService");
        serviceMetaInfo.setServiceVersion("1.0");
        String serviceKey = serviceMetaInfo.getServiceKey();
        List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceKey);
        Assert.assertNotNull(serviceMetaInfoList);
    }

    @Test
    public void heartBeat() throws Exception {
        // init 方法中已经执行心跳检测了
        register();
        // 阻塞 1 分钟
        Thread.sleep(60 * 1000L);
    }
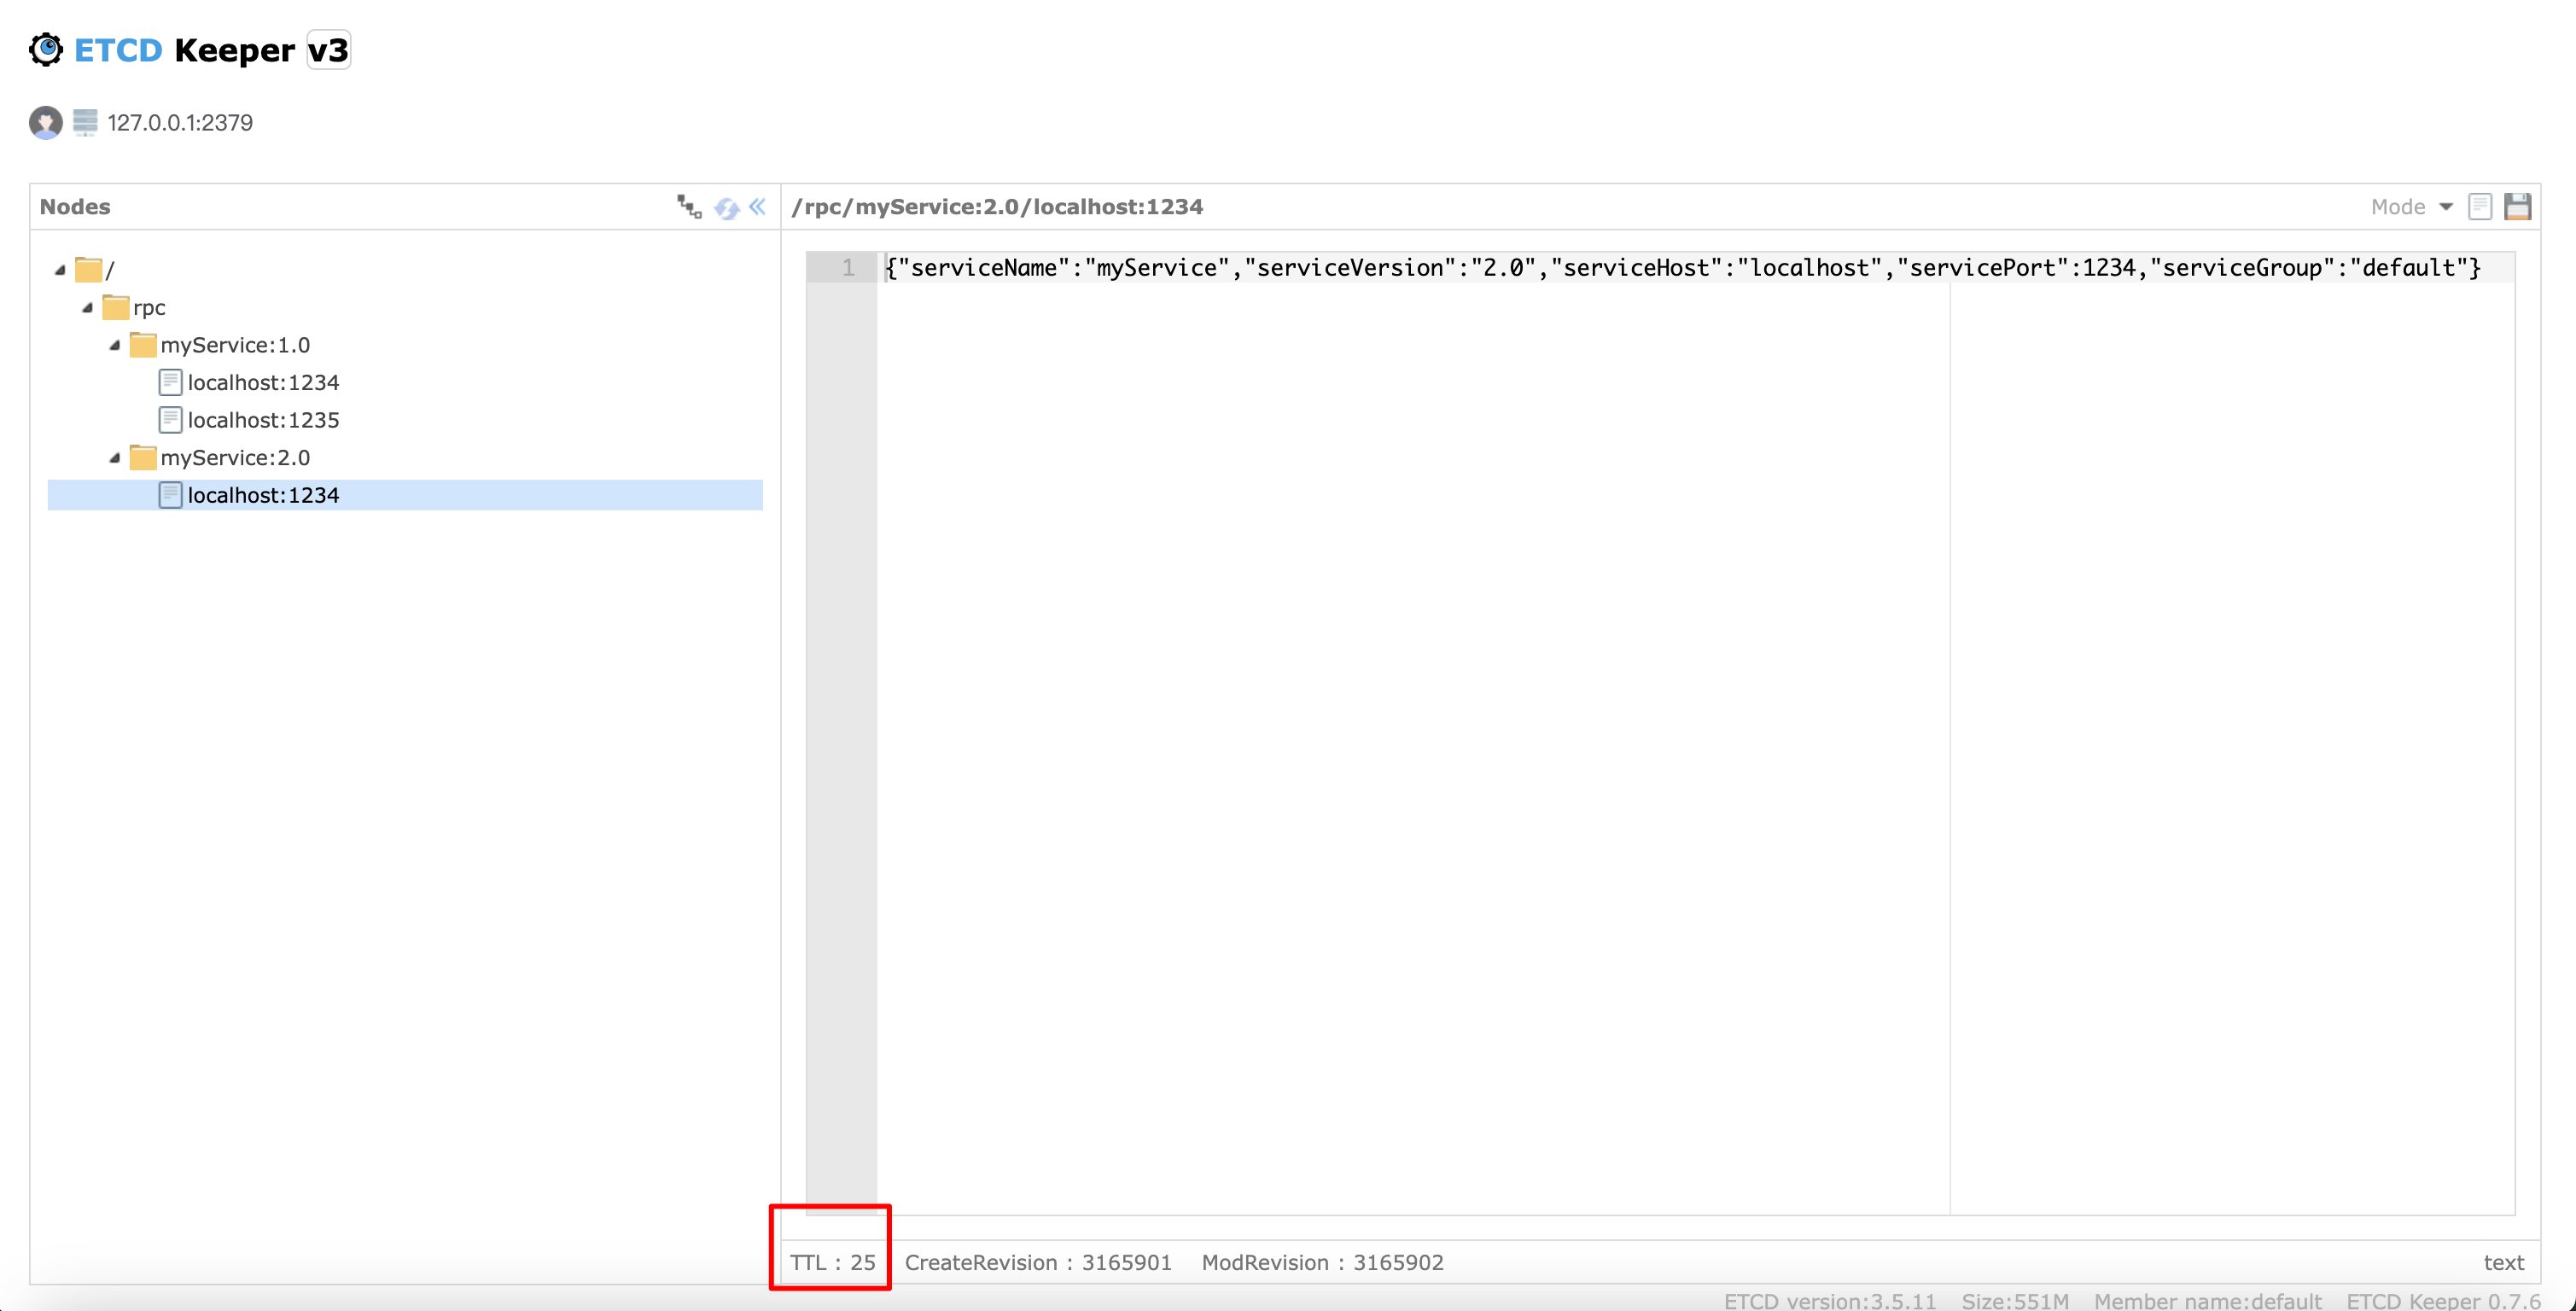
}使用可视化工具观察节点底部的过期时间,当 TTL 到 20 左右的时候,又会重置为 30,说明心跳检测和续期机制正常执行。
服务节点下线机制
当服务提供者节点宕机时,应该从注册中心移除掉已注册的节点,否则会影响消费端调用。所以我们需要设计一套服务节点下线机制。
方案设计
服务节点下线又分为:
- 主动下线:服务提供者项目正常退出时,主动从注册中心移除注册信息。
- 被动下线:服务提供者项目异常推出时,利用 Etcd 的 key 过期机制自动移除。
被动下线已经可以利用 Etcd 的机制实现了,我们主要开发主动下线。
问题是,怎么在 Java 项目正常退出时,执行某个操作呢?
其实,非常简单,利用 JVM 的 ShutdownHook 就能实现。
JVM 的 ShutdownHook 是 Java 虚拟机提供的一种机制,允许开发者在 JVM 即将关闭之前执行一些清理工作或其他必要的操作,例如关闭数据库连接、释放资源、保存临时数据等。
Spring Boot 也提供了类似的优雅停机能力。
开发实现
1)完善 Etcd 注册中心的 destroy 方法,补充下线节点的逻辑。
代码如下:
java
@Override
public void destroy() {
    log.info("当前节点下线");
    // 下线节点
    // 遍历本节点所有的 key
    for (String key : localRegisterNodeKeySet) {
        try {
            kvClient.delete(ByteSequence.from(key, StandardCharsets.UTF_8)).get();
        } catch (Exception e) {
            throw new RuntimeException(key + "节点下线失败");
        }
    }
    // 释放资源
    if (kvClient != null) {
        kvClient.close();
    }
    if (client != null) {
        client.close();
    }
}2)在 RpcApplication 的 init 方法中,注册 Shutdown Hook,当程序正常退出时会执行注册中心的 destroy 方法。
代码如下:
java
/**
 * 框架初始化,支持传入自定义配置
 *
 * @param newRpcConfig 配置
 */
public static void init(RpcConfig newRpcConfig) {
    rpcConfig = newRpcConfig;
    log.info("rpc init, config = {}", newRpcConfig);
    // 注册中心初始化
    RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
    // 根据注册中心类别获取注册中心实例
    Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());
    registry.init(registryConfig);
    log.info("registry init, config = {}", registryConfig);
    // 创建并注册 Shutdown Hook,JVM 退出时执行操作
    Runtime.getRuntime().addShutdownHook(new Thread(registry::destroy));
}测试
测试方法很简单:
- 启动服务提供者,然后观察服务是否成功被注册
- 正常停止服务提供者,然后观察服务信息是否被删除

消费端服务缓存
正常情况下,服务节点信息列表的更新频率是不高的,所以在服务消费者从注册中心获取到服务节点信息列表后,完全可以 缓存在本地,下次就不用再请求注册中心获取了,能够提高性能。
1、增加本地缓存
本地缓存的实现很简单,用一个列表来存储服务信息即可,提供操作列表的基本方法,包括:写缓存、读缓存、清空缓存。
在 registry 包下新增缓存类 RegistryServiceCache,代码如下:
java
package com.salmon.registry;

import com.salmon.model.ServiceMetaInfo;

import java.util.List;

/**
 * 注册中心服务本地缓存
 *
 * @author Salmon
 * @since 2024-05-05
 */
public class RegistryServiceCache {

    /**
     * 服务缓存
     */
    private List<ServiceMetaInfo> serviceCache;

    /**
     * 写缓存
     *
     * @param newServiceCache 新的缓存列表
     */
    void writeCache(List<ServiceMetaInfo> newServiceCache) {
        this.serviceCache = newServiceCache;
    }

    /**
     * 读缓存
     *
     * @return 缓存列表
     */
    List<ServiceMetaInfo> readCache() {
        return this.serviceCache;
    }

    /**
     * 清空缓存
     */
    void clearCache() {
        this.serviceCache = null;
    }
}2、使用本地缓存
1)修改 EtcdRegisty 的代码,使用本地缓存对象:
java
/**
 * 注册中心服务缓存
 */
private final RegistryServiceCache registryServiceCache = new RegistryServiceCache();2)修改服务发现逻辑,优先从缓存获取服务;如果没有缓存,再从注册中心获取,并且设置到缓存中。
代码如下:
java
@Override
public List<ServiceMetaInfo> serviceDiscovery(String serviceKey) {
    // 优先从缓存获取服务
    List<ServiceMetaInfo> cachedServiceMetaInfoList = registryServiceCache.readCache();
    if (!CollUtil.isEmpty(cachedServiceMetaInfoList)) {
        return cachedServiceMetaInfoList;
    }
    // 前缀搜索,结尾一定要加 '/'
    String searchPrefix = ETCD_ROOT_PATH + serviceKey + "/";
    try {
        // 前缀查询
        GetOption getOption = GetOption.builder().isPrefix(true).build();
        List<KeyValue> keyValues = kvClient.get(
                ByteSequence.from(searchPrefix, StandardCharsets.UTF_8),
                getOption
        ).get().getKvs();
        // 解析服务信息
        List<ServiceMetaInfo> serviceMetaInfoList = keyValues.stream().map(keyValue -> {
            String value = keyValue.getValue().toString(StandardCharsets.UTF_8);
            return JSONUtil.toBean(value, ServiceMetaInfo.class);
        }).collect(Collectors.toList());
        // 写入服务缓存
        registryServiceCache.writeCache(serviceMetaInfoList);
        return serviceMetaInfoList;
    } catch (Exception e) {
        throw new RuntimeException("获取服务列表失败", e);
    }
}3、服务缓存更新 - 监听机制
当服务注册信息发生变更(比如节点下线)时,需要即时更新消费端缓存。
问题是,怎么知道服务注册信息什么时候发生变更呢?
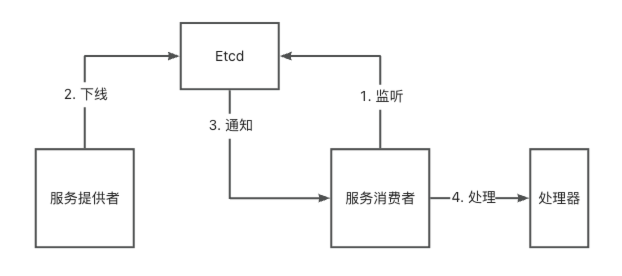
这就需要我们使用 Etcd 的 watch 监听机制,当监听的某个 key 发生修改或删除时,就会触发事件来通知监听者。
如图:
什么时候去创建 watch 监听器呢?
我们首先要明确 watch 监听是服务消费者还是服务提供者执行的。由于我们的目标是更新缓存,缓存是在服务消费端维护和使用的,所以也应该是服务消费端去 watch。
也就是说,只有服务消费者执行的方法中,可以创建 watch 监听器,那么比较合适的位置就是服务发现方法(serviceDiscovery)。可以对本次获取到的所有服务节点 key 进行监听。
还需要防止重复监听同一个 key,可以通过定义一个已监听 key 的集合来实现。
下面我们来开发编码。
1)Registry 注册中心接口补充监听 key 的方法,代码如下:
java
package com.salmon.registry;

import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;

/**
 * 注册中心
 *
 * @author Salmon
 * @since 2024-05-04
 */
public interface Registry {

    ...

    /**
     * 监听(消费端)
     *
     * @param serviceNodeKey 监听节点的key
     */
    void watch(String serviceNodeKey);
}2)EtcdRegistry 类中,新增监听 key 的集合。
可以使用 ConcurrentHashSet 防止并发冲突,代码如下:
java
/**
 * 正在监听的 key 集合
 */
private final Set<String> watchingKeySet = new ConcurrentHashSet<>();
3)在 EtcdRegistry 类中实现监听 key 的方法。
通过调用 Etcd 的 WatchClient 实现监听,如果出现了 DELETE key 删除事件,则清理服务注册缓存。
注意,即使 key 在注册中心被删除后再重新设置,之前的监听依旧生效。所以我们只监听首次加入到监听集合的 key,防止重复。
代码如下:
java
@Override
public void watch(String serviceNodeKey) {
    Watch watchClient = client.getWatchClient();
    // 之前未被监听,开启监听
    boolean newWatch = watchingKeySet.add(serviceNodeKey);
    if (newWatch) {
        watchClient.watch(
                ByteSequence.from(serviceNodeKey, StandardCharsets.UTF_8),
                response -> {
                    for (WatchEvent event : response.getEvents()) {
                        switch (event.getEventType()) {
                            // key 删除时触发
                            case DELETE:
                                // 清理注册服务缓存
                                registryServiceCache.clearCache();
                                break;
                            case PUT:
                            default:
                                break;
                        }
                    }
                }
        );
    }
}4)在消费端获取服务时调用 watch 方法,对获取到的服务节点 key 进行监听。
修改服务发现方法的代码如下:
java
@Override
public List<ServiceMetaInfo> serviceDiscovery(String serviceKey) {
    // 优先从缓存获取服务
    List<ServiceMetaInfo> cachedServiceMetaInfoList = registryServiceCache.readCache();
    if (!CollUtil.isEmpty(cachedServiceMetaInfoList)) {
        return cachedServiceMetaInfoList;
    }
    // 前缀搜索,结尾一定要加 '/'
    String searchPrefix = ETCD_ROOT_PATH + serviceKey + "/";
    try {
        // 前缀查询
        GetOption getOption = GetOption.builder().isPrefix(true).build();
        List<KeyValue> keyValues = kvClient.get(
                ByteSequence.from(searchPrefix, StandardCharsets.UTF_8),
                getOption
        ).get().getKvs();
        // 解析服务信息
        List<ServiceMetaInfo> serviceMetaInfoList = keyValues.stream().map(keyValue -> {
            String key = keyValue.getKey().toString(StandardCharsets.UTF_8);
            // 监听 key 的变化
            watch(key);
            String value = keyValue.getValue().toString(StandardCharsets.UTF_8);
            return JSONUtil.toBean(value, ServiceMetaInfo.class);
        }).collect(Collectors.toList());
        // 写入服务缓存
        registryServiceCache.writeCache(serviceMetaInfoList);
        return serviceMetaInfoList;
    } catch (Exception e) {
        throw new RuntimeException("获取服务列表失败", e);
    }
}5)测试。
可以使用如下步骤,通过 debug 进行测试:
- 先启动服务提供者
- 修改服务消费者项目,连续调用服务 3 次,通过 debug 可以发现,第一次查注册中心、第二次查询缓存。
- 在第三次要调用服务时,下线服务提供者,可以在注册中心看到节点的注册 key 已被删除。
- 继续向下执行,发现第三次调用服务时,又重新从注册中心查询,说明缓存已经被更新。
至此,消费端服务缓存功能已经完成。
ZooKeeper 注册中心实现
这部分不作为学习重点,理解了一种注册中心的实现方式,再用其他技术实现注册中心就很简单了。
其实和 Etcd 注册中心的实现方式极其相似,步骤如下:
- 安装 ZooKeeper
- 引入客户端依赖
- 实现接口
- SPI 补充 ZooKeeper 注册中心
1)本地下载并启动 ZooKeeper,教程使用的版本是 3.8.4,大家最好跟教程保持一致。
下载链接:https://dlcdn.apache.org/zookeeper/zookeeper-3.8.4/apache-zookeeper-3.8.4-bin.tar.gz
如果发现该版本不存在,换一个最接近的版本即可。
正常启动 ZooKeeper 后,默认会占用几个端口号,比如 2181(客户端)、8080(管理端)等。
2)引入客户端依赖。
一般我们会使用 Apache Curator 来操作 ZooKeeper,可以参考官方文档:https://curator.apache.org/docs/getting-started
引入的依赖代码如下:
xml
<!-- zookeeper -->
<dependency>
    <groupId>org.apache.curator</groupId>
    <artifactId>curator-x-discovery</artifactId>
    <version>5.6.0</version>
</dependency>
3)ZooKeeper 注册中心实现,这里不再赘述:
java
package com.salmon.registry;

import cn.hutool.core.collection.ConcurrentHashSet;
import com.salmon.config.RegistryConfig;
import com.salmon.model.ServiceMetaInfo;
import lombok.extern.slf4j.Slf4j;
import org.apache.curator.framework.CuratorFramework;
import org.apache.curator.framework.CuratorFrameworkFactory;
import org.apache.curator.framework.recipes.cache.CuratorCache;
import org.apache.curator.framework.recipes.cache.CuratorCacheListener;
import org.apache.curator.retry.ExponentialBackoffRetry;
import org.apache.curator.x.discovery.ServiceDiscovery;
import org.apache.curator.x.discovery.ServiceDiscoveryBuilder;
import org.apache.curator.x.discovery.ServiceInstance;
import org.apache.curator.x.discovery.details.JsonInstanceSerializer;

import java.util.Collection;
import java.util.HashSet;
import java.util.List;
import java.util.Set;
import java.util.stream.Collectors;

/**
 * zookeeper 注册中心
 *
 * @author Salmon
 * @since 2024-05-05
 */
@Slf4j
public class ZooKeeperRegistry implements Registry {

    private CuratorFramework client;

    private ServiceDiscovery<ServiceMetaInfo> serviceDiscovery;

    /**
     * 本机注册的节点 key 集合(用于维护续期)
     */
    private final Set<String> localRegisterNodeKeySet = new HashSet<>();

    /**
     * 注册中心服务缓存
     */
    private final RegistryServiceCache registryServiceCache = new RegistryServiceCache();

    /**
     * 正在监听的 key 集合
     */
    private final Set<String> watchingKeySet = new ConcurrentHashSet<>();

    /**
     * 根节点
     */
    private static final String ZK_ROOT_PATH = "/rpc/zk";

    @Override
    public void init(RegistryConfig registryConfig) {
        // 构建 client 实例
        client = CuratorFrameworkFactory.builder()
                .connectString(registryConfig.getAddress())
                // 重新策略
                .retryPolicy(new ExponentialBackoffRetry(
                        Math.toIntExact(registryConfig.getTimeout()),
                        3))
                .build();
        // 构建 serviceDiscovery 实例
        serviceDiscovery = ServiceDiscoveryBuilder.builder(ServiceMetaInfo.class)
                .client(client)
                .basePath(ZK_ROOT_PATH)
                .serializer(new JsonInstanceSerializer<>(ServiceMetaInfo.class))
                .build();
        try {
            // 启动 client 和 serviceDiscovery
            client.start();
            serviceDiscovery.start();
        } catch (Exception e) {
            throw new RuntimeException(e);
        }
    }

    @Override
    public void register(ServiceMetaInfo serviceMetaInfo) throws Exception {
        // 注册到 zk 里
        serviceDiscovery.registerService(buildServiceInstance(serviceMetaInfo));
        // 添加节点信息到本地缓存
        String registerKey = ZK_ROOT_PATH + "/" + serviceMetaInfo.getServiceNodeKey();
        localRegisterNodeKeySet.add(registerKey);
    }

    @Override
    public void unRegister(ServiceMetaInfo serviceMetaInfo) {
        try {
            serviceDiscovery.unregisterService(buildServiceInstance(serviceMetaInfo));
        } catch (Exception e) {
            throw new RuntimeException(e);
        }
        // 从本地缓存移除
        String registerKey = ZK_ROOT_PATH + "/" + serviceMetaInfo.getServiceNodeKey();
        localRegisterNodeKeySet.remove(registerKey);
    }

    @Override
    public List<ServiceMetaInfo> serviceDiscovery(String serviceKey) {
        // 优先从缓存获取服务
        List<ServiceMetaInfo> cachedServiceMetaInfoList = registryServiceCache.readCache();
        if (cachedServiceMetaInfoList != null) {
            return cachedServiceMetaInfoList;
        }

        try {
            // 查询服务信息
            Collection<ServiceInstance<ServiceMetaInfo>> serviceInstanceList = serviceDiscovery.queryForInstances(serviceKey);

            // 解析服务信息
            List<ServiceMetaInfo> serviceMetaInfoList = serviceInstanceList.stream()
                    .map(ServiceInstance::getPayload)
                    .collect(Collectors.toList());

            // 写入服务缓存
            registryServiceCache.writeCache(serviceMetaInfoList);
            return serviceMetaInfoList;
        } catch (Exception e) {
            throw new RuntimeException("获取服务列表失败", e);
        }
    }

    @Override
    public void destroy() {
        log.info("当前节点下线");
        // 下线节点(这一步可以不做,因为都是临时节点,服务下线,自然就被删掉了)
        for (String key : localRegisterNodeKeySet) {
            try {
                client.delete().guaranteed().forPath(key);
            } catch (Exception e) {
                throw new RuntimeException(key + "节点下线失败");
            }
        }

        // 释放资源
        if (client != null) {
            client.close();
        }
    }

    @Override
    public void heartBeat() {
        // 不需要心跳机制,建立了临时节点,如果服务器故障,则临时节点直接丢失
    }

    @Override
    public void watch(String serviceNodeKey) {
        String watchKey = ZK_ROOT_PATH + "/" + serviceNodeKey;
        boolean newWatch = watchingKeySet.add(watchKey);
        if (newWatch) {
            CuratorCache curatorCache = CuratorCache.build(client, watchKey);
            curatorCache.start();
            // 创建监听器
            curatorCache.listenable().addListener(
                    CuratorCacheListener
                            .builder()
                            // 删除了的节点
                            .forDeletes(childData -> registryServiceCache.clearCache())
                            // 发生变化的节点
                            .forChanges(((oldNode, node) -> registryServiceCache.clearCache()))
                            .build()
            );
        }
    }

    /**
     * 构建zk服务实例
     *
     * @param serviceMetaInfo 服务信息
     * @return 服务实例
     */
    private ServiceInstance<ServiceMetaInfo> buildServiceInstance(ServiceMetaInfo serviceMetaInfo) {
        String serviceAddress = serviceMetaInfo.getServiceHost() + ":" + serviceMetaInfo.getServicePort();
        try {
            return ServiceInstance
                    .<ServiceMetaInfo>builder()
                    .id(serviceAddress)
                    .name(serviceMetaInfo.getServiceKey())
                    .address(serviceAddress)
                    .payload(serviceMetaInfo)
                    .build();
        } catch (Exception e) {
            throw new RuntimeException(e);
        }
    }
}4)SPI 增加对 ZooKeeper 的支持:
properties
etcd=com.salmon.registry.EtcdRegistry
zookeeper=com.salmon.registry.ZooKeeperRegistry
如图:
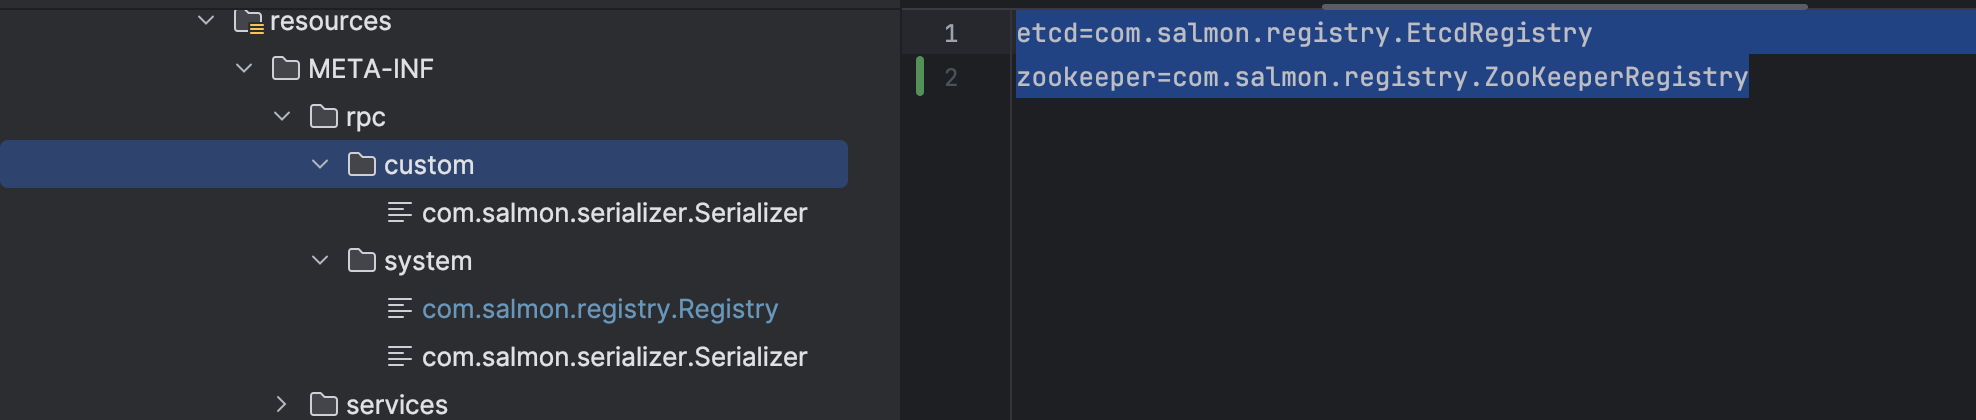
5)最后,可以更改服务提供者和消费者的注册中心配置来测试。
更改的配置如下:
properties
rpc.registryConfig.registry=zookeeper
rpc.registryConfig.address=localhost:2181
三、扩展
1)完善服务注册信息。
参考思路:比如增加节点注册时间。
2)实现更多注册中心。(较难)
参考思路:使用 Redis 实现注册中心。
3)保证注册中心的高可用。
参考思路:了解 Etcd 的集群机制。
4)服务注册信息失效的兜底策略。(较难)
参考思路:如果消费端调用节点时发现节点失效,也可以考虑是否需要从注册中心更新服务注册信息、或者强制更新本地缓存。
5)注册中心 key 监听时,采用观察者模式实现处理。
参考思路:可以定义一个 Listener 接口,根据 watch key 的变更类型去调用 Listener 的不同方法。
自定义协议
一、需求分析
目前的 RPC 框架,我们使用 Vert.x 的 HttpServer 作为服务提供者的服务器,代码实现比较简单,其底层网络传输使用的是 HTTP 协议。
很多同学会把 HTTP 和 RPC 理解为同一类技术,但 HTTP 只是 RPC 框架网络传输的一种可选方式罢了。
问题来了,使用 HTTP 协议会有什么问题么?或者说,有没有更好的选择?
一般情况下,RPC 框架会比较注重性能,而 HTTP 协议中的头部信息、请求响应格式较 “重”,会影响网络传输性能。
举个例子,利用浏览器网络控制台随便查看一个请求,能看到大量的请求和响应标头:
所以,我们需要自己自定义一套 RPC 协议,比如利用 TCP 等传输层协议、自己定义请求响应结构,来实现性能更高、更灵活、更安全的 RPC 框架。
二、设计方案
自定义 RPC 协议可以分为 2 大核心部分:
- 自定义网络传输
- 自定义消息结构
1、网络传输设计
网络传输设计的目标是:选择一个能够高性能通信的网络协议和传输方式。
需求分析中已经提到了,HTTP 协议的头信息是比较大的,会影响传输性能。但其实除了这点外,HTTP 本身属于无状态协议,这意味着每个 HTTP 请求都是独立的,每次请求 / 响应都要重新建立和关闭连接,也会影响性能。
考虑到这点,在 HTTP/1.1 中引入了持久连接(Keep-Alive),允许在单个 TCP 连接上发送多个 HTTP 请求和响应,避免了每次请求都要重新建立和关闭连接的开销。
虽然如此,HTTP 本身是应用层协议,我们现在设计的 RPC 协议也是应用层协议,性能肯定是不如底层(传输层)的 TCP 协议要高的。所以我们想要追求更高的性能,还是选择使用 TCP 协议完成网络传输,有更多的自主设计空间。
2、消息结构设计
消息结构设计的目标是:用 最少的 空间传递 需要的 信息。
1)如何使用最少的空间呢?
大家之前接触到的数据类型可能都是整型、长整型、浮点数类型等等,这些类型其实都比较 “重”,占用的字节数较多。比如整型要占用 4 个字节、32 个 bit 位。
我们在自定义消息结构时,想要节省空间,就要尽可能使用更轻量的类型,比如 byte 字节类型,只占用 1 个字节、8 个 bit 位。
需要注意的是,Java 中实现 bit 位运算拼接相对比较麻烦,所以权衡开发成本,我们设计消息结构时,尽量给每个数据凑到整个字节。
2)消息内需要哪些信息呢?
目标肯定是能够完成请求嘛,那我们何不从之前的 HTTP 请求方式中,找到一些线索?
分析 HTTP 请求结构,我们能够得到 RPC 消息所需的信息:
- 魔数:作用是安全校验,防止服务器处理了非框架发来的乱七八糟的消息(类似 HTTPS 的安全证书)
- 版本号:保证请求和响应的一致性(类似 HTTP 协议有 1.0/2.0 等版本)
- 序列化方式:来告诉服务端和客户端如何解析数据(类似 HTTP 的 Content-Type 内容类型)
- 类型:标识是请求还是响应?或者是心跳检测等其他用途。(类似 HTTP 有请求头和响应头)
- 状态:如果是响应,记录响应的结果(类似 HTTP 的 200 状态代码)
此外,还需要有请求 id,唯一标识某个请求,因为 TCP 是双向通信的,需要有个唯一标识来追踪每个请求。
最后,也是最重要的,要发送 body 内容数据。我们暂时称它为 请求体,类似于我们之前 HTTP 请求中发送的 RpcRequest。
如果是 HTTP 这种协议,有专门的 key / value 结构,很容易找到完整的 body 数据。但基于 TCP 协议,想要获取到完整的 body 内容数据,就需要一些 “小心思” 了,因为 TCP 协议本身会存在半包和粘包问题,每次传输的数据可能是不完整的,具体的后面会讲。
所以我们需要在消息头中新增一个字段 请求体数据长度,保证能够完整地获取 body 内容信息。
基于以上的思考,我们可以得到最终的消息结构设计,如下图:
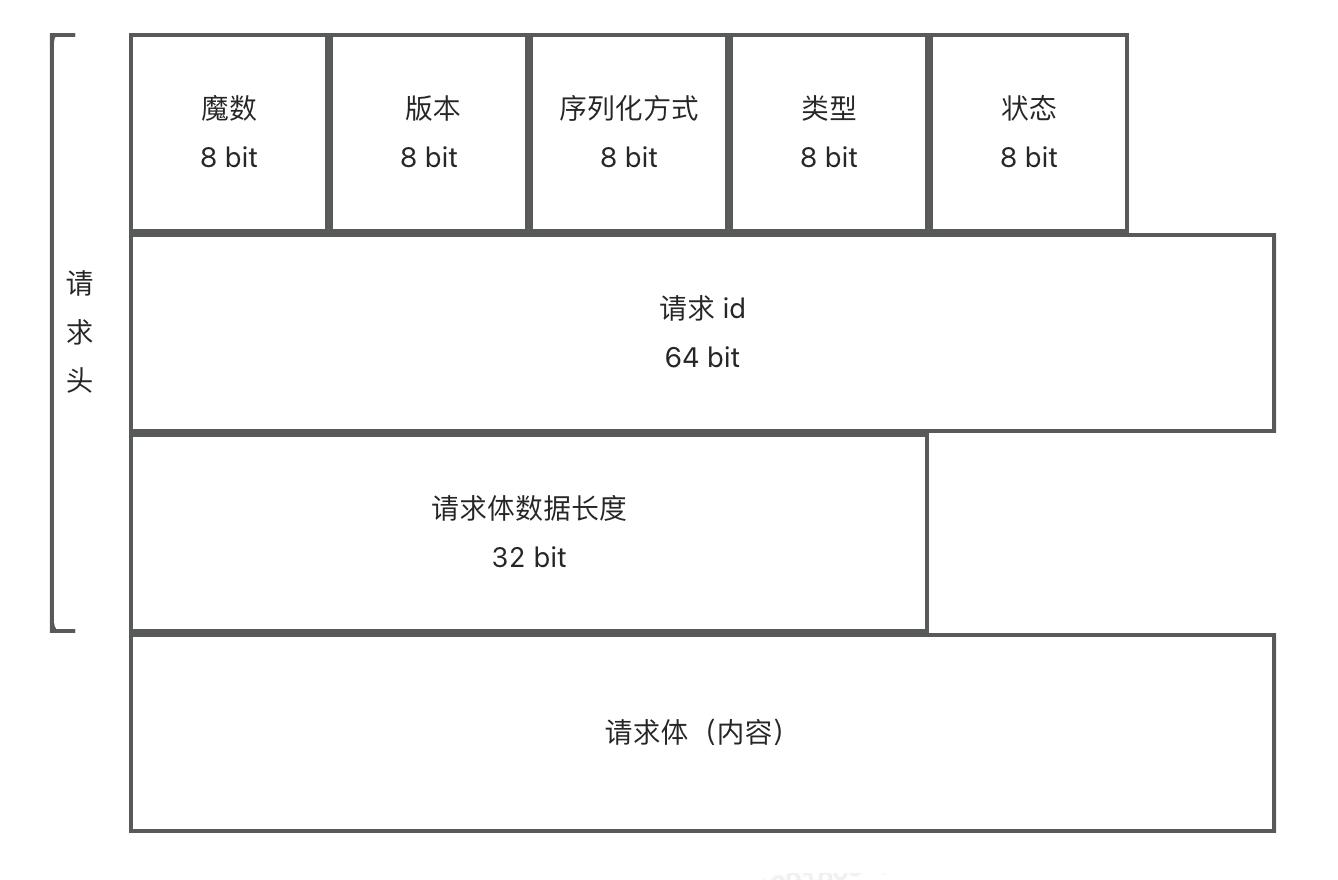
实际上,这些数据应该是紧凑的,请求头信息总长 17 个字节。也就是说,上述消息结构,本质上就是拼接在一起的一个字节数组。我们后续实现时,需要有 消息编码器 和 消息解码器,编码器先 new 一个空的 Buffer 缓冲区,然后按照顺序向缓冲区依次写入这些数据;解码器在读取时也按照顺序依次读取,就能还原出编码前的数据。
通过这种约定的方式,我们就不用记录头信息了。比如 magic 魔数,不用存储 “magic” 这个字符串,而是读取第一个字节(前 8 bit)就能获取到。
如果你学过 Redis 底层,会发现很多数据结构都是这种设计。
如果大家是第一次设计协议,或者经验不足,强烈建议大家先去学一下优秀开源框架的协议设计,这样不会说毫无头绪。
比如这里我参考了 Dubbo 的协议设计,如下图:
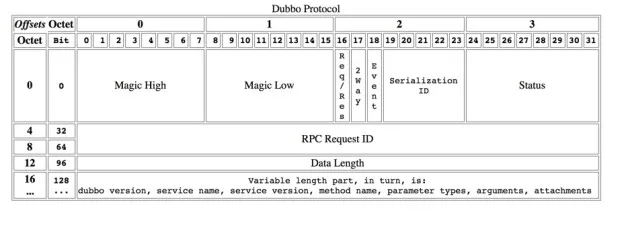
明确了设计后,我们来开发实现,就比较简单了。
三、开发实现
1、消息结构
新建 protocol 包,将所有和自定义协议有关的代码都放到该包下。
1)新建协议消息类 ProtocolMessage。
将消息头单独封装为一个内部类,消息体可以使用泛型类型,完整代码如下:
java
package com.salmon.protocol;

import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;

/**
 * 协议消息结构
 *
 * @author Salmon
 * @since 2024-05-07
 */
@Data
@AllArgsConstructor
@NoArgsConstructor
public class ProtocolMessage<T> {

    /**
     * 消息头
     */
    private Header header;

    /**
     * 消息体(请求或响应对象)
     */
    private T body;

    /**
     * 协议消息头
     */
    @Data
    public static class Header {
        /**
         * 魔数,保证安全性
         */
        private byte magic;

        /**
         * 版本号
         */
        private byte version;

        /**
         * 序列化器
         */
        private byte serializer;

        /**
         * 消息类型(请求 / 响应)
         */
        private byte type;

        /**
         * 状态
         */
        private byte status;

        /**
         * 请求 id
         */
        private long requestId;

        /**
         * 消息体长度
         */
        private int bodyLength;
    }
}2)新建协议常量类 ProtocolConstant。
记录了和自定义协议有关的关键信息,比如消息头长度、魔数、版本号。
完整代码如下:
java
package com.salmon.protocol;

/**
 * 协议常量
 *
 * @author Salmon
 * @since 2024-05-07
 */
public interface ProtocolConstant {

    /**
     * 消息头长度
     */
    int MESSAGE_HEADER_LENGTH = 17;

    /**
     * 协议魔数
     */
    byte PROTOCOL_MAGIC = 0x1;

    /**
     * 协议版本号
     */
    byte PROTOCOL_VERSION = 0x1;
}3)新建消息字段的枚举类,比如:
协议状态枚举,暂时只定义成功、请求失败、响应失败三种枚举值:
java
package com.salmon.protocol;

import lombok.Getter;

/**
 * 协议消息的状态枚举
 *
 * @author Salmon
 * @since 2024-05-07
 */
@Getter
public enum ProtocolMessageStatusEnum {

    OK("ok", 20),
    BAD_REQUEST("badRequest", 40),
    BAD_RESPONSE("badResponse", 50);

    private final String text;

    private final int value;

    ProtocolMessageStatusEnum(String text, int value) {
        this.text = text;
        this.value = value;
    }

    /**
     * 根据 value 获取枚举
     *
     * @param value 枚举值
     * @return 枚举
     */
    public static ProtocolMessageStatusEnum getEnumByValue(int value) {
        for (ProtocolMessageStatusEnum anEnum : ProtocolMessageStatusEnum.values()) {
            if (anEnum.value == value) {
                return anEnum;
            }
        }
        return null;
    }
}协议消息类型枚举,包括请求、响应、心跳、其它。代码如下:
java
package com.salmon.protocol;

import lombok.Getter;

/**
 * 协议消息的类型枚举
 *
 * @author Salmon
 * @since 2024-05-07
 */
@Getter
public enum ProtocolMessageTypeEnum {

    /**
     * 请求
     */
    REQUEST(0),
    /**
     * 响应
     */
    RESPONSE(1),
    /**
     * 心跳
     */
    HEART_BEAT(2),
    /**
     * 其它
     */
    OTHERS(3);

    private final int key;

    ProtocolMessageTypeEnum(int key) {
        this.key = key;
    }

    /**
     * 根据 key 获取枚举
     *
     * @param key 键
     * @return 枚举
     */
    public static ProtocolMessageTypeEnum getEnumByKey(int key) {
        for (ProtocolMessageTypeEnum anEnum : ProtocolMessageTypeEnum.values()) {
            if (anEnum.key == key) {
                return anEnum;
            }
        }
        return null;
    }
}协议消息的序列化器枚举,跟我们 RPC 框架已支持的序列化器对应。代码如下:
java
package com.salmon.protocol;

import cn.hutool.core.util.ObjectUtil;
import lombok.Getter;

import java.util.Arrays;
import java.util.List;
import java.util.stream.Collectors;

/**
 * 协议消息的序列化器枚举
 *
 * @author Salmon
 * @since 2024-05-07
 */
@Getter
public enum ProtocolMessageSerializerEnum {

    /**
     * jdk 序列化
     */
    JDK(0, "jdk"),
    /**
     * json 序列化
     */
    JSON(1, "json"),
    /**
     * kryo 协议
     */
    KRYO(2, "kryo"),
    /**
     * hessian 协议
     */
    HESSIAN(3, "hessian");

    private final int key;

    private final String value;

    ProtocolMessageSerializerEnum(int key, String value) {
        this.key = key;
        this.value = value;
    }

    /**
     * 获取值列表
     *
     * @return 值列表
     */
    public static List<String> getValues() {
        return Arrays.stream(values()).map(item -> item.value).collect(Collectors.toList());
    }

    /**
     * 根据 key 获取枚举
     *
     * @param key 枚举键
     * @return 枚举
     */
    public static ProtocolMessageSerializerEnum getEnumByKey(int key) {
        for (ProtocolMessageSerializerEnum anEnum : ProtocolMessageSerializerEnum.values()) {
            if (anEnum.key == key) {
                return anEnum;
            }
        }
        return null;
    }


    /**
     * 根据 value 获取枚举
     *
     * @param value 枚举值
     * @return 枚举
     */
    public static ProtocolMessageSerializerEnum getEnumByValue(String value) {
        if (ObjectUtil.isEmpty(value)) {
            return null;
        }
        for (ProtocolMessageSerializerEnum anEnum : ProtocolMessageSerializerEnum.values()) {
            if (anEnum.value.equals(value)) {
                return anEnum;
            }
        }
        return null;
    }
}2、网络传输
我们的 RPC 框架使用了高性能的 Vert.x 作为网络传输服务器,之前用的是 HttpServer。同样,Vert.x 也支持 TCP 服务器,相比于 Netty 或者自己写 Socket 代码,更加简单易用。
首先新建 server.tcp 包,将所有 TCP 服务相关的代码放到该包中。
1)TCP 服务器实现。
新建 VertxTcpServer 类,跟之前写的 VertxHttpServer 类似,先创建 Vert.x 的服务器实例,然后定义处理请求的方法,比如回复 “Hello, client!”,最后启动服务器。
示例代码如下:
java
package com.salmon.server.tcp;

import com.salmon.server.HttpServer;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetServer;

/**
 * 基于 Vert.x 的TCP服务器实现
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpServer implements HttpServer {

    public static void main(String[] args) {
        new VertxTcpServer().doStart(8888);
    }

    @Override
    public void doStart(int port) {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 服务器
        NetServer server = vertx.createNetServer();

        // 处理请求
        server.connectHandler(socket -> {
            socket.handler(buffer -> {
                // 处理接收到的字节数组
                byte[] requestData = buffer.getBytes();
                // 在这里进行自定义的字节数组处理逻辑,比如解析请求、调用服务、构造响应等
                byte[] responseData = handleRequest(requestData);
                // 发送响应
                socket.write(Buffer.buffer(responseData));
            });
        });

        // 启动 TCP 服务器并监听指定端口
        server.listen(port, result -> {
            if (result.succeeded()) {
                System.out.println("TCP server started on port " + port);
            } else {
                System.err.println("Failed to start TCP server: " + result.cause());
            }
        });
    }


    private byte[] handleRequest(byte[] requestData) {
        // 在这里编写处理请求的逻辑,根据 requestData 构造响应数据并返回
	System.out.println("Received response from client: " + Buffer.buffer(requestData));
        // 这里只是一个示例,实际逻辑需要根据具体的业务需求来实现
        return "Hello, client!".getBytes();
    }

}上述代码中的 socket.write 方法,就是在向连接到服务器的客户端发送数据。注意发送的数据格式为 Buffer,这是 Vert.x 为我们提供的字节数组缓冲区实现。
2)TCP 客户端实现。
新建 VertxTcpClient 类,先创建 Vert.x 的客户端实例,然后定义处理请求的方法,比如回复 “Hello, server!”,并建立连接。
示例代码如下:
java
package com.salmon.server.tcp;

import io.vertx.core.Vertx;
import io.vertx.core.net.NetClient;

/**
 * 基于 Vert.x 的TCP客户端
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpClient {

    public static void main(String[] args) {
        new VertxTcpClient().start();
    }

    public void start() {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 客户端
        NetClient netClient = vertx.createNetClient();

        // 连接服务器
        netClient.connect(8888, "localhost", result -> {
            if (result.succeeded()) {
                System.out.println("Connected to TCP server");
                io.vertx.core.net.NetSocket socket = result.result();
                // 发送数据
                socket.write("Hello, server!");
                // 接收响应
                socket.handler(buffer -> {
                    System.out.println("Received response from server: " + buffer.toString());
                });
            } else {
                System.err.println("Failed to connect to TCP server");
            }
        });
    }
}3)可以先进行简单的测试,先启动服务器,再启动客户端,能够在控制台看到它们互相打招呼的输出。
3、编码 / 解码器
在上一步中,我们也注意到了,Vert.x 的 TCP 服务器收发的消息是 Buffer 类型,不能直接写入一个对象。因此,我们需要编码器和解码器,将 Java 的消息对象和 Buffer 进行相互转换。
我这里只用一张图,通过其演示整个请求和响应的过程,相信就能带大家了解编码器和解码器的作用。
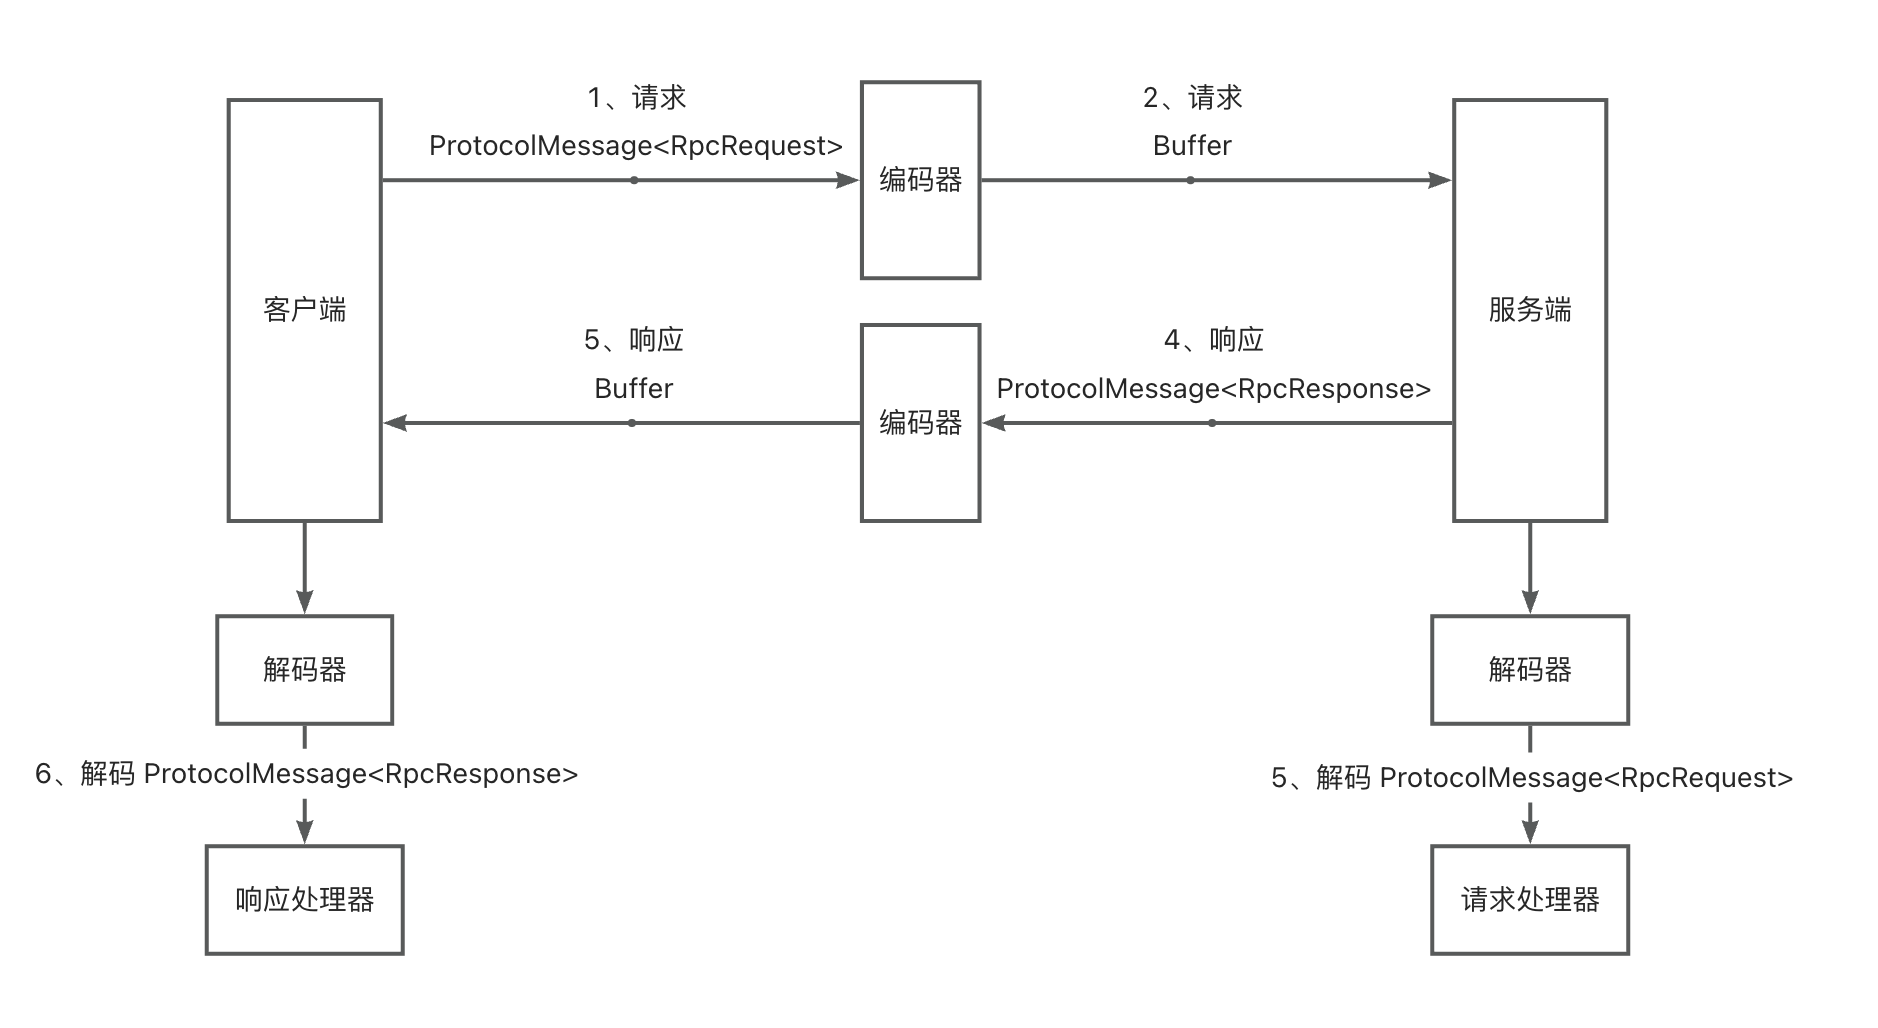
之前 HTTP 请求和响应时,直接从请求 body 处理器中获取到 body 字节数组,再通过序列化(反序列化)得到 RpcRequest 或 RpcResponse 对象。使用 TCP 服务器后,只不过改为从 Buffer 中获取字节数组,然后编解码为 RpcRequest 或 RpcResponse 对象。其他的后续处理流程都是可复用的。
1)首先实现消息编码器。
在 protocol 包下新建 ProtocolMessageEncoder,核心流程是依次向 Buffer 缓冲区写入消息对象里的字段。
代码如下:
java
package com.salmon.protocol;

import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import io.vertx.core.buffer.Buffer;

import java.io.IOException;

/**
 * 协议消息编码器
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class ProtocolMessageEncoder {

    /**
     * 编码
     *
     * @param protocolMessage 自定义消息
     * @return buffer
     * @throws IOException IO异常
     */
    public static Buffer encode(ProtocolMessage<?> protocolMessage) throws IOException {
        if (protocolMessage == null || protocolMessage.getHeader() == null) {
            return Buffer.buffer();
        }
        ProtocolMessage.Header header = protocolMessage.getHeader();
        // 依次向缓冲区写入字节
        Buffer buffer = Buffer.buffer();
        buffer.appendByte(header.getMagic());
        buffer.appendByte(header.getVersion());
        buffer.appendByte(header.getSerializer());
        buffer.appendByte(header.getType());
        buffer.appendByte(header.getStatus());
        buffer.appendLong(header.getRequestId());
        // 获取序列化器
        ProtocolMessageSerializerEnum serializerEnum = ProtocolMessageSerializerEnum.getEnumByKey(header.getSerializer());
        if (serializerEnum == null) {
            throw new RuntimeException("序列化协议不存在");
        }
        Serializer serializer = SerializerFactory.getInstance(serializerEnum.getValue());
        byte[] bodyBytes = serializer.serialize(protocolMessage.getBody());
        // 写入 body 长度和数据
        buffer.appendInt(bodyBytes.length);
        buffer.appendBytes(bodyBytes);
        return buffer;
    }
}2)实现消息解码器。
在 protocol 包下新建 ProtocolMessageDecoder,核心流程是依次从 Buffer 缓冲区的指定位置读取字段,构造出完整的消息对象。
代码如下:
java
package com.salmon.protocol;

import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import io.vertx.core.buffer.Buffer;

import java.io.IOException;

/**
 * 协议消息解码器
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class ProtocolMessageDecoder {

    /**
     * 解码
     *
     * @param buffer 待解析数据
     * @return 消息
     * @throws IOException IO异常
     */
    public static ProtocolMessage<?> decode(Buffer buffer) throws IOException {
        ProtocolMessage.Header header = new ProtocolMessage.Header();
        byte magic = buffer.getByte(0);
        // 校验魔数
        if (magic != ProtocolConstant.PROTOCOL_MAGIC) {
            throw new RuntimeException("消息 magic 非法");
        }
        header.setMagic(magic);
        header.setVersion(buffer.getByte(1));
        header.setSerializer(buffer.getByte(2));
        header.setType(buffer.getByte(3));
        header.setStatus(buffer.getByte(4));
        header.setRequestId(buffer.getLong(5));
        // todo ?
        header.setBodyLength(buffer.getInt(13));
        // 解决粘包问题,只读指定长度的数据
        byte[] bodyBytes = buffer.getBytes(17, 17 + header.getBodyLength());
        // 解析消息体
        ProtocolMessageSerializerEnum serializerEnum = ProtocolMessageSerializerEnum.getEnumByKey(header.getSerializer());
        if (serializerEnum == null) {
            throw new RuntimeException("序列化消息的协议不存在");
        }
        Serializer serializer = SerializerFactory.getInstance(serializerEnum.getValue());
        ProtocolMessageTypeEnum messageTypeEnum = ProtocolMessageTypeEnum.getEnumByKey(header.getType());
        if (messageTypeEnum == null) {
            throw new RuntimeException("序列化消息的类型不存在");
        }
        switch (messageTypeEnum) {
            case REQUEST:
                RpcRequest request = serializer.deserialize(bodyBytes, RpcRequest.class);
                return new ProtocolMessage<>(header, request);
            case RESPONSE:
                RpcResponse response = serializer.deserialize(bodyBytes, RpcResponse.class);
                return new ProtocolMessage<>(header, response);
            case HEART_BEAT:
            case OTHERS:
            default:
                throw new RuntimeException("暂不支持该消息类型");
        }
    }
}3)编写单元测试类,先编码再解码,以测试编码器和解码器的正确性。
代码如下:
java
import cn.hutool.core.util.IdUtil;
import com.salmon.constant.RpcConstant;
import com.salmon.model.RpcRequest;
import com.salmon.protocol.*;
import io.vertx.core.buffer.Buffer;
import org.junit.Assert;
import org.junit.Test;

import java.io.IOException;

/**
 * @author Salmon
 * @since 2024-05-07
 */
public class ProtocolMessageTest {
    @Test
    public void testEncodeAndDecode() throws IOException {
        // 构造消息
        ProtocolMessage<RpcRequest> protocolMessage = new ProtocolMessage<>();
        ProtocolMessage.Header header = new ProtocolMessage.Header();
        header.setMagic(ProtocolConstant.PROTOCOL_MAGIC);
        header.setVersion(ProtocolConstant.PROTOCOL_VERSION);
        header.setSerializer((byte) ProtocolMessageSerializerEnum.JDK.getKey());
        header.setType((byte) ProtocolMessageTypeEnum.REQUEST.getKey());
        header.setStatus((byte) ProtocolMessageStatusEnum.OK.getValue());
        // 基于雪花算法生成请求id
        header.setRequestId(IdUtil.getSnowflakeNextId());
        header.setBodyLength(0);
        RpcRequest rpcRequest = new RpcRequest();
        rpcRequest.setServiceName("myService");
        rpcRequest.setMethodName("myMethod");
        rpcRequest.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
        rpcRequest.setParameterTypes(new Class[]{String.class});
        rpcRequest.setArgs(new Object[]{"aaa", "bbb"});
        protocolMessage.setHeader(header);
        protocolMessage.setBody(rpcRequest);
        // 编码消息
        Buffer encodeBuffer = ProtocolMessageEncoder.encode(protocolMessage);
        // 解码消息
        ProtocolMessage<?> message = ProtocolMessageDecoder.decode(encodeBuffer);
        Assert.assertNotNull(message);
    }

}
4、请求处理器(服务提供者)
可以使用 netty 的 pipeline 组合多个 handler(比如编码 => 解码 => 请求 / 响应处理)
请求处理器的作用是接受请求,然后通过反射调用服务实现类。
类似之前的 HttpServerHandler,我们需要开发一个 TcpServerHandler,用于处理请求。和 HttpServerHandler 的区别只是在获取请求、写入响应的方式上,需要调用上面开发好的编码器和解码器。
通过实现 Vert.x 提供的 Handler<NetSocket> 接口,可以定义 TCP 请求处理器。
完整代码如下,大多数代码都是从之前写好的 HttpServerHandler 复制来的:
java
package com.salmon.server.handler;

import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.protocol.ProtocolMessage;
import com.salmon.protocol.ProtocolMessageDecoder;
import com.salmon.protocol.ProtocolMessageEncoder;
import com.salmon.protocol.ProtocolMessageTypeEnum;
import com.salmon.registry.LocalRegistry;
import io.vertx.core.Handler;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetSocket;

import java.io.IOException;
import java.lang.reflect.Method;

/**
 * TCP 请求处理
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class TcpServerHandler implements Handler<NetSocket> {

    @Override
    public void handle(NetSocket netSocket) {
        // 处理连接
        netSocket.handler(buffer -> {
            // 接收请求,解码
            ProtocolMessage<RpcRequest> protocolMessage;
            try {
                protocolMessage = (ProtocolMessage<RpcRequest>) ProtocolMessageDecoder.decode(buffer);
            } catch (IOException e) {
                throw new RuntimeException("协议消息解码错误");
            }
            RpcRequest rpcRequest = protocolMessage.getBody();

            // 处理请求
            // 构造响应结果对象
            RpcResponse rpcResponse = new RpcResponse();
            try {
                // 获取要调用的服务实现类,通过反射调用
                Class<?> implClass = LocalRegistry.get(rpcRequest.getServiceName());
                Method method = implClass.getMethod(rpcRequest.getMethodName(), rpcRequest.getParameterTypes());
                Object result = method.invoke(implClass.getDeclaredConstructor().newInstance(), rpcRequest.getArgs());
                // 封装返回结果
                rpcResponse.setData(result);
                rpcResponse.setDataType(method.getReturnType());
                rpcResponse.setMessage("ok");
            } catch (Exception e) {
                e.printStackTrace();
                rpcResponse.setMessage(e.getMessage());
                rpcResponse.setException(e);
            }

            // 发送响应,编码
            ProtocolMessage.Header header = protocolMessage.getHeader();
            header.setType((byte) ProtocolMessageTypeEnum.RESPONSE.getKey());
            ProtocolMessage<RpcResponse> responseProtocolMessage = new ProtocolMessage<>(header, rpcResponse);
            try {
                Buffer encode = ProtocolMessageEncoder.encode(responseProtocolMessage);
                netSocket.write(encode);
            } catch (IOException e) {
                throw new RuntimeException("协议消息编码错误");
            }
        });
    }
}5、请求发送(服务消费者)
调整服务消费者发送请求的代码,改 HTTP 请求为 TCP 请求。
代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import cn.hutool.core.util.IdUtil;
import cn.hutool.http.HttpRequest;
import cn.hutool.http.HttpResponse;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.protocol.*;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;
import io.vertx.core.net.NetSocket;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.List;
import java.util.concurrent.CompletableFuture;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Slf4j
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 指定序列化器
//        final Serializer serializer = SerializerFactory.getInstance(RpcApplication.getRpcConfig().getSerializer());

        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();
        try {
            // 序列化
//            byte[] bodyBytes = serializer.serialize(rpcRequest);

            // 从注册中心获取服务提供者请求地址
            RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 获取到具体的注册中心实例
            Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
            // 获取该服务的所有节点
            List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
            if (CollUtil.isEmpty(serviceMetaInfoList)) {
                throw new RuntimeException("暂无服务地址");
            }
            // todo 暂时先取第一个节点,后续通过负载均衡来获取
            ServiceMetaInfo selectedServiceMetaInfo = serviceMetaInfoList.get(0);

            // 发起 HTTP 请求,远程调用服务的方法
//            try (HttpResponse httpResponse = HttpRequest.post(selectedServiceMetaInfo.getServiceAddress())
//                    .body(bodyBytes)
//                    .execute()) {
//                if (httpResponse.isOk()) {
//                    byte[] result = httpResponse.bodyBytes();
//                    // 反序列化 RPC 响应
//                    RpcResponse rpcResponse = serializer.deserialize(result, RpcResponse.class);
//                    return rpcResponse.getData();
//                }
//            }
            // 改为发送 TCP 请求
            Vertx vertx = Vertx.vertx();
            NetClient netClient = vertx.createNetClient();
            CompletableFuture<RpcResponse> responseFuture = new CompletableFuture<>();
            netClient.connect(
                    selectedServiceMetaInfo.getServicePort(),
                    selectedServiceMetaInfo.getServiceHost(),
                    result -> {
                        if (result.succeeded()) {
                            log.info("Connected to TCP server");
                            NetSocket socket = result.result();
                            // 发送数据
                            // 构造消息头
                            ProtocolMessage.Header header = new ProtocolMessage.Header();
                            header.setMagic(ProtocolConstant.PROTOCOL_MAGIC);
                            header.setVersion(ProtocolConstant.PROTOCOL_VERSION);
                            header.setSerializer((byte) ProtocolMessageSerializerEnum.getEnumByValue(RpcApplication.getRpcConfig().getSerializer()).getKey());
                            header.setType((byte) ProtocolMessageTypeEnum.REQUEST.getKey());
                            header.setRequestId(IdUtil.getSnowflakeNextId());
                            // 构造消息
                            ProtocolMessage<RpcRequest> protocolMessage = new ProtocolMessage<>(header, rpcRequest);
                            // 编码请求
                            try {
                                Buffer encodeBuffer = ProtocolMessageEncoder.encode(protocolMessage);
                                // 向指定服务写入消息请求
                                socket.write(encodeBuffer);
                            } catch (IOException e) {
                                throw new RuntimeException("协议消息编码错误");
                            }
                            // 接收响应
                            socket.handler(buffer -> {
                                try {
                                    ProtocolMessage<RpcResponse> rpcResponseProtocolMessage = (ProtocolMessage<RpcResponse>) ProtocolMessageDecoder.decode(buffer);
                                    // 完成了响应
                                    responseFuture.complete(rpcResponseProtocolMessage.getBody());
                                } catch (IOException e) {
                                    throw new RuntimeException("协议消息解码错误");
                                }
                            });
                        } else {
                            log.error("Failed to connect to TCP server");
                        }
                    }
            );
            // 阻塞,直到响应完成,才会继续向下执行
            RpcResponse rpcResponse = responseFuture.get();
            // 记得关闭连接
            netClient.close();
            return rpcResponse.getData();
        } catch (Exception e) {
            e.printStackTrace();
        }
        return null;
    }
}这里的代码看着比较复杂,但我们只需要关注上述代码中注释了 “发送 TCP 请求” 的部分即可。由于 Vert.x 提供的请求处理器是异步、反应式的,我们为了更方便地获取结果,可以使用 CompletableFuture 转异步为同步,参考代码如下:
java
CompletableFuture<RpcResponse> responseFuture = new CompletableFuture<>();
netClient.connect(xxx,
    result -> {
        // 完成了响应
        responseFuture.complete(rpcResponseProtocolMessage.getBody());
    });
);
// 阻塞,直到响应完成,才会继续向下执行
RpcResponse rpcResponse = responseFuture.get();
等下也会优化下上述代码。
四、测试
编写好上述代码后,我们就可以先测试请求响应流程是否跑通了。
修改服务提供者 ProviderExample 代码,改为启动 TCP 服务器。完整代码如下:
java
package com.salmon;

import com.salmon.config.RegistryConfig;
import com.salmon.config.RpcConfig;
import com.salmon.impl.UserServiceImpl;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.LocalRegistry;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.server.HttpServer;
import com.salmon.server.impl.VertxHttpServer;
import com.salmon.server.tcp.VertxTcpServer;
import com.salmon.service.UserService;

/**
 * 简易服务提供者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ProviderExample {
    public static void main(String[] args) {
        // RPC 框架初始化
        RpcApplication.init();

        // 注册服务
        String serviceName = UserService.class.getName();
        LocalRegistry.registry(serviceName, UserServiceImpl.class);

        // 注册服务到注册中心
        RpcConfig rpcConfig = RpcApplication.getRpcConfig();
        RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
        registryConfig.setAddress("http://localhost:2379");
        // 获取注册中心实例
        Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());

        // 封装服务注册信息
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName(serviceName);
        serviceMetaInfo.setServiceHost(rpcConfig.getServerHost());
        serviceMetaInfo.setServicePort(rpcConfig.getServerPort());

        try {
            // 注册服务
            registry.register(serviceMetaInfo);
        } catch (Exception e) {
            throw new RuntimeException(e);
        }

        // 启动 TCP 服务
        HttpServer httpServer = new VertxTcpServer();
        httpServer.doStart(rpcConfig.getServerPort());
    }
}然后启动消费者示例项目,应该能够正常完成调用。如果不能,那可能就是出现了我们接下来要讲的问题 —— 粘包半包问题。
五、粘包半包问题解决
什么是粘包和半包?
使用 TCP 协议网络通讯时,可能会出现半包和粘包问题。
我举个例子大家就明白了。
理想情况下,假如我们客户端 连续 2 次 要发送的消息是:
sh
// 第一次
Hello, server!Hello, server!Hello, server!Hello, server!
// 第二次
Hello, server!Hello, server!Hello, server!Hello, server!
但服务端收到的消息情况可能是:
1)每次收到的数据更少了,这种情况叫做 半包:
sh
// 第一次
Hello, server!Hello, server!Hello, server!
// 第二次
Hello, server!Hello, server!
2)每次收到的数据更多了,这种情况叫做 粘包:
sh
// 第一次
Hello, server!Hello, server!
// 第二次
Hello, server!Hello, server!Hello, server!
// 第三次
Hello, server!Hello, server!Hello, server!Hello, server!Hello, server!
半包粘包问题演示
为了更好地理解半包和粘包,我们可以编写代码来测试。
1)修改 TCP 客户端代码,连续发送 1000 次消息:
java
package com.salmon.server.tcp;

import io.vertx.core.Vertx;
import io.vertx.core.net.NetClient;

/**
 * 基于 Vert.x 的TCP客户端
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpClient {

    public static void main(String[] args) {
        new VertxTcpClient().start();
    }

    public void start() {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 客户端
        NetClient netClient = vertx.createNetClient();

        // 连接服务器
        netClient.connect(8888, "localhost", result -> {
            if (result.succeeded()) {
                System.out.println("Connected to TCP server");
                io.vertx.core.net.NetSocket socket = result.result();
                for (int i = 0; i < 1000; i++) {
                    // 发送数据
                    socket.write("Hello, server!Hello, server!Hello, server!Hello, server!");
                }
                // 接收响应
                socket.handler(buffer -> {
                    System.out.println("Received response from server: " + buffer.toString());
                });
            } else {
                System.err.println("Failed to connect to TCP server");
            }
        });
    }
}2)修改 TCP 服务端代码,打印出每次收到的消息:
java
package com.salmon.server.tcp;

import com.salmon.server.HttpServer;
import com.salmon.server.handler.TcpServerHandler;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetServer;

/**
 * 基于 Vert.x 的TCP服务器实现
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpServer implements HttpServer {

    public static void main(String[] args) {
        new VertxTcpServer().doStart(8888);
    }

    @Override
    public void doStart(int port) {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 服务器
        NetServer server = vertx.createNetServer();

        // 处理请求
//        server.connectHandler(new TcpServerHandler());
        server.connectHandler(socket -> {
            socket.handler(buffer -> {
                String testMessage = "Hello, server!Hello, server!Hello, server!Hello, server!";
                int messageLength = testMessage.getBytes().length;
                // 消息长度小于原消息
                if (buffer.getBytes().length < messageLength) {
                    System.out.println("半包, length = " + buffer.getBytes().length);
                    return;
                }
                // 消息长度大于原消息
                if (buffer.getBytes().length > messageLength) {
                    System.out.println("粘包, length = " + buffer.getBytes().length);
                    return;
                }
                String str = new String(buffer.getBytes(0, messageLength));
                System.out.println(str);
                if (testMessage.equals(str)) {
                    System.out.println("good");
                }
            });
        });


        // 启动 TCP 服务器并监听指定端口
        server.listen(port, result -> {
            if (result.succeeded()) {
                System.out.println("TCP server started on port " + port);
            } else {
                System.err.println("Failed to start TCP server: " + result.cause());
            }
        });
    }

//    private byte[] handleRequest(byte[] requestData) {
//        // 在这里编写处理请求的逻辑,根据 requestData 构造响应数据并返回
//        System.out.println("Received response from client: " + Buffer.buffer(requestData));
//        // 这里只是一个示例,实际逻辑需要根据具体的业务需求来实现
//        return "Hello, client!".getBytes();
//    }

}3)测试运行,查看服务端控制台,发现服务端接受消息时,出现了半包和粘包:
下面我们分别解决半包和粘包问题。
如何解决半包?
解决半包的核心思路是:在消息头中设置请求体的长度,服务端接收时,判断每次消息的长度是否符合预期,不完整就不读,留到下一次接收到消息时再读取。
示例代码如下:
java
if (buffer == null || buffer.length() == 0) {
    throw new RuntimeException("消息 buffer 为空");
}
if (buffer.getBytes().length < ProtocolConstant.MESSAGE_HEADER_LENGTH) {
    throw new RuntimeException("出现了半包问题");
}
如何解决粘包?
解决粘包的核心思路也是类似的:每次只读取指定长度的数据,超过长度的留着下一次接收到消息时再读取。
示例代码如下:
java
// 解决粘包问题,只读指定长度的数据
byte[] bodyBytes = buffer.getBytes(17, 17 + header.getBodyLength());
听上去简单,但自己实现起来还是比较麻烦的,要记录每次接收到的消息位置,维护字节数组缓存。有没有更简单的方式呢?
Vert.x 解决半包和粘包
在 Vert.x 框架中,可以使用内置的 RecordParser 完美解决半包粘包,它的作用是:保证下次读取到 特定长度 的字符。
先不要急着直接修改业务代码,而是先学会该类库的使用,跑通测试流程,再引入到自己的业务代码中。
基础代码
1)先小试牛刀,使用 RecordParser 来读取固定长度的消息,示例代码如下:
java
package com.salmon.server.tcp;

import com.salmon.server.HttpServer;
import com.salmon.server.handler.TcpServerHandler;
import io.vertx.core.Handler;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetServer;
import io.vertx.core.parsetools.RecordParser;

/**
 * 基于 Vert.x 的TCP服务器实现
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpServer implements HttpServer {

    public static void main(String[] args) {
        new VertxTcpServer().doStart(8888);
    }

    @Override
    public void doStart(int port) {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 服务器
        NetServer server = vertx.createNetServer();

        // 处理请求
//        server.connectHandler(new TcpServerHandler());
        server.connectHandler(socket -> {
            String testMessage = "Hello, server!Hello, server!Hello, server!Hello, server!";
            int messageLength = testMessage.getBytes().length;

            // 构造parser
            RecordParser parser = RecordParser.newFixed(messageLength);
            parser.setOutput(new Handler<Buffer>() {
                @Override
                public void handle(Buffer buffer) {
                    String str = new String(buffer.getBytes());
                    System.out.println(str);
                    if (testMessage.equals(str)) {
                        System.out.println("good");
                    }
                }
            });

            socket.handler(parser);
        });


        // 启动 TCP 服务器并监听指定端口
        server.listen(port, result -> {
            if (result.succeeded()) {
                System.out.println("TCP server started on port " + port);
            } else {
                System.err.println("Failed to start TCP server: " + result.cause());
            }
        });
    }

}上述代码的核心是 RecordParser.newFixed(messageLength),为 Parser 指定每次读取固定值长度的内容。
测试发现,这次的输出结果非常整齐,解决了半包和粘包:
2)实际运用中,消息体的长度是不固定的,所以要通过调整 RecordParser 的固定长度(变长)来解决。
那我们的思路可以是,将读取完整的消息拆分为 2 次:
- 先完整读取请求头信息,由于请求头信息长度是固定的,可以使用
RecordParser保证每次都完整读取。 - 再根据请求头长度信息更改
RecordParser的固定长度,保证完整获取到请求体。
修改测试 TCP Server 代码如下:
java
package com.salmon.server.tcp;

import com.salmon.server.HttpServer;
import com.salmon.server.handler.TcpServerHandler;
import io.vertx.core.Handler;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetServer;
import io.vertx.core.parsetools.RecordParser;

/**
 * 基于 Vert.x 的TCP服务器实现
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpServer implements HttpServer {

    public static void main(String[] args) {
        new VertxTcpServer().doStart(8888);
    }

    @Override
    public void doStart(int port) {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 服务器
        NetServer server = vertx.createNetServer();

        // 处理请求
        server.connectHandler(socket -> {
            // 构造 parser
            RecordParser parser = RecordParser.newFixed(8);
            parser.setOutput(new Handler<Buffer>() {
                // 初始化
                int size = -1;
                // 一次完整的读取(头 + 体)
                Buffer resultBuffer = Buffer.buffer();

                @Override
                public void handle(Buffer buffer) {
                    // 1. 每次循环,首先读取消息头
                    if (-1 == size) {
                        // | 4 byte | body.length | body.data |
                        // 发送的消息头是有两个整数,每个整数占用 4 个字节,消息头部总共占 8 个字节
                        // 读取消息体长度(读取第二个整数,从下标为 4 的位置读取一个整数(32位的整数值))
                        size = buffer.getInt(4);
                        // 将其设置为下次要读取的消息长度
                        parser.fixedSizeMode(size);
                        // 写入头信息到结果
                        resultBuffer.appendBuffer(buffer);
                    } else {
                        // 2. 然后读取消息体
                        // 写入体信息到结果
                        resultBuffer.appendBuffer(buffer);
                        System.out.println(resultBuffer.toString());
                        // 重置一轮,下次重新先读取消息头
                        parser.fixedSizeMode(8);
                        size = -1;
                        resultBuffer = Buffer.buffer();
                    }
                }
            });

            socket.handler(parser);
        });


        // 启动 TCP 服务器并监听指定端口
        server.listen(port, result -> {
            if (result.succeeded()) {
                System.out.println("TCP server started on port " + port);
            } else {
                System.err.println("Failed to start TCP server: " + result.cause());
            }
        });
    }

}我们根据消息的头部分别是有哪些类型构成的,就可以算出实际我们要在哪个位置开始读取到消息体的长度。常见的整数数据类型如下:
- byte:8 位,1 个字节。
- short:16 位,2 个字节。
- int:32 位,4 个字节。
- long:64 位,8 个字节。
修改测试 TCP client 代码如下,自己构造了一个变长、长度信息不在 Buffer 最开头(而是有一定偏移量)的消息:
java
package com.salmon.server.tcp;

import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;

/**
 * 基于 Vert.x 的TCP客户端
 *
 * @author Salmon
 * @since 2024-05-07
 */
public class VertxTcpClient {

    public static void main(String[] args) {
        new VertxTcpClient().start();
    }

    public void start() {
        // 创建 Vert.x 实例
        Vertx vertx = Vertx.vertx();

        // 创建 TCP 客户端
        NetClient netClient = vertx.createNetClient();

        // 连接服务器
        netClient.connect(8888, "localhost", result -> {
            if (result.succeeded()) {
                System.out.println("Connected to TCP server");
                io.vertx.core.net.NetSocket socket = result.result();
                for (int i = 0; i < 1000; i++) {
                    // 发送数据
                    Buffer buffer = Buffer.buffer();
                    String str = "Hello, server!Hello, server!Hello, server!Hello, server!";
                    buffer.appendInt(0);
                    buffer.appendInt(str.getBytes().length);
                    buffer.appendBytes(str.getBytes());
                    socket.write(buffer);
                }
                // 接收响应
                socket.handler(buffer -> {
                    System.out.println("Received response from server: " + buffer.toString());
                });
            } else {
                System.err.println("Failed to connect to TCP server");
            }
        });
    }
}测试结果应该也是能够正常读取到消息的,不会出现半包和粘包。(注意:前面部分是消息头)
封装半包粘包处理器
我们会发现,解决半包粘包问题还是有一定的代码量的,而且由于 ServiceProxy(消费者)和请求 Handler(提供者)都需要接受 Buffer,所以都需要半包粘包问题处理。
那我们就应该要想到:需要对代码进行封装复用了。
这里我们可以使用设计模式中的 装饰者模式,使用 RecordParser 对原有的 Buffer 处理器的能力进行增强。
装饰者模式可以简单理解为给对象穿装备,增强对象的能力。
在 server.tcp 包下新建 TcpBufferHandlerWrapper 类,实现并增强 Handler<Buffer> 接口。
完整代码如下:
java
package com.salmon.server.tcp;

import com.salmon.protocol.ProtocolConstant;
import io.vertx.core.Handler;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.parsetools.RecordParser;

/**
 * 装饰者模式(使用 recordParser 对原有的 buffer 处理能力进行增强)
 *
 * @author Salmon
 * @since 2024-05-13
 */
public class TcpBufferHandlerWrapper implements Handler<Buffer> {

    private final RecordParser recordParser;

    public TcpBufferHandlerWrapper(Handler<Buffer> bufferHandler) {
        recordParser = initRecordParser(bufferHandler);
    }

    @Override
    public void handle(Buffer buffer) {
        recordParser.handle(buffer);
    }

    private RecordParser initRecordParser(Handler<Buffer> bufferHandler) {
        // 构造 parser
        RecordParser parser = RecordParser.newFixed(ProtocolConstant.MESSAGE_HEADER_LENGTH);

        parser.setOutput(new Handler<Buffer>() {
            // 初始化
            int size = -1;
            // 一次完整的读取(头 + 体)
            Buffer resultBuffer = Buffer.buffer();

            @Override
            public void handle(Buffer buffer) {
                // 1. 每次循环,首先读取消息头
                if (-1 == size) {
                    // | magic: 1 byte | version: 1 byte | setSerializer: 1 byte | type: 1 byte | status: 1 byte | requestId: 8 byte| body.length | body.data |
                    // 发送的消息头如上所示,消息头部总共占 17 个字节
                    // 读取消息体长度(从下标为 13 的位置读取一个整数(32位的整数值))
                    size = buffer.getInt(13);
                    // 将其设置为下次要读取的消息长度
                    parser.fixedSizeMode(size);
                    // 写入头信息到结果
                    resultBuffer.appendBuffer(buffer);
                } else {
                    // 2. 然后读取消息体
                    // 写入体信息到结果
                    resultBuffer.appendBuffer(buffer);
                    // 已拼接为完整 Buffer,执行处理
                    bufferHandler.handle(resultBuffer);
                    // 重置一轮,下次重新先读取消息头
                    parser.fixedSizeMode(ProtocolConstant.MESSAGE_HEADER_LENGTH);
                    size = -1;
                    resultBuffer = Buffer.buffer();
                }
            }
        });
        return parser;
    }
}其实就是把 RecordParser 的代码粘了过来,当调用处理器的 handle 方法时,改为调用 recordParser.handle。
优化客户端调用代码
有了半包粘包处理器,我们就可以很轻松地在业务代码中运用它了。
1)修改 TCP 请求处理器。
使用 TcpBufferHandlerWrapper 来封装之前处理请求的代码,请求逻辑不用变,需要修改的部分代码如下:
java
package com.salmon.server.handler;

import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.protocol.*;
import com.salmon.registry.LocalRegistry;
import com.salmon.server.tcp.TcpBufferHandlerWrapper;
import io.vertx.core.Handler;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetSocket;

import java.io.IOException;
import java.lang.reflect.Method;

/**
 * TCP 请求处理器
 *
 * @author Salmon
 * @since 2024-05-13
 */
public class TcpServerHandler implements Handler<NetSocket> {

    /**
     * 处理请求
     *
     * @param socket the event to handle
     */
    @Override
    public void handle(NetSocket socket) {
        TcpBufferHandlerWrapper bufferHandlerWrapper = new TcpBufferHandlerWrapper(buffer -> {
            // 接收请求,解码
            ProtocolMessage<RpcRequest> protocolMessage;
            try {
                protocolMessage = (ProtocolMessage<RpcRequest>) ProtocolMessageDecoder.decode(buffer);
            } catch (IOException e) {
                throw new RuntimeException("协议消息解码错误");
            }
            RpcRequest rpcRequest = protocolMessage.getBody();

            // 处理请求
            // 构造响应结果对象
            RpcResponse rpcResponse = new RpcResponse();
            try {
                // 获取要调用的服务实现类,通过反射调用
                Class<?> implClass = LocalRegistry.get(rpcRequest.getServiceName());
                Method method = implClass.getMethod(rpcRequest.getMethodName(), rpcRequest.getParameterTypes());
                Object result = method.invoke(implClass.getDeclaredConstructor().newInstance(), rpcRequest.getArgs());
                // 封装返回结果
                rpcResponse.setData(result);
                rpcResponse.setDataType(method.getReturnType());
                rpcResponse.setMessage("ok");
            } catch (Exception e) {
                e.printStackTrace();
                rpcResponse.setMessage(e.getMessage());
                rpcResponse.setException(e);
            }

            // 发送响应,编码
            ProtocolMessage.Header header = protocolMessage.getHeader();
            header.setType((byte) ProtocolMessageTypeEnum.RESPONSE.getKey());
            header.setStatus((byte) ProtocolMessageStatusEnum.OK.getValue());
            ProtocolMessage<RpcResponse> responseProtocolMessage = new ProtocolMessage<>(header, rpcResponse);
            try {
                Buffer encode = ProtocolMessageEncoder.encode(responseProtocolMessage);
                socket.write(encode);
            } catch (IOException e) {
                throw new RuntimeException("协议消息编码错误");
            }
        });
        socket.handler(bufferHandlerWrapper);
    }
}其实就是使用一个 Wrapper 对象 包装 了之前的代码,就解决了半包粘包。是不是很简单?这就是装饰者模式的妙用!
2)修改客户端处理响应的代码。
之前我们是把所有发送请求、处理响应的代码都写到了 ServiceProxy 中,使得这个类的代码 “臃肿不堪”。
我们干脆做个优化,把所有的请求响应逻辑提取出来,封装为单独的 VertxTcpClient 类,放在 server.tcp 包下。
VertxTcpClient 的完整代码如下:
java
package com.salmon.server.tcp;

import cn.hutool.core.util.IdUtil;
import com.salmon.RpcApplication;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.protocol.*;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;
import io.vertx.core.net.NetSocket;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutionException;

/**
 * 基于 Vert.x 的TCP客户端
 *
 * @author Salmon
 * @since 2024-05-07
 */
@Slf4j
public class VertxTcpClient {

    /**
     * 发送请求
     *
     * @param rpcRequest      rpc 请求信息
     * @param serviceMetaInfo rpc服务元信息
     * @return rpc 响应信息
     */
    public static RpcResponse doRequest(RpcRequest rpcRequest, ServiceMetaInfo serviceMetaInfo) throws InterruptedException, ExecutionException {
        // 发送 TCP 请求
        Vertx vertx = Vertx.vertx();
        NetClient netClient = vertx.createNetClient();
        CompletableFuture<RpcResponse> responseFuture = new CompletableFuture<>();
        netClient.connect(
                serviceMetaInfo.getServicePort(),
                serviceMetaInfo.getServiceHost(),
                result -> {
                    if (!result.succeeded()) {
                        log.error("Failed to connect to TCP server");
                        return;
                    }
                    NetSocket socket = result.result();
                    // 发送数据
                    // 构造消息头
                    ProtocolMessage.Header header = new ProtocolMessage.Header();
                    header.setMagic(ProtocolConstant.PROTOCOL_MAGIC);
                    header.setVersion(ProtocolConstant.PROTOCOL_VERSION);
                    header.setSerializer((byte) ProtocolMessageSerializerEnum.getEnumByValue(RpcApplication.getRpcConfig().getSerializer()).getKey());
                    header.setType((byte) ProtocolMessageTypeEnum.REQUEST.getKey());
                    // 生成全局请求 ID
                    header.setRequestId(IdUtil.getSnowflakeNextId());
                    // 构造消息
                    ProtocolMessage<RpcRequest> protocolMessage = new ProtocolMessage<>();
                    protocolMessage.setHeader(header);
                    protocolMessage.setBody(rpcRequest);

                    // 编码请求
                    try {
                        Buffer encodeBuffer = ProtocolMessageEncoder.encode(protocolMessage);
                        // 向指定服务写入消息请求
                        socket.write(encodeBuffer);
                    } catch (IOException e) {
                        throw new RuntimeException("协议消息编码错误");
                    }

                    // 接收响应
                    TcpBufferHandlerWrapper bufferHandlerWrapper = new TcpBufferHandlerWrapper(
                            buffer -> {
                                try {
                                    ProtocolMessage<RpcResponse> rpcResponseProtocolMessage = (ProtocolMessage<RpcResponse>) ProtocolMessageDecoder.decode(buffer);
                                    responseFuture.complete(rpcResponseProtocolMessage.getBody());
                                } catch (IOException e) {
                                    throw new RuntimeException("协议消息解码错误");
                                }
                            }
                    );
                    socket.handler(bufferHandlerWrapper);
                }
        );
        // 等待异步结果
        RpcResponse rpcResponse = responseFuture.get();
        // 记得关闭连接
        netClient.close();
        return rpcResponse;
    }
}注意,上述代码中,也使用了 TcpBufferHandlerWrapper 对处理响应的代码进行了封装。
修改 ServiceProxy 代码,调用 VertxTcpClient,修改后的代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import cn.hutool.core.util.IdUtil;
import cn.hutool.http.HttpRequest;
import cn.hutool.http.HttpResponse;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.protocol.*;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import com.salmon.server.tcp.VertxTcpClient;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;
import io.vertx.core.net.NetSocket;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.List;
import java.util.concurrent.CompletableFuture;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Slf4j
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();
        try {
            // 从注册中心获取服务提供者请求地址
            RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 获取到具体的注册中心实例
            Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
            // 获取该服务的所有节点
            List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
            if (CollUtil.isEmpty(serviceMetaInfoList)) {
                throw new RuntimeException("暂无服务地址");
            }
            // todo 暂时先取第一个节点,后续通过负载均衡来获取
            ServiceMetaInfo selectedServiceMetaInfo = serviceMetaInfoList.get(0);
            // 发送 TCP 请求
            RpcResponse rpcResponse = VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo);
            return rpcResponse.getData();
        } catch (Exception e) {
            throw new RuntimeException("调用失败");
        }
    }
}怎么样,是不是简单了很多?
六、扩展
1)自己定义一个占用空间更少的 RPC 协议的消息结构。
参考思路:序列化方式字段目前占用了 8 bit,但其实总共就几种序列化方式,能否只占用 4 bit?其他字段也可以按照这种方式思考。
最后
最后再给大家抛个小问题:为什么 tcpServer 不提供个 server 接口,或者和 httpServer 共用接口?
我的想法是这样的:替换这两个服务器(协议实现)涉及的改动点非常多,比如 RPC 协议、请求处理器等,不是直接能通过配置就替换的,而且 RPC 框架一般也不需要替换底层的协议,只使用 TCP 会更好。
所以希望大家在系统设计时,一定要灵活,按需设计,不要学了技术后就无脑应用!
负载均衡
一、需求分析
现在我们的 RPC 框架已经可以从注册中心获取到服务提供者的注册信息了,同一个服务可能会有多个服务提供者,但是目前我们消费者始终读取了第一个服务提供者节点发起调用,不仅会增大单个节点的压力,而且没有利用好其他节点的资源。
我们完全可以从服务提供者节点中,选择一个服务提供者发起请求,而不是每次都请求同一个服务提供者,这个操作就叫做 负载均衡。
本节教程,我们就为 RPC 框架支持服务消费者的负载均衡。
二、负载均衡
什么是负载均衡?
让我们把这个词拆开来看:
1)何为负载?可以把负载理解为要处理的工作和压力,比如网络请求、事务、数据处理任务等。
2)何为均衡?把工作和压力平均地分配给多个工作者,从而分摊每个工作者的压力,保证大家正常工作。
用个比喻,假设餐厅里只有一个服务员,如果顾客非常多,他可能会忙不过来,没法及时上菜、忙中生乱;而且他的压力会越来越大,最严重的情况下就累倒了无法继续工作。而如果有多个服务员,大家能够服务更多的顾客,即使有一个服务员生病了,其他服务员也能帮忙顶上。
所以,负载均衡是一种用来分配网络或计算负载到多个资源上的技术。它的目的是确保每个资源都能够有效地处理负载、增加系统的并发量、避免某些资源过载而导致性能下降或服务不可用的情况。
回归到我们的 RPC 框架,负载均衡的作用是从一组可用的服务提供者中选择一个进行调用。
常用的负载均衡实现技术有 Nginx(七层负载均衡)、LVS(四层负载均衡)等。
常见负载均衡算法
负载均衡学习的重点就是它的算法 —— 按照什么策略选择资源。
不同的负载均衡算法,适用的场景也不同,一定要根据实际情况选取,主流的负载均衡算法如下:
1)轮询(Round Robin):按照循环的顺序将请求分配给每个服务器,适用于各服务器性能相近的情况。
假如有 5 台服务器节点,请求调用顺序如下:
sh
1,2,3,4,5,1,2,3,4,52)随机(Random):随机选择一个服务器来处理请求,适用于服务器性能相近且负载均匀的情况。
假如有 5 台服务器节点,请求调用顺序如下:
sh
3,2,4,1,2,5,2,1,3,43)加权轮询(Weighted Round Robin):根据服务器的性能或权重分配请求,性能更好的服务器会获得更多的请求,适用于服务器性能不均的情况。
假如有 1 台千兆带宽的服务器节点和 4 台百兆带宽的服务器节点,请求调用顺序可能如下:
sh
1,1,1,2, 1,1,1,3, 1,1,1,4, 1,1,1,54)加权随机(Weighted Random):根据服务器的权重随机选择一个服务器处理请求,适用于服务器性能不均的情况。
假如有 2 台千兆带宽的服务器节点和 3 台百兆带宽的服务器节点,请求调用顺序可能如下:
sh
1,2,2,1,3, 1,1,1,2,4, 2,2,2,1,55)最小连接数(Least Connections):选择当前连接数最少的服务器来处理请求,适用于长连接场景。
6)IP Hash:根据客户端 IP 地址的哈希值选择服务器处理请求,确保同一客户端的请求始终被分配到同一台服务器上,适用于需要保持会话一致性的场景。
当然,也可以根据请求中的其他参数进行 Hash,比如根据请求接口的地址路由到不同的服务器节点。
下面,再给大家分享一个很重要的分布式知识点:一致性 Hash。
一致性 Hash
一致性哈希(Consistent Hashing)是一种经典的哈希算法,用于将请求分配到多个节点或服务器上,所以非常适用于负载均衡。
它的核心思想是将整个哈希值空间划分成一个环状结构,每个节点或服务器在环上占据一个位置,每个请求根据其哈希值映射到环上的一个点,然后顺时针寻找第一个大于或等于该哈希值的节点,将请求路由到该节点上。
一致性哈希环结构如图:
上图中,请求 A 会交给服务器 C 来处理。
好像也没什么特别的啊?还整个环?
其实,一致性哈希还解决了 节点下线 和 倾斜问题。
1)节点下线:当某个节点下线时,其负载会被平均分摊到其他节点上,而不会影响到整个系统的稳定性,因为只有部分请求会受到影响。
如下图,服务器 C 下线后,请求 A 会交给服务器 A 来处理(顺时针寻找第一个大于或等于该哈希值的节点),而服务器 B 接收到的请求保持不变。
如果是轮询取模算法,只要节点数变了,很有可能大多数服务器处理的请求都要发生变化,对系统的影响巨大。
2)倾斜问题:通过虚拟节点的引入,将每个物理节点映射到多个虚拟节点上,使得节点在哈希环上的 分布更加均匀,减少了节点间的负载差异。
举个例子,节点很少的情况下,环的情况可能如下图:
这样就会导致绝大多数的请求都会发给服务器 C,而服务器 A 的 “领地” 非常少,几乎不会有请求。
引入虚拟节点后,环的情况变为:
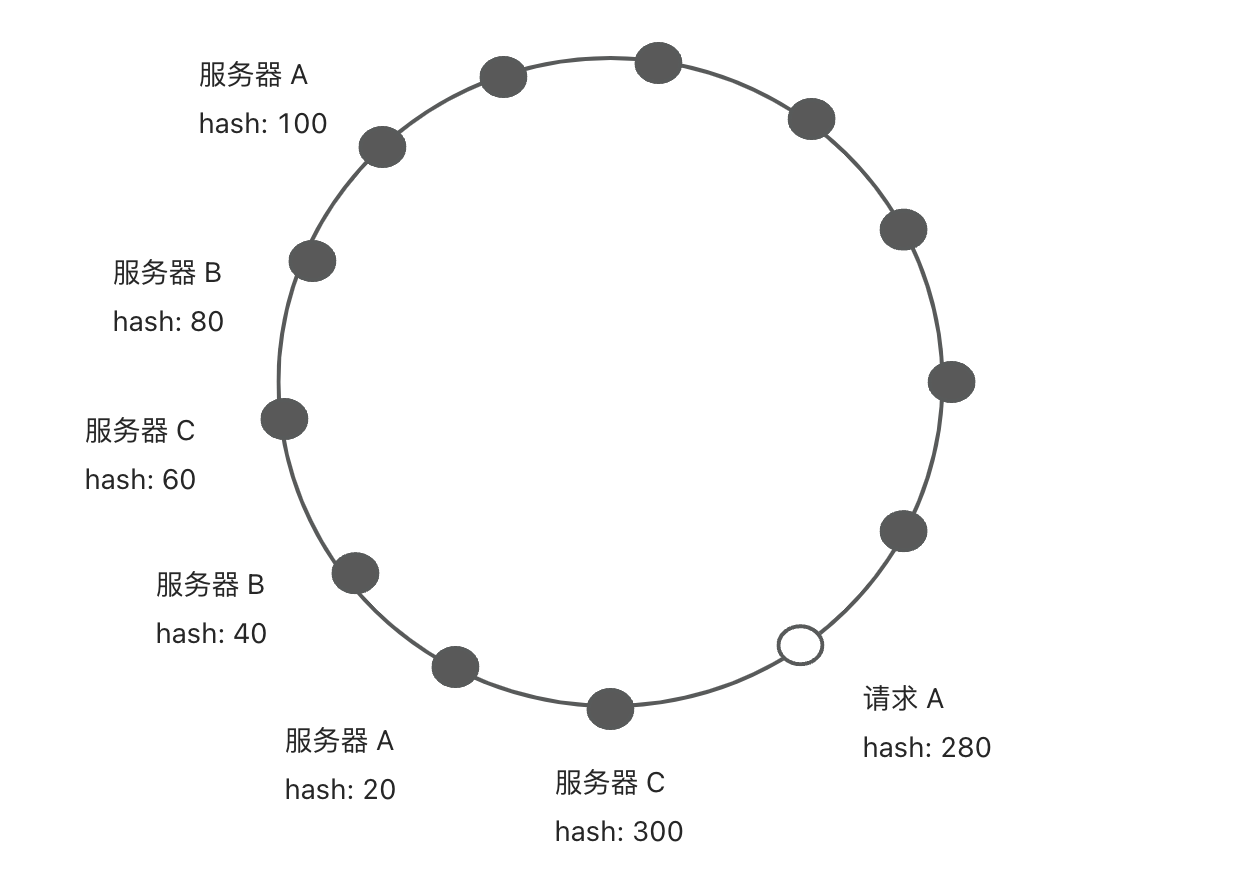
这样一来,每个服务器接受到的请求会更容易平均。
理解了负载均衡算法后,我们来开发实现。
三、开发实现
1、多种负载均衡器实现
大家学习负载均衡的时候,可以参考 Nginx 的负载均衡算法实现,此处我带大家实现轮询、随机、一致性 Hash 三种负载均衡算法。
在 RPC 项目中新建 loadbalancer 包,将所有负载均衡器相关的代码放到该包下。
1)先编写负载均衡器通用接口。提供一个选择服务方法,接受请求参数和可用服务列表,可以根据这些信息进行选择。
代码如下:
java
package com.salmon.loadbalancer;

import com.salmon.model.ServiceMetaInfo;

import java.util.List;
import java.util.Map;

/**
 * 负载均衡器(消费端使用)
 *
 * @author Salmon
 * @since 2024-05-14
 */
public interface LoadBalancer {

    /**
     * 选择服务调用
     *
     * @param requestParams       请求参数
     * @param serviceMetaInfoList 可用服务列表
     * @return 选中的服务
     */
    ServiceMetaInfo select(Map<String, Object> requestParams, List<ServiceMetaInfo> serviceMetaInfoList);

}2)轮询负载均衡器。
使用 JUC 包的 AtomicInteger 实现原子计数器,防止并发冲突问题。
代码如下:
java
package com.salmon.loadbalancer.impl;

import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;
import java.util.Map;
import java.util.concurrent.atomic.AtomicInteger;

/**
 * 轮询负载均衡器
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class RoundRobinLoadBalancer implements LoadBalancer {

    /**
     * 当前轮询的下标
     */
    private final AtomicInteger currentIndex = new AtomicInteger(0);

    @Override
    public ServiceMetaInfo select(Map<String, Object> requestParams, List<ServiceMetaInfo> serviceMetaInfoList) {
        if (serviceMetaInfoList.isEmpty()) {
            return null;
        }
        // 只有一个服务,无需轮询
        int size = serviceMetaInfoList.size();
        if (size == 1) {
            return serviceMetaInfoList.get(0);
        }
        // 取模算法轮询
        int index = currentIndex.getAndIncrement() % size;
        return serviceMetaInfoList.get(index);
    }
}3)随机负载均衡器。
使用 Java 自带的 Random 类实现随机选取即可,代码如下:
java
package com.salmon.loadbalancer.impl;

import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;
import java.util.Map;
import java.util.Random;

/**
 * 随机负载均衡器
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class RandomLoadBalancer implements LoadBalancer {

    private final Random random = new Random();

    @Override
    public ServiceMetaInfo select(Map<String, Object> requestParams, List<ServiceMetaInfo> serviceMetaInfoList) {
        if (serviceMetaInfoList.isEmpty()) {
            return null;
        }
        // 只有一个服务,无需随机
        int size = serviceMetaInfoList.size();
        if (size == 1) {
            return serviceMetaInfoList.get(0);
        }
        return serviceMetaInfoList.get(random.nextInt(size));
    }
}4)实现一致性 Hash 负载均衡器。
可以使用 TreeMap 实现一致性 Hash 环,该数据结构提供了 ceilingEntry 和 firstEntry 两个方法,便于获取符合算法要求的节点。
代码如下:
java
package com.salmon.loadbalancer.impl;

import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.model.ServiceMetaInfo;

import java.util.List;
import java.util.Map;
import java.util.TreeMap;

/**
 * 一致性哈希负载均衡器
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class ConsistentHashLoadBalancer implements LoadBalancer {

    /**
     * 一致性 Hash 环,存放虚拟节点
     */
    private final TreeMap<Integer, ServiceMetaInfo> virtualNodes = new TreeMap<>();

    /**
     * 虚拟节点数
     */
    private static final int VIRTUAL_NODE_NUM = 100;

    @Override
    public ServiceMetaInfo select(Map<String, Object> requestParams, List<ServiceMetaInfo> serviceMetaInfoList) {
        if (serviceMetaInfoList.isEmpty()) {
            return null;
        }
        // 只有一个服务,无需随机
        int size = serviceMetaInfoList.size();
        if (size == 1) {
            return serviceMetaInfoList.get(0);
        }

        // 构建虚拟节点环
        for (ServiceMetaInfo serviceMetaInfo : serviceMetaInfoList) {
            for (int i = 0; i < VIRTUAL_NODE_NUM; i++) {
                int hash = getHash(serviceMetaInfo.getServiceAddress() + "#" + i);
                virtualNodes.put(hash, serviceMetaInfo);
            }
        }

        // 获取调用请求的 hash 值
        int hash = getHash(requestParams);

        // 选择最接近且大于等于调用请求 hash 值的虚拟节点
        Map.Entry<Integer, ServiceMetaInfo> entry = virtualNodes.ceilingEntry(hash);
        if (entry == null) {
            // 如果没有大于等于调用请求 hash 值的虚拟节点,则返回环首部的节点
            entry = virtualNodes.firstEntry();
        }
        return entry.getValue();
    }

    /**
     * Hash 算法,可自行实现
     *
     * @param key 根据 key 计算 hash
     * @return hash 值
     */
    private int getHash(Object key) {
        return key.hashCode();
    }
}上述代码中,注意两点:
- 根据 requestParams 对象计算 Hash 值,这里我只是简单地调用了对象的 hashCode 方法,大家也可以根据需求实现自己的 Hash 算法。
- 每次调用负载均衡器时,都会重新构造 Hash 环,这是为了能够即时处理节点的变化。
2、支持配置和扩展负载均衡器
一个成熟的 RPC 框架可能会支持多个负载均衡器,像序列化器和注册中心一样,我们的需求是,让开发者能够填写配置来指定使用的负载均衡器,并且支持自定义负载均衡器,让框架更易用、更利于扩展。
要实现这点,开发方式和序列化器、注册中心都是一样的,都可以使用工厂创建对象、使用 SPI 动态加载自定义的注册中心。
1)负载均衡器常量。
在 loadbalancer 包下新建 LoadBalancerKeys 类,列举所有支持的负载均衡器键名。
代码如下:
java
package com.salmon.loadbalancer;

/**
 * 负载均衡器键名常量
 *
 * @author Salmon
 * @since 2024-05-14
 */
public interface LoadBalancerKeys {

    /**
     * 轮询
     */
    String ROUND_ROBIN = "roundRobin";
    /**
     * 随机
     */
    String RANDOM = "random";
    /**
     * 一致性哈希
     */
    String CONSISTENT_HASH = "consistentHash";
}2)使用工厂模式,支持根据 key 从 SPI 获取负载均衡器对象实例。
在 loadbalancer 包下新建 LoadBalancerFactory 类,代码如下:
java
package com.salmon.loadbalancer;

import cn.hutool.core.util.StrUtil;
import com.salmon.loadbalancer.impl.RoundRobinLoadBalancer;
import com.salmon.spi.SpiLoader;

/**
 * 负载均衡器工厂(工厂模式,用于获取负载均衡器对象)
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class LoadBalancerFactory {

    static {
        SpiLoader.load(LoadBalancer.class);
    }

    /**
     * 默认负载均衡器
     */
    private static final LoadBalancer DEFAULT_LOAD_BALANCER = new RoundRobinLoadBalancer();

    /**
     * 获取负载均衡实现实例
     *
     * @param key 负载均衡键名
     * @return 指定的负载均衡实现
     */
    public static LoadBalancer getInstance(String key) {
        if (StrUtil.isBlank(key)) {
            return DEFAULT_LOAD_BALANCER;
        }
        return SpiLoader.getInstance(LoadBalancer.class, key);
    }
}这个类可以直接复制之前的 SerializerFactory,然后略做修改。可以发现,只要跑通了一次 SPI 机制,后续的开发就很简单了~
3)在 META-INF 的 rpc/system 目录下编写负载均衡器接口的 SPI 配置文件,文件名称为 com.salmon.loadbalancer.LoadBalancer。
如图:
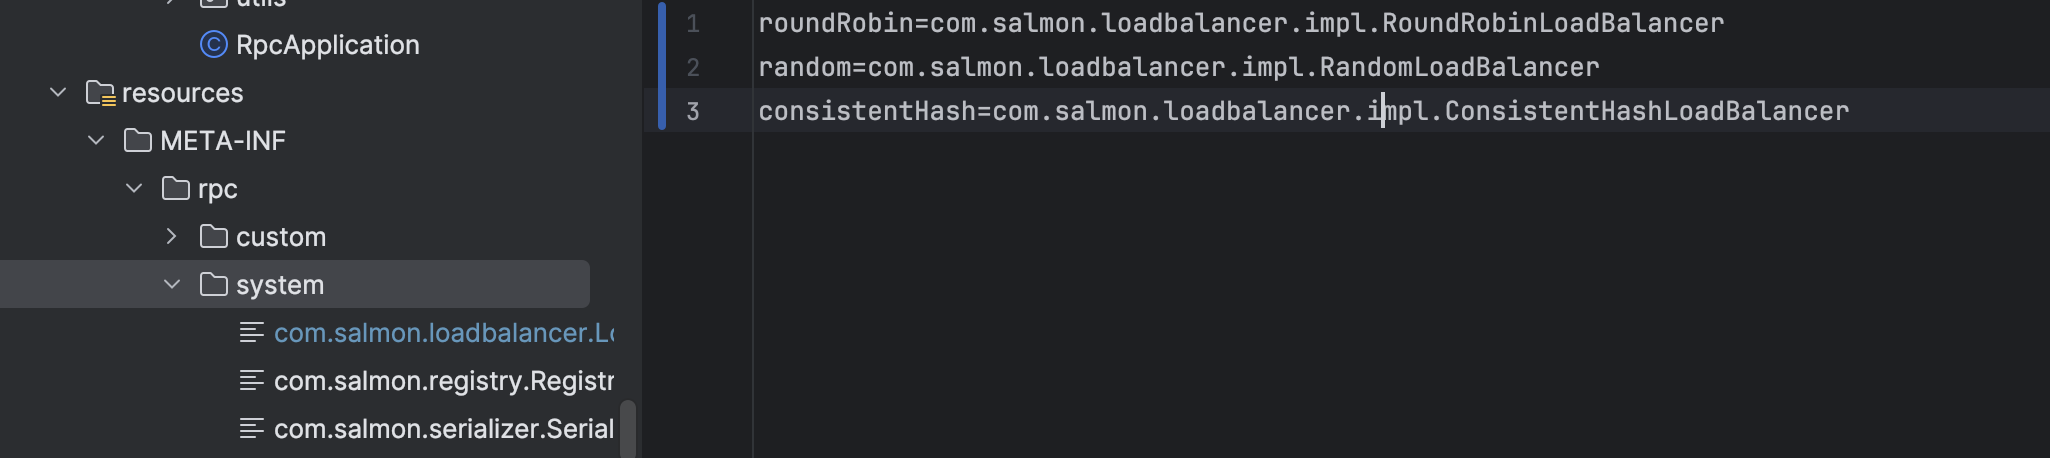
代码如下:
properties
roundRobin=com.salmon.loadbalancer.impl.RoundRobinLoadBalancer
random=com.salmon.loadbalancer.impl.RandomLoadBalancer
consistentHash=com.salmon.loadbalancer.impl.ConsistentHashLoadBalancer
4)为 RpcConfig 全局配置新增负载均衡器的配置,代码如下:
java
package com.salmon.config;

import com.salmon.loadbalancer.LoadBalancerKeys;
import com.salmon.serializer.SerializerKeys;
import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;

    /**
     * 序列化器
     */
    private String serializer = SerializerKeys.JDK;

    /**
     * 注册中心配置
     */
    private RegistryConfig registryConfig = new RegistryConfig();

    /**
     * 负载均衡器
     */
    private String loadBalancer = LoadBalancerKeys.ROUND_ROBIN;
}3、应用负载均衡器
现在,我们就能够愉快地使用负载均衡器了。修改 ServiceProxy 的代码,将 “固定调用第一个服务节点” 改为 “调用负载均衡器获取一个服务节点”。
修改后的代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import cn.hutool.core.util.IdUtil;
import cn.hutool.http.HttpRequest;
import cn.hutool.http.HttpResponse;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.loadbalancer.LoadBalancerFactory;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.protocol.*;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import com.salmon.server.tcp.VertxTcpClient;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;
import io.vertx.core.net.NetSocket;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.concurrent.CompletableFuture;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Slf4j
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();
        try {
            // 从注册中心获取服务提供者请求地址
            RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 获取到具体的注册中心实例
            Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
            // 获取该服务的所有节点
            List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
            if (CollUtil.isEmpty(serviceMetaInfoList)) {
                throw new RuntimeException("暂无服务地址");
            }

            // 负载均衡
            LoadBalancer loadBalancer = LoadBalancerFactory.getInstance(rpcConfig.getLoadBalancer());
            // 将调用方法名(请求路径)作为负载均衡参数
            Map<String, Object> requestParams = new HashMap<>();
            requestParams.put("methodName", rpcRequest.getMethodName());
            ServiceMetaInfo selectedServiceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);

            // 发送 TCP 请求
            RpcResponse rpcResponse = VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo);
            return rpcResponse.getData();
        } catch (Exception e) {
            throw new RuntimeException("调用失败");
        }
    }
}上述代码中,我们给负载均衡器传入了一个 requestParams HashMap,并且将请求方法名作为参数放到了 Map 中。如果使用的是一致性 Hash 算法,那么会根据 requestParams 计算 Hash 值,调用相同方法的请求 Hash 值肯定相同,所以总会请求到同一个服务器节点上。
四、测试
1、测试负载均衡算法
首先编写单元测试类 LoadBalancerTest,代码如下:
java
import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.loadbalancer.impl.ConsistentHashLoadBalancer;
import com.salmon.model.ServiceMetaInfo;
import org.junit.Assert;
import org.junit.Test;

import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

/**
 * 负载均衡器测试
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class LoadBalancerTest {
    final LoadBalancer loadBalancer = new ConsistentHashLoadBalancer();

    @Test
    public void select() {
        // 请求参数
        Map<String, Object> requestParams = new HashMap<>();
        requestParams.put("methodName", "registerUser");

        // 服务列表
        ServiceMetaInfo serviceMetaInfo1 = new ServiceMetaInfo();
        serviceMetaInfo1.setServiceName("myService");
        serviceMetaInfo1.setServiceVersion("1.0");
        serviceMetaInfo1.setServiceHost("localhost");
        serviceMetaInfo1.setServicePort(1234);

        ServiceMetaInfo serviceMetaInfo2 = new ServiceMetaInfo();
        serviceMetaInfo2.setServiceName("myService");
        serviceMetaInfo2.setServiceVersion("1.0");
        serviceMetaInfo2.setServiceHost("salmon.ltd");
        serviceMetaInfo2.setServicePort(80);

        List<ServiceMetaInfo> serviceMetaInfoList = Arrays.asList(serviceMetaInfo1, serviceMetaInfo2);

        // 连续调用 3 次
        ServiceMetaInfo serviceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);
        System.out.println(serviceMetaInfo);
        Assert.assertNotNull(serviceMetaInfo);
        serviceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);
        System.out.println(serviceMetaInfo);
        Assert.assertNotNull(serviceMetaInfo);
        serviceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);
        System.out.println(serviceMetaInfo);
        Assert.assertNotNull(serviceMetaInfo);
    }
}可以替换 loadBalancer 对象为不同的负载均衡器实现类,然后观察效果。
一致性哈希测试结果如下,可以看到相同方法名的请求都选中了这台服务器
2、测试负载均衡调用
首先在不同的端口启动 2 个服务提供者,然后启动服务消费者项目,通过 Debug 或者控制台输出来观察每次请求的节点地址。
五、扩展
1)实现更多不同算法的负载均衡器
参考思路:比如最少活跃数负载均衡器,选择当前正在处理请求的数量最少的服务提供者。
2)自定义一致性 Hash 算法中的 Hash 算法
参考思路:比如根据请求客户端的 IP 地址来计算 Hash 值,保证同 IP 的请求发送给相同的服务提供者。
重试机制
一、需求分析
目前,如果使用 RPC 框架的服务消费者调用接口失败,就会直接报错。
调用接口失败可能有很多原因,有时可能是服务提供者返回了错误,但有时可能只是网络不稳定或服务提供者重启等临时性问题。这种情况下,我们可能更希望服务消费者拥有自动重试的能力,提高系统的可用性。
接下来,我将带大家实现服务消费端的重试机制。
二、设计方案
重试机制
重试的概念我相信大家都能理解,不必多说,就是 “不行再来” 呗。
我们需要掌握的是 “如何设计重试机制”,重试机制的核心是 重试策略,一般来说,包含以下几个考虑点:
- 什么时候、什么条件下重试?
- 重试时间(确定下一次的重试时间)
- 什么时候、什么条件下停止重试?
- 重试后要做什么?
重试条件
首先是什么时候、什么条件下重试?
这个比较好思考,如果我们希望提高系统的可用性,当由于网络等异常情况发生时,触发重试。
重试时间
重试时间(也叫重试等待)的策略就比较丰富了,可能会用到一些算法,主流的重试时间算法有:
1)固定重试间隔(Fixed Retry Interval):在每次重试之间使用固定的时间间隔。
比如近 5 次重试的时间点如下:
sh
1s
2s
3s
4s
5s2)指数退避重试(Exponential Backoff Retry):在每次失败后,重试的时间间隔会以指数级增加,以避免请求过于密集。
比如近 5 次重试的时间点如下:
sh
1s
3s(多等 2s)
7s(多等 4s)
15s(多等 8s)
31s(多等 16s)3)随机延迟重试(Random Delay Retry):在每次重试之间使用随机的时间间隔,以避免请求的同时发生。
4)可变延迟重试(Variable Delay Retry):这种策略更 “高级” 了,根据先前重试的成功或失败情况,动态调整下一次重试的延迟时间。比如,根据前一次的响应时间调整下一次重试的等待时间。
值得一提的是,以上的策略是可以组合使用的,一定要根据具体情况和需求灵活调整。比如可以先使用指数退避重试策略,如果连续多次重试失败,则切换到固定重试间隔策略。
停止重试
一般来说,重试次数是有上限的,否则随着报错的增多,系统同时发生的重试也会越来越多,造成雪崩。
主流的停止重试策略有:
1)最大尝试次数:一般重试当达到最大次数时不再重试。
2)超时停止:重试达到最大时间的时候,停止重试。
重试工作
最后一点是重试后要做什么事情?一般来说就是重复执行原本要做的操作,比如发送请求失败了,那就再发一次请求。
需要注意的是,当重试次数超过上限时,往往还要进行其他的操作,比如:
- 通知告警:让开发者人工介入
- 降级容错:改为调用其他接口、或者执行其他操作
重试方案设计
回归到我们的 RPC 框架,消费者发起调用的代码如下:
java
try {
    // rpc 请求
    RpcResponse rpcResponse = VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo);
    return rpcResponse.getData();
} catch (Exception e) {
    throw new RuntimeException("调用失败");
}
我们完全可以将 VertxTcpClient.doRequest 封装为一个可重试的任务,如果请求失败(重试条件),系统就会自动按照重试策略再次发起请求,不用开发者关心。
对于重试算法,我们就选择主流的重试算法好了,Java 中可以使用 Guava-Retrying 库轻松实现多种不同的重试算法,非常简单,后面直接带大家实战。
和序列化器、注册中心、负载均衡器一样,重试策略本身也可以使用 SPI + 工厂的方式,允许开发者动态配置和扩展自己的重试策略。
最后,如果重试超过一定次数,我们就停止重试,并且抛出异常。在下节教程中,还会给大家分享重试失败后的另一种选择 —— 容错机制。
三、开发实现
1、多种重试策略实现
下面带大家实现 2 种最基本的重试策略:不重试、固定重试间隔。
没错,不重试也是一种重试策略哈哈!
在 RPC 项目中新建 fault.retry 包,将所有重试相关的代码放到该包下。
1)先编写重试策略通用接口。提供一个重试方法,接受一个具体的任务参数,可以使用 Callable 类代表一个任务。
代码如下:
java
package com.salmon.fault.retry;

import com.salmon.model.RpcResponse;

import java.util.concurrent.Callable;

/**
 * 重试策略
 *
 * @author Salmon
 * @since 2024-05-14
 */
public interface RetryStrategy {

    /**
     * 重试
     *
     * @param callable 重试的任务
     * @return rpc响应结果
     * @throws Exception 异常
     */
    RpcResponse doRetry(Callable<RpcResponse> callable) throws Exception;
}2)引入 Guava-Retrying 重试库,代码如下:
xml
<!-- https://github.com/rholder/guava-retrying -->
<dependency>
    <groupId>com.github.rholder</groupId>
    <artifactId>guava-retrying</artifactId>
    <version>2.0.0</version>
</dependency>
3)不重试策略实现。
就是直接执行一次任务,代码如下:
java
package com.salmon.fault.retry.impl;

import com.salmon.fault.retry.RetryStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.concurrent.Callable;

/**
 * 不重试 - 重试策略
 *
 * @author Salmon
 * @since 2024-05-14
 */
@Slf4j
public class NoRetryStrategy implements RetryStrategy {
    @Override
    public RpcResponse doRetry(Callable<RpcResponse> callable) throws Exception {
        return callable.call();
    }
}4)固定重试间隔策略实现。
使用 Guava-Retrying 提供的 RetryerBuilder 能够很方便地指定重试条件、重试等待策略、重试停止策略、重试工作等。
代码如下:
java
package com.salmon.fault.retry.impl;

import com.github.rholder.retry.*;
import com.salmon.fault.retry.RetryStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.concurrent.Callable;
import java.util.concurrent.TimeUnit;

/**
 * 固定时间间隔 - 重试策略
 *
 * @author Salmon
 * @since 2024-05-14
 */
@Slf4j
public class FixedIntervalRetryStrategy implements RetryStrategy {

    @Override
    public RpcResponse doRetry(Callable<RpcResponse> callable) throws Exception {
        Retryer<RpcResponse> retryer = RetryerBuilder.<RpcResponse>newBuilder()
                // 指定重试抛出的异常类型
                .retryIfExceptionOfType(Exception.class)
                // 指定等待策略,固定 3 秒
                .withWaitStrategy(WaitStrategies.fixedWait(3L, TimeUnit.SECONDS))
                // 停止策略,超过最大重试次数停止
                .withStopStrategy(StopStrategies.stopAfterAttempt(3))
                // 监听器,监听重试
                .withRetryListener(new RetryListener() {
                    @Override
                    public <V> void onRetry(Attempt<V> attempt) {
                        log.info("重试次数 {}", attempt.getAttemptNumber());
                    }
                }).build();
        return retryer.call(callable);
    }
}上述代码中,重试策略如下:
- 重试条件:使用 retryIfExceptionOfType 方法指定当出现 Exception 异常时重试。
- 重试等待策略:使用 withWaitStrategy 方法指定策略,选择 fixedWait 固定时间间隔策略。
- 重试停止策略:使用 withStopStrategy 方法指定策略,选择 stopAfterAttempt 超过最大重试次数停止。
- 重试工作:使用 withRetryListener 监听重试,每次重试时,除了再次执行任务外,还能够打印当前的重试次数。
5)可以简单编写一个单元测试,来验证不同的重试策略,这是最好的学习方式。
单元测试代码如下:
java
import com.salmon.fault.retry.RetryStrategy;
import com.salmon.fault.retry.impl.NoRetryStrategy;
import com.salmon.model.RpcResponse;
import org.junit.Test;

/**
 * 重试策略测试
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class RetryStrategyTest {
    RetryStrategy retryStrategy = new NoRetryStrategy();

    @Test
    public void doRetry() {
        try {
            RpcResponse rpcResponse = retryStrategy.doRetry(() -> {
                System.out.println("测试重试");
                throw new RuntimeException("模拟重试失败");
            });
            System.out.println(rpcResponse);
        } catch (Exception e) {
            System.out.println("重试多次失败");
            e.printStackTrace();
        }
    }
}
2、支持配置和扩展重试策略
一个成熟的 RPC 框架可能会支持多种不同的重试策略,像序列化器、注册中心、负载均衡器一样,我们的需求是,让开发者能够填写配置来指定使用的重试策略,并且支持自定义重试策略,让框架更易用、更利于扩展。
要实现这点,开发方式和序列化器、注册中心、负载均衡器都是一样的,都可以使用工厂创建对象、使用 SPI 动态加载自定义的注册中心。
1)重试策略常量。
在 fault.retry 包下新建 RetryStrategyKeys 类,列举所有支持的重试策略键名。
代码如下:
java
package com.salmon.fault.retry;

/**
 * 重试策略键名常量
 *
 * @author Salmon
 * @since 2024-05-14
 */
public interface RetryStrategyKeys {

    /**
     * 不重试
     */
    String NO = "no";

    /**
     * 固定时间间隔
     */
    String FIXED_INTERVAL = "fixedInterval";
}2)使用工厂模式,支持根据 key 从 SPI 获取重试策略对象实例。
在 fault.retry 包下新建 RetryStrategyFactory 类,代码如下:
java
package com.salmon.fault.retry;

import cn.hutool.core.util.StrUtil;
import com.salmon.fault.retry.impl.NoRetryStrategy;
import com.salmon.spi.SpiLoader;

/**
 * 重试策略工厂(用于获取重试器对象)
 *
 * @author Salmon
 * @since 2024-05-14
 */
public class RetryStrategyFactory {

    static {
        SpiLoader.load(RetryStrategy.class);
    }

    /**
     * 默认重试器
     */
    private static final RetryStrategy DEFAULT_RETRY_STRATEGY = new NoRetryStrategy();

    /**
     * 获取重试策略实例
     *
     * @param key 重试策略键名
     * @return 指定的重试策略实现
     */
    public static RetryStrategy getInstance(String key) {
        if (StrUtil.isBlank(key)) {
            return DEFAULT_RETRY_STRATEGY;
        }
        return SpiLoader.getInstance(RetryStrategy.class, key);
    }
}这个类可以直接复制之前的 SerializerFactory,然后略做修改。可以发现,只要跑通了一次 SPI 机制,后续的开发就很简单了~
3)在 META-INF 的 rpc/system 目录下编写重试策略接口的 SPI 配置文件,文件名称为 com.salmon.fault.retry.RetryStrategy。
如图:
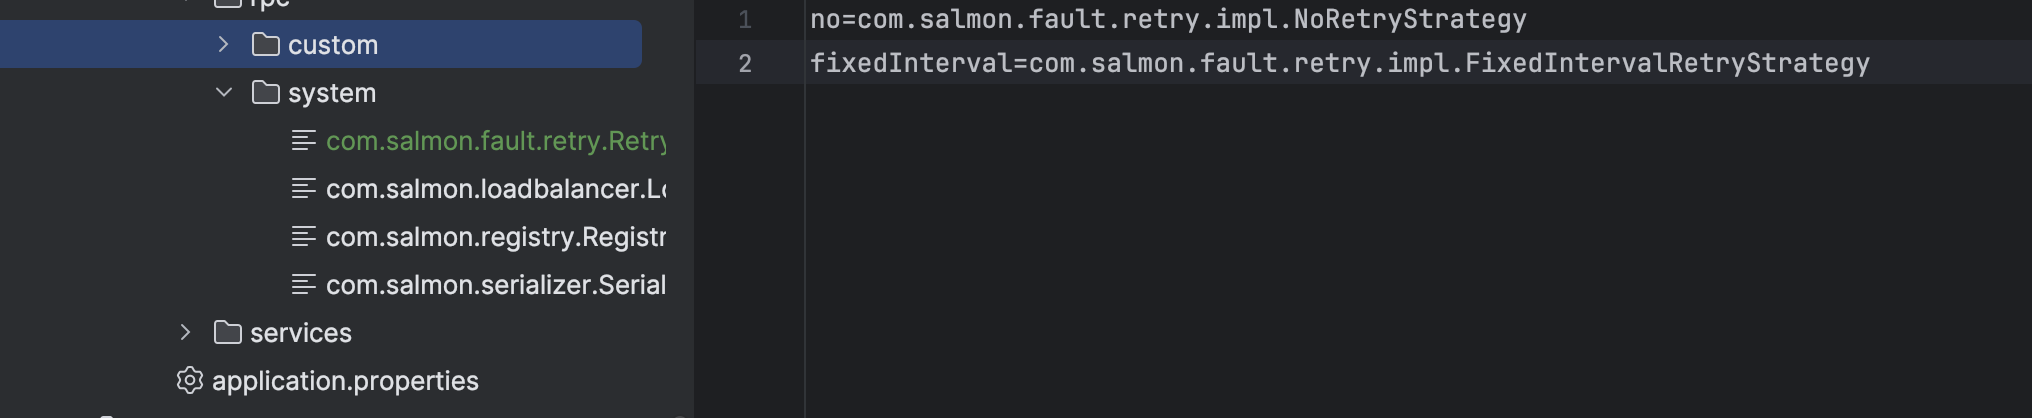
代码如下:
java
no=com.salmon.fault.retry.impl.NoRetryStrategy
fixedInterval=com.salmon.fault.retry.impl.FixedIntervalRetryStrategy
4)为 RpcConfig 全局配置新增重试策略的配置,代码如下:
java
package com.salmon.config;

import com.salmon.fault.retry.RetryStrategyKeys;
import com.salmon.loadbalancer.LoadBalancerKeys;
import com.salmon.serializer.SerializerKeys;
import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;

    /**
     * 序列化器
     */
    private String serializer = SerializerKeys.JDK;

    /**
     * 注册中心配置
     */
    private RegistryConfig registryConfig = new RegistryConfig();

    /**
     * 负载均衡器
     */
    private String loadBalancer = LoadBalancerKeys.ROUND_ROBIN;

    /**
     * 重试策略
     */
    private String retryStrategy = RetryStrategyKeys.NO;
}3、应用重试功能
现在,我们就能够愉快地使用重试功能了。修改 ServiceProxy 的代码,从工厂中获取重试器,并且将请求代码封装为一个 Callable 接口,作为重试器的参数,调用重试器即可。
修改的代码如下:
java
// rpc 请求
// 使用重试机制
RetryStrategy retryStrategy = RetryStrategyFactory.getInstance(rpcConfig.getRetryStrategy());
RpcResponse rpcResponse = retryStrategy.doRetry(() ->
        // 发送 TCP 请求
        VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo)
);
上述代码中,使用 Lambda 表达式将 VertxTcpClient.doRequest 封装为了一个匿名函数,简化了代码。
修改后的 ServiceProxy 的完整代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import cn.hutool.core.util.IdUtil;
import cn.hutool.http.HttpRequest;
import cn.hutool.http.HttpResponse;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.fault.retry.RetryStrategy;
import com.salmon.fault.retry.RetryStrategyFactory;
import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.loadbalancer.LoadBalancerFactory;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.protocol.*;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.serializer.Serializer;
import com.salmon.serializer.SerializerFactory;
import com.salmon.server.tcp.VertxTcpClient;
import io.vertx.core.Vertx;
import io.vertx.core.buffer.Buffer;
import io.vertx.core.net.NetClient;
import io.vertx.core.net.NetSocket;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;
import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.concurrent.CompletableFuture;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Slf4j
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();
        try {
            // 从注册中心获取服务提供者请求地址
            RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 获取到具体的注册中心实例
            Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
            // 获取该服务的所有节点
            List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
            if (CollUtil.isEmpty(serviceMetaInfoList)) {
                throw new RuntimeException("暂无服务地址");
            }

            // 负载均衡
            LoadBalancer loadBalancer = LoadBalancerFactory.getInstance(rpcConfig.getLoadBalancer());
            // 将调用方法名(请求路径)作为负载均衡参数
            Map<String, Object> requestParams = new HashMap<>();
            requestParams.put("methodName", rpcRequest.getMethodName());
            ServiceMetaInfo selectedServiceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);

            // rpc 请求
            // 使用重试机制
            RetryStrategy retryStrategy = RetryStrategyFactory.getInstance(rpcConfig.getRetryStrategy());
            RpcResponse rpcResponse = retryStrategy.doRetry(() ->
                    // 发送 TCP 请求
                    VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo)
            );
            return rpcResponse.getData();
        } catch (Exception e) {
            throw new RuntimeException("调用失败");
        }
    }
}我们会发现,即使引入了重试机制,整段代码并没有变得更复杂,这就是可扩展性设计的巧妙之处。
四、测试
首先启动服务提供者,然后使用 Debug 模式启动服务消费者,当服务消费者发起调用时,立刻停止服务提供者,就会看到调用失败后重试的情况。
五、扩展
1)新增更多不同类型的重试器。
参考思路:比如指数退避算法的重试器。
容错机制
一、需求分析
之前教程中,我们给 RPC 框架增加了重试机制,提升了服务消费端的可靠性和健壮性。
但如果重试超过了一定次数仍然失败,我们又该怎么处理呢?
或者说当调用出现失败时,我们一定要重试么?有没有其他的策略呢?
本节教程,将实现另一种提高服务消费端可靠性和健壮性的机制 —— 容错机制。
二、设计方案
容错机制
容错是指系统在出现异常情况时,可以通过一定的策略保证系统仍然稳定运行,从而提高系统的可靠性和健壮性。
在分布式系统中,容错机制尤为重要,因为分布式系统中的各个组件都可能存在网络故障、节点故障等各种异常情况。要顾全大局,尽可能消除偶发 / 单点故障对系统带来的整体影响。
打个比方,将分布式系统类比为一家公司,如果公司某个优秀员工请假了,需要 “触发容错”,让另一个普通员工顶上,这本质上是容错机制的一种 降级 策略。
容错机制一般都是在系统出现错误时才触发的,这点没什么好讲的,我们需要重点学习的是容错策略和容错实现方式。
容错策略
容错策略有很多种,常用的容错策略主要是以下几个:
1)Fail-Over 故障转移:一次调用失败后,切换一个其他节点再次进行调用,也算是一种重试。
2)Fail-Back 失败自动恢复:系统的某个功能出现调用失败或错误时,通过其他的方法,恢复该功能的正常。可以理解为降级,比如重试、调用其他服务等。
3)Fail-Safe 静默处理:系统出现部分非重要功能的异常时,直接忽略掉,不做任何处理,就像错误没有发生过一样。
4)Fail-Fast 快速失败:系统出现调用错误时,立刻报错,交给外层调用方处理。
容错实现方式
容错其实是个比较广泛的概念,除了上面几种策略外,很多技术都可以起到容错的作用。
比如:
1)重试:重试本质上也是一种容错的降级策略,系统错误后再试一次。
2)限流:当系统压力过大、已经出现部分错误时,通过限制执行操作(接受请求)的频率或数量,对系统进行保护。
3)降级:系统出现错误后,改为执行其他更稳定可用的操作。也可以叫做 “兜底” 或 “有损服务”,这种方式的本质是:即使牺牲一定的服务质量,也要保证系统的部分功能可用,保证基本的功能需求得到满足。
4)熔断:系统出现故障或异常时,暂时中断对该服务的请求,而是执行其他操作,以避免连锁故障。
5)超时控制:如果请求或操作长时间没处理完成,就进行中断,防止阻塞和资源占用。
注意,在实际项目中,根据对系统可靠性的需求,我们通常会结合多种策略或方法实现容错机制。
容错方案设计
回归到我们的 RPC 框架,之前已经给系统增加重试机制了,算是实现了一部分的容错能力。
现在,我们可以正式引入容错机制,通过更多策略来进一步增加系统可靠性。
容错方案的设计可以是很灵活的,建议大家先自己思考。
这里提供 2 种方案:
1)先容错再重试。
当系统发生异常时,首先会触发容错机制,比如记录日志、进行告警等,然后可以选择是否进行重试。
这种方案其实是把重试当做容错机制的一种可选方案。
2)先重试再容错。
在发生错误后,首先尝试重试操作,如果重试多次仍然失败,则触发容错机制,比如记录日志、进行告警等。
但其实大家能不能想到,这 2 种方案其实完全可以结合使用!
系统错误时,先通过重试操作解决一些临时性的异常,比如网络波动、服务端临时不可用等;如果重试多次后仍然失败,说明可能存在更严重的问题,这时可以触发其他的容错策略,比如调用降级服务、熔断、限流、快速失败等,来减少异常的影响,保障系统的稳定性和可靠性。
举个具体的例子:
- 系统调用服务 A 出现网络错误,使用容错策略 - 重试。
- 重试 3 次失败后,使用其他容错策略 - 降级。
- 系统改为调用不依赖网络的服务 B,完成操作。
下面将带大家实现这种方案。
三、开发实现
整个容错机制的实现方式几乎和重试机制一模一样,能力较强的同学可以先尝试自己实现。
1、多种容错策略实现
下面带大家实现 2 种最基本的容错策略:Fail-Fast 快速失败、Fail-Safe 静默处理。
在 RPC 项目中新建 fault.tolerant 包,将所有容错相关的代码放到该包下。
1)先编写容错策略通用接口。提供一个容错方法,使用 Map 类型的参数接受上下文信息(可用于灵活地传递容错处理需要用到的数据),并且接受一个具体的异常类参数。
由于容错是应用到发送请求操作的,所以容错方法的返回值是 RpcResponse(响应)。
代码如下:
java
package com.salmon.fault.tolerant;

import com.salmon.model.RpcResponse;

import java.util.Map;

/**
 * 容错策略
 *
 * @author Salmon
 * @since 2024-05-15
 */
public interface TolerantStrategy {

    /**
     * 容错
     *
     * @param context 上下文,用于传递数据
     * @param e       异常
     * @return rpc 响应
     */
    RpcResponse doTolerant(Map<String, Object> context, Exception e);
}2)快速失败容错策略实现。
很好理解,就是遇到异常后,将异常再次抛出,交给外层处理。
代码如下:
java
package com.salmon.fault.tolerant.impl;

import com.salmon.fault.tolerant.TolerantStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.Map;

/**
 * 快速失败 - 容错策略(立刻通知外层调用方)
 *
 * @author Salmon
 * @since 2024-05-15
 */
@Slf4j
public class FailFastTolerantStrategy implements TolerantStrategy {
    @Override
    public RpcResponse doTolerant(Map<String, Object> context, Exception e) {
        throw new RuntimeException("服务异常", e);
    }
}3)静默处理容错策略实现。
也很好理解,就是遇到异常后,记录一条日志,然后正常返回一个响应对象,就好像没有出现过报错。
代码如下:
java
package com.salmon.fault.tolerant.impl;

import com.salmon.fault.tolerant.TolerantStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.Map;

/**
 * 静默处理异常 - 容错策略
 *
 * @author Salmon
 * @since 2024-05-15
 */
@Slf4j
public class FailSafeTolerantStrategy implements TolerantStrategy {
    @Override
    public RpcResponse doTolerant(Map<String, Object> context, Exception e) {
        log.info("静默处理异常", e);
        return new RpcResponse();
    }
}4)其他容错策略。
还可以自行实现更多的容错策略,比如 FailBackTolerantStrategy 故障恢复策略:
java
package com.salmon.fault.tolerant.impl;

import com.salmon.fault.tolerant.TolerantStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.Map;

/**
 * 降级到其他服务 - 容错策略
 *
 * @author Salmon
 * @since 2024-05-15
 */
@Slf4j
public class FailBackTolerantStrategy implements TolerantStrategy {
    @Override
    public RpcResponse doTolerant(Map<String, Object> context, Exception e) {
        // todo 可自行扩展,获取降级的服务并调用
        return null;
    }
}还有 FailOverTolerantStrategy 故障转移策略:
java
package com.salmon.fault.tolerant.impl;

import com.salmon.fault.tolerant.TolerantStrategy;
import com.salmon.model.RpcResponse;
import lombok.extern.slf4j.Slf4j;

import java.util.Map;

/**
 * 转移到其他服务节点 - 容错策略
 *
 * @author Salmon
 * @since 2024-05-15
 */
@Slf4j
public class FailOverTolerantStrategy implements TolerantStrategy {
    @Override
    public RpcResponse doTolerant(Map<String, Object> context, Exception e) {
        // todo 可自行扩展,获取其他服务节点并调用
        return null;
    }
}当前的容错机制目录如下:
2、支持配置和扩展容错策略
一个成熟的 RPC 框架可能会支持多种不同的容错策略,像序列化器、注册中心、负载均衡器一样,我们的需求是,让开发者能够填写配置来指定使用的容错策略,并且支持自定义容错策略,让框架更易用、更利于扩展。
要实现这点,开发方式和序列化器、注册中心、负载均衡器都是一样的,都可以使用工厂创建对象、使用 SPI 动态加载自定义的注册中心。
1)容错策略常量。
在 fault.tolerant 包下新建 TolerantStrategyKeys 类,列举所有支持的容错策略键名。
代码如下:
java
package com.salmon.fault.tolerant;

/**
 * 容错策略键名常量
 *
 * @author Salmon
 * @since 2024-05-15
 */
public interface TolerantStrategyKeys {

    /**
     * 故障恢复
     */
    String FAIL_BACK = "failBack";

    /**
     * 快速失败
     */
    String FAIL_FAST = "failFast";

    /**
     * 故障转移
     */
    String FAIL_OVER = "failOver";

    /**
     * 静默处理
     */
    String FAIL_SAFE = "failSafe";
}2)使用工厂模式,支持根据 key 从 SPI 获取容错策略对象实例。
在 fault.tolerant 包下新建 TolerantStrategyFactory 类,代码如下:
java
package com.salmon.fault.tolerant;

import cn.hutool.core.util.StrUtil;
import com.salmon.fault.tolerant.impl.FailFastTolerantStrategy;
import com.salmon.spi.SpiLoader;

/**
 * 容错策略工厂(工厂模式,用于获取容错策略对象)
 *
 * @author Salmon
 * @since 2024-05-15
 */
public class TolerantStrategyFactory {

    static {
        SpiLoader.load(TolerantStrategy.class);
    }

    /**
     * 默认容错策略
     */
    private static final TolerantStrategy DEFAULT_TOLERANT_STRATEGY = new FailFastTolerantStrategy();

    /**
     * 获取容错策略实例
     *
     * @param key 容错策略键名
     * @return 指定的容错策略实现
     */
    public static TolerantStrategy getInstance(String key) {
        if (StrUtil.isBlank(key)) {
            return DEFAULT_TOLERANT_STRATEGY;
        }
        return SpiLoader.getInstance(TolerantStrategy.class, key);
    }

}这个类可以直接复制之前的 SerializerFactory,然后略做修改。可以发现,只要跑通了一次 SPI 机制,后续的开发就很简单了~
3)在 META-INF 的 rpc/system 目录下编写容错策略接口的 SPI 配置文件,文件名称为 com.salmon.fault.tolerant.TolerantStrategy。
如图:
代码如下:
properties
failBack=com.salmon.fault.tolerant.impl.FailBackTolerantStrategy
failFast=com.salmon.fault.tolerant.impl.FailFastTolerantStrategy
failOver=com.salmon.fault.tolerant.impl.FailOverTolerantStrategy
failSafe=com.salmon.fault.tolerant.impl.FailSafeTolerantStrategy
4)为 RpcConfig 全局配置新增容错策略的配置,代码如下:
java
package com.salmon.config;

import com.salmon.fault.retry.RetryStrategyKeys;
import com.salmon.fault.tolerant.TolerantStrategyKeys;
import com.salmon.loadbalancer.LoadBalancerKeys;
import com.salmon.serializer.SerializerKeys;
import lombok.Data;

/**
 * RPC 框架配置
 *
 * @author Salmon
 * @since 2024-05-02
 */
@Data
public class RpcConfig {

    /**
     * 名称
     */
    private String name = "salmon-rpc";

    /**
     * 版本号
     */
    private String version = "1.0";

    /**
     * 服务器主机名
     */
    private String serverHost = "localhost";

    /**
     * 服务器端口号
     */
    private Integer serverPort = 8080;

    /**
     * 模拟调用
     */
    private boolean mock = false;

    /**
     * 序列化器
     */
    private String serializer = SerializerKeys.JDK;

    /**
     * 注册中心配置
     */
    private RegistryConfig registryConfig = new RegistryConfig();

    /**
     * 负载均衡器
     */
    private String loadBalancer = LoadBalancerKeys.ROUND_ROBIN;

    /**
     * 重试策略
     */
    private String retryStrategy = RetryStrategyKeys.NO;

    /**
     * 容错策略
     */
    private String tolerantStrategy = TolerantStrategyKeys.FAIL_FAST;
}3、应用容错功能
容错功能的应用非常简单,我们只需要修改 ServiceProxy 的部分代码,在重试多次抛出异常时,从工厂中获取容错策略并执行即可。
修改的代码如下:
java
// rpc 请求
RpcResponse rpcResponse;
try {
    // 使用重试机制
    RetryStrategy retryStrategy = RetryStrategyFactory.getInstance(rpcConfig.getRetryStrategy());
    rpcResponse = retryStrategy.doRetry(() ->
            // 发送 TCP 请求
            VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo)
    );
} catch (Exception e) {
    // 使用容错机制
    TolerantStrategy tolerantStrategy = TolerantStrategyFactory.getInstance(rpcConfig.getTolerantStrategy());
    rpcResponse = tolerantStrategy.doTolerant(null, e);
}
return rpcResponse.getData();
修改后的 ServiceProxy 的完整代码如下:
java
package com.salmon.proxy;

import cn.hutool.core.collection.CollUtil;
import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.constant.RpcConstant;
import com.salmon.fault.retry.RetryStrategy;
import com.salmon.fault.retry.RetryStrategyFactory;
import com.salmon.fault.tolerant.TolerantStrategy;
import com.salmon.fault.tolerant.TolerantStrategyFactory;
import com.salmon.loadbalancer.LoadBalancer;
import com.salmon.loadbalancer.LoadBalancerFactory;
import com.salmon.model.RpcRequest;
import com.salmon.model.RpcResponse;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.server.tcp.VertxTcpClient;
import lombok.extern.slf4j.Slf4j;

import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

/**
 * 服务代理(JDK 动态代理)
 *
 * @author Salmon
 * @since 2024-04-26
 */
@Slf4j
public class ServiceProxy implements InvocationHandler {

    /**
     * 调用代理
     *
     * @param proxy  代理对象
     * @param method 当前执行的方法
     * @param args   方法的参数
     * @return 返回方法的运行结果
     * @throws Throwable 异常
     */
    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        // 构造请求
        String serviceName = method.getDeclaringClass().getName();
        RpcRequest rpcRequest = RpcRequest.builder()
                .serviceName(serviceName)
                .methodName(method.getName())
                .parameterTypes(method.getParameterTypes())
                .args(args)
                .build();

        // 从注册中心获取服务提供者请求地址
        RpcConfig rpcConfig = RpcApplication.getRpcConfig();
        // 获取到具体的注册中心实例
        Registry registry = RegistryFactory.getInstance(rpcConfig.getRegistryConfig().getRegistry());
        // 封装服务注册信息
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName(serviceName);
        serviceMetaInfo.setServiceVersion(RpcConstant.DEFAULT_SERVICE_VERSION);
        // 获取该服务的所有节点
        List<ServiceMetaInfo> serviceMetaInfoList = registry.serviceDiscovery(serviceMetaInfo.getServiceKey());
        if (CollUtil.isEmpty(serviceMetaInfoList)) {
            throw new RuntimeException("暂无服务地址");
        }

        // 负载均衡
        LoadBalancer loadBalancer = LoadBalancerFactory.getInstance(rpcConfig.getLoadBalancer());
        // 将调用方法名(请求路径)作为负载均衡参数
        Map<String, Object> requestParams = new HashMap<>();
        requestParams.put("methodName", rpcRequest.getMethodName());
        ServiceMetaInfo selectedServiceMetaInfo = loadBalancer.select(requestParams, serviceMetaInfoList);

        // rpc 请求
        RpcResponse rpcResponse;
        try {
            // 使用重试机制
            RetryStrategy retryStrategy = RetryStrategyFactory.getInstance(rpcConfig.getRetryStrategy());
            rpcResponse = retryStrategy.doRetry(() ->
                    // 发送 TCP 请求
                    VertxTcpClient.doRequest(rpcRequest, selectedServiceMetaInfo)
            );
        } catch (Exception e) {
            // 使用容错机制
            TolerantStrategy tolerantStrategy = TolerantStrategyFactory.getInstance(rpcConfig.getTolerantStrategy());
            rpcResponse = tolerantStrategy.doTolerant(null, e);
        }
        return rpcResponse.getData();
    }
}我们会发现,即使引入了容错机制,整段代码并没有变得更复杂,这就是可扩展性设计的巧妙之处。
四、测试
首先启动服务提供者,然后使用 Debug 模式启动服务消费者,当服务消费者发起调用时,立刻停止服务提供者,就会看到调用失败后重试的情况。等待多次重试后,就可以看到容错策略的执行。
五、扩展
1)实现 Fail-Back 容错机制。
参考思路:可以参考 Dubbo 的 Mock 能力,让消费端指定调用失败后要执行的本地服务和方法。
2)实现 Fail-Over 容错机制。
参考思路:可以利用容错方法的上下文参数传递所有的服务节点和本次调用的服务节点,选择一个其他节点再次发起调用。
3)实现更多容错方案。(较难)
参考思路:比如限流、熔断、超时控制等。或者将重试机制作为容错机制的一种策略来实现。
启动机制和注解驱动
一、需求分析
通过前面的教程,我们 RPC 框架的功能已经比较完善了,接下来我们就要思考如何优化这个框架。
框架是给开发者用的,让我们换位思考:如果你是一名开发者,会选择怎样的一款框架呢?
答案很简单,就是选择符合自身需求的呗!
往细了说,我会更关注框架的这些情况:
- 框架的知名度和用户数:尽量选主流的、用户多的,经过了充分的市场验证。
- 生态和社区活跃度:尽量选社区活跃的、能和其他技术兼容的。
- 简单易用易上手:最好能开箱即用,不用花很多时间去上手。这点可能是我们在做个人小型项目时最关注的,可以把精力聚焦到业务开发上。
选择框架的过程其实还有一个专业术语 —— 技术选型
回归到我们的 RPC 项目,其实框架目前是不够易用的。还记得么?光是我们的示例服务提供者,就要写下面这段又臭又长的代码!
java
package com.salmon;

import com.salmon.config.RegistryConfig;
import com.salmon.config.RpcConfig;
import com.salmon.impl.UserServiceImpl;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.LocalRegistry;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.server.HttpServer;
import com.salmon.server.tcp.VertxTcpServer;
import com.salmon.service.UserService;

/**
 * 简易服务提供者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ProviderExample {
    public static void main(String[] args) {
        // RPC 框架初始化
        RpcApplication.init();

        // 注册服务
        String serviceName = UserService.class.getName();
        LocalRegistry.registry(serviceName, UserServiceImpl.class);

        // 注册服务到注册中心
        RpcConfig rpcConfig = RpcApplication.getRpcConfig();
        RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
        // 获取注册中心实例
        Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());

        // 封装服务注册信息
        ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
        serviceMetaInfo.setServiceName(serviceName);
        serviceMetaInfo.setServiceHost(rpcConfig.getServerHost());
        serviceMetaInfo.setServicePort(rpcConfig.getServerPort());

        try {
            // 注册服务
            registry.register(serviceMetaInfo);
        } catch (Exception e) {
            throw new RuntimeException(e);
        }

        // 启动 TCP 服务
        HttpServer httpServer = new VertxTcpServer();
        httpServer.doStart(rpcConfig.getServerPort());
    }
}本节教程,我们就来优化框架的易用性,通过建立合适的启动机制和注解驱动机制,帮助开发者最少只用一行代码,就能轻松使用框架!
二、设计方案
让我们先来站在上帝视角,思考一下:怎么能让开发者用更少的代码启动框架?
启动机制设计
其实很简单,把所有启动代码封装成一个 专门的启动类 或方法,然后由服务提供者 / 服务消费者调用即可。
但有一点我们需要注意,服务提供者和服务消费者需要初始化的模块是不同的,比如服务消费者不需要启动 Web 服务器。
所以我们需要针对服务提供者和消费者分别编写一个启动类,如果是二者都需要初始化的模块,可以放到全局应用类 RpcApplication 中,复用代码的同时保证启动类的可维护、可扩展性。
在 Dubbo 中,就有类似的设计,参考文档:https://cn.dubbo.apache.org/zh-cn/overview/mannual/java-sdk/quick-start/api/。
注解驱动设计
除了启动类外,其实还有一种更牛的方法,能帮助开发者使用框架。
学过 Dubbo 这款 RPC 框架的同学应该会有印象,Dubbo 中是如何让开发者快速使用框架的呢?
它的做法是 注解驱动,开发者只需要在服务提供者实现类打上一个 DubboService 注解,就能快速注册服务;同样的,只要在服务消费者字段打上一个 DubboReference 注解,就能快速使用服务。
如图:
由于现在的 Java 项目基本都使用 Spring Boot 框架,所以 Dubbo 还贴心地推出了 Spring Boot Starter,用更少的代码在 Spring Boot 项目中使用框架。
参考文档:https://cn.dubbo.apache.org/zh-cn/overview/mannual/java-sdk/quick-start/spring-boot/
那我们也可以有样学样,创建一个 Spring Boot Starter 项目,并通过注解驱动框架的初始化,完成服务注册和获取引用。
实现注解驱动并不复杂,有 2 种常用的方式:
- 主动扫描:让开发者指定要扫描的路径,然后遍历所有的类文件,针对有注解的类文件,执行自定义的操作。
- 监听 Bean 加载:在 Spring 项目中,可以通过实现 BeanPostProcessor 接口,在 Bean 初始化后执行自定义的操作。
有了思路后,下面我们依次开发实现启动机制和注解驱动。
三、开发实现
启动机制
我们在 rpc 项目中新建包名 bootstrap,所有和框架启动初始化相关的代码都放到该包下。
服务提供者启动类
新建 ProviderBootstrap 类,先直接复制之前服务提供者示例项目中的初始化代码,然后略微改造,支持用户传入自己要注册的服务。
在注册服务时,我们需要填入多个字段,比如服务名称、服务实现类,参考代码如下:
java
// 注册服务
String serviceName = UserService.class.getName();
LocalRegistry.register(serviceName, UserServiceImpl.class);
我们可以将这些字段进行封装,在 model 包下新建 ServiceRegisterInfo 类,代码如下:
java
package com.salmon.model;

import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;

/**
 * 服务注册信息类
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Data
@AllArgsConstructor
@NoArgsConstructor
public class ServiceRegisterInfo<T> {

    /**
     * 服务名称
     */
    private String serviceName;

    /**
     * 实现类
     */
    private Class<? extends T> implClass;
}这样一来,服务提供者的初始化方法只需要接受封装的注册信息列表作为参数即可,简化了方法。
服务提供者完整代码如下:
java
package com.salmon.bootstrap;

import com.salmon.RpcApplication;
import com.salmon.config.RegistryConfig;
import com.salmon.config.RpcConfig;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.model.ServiceRegisterInfo;
import com.salmon.registry.LocalRegistry;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.server.HttpServer;
import com.salmon.server.tcp.VertxTcpServer;

import java.util.List;

/**
 * 服务提供者初始化
 *
 * @author Salmon
 * @since 2024-05-16
 */
public class ProviderBootstrap {

    /**
     * 初始化
     *
     * @param serviceRegisterInfoList 服务注册列表
     */
    public static void init(List<ServiceRegisterInfo<?>> serviceRegisterInfoList) {
        // RPC 框架初始化(配置和注册中心)
        RpcApplication.init();

        // 注册服务到注册中心
        final RpcConfig rpcConfig = RpcApplication.getRpcConfig();

        for (ServiceRegisterInfo<?> serviceRegisterInfo : serviceRegisterInfoList) {
            // 注册服务
            String serviceName = serviceRegisterInfo.getServiceName();
            // 本地注册
            LocalRegistry.registry(serviceName, serviceRegisterInfo.getImplClass());

            // 注册服务到注册中心
            RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
            // 获取注册中心实例
            Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());
            // 封装服务注册信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServiceName(serviceName);
            serviceMetaInfo.setServiceHost(rpcConfig.getServerHost());
            serviceMetaInfo.setServicePort(rpcConfig.getServerPort());
            try {
                // 注册服务
                registry.register(serviceMetaInfo);
            } catch (Exception e) {
                throw new RuntimeException(serviceName + " 服务注册失败", e);
            }
        }

        // 启动 TCP 服务
        HttpServer httpServer = new VertxTcpServer();
        httpServer.doStart(rpcConfig.getServerPort());
    }
}现在,我们想要在服务提供者项目中使用 RPC 框架,就非常简单了。只需要定义要注册的服务列表,然后一行代码调用 ProviderBootstrap.init 方法即可完成初始化。
示例代码如下:
java
package com.salmon;

import com.salmon.bootstrap.ProviderBootstrap;
import com.salmon.impl.UserServiceImpl;
import com.salmon.model.ServiceRegisterInfo;
import com.salmon.service.UserService;

import java.util.ArrayList;
import java.util.List;

/**
 * 简易服务提供者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ProviderExample {
    public static void main(String[] args) {
        // 要注册的服务
        List<ServiceRegisterInfo<?>> serviceRegisterInfoList = new ArrayList<>();
        ServiceRegisterInfo<UserService> objectServiceRegisterInfo = new ServiceRegisterInfo<>(UserService.class.getName(), UserServiceImpl.class);
        serviceRegisterInfoList.add(objectServiceRegisterInfo);

        // 服务提供者初始化
        ProviderBootstrap.init(serviceRegisterInfoList);
    }
}服务消费者启动类
服务消费者启动类的实现就更简单了,因为它不需要注册服务、也不需要启动 Web 服务器,只需要执行 RpcApplication.init 完成框架的通用初始化即可。
服务消费者启动类的完整代码如下:
java
package com.salmon.bootstrap;

import com.salmon.RpcApplication;

/**
 * 服务消费者启动类(初始化)
 *
 * @author Salmon
 * @since 2024-05-16
 */
public class ConsumerBootstrap {

    /**
     * 初始化
     */
    public static void init() {
        // RPC 框架初始化(配置和注册中心)
        RpcApplication.init();
    }
}目前的项目结构如图:
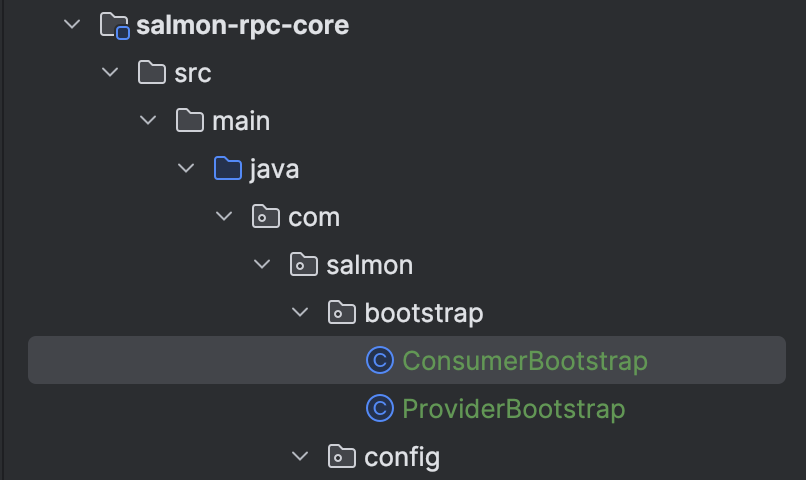
服务消费者示例项目的代码不会有明显的变化,只不过改为调用启动类了。
示例代码如下:
java
package com.salmon;

import com.salmon.bootstrap.ConsumerBootstrap;
import com.salmon.model.User;
import com.salmon.proxy.ServiceProxyFactory;
import com.salmon.service.UserService;

/**
 * 简易服务消费者示例
 *
 * @author Salmon
 * @since 2024-05-02
 */
public class ConsumerExample {
    public static void main(String[] args) {
        // 服务提供者初始化
        ConsumerBootstrap.init();
        // 获取代理
        UserService userService = ServiceProxyFactory.getProxy(UserService.class);
        User user = new User();
        user.setName("Salmon");
        // 调用
        User newUser = userService.getUser(user);
        if (newUser != null) {
            System.out.println(user.getName());
        } else {
            System.out.println("user == null");
        }
    }
}Spring Boot Starter 注解驱动
注意,为了便于大家学习,不要和已有项目的代码混淆,我们再来创建一个新的项目模块,专门用于实现 Spring Boot Starter 注解驱动的 RPC 框架。
Dubbo 是在框架内引入了 spring-context,会让整个框架更内聚,但是不利于学习理解。
1、Spring Boot Starter 项目初始化
在项目根目录(salmon-rpc)处右键新建模块:
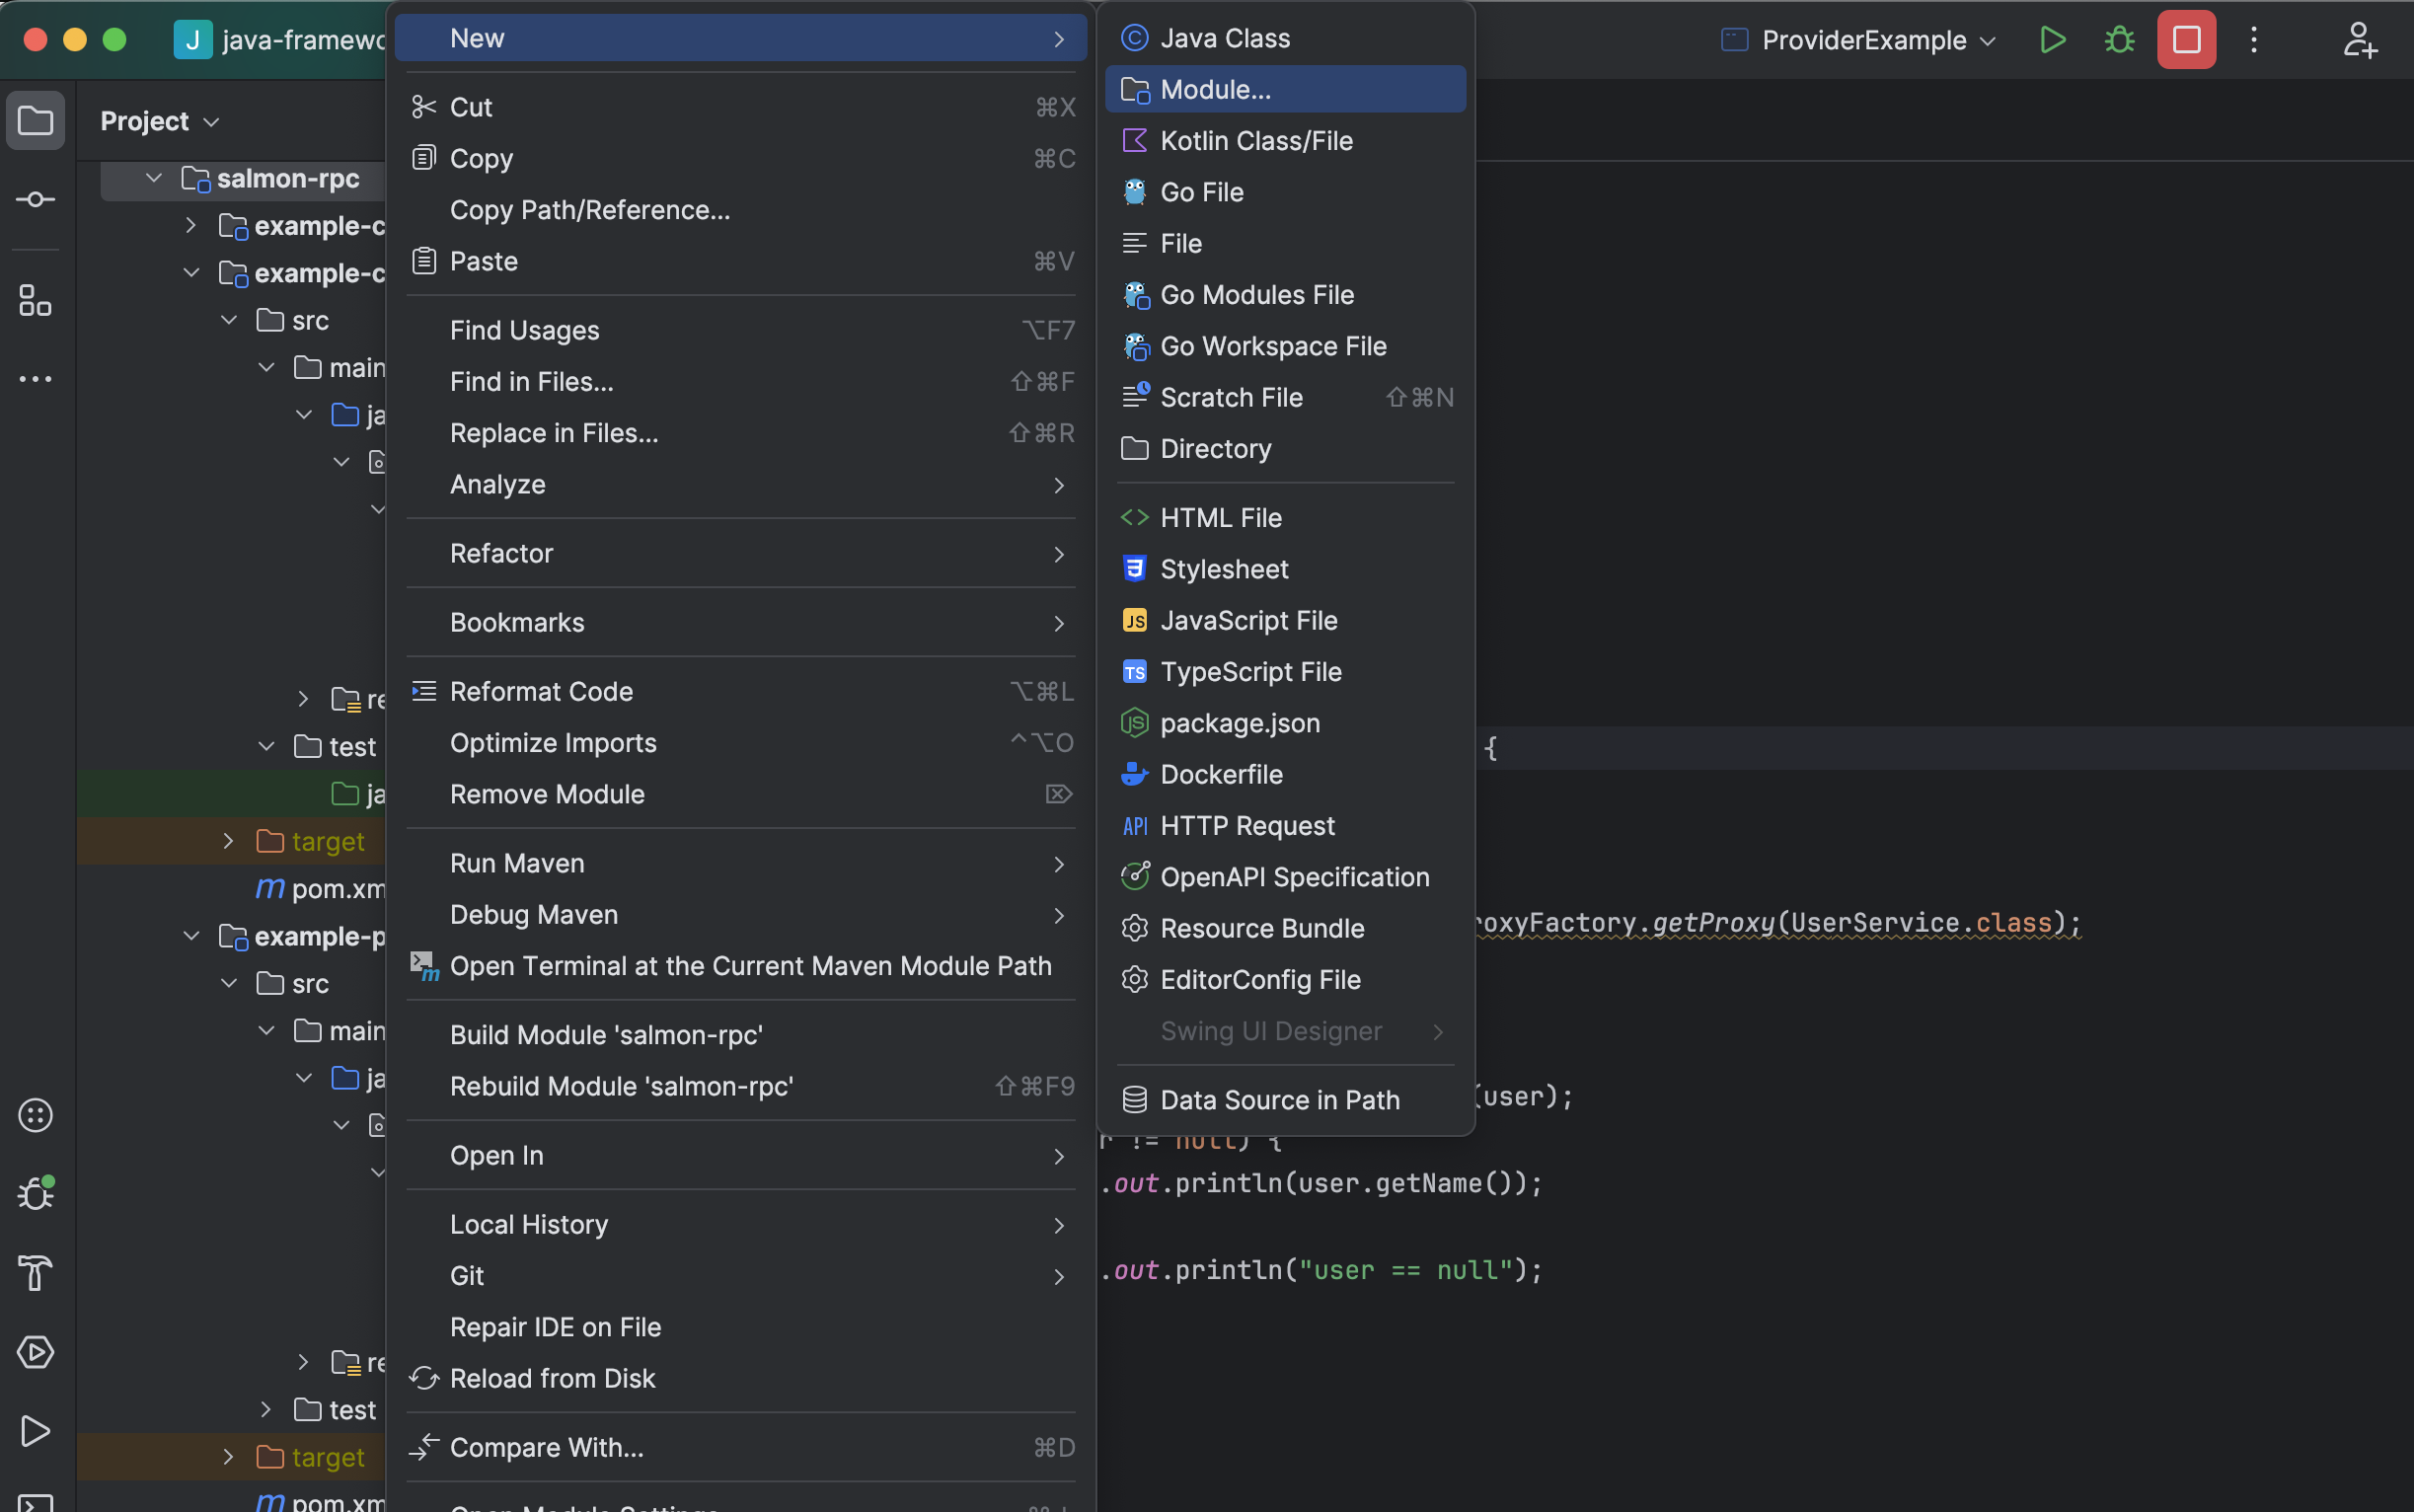
选择 Spring Initializr,将 Server URL 更改为 start.aliyun.com,然后创建一个名为 salmon-rpc-spring-boot-starter 的模块,JDK 和 Java 版本选择 >= 8 即可。
如下图:
选择 Spring Boot 版本为 2.6,项目依赖如下:
创建好模块后,修改 pom.xml 文件,移除无用的插件代码:
xml
<plugin>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-maven-plugin</artifactId>
    <version>${spring-boot.version}</version>
    <configuration>
        <mainClass>com.salmon.salmonrpcspringbootstarter.SalmonRpcSpringBootStarterApplication</mainClass>
        <skip>true</skip>
    </configuration>
    <executions>
        <execution>
            <id>repackage</id>
            <goals>
                <goal>repackage</goal>
            </goals>
        </execution>
    </executions>
</plugin>引入我们开发的 RPC 框架:
xml
<dependency>
    <groupId>com.salmon</groupId>
    <artifactId>salmon-rpc-core</artifactId>
    <version>1.0-SNAPSHOT</version>
</dependency>
至此,Spring Boot Starter 项目已经完成初始化。
2、定义注解
实现注解驱动的第一步是定义注解,要定义哪些注解呢?我们怎么知道应该定义哪些注解呢?
还是那句话,有样学样,可以参考知名框架 Dubbo 的注解。
比如:
- @EnableDubbo:在 Spring Boot 主应用类上使用,用于启用 Dubbo 功能。
- @DubboComponentScan:在 Spring Boot 主应用类上使用,用于指定 Dubbo 组件扫描的包路径。
- @DubboReference:在消费者中使用,用于声明 Dubbo 服务引用。
- @DubboService:在提供者中使用,用于声明 Dubbo 服务。
- @DubboMethod:在提供者和消费者中使用,用于配置 Dubbo 方法的参数、超时时间等。
- @DubboTransported:在 Dubbo 提供者和消费者中使用,用于指定传输协议和参数,例如传输协议的类型、端口等。
当然,这些注解我们不需要全部用到,遵循最小可用化原则,我们只需要定义 3 个注解。
在 salmon-rpc-spring-boot-starter 项目下新建 annotation 包,将所有注解代码放到该包下。
如下图:
1)@EnableRpc:用于全局标识项目需要引入 RPC 框架、执行初始化方法。
由于服务消费者和服务提供者初始化的模块不同,我们需要在 EnableRpc 注解中,指定是否需要启动服务器等属性。
代码如下:
java
package com.salmon.salmonrpc.springboot.starter.annotation;

import java.lang.annotation.ElementType;
import java.lang.annotation.Retention;
import java.lang.annotation.RetentionPolicy;
import java.lang.annotation.Target;

/**
 * 启用 Rpc 注解
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Target({ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
public @interface EnableRpc {

    /**
     * 需要启动 server
     */
    boolean needServer() default true;
}当然,你也可以将 EnableRpc 注解拆分为两个注解(比如 EnableRpcProvider、EnableRpcConsumer),分别用于标识服务提供者和消费者,但可能存在模块重复初始化的可能性。
2)@RpcService:服务提供者注解,在需要注册和提供的服务类上使用。
RpcService 注解中,需要指定服务注册信息属性,比如服务接口实现类、版本号等(也可以包括服务名称)。
代码如下:
java
package com.salmon.salmonrpc.springboot.starter.annotation;

import com.salmon.constant.RpcConstant;
import org.springframework.stereotype.Component;

import java.lang.annotation.ElementType;
import java.lang.annotation.Retention;
import java.lang.annotation.RetentionPolicy;
import java.lang.annotation.Target;

/**
 * 服务提供者注解(用于注册服务)
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Target({ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
@Component
public @interface RpcService {

    /**
     * 服务接口类
     */
    Class<?> interfaceClass() default void.class;

    /**
     * 版本号
     */
    String serviceVersion() default RpcConstant.DEFAULT_SERVICE_VERSION;
}3)@RpcReference:服务消费者注解,在需要注入服务代理对象的属性上使用,类似 Spring 中的 @Resource 注解。
RpcReference 注解中,需要指定调用服务相关的属性,比如服务接口类(可能存在多个接口)、版本号、负载均衡器、重试策略、是否 Mock 模拟调用等。
代码如下:
java
package com.salmon.salmonrpc.springboot.starter.annotation;

import com.salmon.constant.RpcConstant;
import com.salmon.fault.retry.RetryStrategyKeys;
import com.salmon.fault.tolerant.TolerantStrategyKeys;
import com.salmon.loadbalancer.LoadBalancerKeys;

import java.lang.annotation.ElementType;
import java.lang.annotation.Retention;
import java.lang.annotation.RetentionPolicy;
import java.lang.annotation.Target;

/**
 * 服务消费者注解(用于注入服务)
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Target({ElementType.FIELD})
@Retention(RetentionPolicy.RUNTIME)
public @interface RpcReference {

    /**
     * 服务接口类
     */
    Class<?> interfaceClass() default void.class;

    /**
     * 版本号
     */
    String serviceVersion() default RpcConstant.DEFAULT_SERVICE_VERSION;

    /**
     * 负载均衡器
     */
    String loadBalancer() default LoadBalancerKeys.ROUND_ROBIN;

    /**
     * 重试策略
     */
    String retryStrategy() default RetryStrategyKeys.NO;

    /**
     * 容错策略
     */
    String tolerantStrategy() default TolerantStrategyKeys.FAIL_FAST;

    /**
     * 模拟调用
     */
    boolean mock() default false;
}3、注解驱动
在 starter 项目中新建 bootstrap 包,并且分别针对上面定义的 3 个注解新建启动类。
项目的目录结构如图:
1)Rpc 框架全局启动类 RpcInitBootstrap。
我们的需求是,在 Spring 框架初始化时,获取 @EnableRpc 注解的属性,并初始化 RPC 框架。
怎么获取到注解的属性呢?
可以实现 Spring 的 ImportBeanDefinitionRegistrar 接口,并且在 registerBeanDefinitions 方法中,获取到项目的注解和注解属性。
完整代码如下:
java
package com.salmon.salmonrpc.springboot.starter.bootstrap;

import com.salmon.RpcApplication;
import com.salmon.config.RpcConfig;
import com.salmon.salmonrpc.springboot.starter.annotation.EnableRpc;
import com.salmon.server.tcp.VertxTcpServer;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.support.BeanDefinitionRegistry;
import org.springframework.context.annotation.ImportBeanDefinitionRegistrar;
import org.springframework.core.type.AnnotationMetadata;

/**
 * Rpc 框架启动
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Slf4j
public class RpcInitBootstrap implements ImportBeanDefinitionRegistrar {

    /**
     * Spring 初始化时执行,初始化 RPC 框架
     *
     * @param importingClassMetadata 导入类上的注解信息数据
     * @param registry               用于注册自定义的 bean 容器
     */
    @Override
    public void registerBeanDefinitions(AnnotationMetadata importingClassMetadata, BeanDefinitionRegistry registry) {
        // 获取 EnableRpc 注解的属性值
        boolean needServer = (boolean) importingClassMetadata.getAnnotationAttributes(EnableRpc.class.getName()).get("needServer");

        // RPC 框架初始化(配置和注册中心)
        RpcApplication.init();

        // 全局配置
        final RpcConfig rpcConfig = RpcApplication.getRpcConfig();

        // 启动服务器
        if (needServer) {
            VertxTcpServer vertxTcpServer = new VertxTcpServer();
            vertxTcpServer.doStart(rpcConfig.getServerPort());
        } else {
            log.info("不启动 server");
        }
    }
}上述代码中,我们从 Spring 元信息中获取到了 EnableRpc 注解的 needServer 属性,并通过它来判断是否要启动服务器。
2)Rpc 服务提供者启动类 RpcProviderBootstrap。
服务提供者启动类的作用是,获取到所有包含 @RpcService 注解的类,并且通过注解的属性和反射机制,获取到要注册的服务信息,并且完成服务注册。
怎么获取到所有包含 @RpcService 注解的类呢?
像前面设计方案中提到的,可以主动扫描包,也可以利用 Spring 的特性监听 Bean 的加载。
此处我们选择后者,实现更简单,而且能直接获取到服务提供者类的 Bean 对象。
只需要让启动类实现 BeanPostProcessor 接口的 postProcessAfterInitialization 方法,就可以在某个服务提供者 Bean 初始化后,执行注册服务等操作了。
完整代码如下:
java
package com.salmon.salmonrpc.springboot.starter.bootstrap;

import com.salmon.RpcApplication;
import com.salmon.config.RegistryConfig;
import com.salmon.config.RpcConfig;
import com.salmon.model.ServiceMetaInfo;
import com.salmon.registry.LocalRegistry;
import com.salmon.registry.Registry;
import com.salmon.registry.RegistryFactory;
import com.salmon.salmonrpc.springboot.starter.annotation.RpcService;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.BeansException;
import org.springframework.beans.factory.config.BeanPostProcessor;

/**
 * Rpc 服务提供者启动
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Slf4j
public class RpcProviderBootstrap implements BeanPostProcessor {

    /**
     * Bean 初始化后执行,注册服务
     *
     * @param bean     当前正在初始化的Bean对象
     * @param beanName 当前正在初始化的Bean的名称
     * @return 返回经过处理后的Bean对象
     * @throws BeansException BeansException
     */
    @Override
    public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
        Class<?> beanClass = bean.getClass();
        RpcService rpcService = beanClass.getAnnotation(RpcService.class);
        // 如果被标注为rpc服务
        if (rpcService != null) {
            // 需要注册的服务
            // 1. 获取服务基本信息
            Class<?> interfaceClass = rpcService.interfaceClass();
            // 默认值处理,如果未指定,获取该类所实现的接口
            if (interfaceClass == void.class) {
                interfaceClass = beanClass.getInterfaces()[0];
            }
            String serviceName = interfaceClass.getName();
            String serviceVersion = rpcService.serviceVersion();
            // 2. 注册服务
            // 本地注册
            LocalRegistry.registry(serviceName, beanClass);

            // 全局配置
            final RpcConfig rpcConfig = RpcApplication.getRpcConfig();
            // 注册服务到注册中心
            RegistryConfig registryConfig = rpcConfig.getRegistryConfig();
            // 获取指定的服务注册中心实例
            Registry registry = RegistryFactory.getInstance(registryConfig.getRegistry());
            // 封装服务注册元信息
            ServiceMetaInfo serviceMetaInfo = new ServiceMetaInfo();
            serviceMetaInfo.setServicePort(rpcConfig.getServerPort());
            serviceMetaInfo.setServiceHost(rpcConfig.getServerHost());
            serviceMetaInfo.setServiceVersion(serviceVersion);
            serviceMetaInfo.setServiceName(serviceName);
            try {
                registry.register(serviceMetaInfo);
            } catch (Exception e) {
                throw new RuntimeException(serviceName + " 服务注册失败", e);
            }
        }

        return BeanPostProcessor.super.postProcessAfterInitialization(bean, beanName);
    }
}其实上述代码中,绝大多数服务提供者初始化的代码都只需要从之前写好的启动类中复制粘贴,只不过换了一种参数获取方式罢了。
3)Rpc 服务消费者启动类 RpcConsumerBootstrap。
和服务提供者启动类的实现方式类似,在 Bean 初始化后,通过反射获取到 Bean 的所有属性,如果属性包含 @RpcReference 注解,那么就为该属性动态生成代理对象并赋值。
完整代码如下:
java
package com.salmon.salmonrpc.springboot.starter.bootstrap;

import com.salmon.proxy.ServiceProxyFactory;
import com.salmon.salmonrpc.springboot.starter.annotation.RpcReference;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.BeansException;
import org.springframework.beans.factory.config.BeanPostProcessor;

import java.lang.reflect.Field;

/**
 * Rpc 服务消费者启动
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Slf4j
public class RpcConsumerBootstrap implements BeanPostProcessor {

    @Override
    public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
        Class<?> beanClass = bean.getClass();
        // 获取该类上所有声明的属性
        Field[] declaredFields = beanClass.getDeclaredFields();
        for (Field field : declaredFields) {
            RpcReference rpcReference = field.getAnnotation(RpcReference.class);
            // 如果需要调用 rpc 服务
            if (rpcReference != null) {
                // 为属性生成代理对象
                Class<?> interfaceClass = rpcReference.interfaceClass();
                if (interfaceClass == void.class) {
                    interfaceClass = field.getType();
                }
                field.setAccessible(true);
                boolean mock = rpcReference.mock();
                Object proxyObject;
                if (!mock) {
                    proxyObject = ServiceProxyFactory.getProxy(interfaceClass);
                } else {
                    proxyObject = ServiceProxyFactory.getMockProxy(interfaceClass);
                }
                try {
                    field.set(bean, proxyObject);
                    field.setAccessible(false);
                } catch (IllegalAccessException e) {
                    throw new RuntimeException("为字段注入代理对象失败", e);
                }
            }
        }
        return BeanPostProcessor.super.postProcessAfterInitialization(bean, beanName);
    }
}上述代码中,核心方法是 beanClass.getDeclaredFields,用于获取类中的所有属性。看到这里的同学,必须要把反射的常用语法熟记于心了。
4)注册已编写的启动类。
最后,别忘了在 Spring 中加载我们已经编写好的启动类。
如何加载呢?
我们的需求是,仅在用户使用 @EnableRpc 注解时,才启动 RPC 框架。所以,可以通过给 EnableRpc 增加 @Import 注解,来注册我们自定义的启动类,实现灵活的可选加载。
修改后的 EnableRpc 注解代码如下:
java
package com.salmon.salmonrpc.springboot.starter.annotation;

import com.salmon.salmonrpc.springboot.starter.bootstrap.RpcConsumerBootstrap;
import com.salmon.salmonrpc.springboot.starter.bootstrap.RpcInitBootstrap;
import com.salmon.salmonrpc.springboot.starter.bootstrap.RpcProviderBootstrap;
import org.springframework.context.annotation.Import;

import java.lang.annotation.ElementType;
import java.lang.annotation.Retention;
import java.lang.annotation.RetentionPolicy;
import java.lang.annotation.Target;

/**
 * 启用 Rpc 注解
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Target({ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
@Import({RpcInitBootstrap.class, RpcProviderBootstrap.class, RpcConsumerBootstrap.class})
public @interface EnableRpc {

    /**
     * 需要启动 server
     */
    boolean needServer() default true;
}至此,一个基于注解驱动的 RPC 框架 Starter 开发完成。
四、测试
让我们使用 IDEA 新建 2 个使用 Spring Boot 2 框架的项目。
- 示例 Spring Boot 消费者:example-springboot-consumer
- 示例 Spring Boot 提供者:example-springboot-provider
项目的目录结构如下图:
每个项目都引入依赖:
xml
<dependency>
    <groupId>com.salmon</groupId>
    <artifactId>salmon-rpc-spring-boot-starter</artifactId>
    <version>1.0-SNAPSHOT</version>
</dependency>
<dependency>
    <groupId>com.salmon</groupId>
    <artifactId>example-common</artifactId>
    <version>1.0-SNAPSHOT</version>
</dependency>
1)示例服务提供者项目的入口类加上 @EnableRpc 注解,代码如下:
java
package com.salmon.examplespringbootprovider;

import com.salmon.salmonrpc.springboot.starter.annotation.EnableRpc;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
@EnableRpc
public class ExampleSpringbootProviderApplication {

    public static void main(String[] args) {
        SpringApplication.run(ExampleSpringbootProviderApplication.class, args);
    }

}
服务提供者提供一个简单的服务,代码如下:
java
package com.salmon.examplespringbootprovider;

import com.salmon.model.User;
import com.salmon.salmonrpc.springboot.starter.annotation.RpcService;
import com.salmon.service.UserService;
import org.springframework.stereotype.Service;

/**
 * 用户服务实现类
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Service
@RpcService
public class UserServiceImpl implements UserService {
    @Override
    public User getUser(User user) {
        System.out.println("用户名:" + user.getName());
        return user;
    }
}2)示例服务消费者的入口类加上 @EnableRpc(needServer = false) 注解,标识启动 RPC 框架,但不启动服务器。
代码如下:
java
package com.salmon.examplespringbootconsumer;

import com.salmon.salmonrpc.springboot.starter.annotation.EnableRpc;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
@EnableRpc(needServer = false)
public class ExampleSpringbootConsumerApplication {

    public static void main(String[] args) {
        SpringApplication.run(ExampleSpringbootConsumerApplication.class, args);
    }

}
消费者编写一个 Spring 的 Bean,引入 UserService 属性并打上 @RpcReference 注解,表示需要使用远程服务提供者的服务。
代码如下:
java
package com.salmon.examplespringbootconsumer;

import com.salmon.model.User;
import com.salmon.salmonrpc.springboot.starter.annotation.RpcReference;
import com.salmon.service.UserService;
import org.springframework.stereotype.Service;

/**
 * 测试 rpc 调用
 *
 * @author Salmon
 * @since 2024-05-16
 */
@Service
public class ExampleServiceImpl {

    @RpcReference
    private UserService userService;

    public void test() {
        User user = new User();
        user.setName("Salmon");
        User resultUser = userService.getUser(user);
        System.out.println(resultUser.getName());
    }
}服务消费者编写单元测试,验证能否调用远程服务:
java
package com.salmon.examplespringbootconsumer;

import org.junit.jupiter.api.Test;
import org.springframework.boot.test.context.SpringBootTest;

import javax.annotation.Resource;

@SpringBootTest
class ExampleSpringbootConsumerApplicationTests {

    @Resource
    private ExampleServiceImpl exampleService;

    @Test
    void contextLoads() {
        exampleService.test();
    }
}服务消费者的目录结构如图:
3)启动服务提供者入口类,如下图:
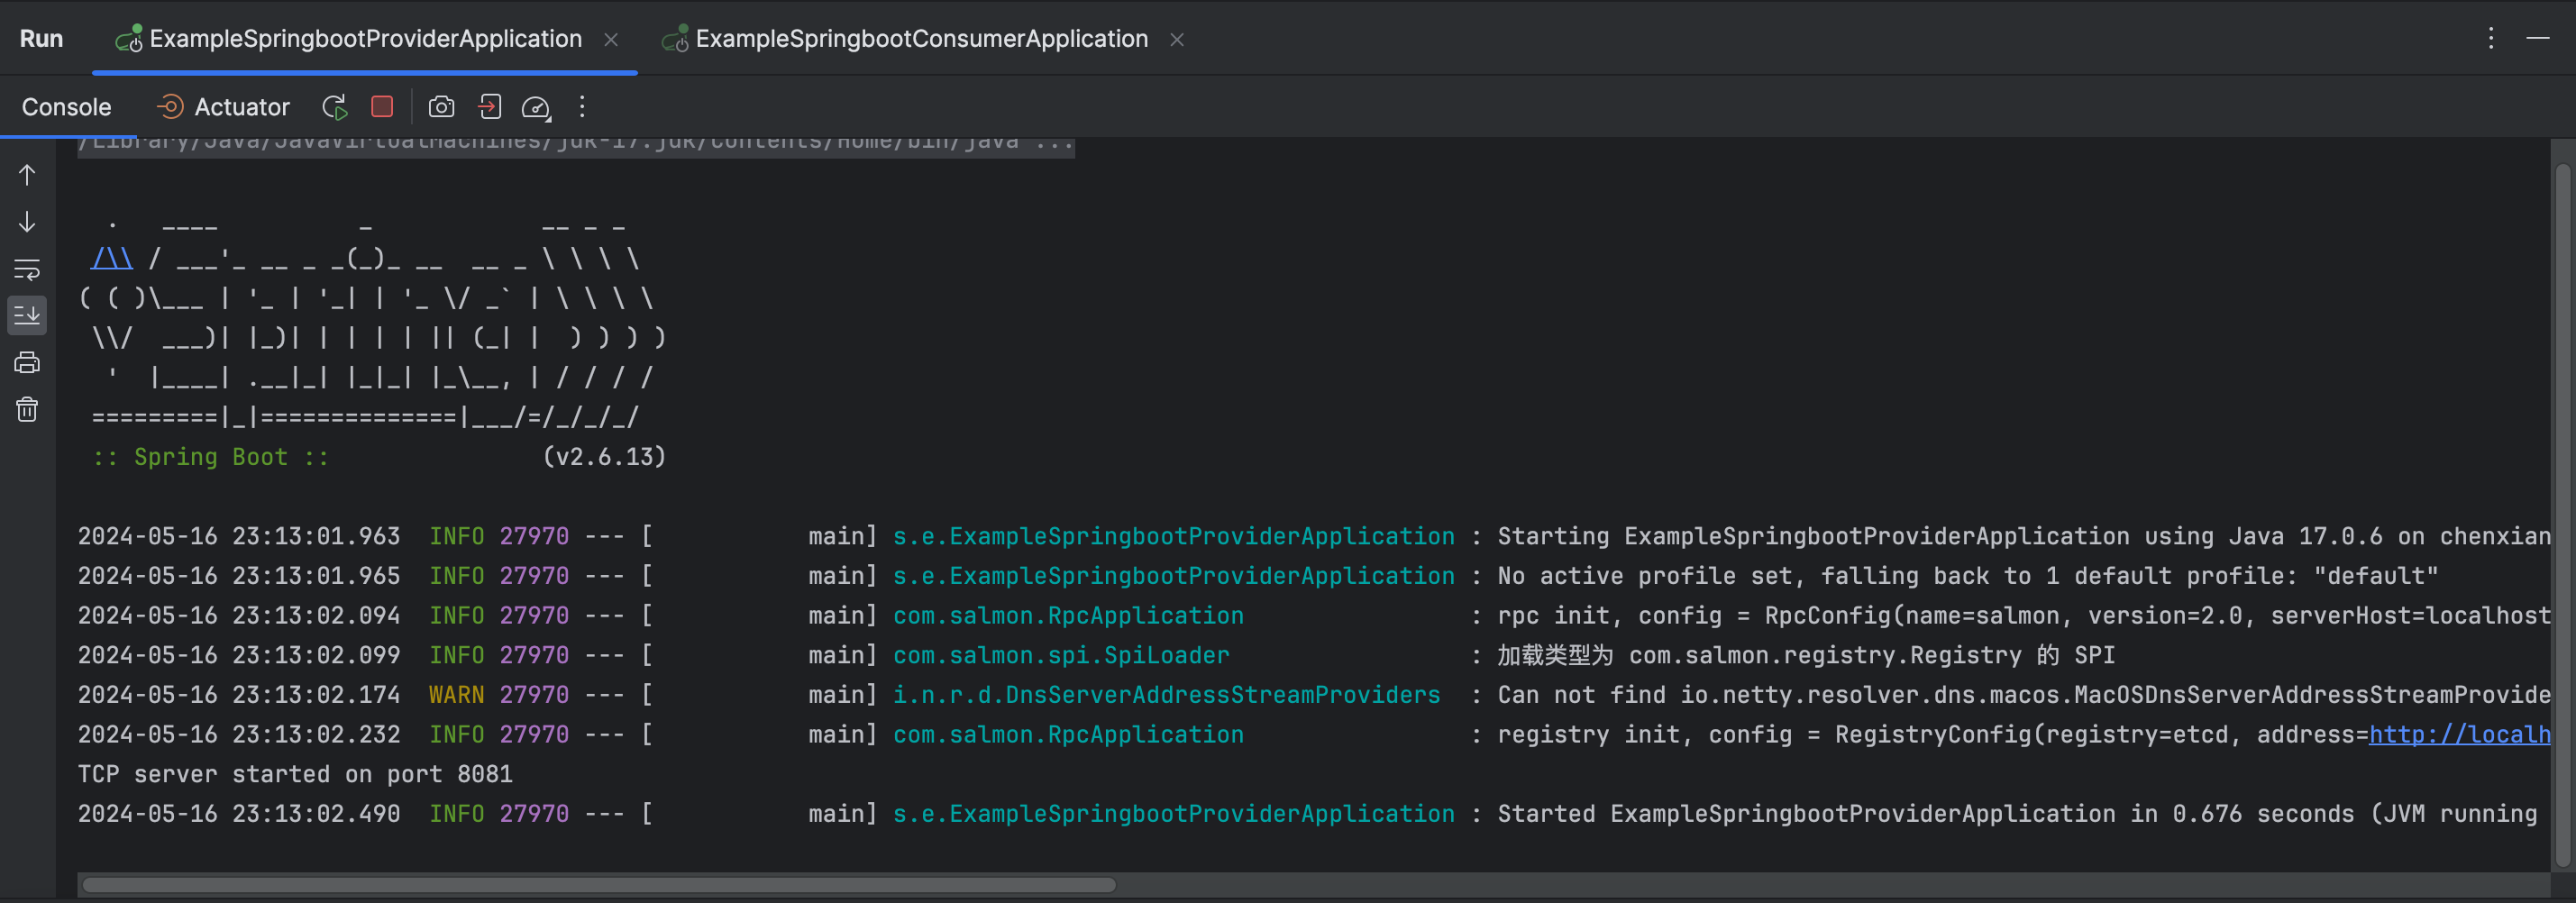
启动服务消费者的入口类,如下图:
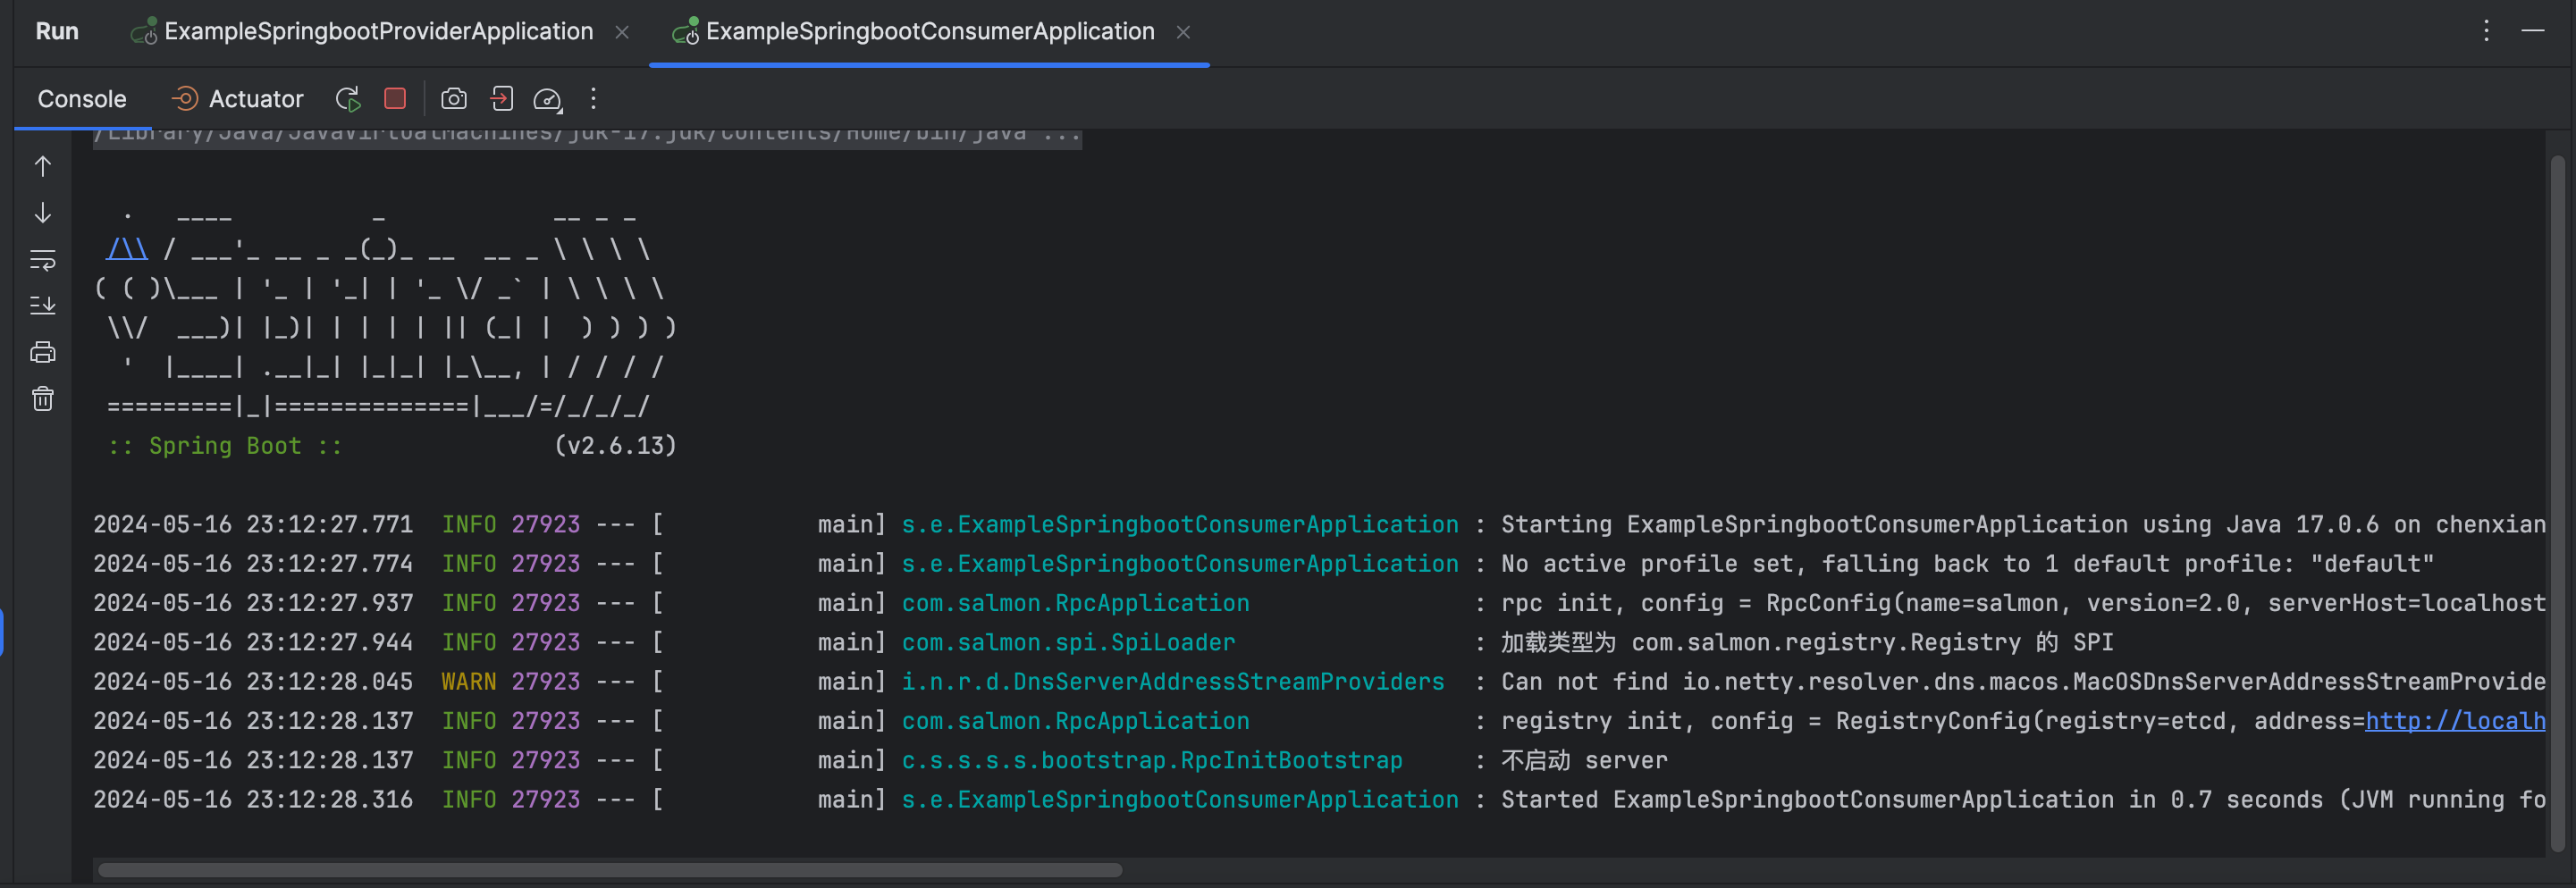
可以看到 server 并没有启动,符合预期。
最后,执行服务消费者的单元测试,验证能否跑通整个流程。
如下图,调用成功:
服务提供者也收到了调用:
至此,我们就能够通过使用注解的方式,轻松地给项目引入 RPC 框架了~
五、扩展
Spring Boot Starter 项目支持读取 yml / yaml 配置文件来启动 RPC 框架。
参考思路:像读取 properties 文件一样,提供一个工具类来读取 yml 配置。
服务提供者启动逻辑也可以改 bean 后置执行为 “使用组件扫描”。
扩展思路
1)RPC 请求类中支持携带参数列表,可用于安全校验等。
参考思路:比如服务提供者参数列表、服务消费者参数列表,服务端收到请求后可以根据参数列表中的值,判断如何进一步处理,比如在参数列表中携带 token 可以实现安全校验。
2)开发服务管理界面。
参考思路:类似 Nacos 注册中心面板,需要一定的前端基础。
3)项目支持读取 yml / yaml 等更多类型的配置文件,作为全局配置。
参考思路:仿照现有的 ConfigUtils 工具类,支持更多读取配置的方式,甚至可以使用 SPI 机制允许开发者二次扩展配置解析器。
4)实现拦截器机制,服务调用前和服务调用后可以执行额外的操作。
参考思路:可以参考 Spring MVC 或 Servlet 的 Filter 机制,使用责任链模式实现;可以在服务提供者处理前后、服务消费者调用前后增加拦截器,用于进行日志校验、安全校验等。还可以使用 SPI 机制,支持用户自定义拦截器。
5)自定义异常。
参考思路:自定义异常类 RpcException,根据业务区分错误码(ErrorCode),比如消费者异常、注册中心异常、提供者异常等,让报错更清晰明确。
6)服务支持指定版本号。
参考思路:虽然目前框架已经预留了版本字段,但都是默认值 1.0,还需要从服务提供者、再到消费者代理调用的一条完整路径上去应用版本号。
7)支持消费方指定某个服务级别的负载均衡器、重试策略、容错机制。
参考思路:目前只能通过全局配置改变对所有服务的负载均衡调用规则。实现的话可能需要修改 ServiceProxy 类,让它支持传参,根据消费端的配置来动态创建 ServiceProxy。
8)支持指定服务分组:服务提供者能够选择服务的分组,服务消费者能够使用指定分组的服务。(Dubbo 支持)
参考思路:目前框架仅仅是预留了服务分组字段,用默认值填充。还需要从服务提供者、再到消费者代理调用的一条完整路径上去应用服务分组。可以进一步实现多环境功能。
9)服务消费方支持设定超时时间。
参考思路:可以通过修改 TCP 客户端请求相关的代码实现。
10)处理 Bean 注入问题:目前本地服务注册表存储的是 class,然后通过反射创建实例,但是如果 Bean 包含有参构造函数,或者给属性注入了其他示例,这种方式就行不通了。
参考思路:本地注册时要放入实现类的对象实例,而不是 class 类型。
11)压力测试 RPC 框架的性能。
参考思路:通过 JMeter 等压力测试工具验证请求、响应的传输耗时和 QPS。
12)服务注册信息缓存优化,支持区分服务 key,而不是公用同一个缓存对象。
参考思路:目前的缓存实现是最简单的,但如果有多个服务,可能会冲突,可以使用 Map 等结构维护多个缓存信息。
13)服务注册信息缓存增加过期时间,定期刷新缓存。
参考思路:使用 Caffeine 构建缓存。
评论
1 条
这是我在学习过程中记录的笔记,希望对大家学习rpc框架有所帮助。<img src= 'https://media.salmonedu.ltd/blog//emoji/%E6%97%BA%E8%B4%A2%2860%20x%2060%29.png' width='24'height='24' style='margin: 0 1px;vertical-align: text-bottom'/>