记一次 Spring Cloud 微服务 Metaspace OOM 的排查经历
本文详细解析了一次 Spring Cloud 微服务因 Metaspac
1. 案发现场:突如其来的 CPU 告警
今天周末,突然收到阿里云发来的服务器警告短信。登录服务器一看,发现 CPU 占用率一直异常保持在 30% 左右,直觉告诉我肯定有某个微服务跑飞了。
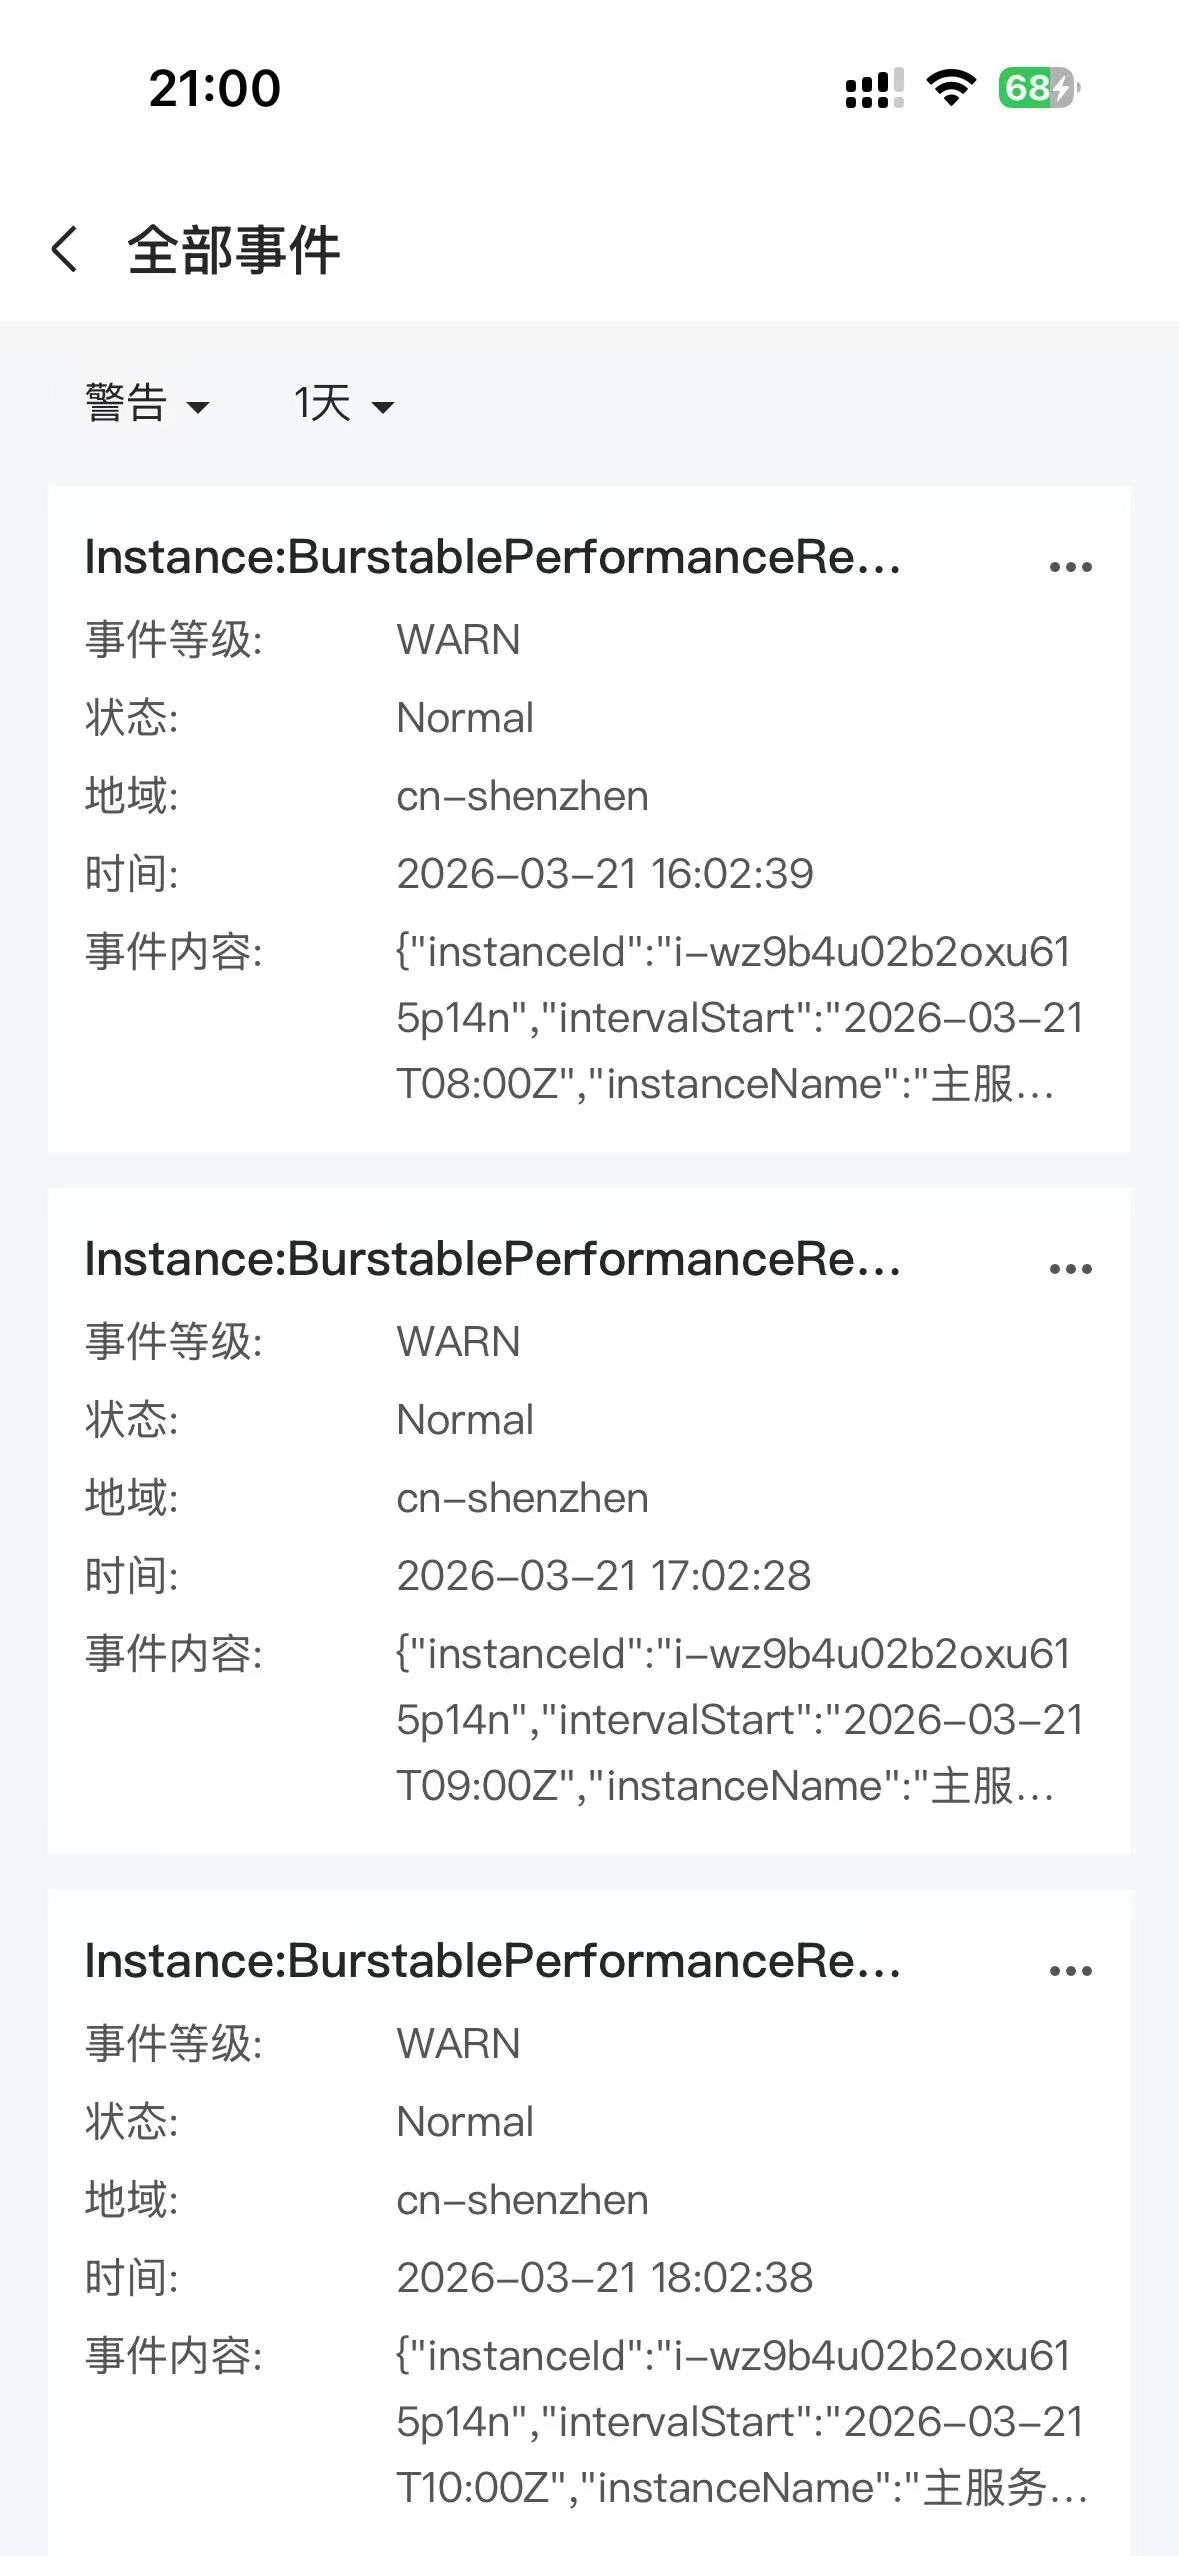
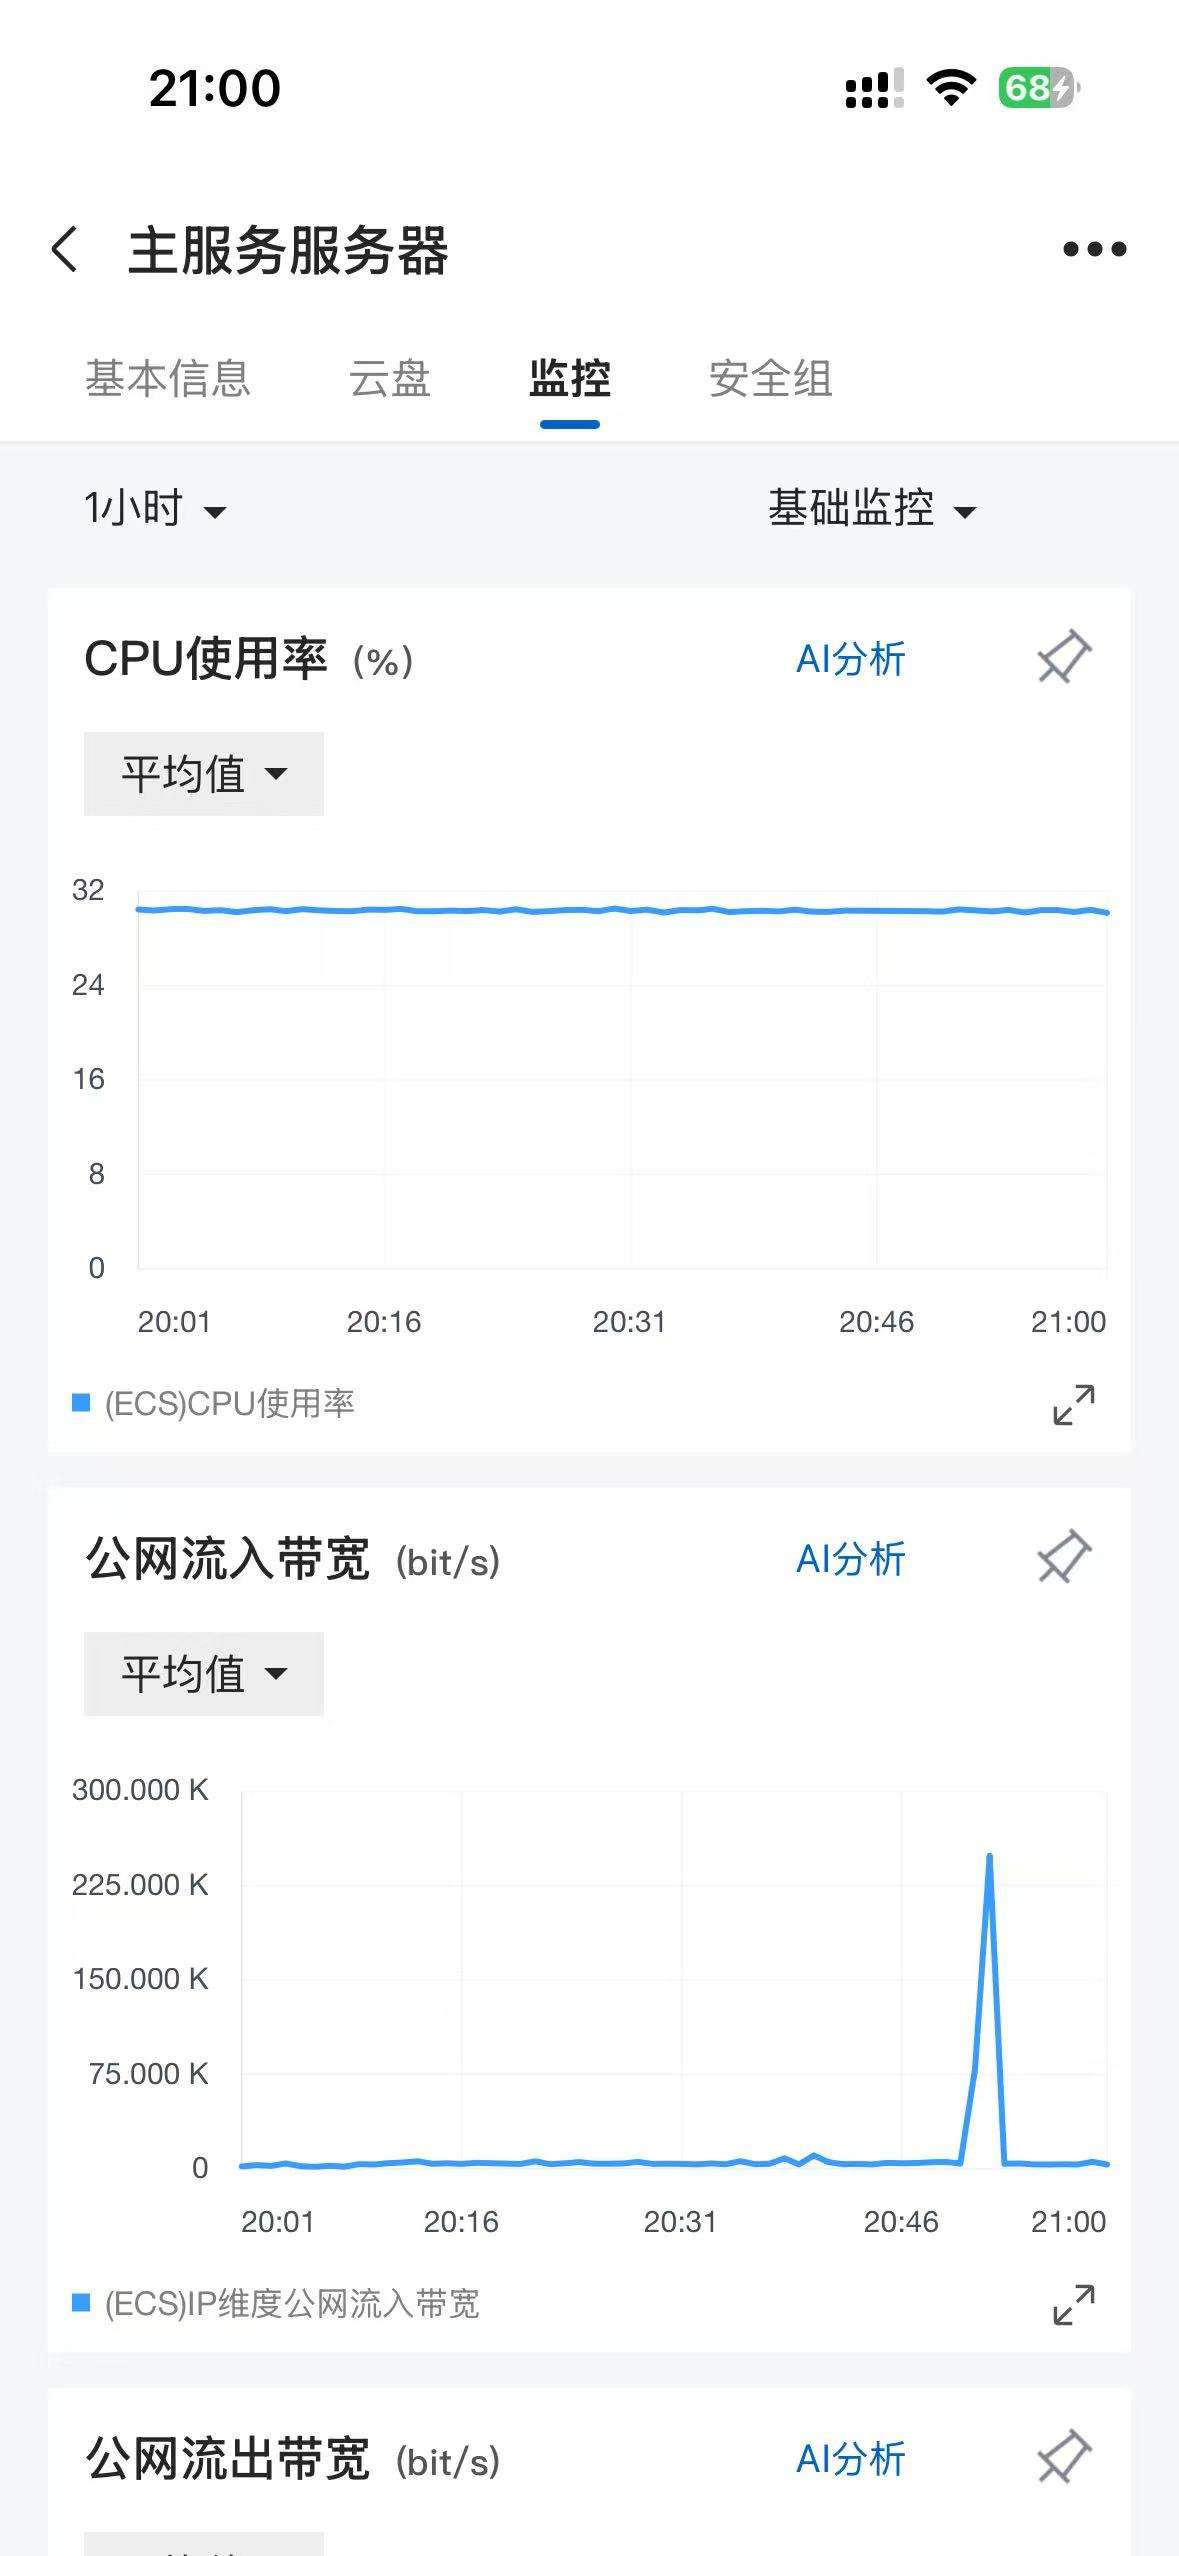
刚好昨天出于节省服务器计算资源的考虑,我把所有微服务的 JVM 内存限制做了一些下调。顺藤摸瓜排查,发现 Nacos 控制台中“博客服务(s-blog)”无法连接、健康检查失败。去服务器拉取了该服务的日志,果然看到了刺眼的 OutOfMemoryError:
bash
java.lang.OutOfMemoryError: Metaspace

2026-03-21 20:44:28.829  INFO Server healthy check fail, currentConnection = 1774002959720_172.25.116.135_56796
2026-03-21 20:44:43.835  WARN login failed, error:
java.lang.OutOfMemoryError: Metaspace
2026-03-21 20:44:51.864  INFO Server healthy check fail, currentConnection = 1774002959720_172.25.116.135_56796
2026-03-21 20:45:02.668 ERROR Execute listen config change error 报错非常硬核且明确:Metaspace(元空间)内存溢出。
2. 现场保留:获取 Dump 快照文件
万幸的是,我在部署服务编写 docker-compose.yml 时,习惯性地加上了 OOM 自动导出 Heap Dump 文件的 JVM 参数:
yaml
services:
  s-blog:
    image: s-blog
    volumes:
      - /mydata/projects/s-cloud/s-blog/logs:/usr/local/springboot/logs
    environment:
      JAVA_OPTS: >
        -Xms256m -Xmx384m -Xss256k -XX:MaxMetaspaceSize=256m -XX:+UseG1GC
        -XX:+HeapDumpOnOutOfMemoryError
        -XX:HeapDumpPath=/usr/local/springboot/logs
进入服务器的宿主机挂载目录一看,果然老老实实躺着一个新鲜生成的 .hprof 重金属快照文件。

直接通过 SCP 或各种 SSH 客户端,将这个大文件下载到本地电脑上,准备开始“解剖调查”。(分析工具如果你还没装,极力推荐前往官网下载 Eclipse MAT:https://eclipse.dev/mat/download/)
3. 查案第一步:新手最容易踩的“看错视图”陷阱
把 .hprof 拖进 MAT 工具加载完成后,我首先看到的是 Histogram(直方图)和 Dominator Tree(支配树)视图:
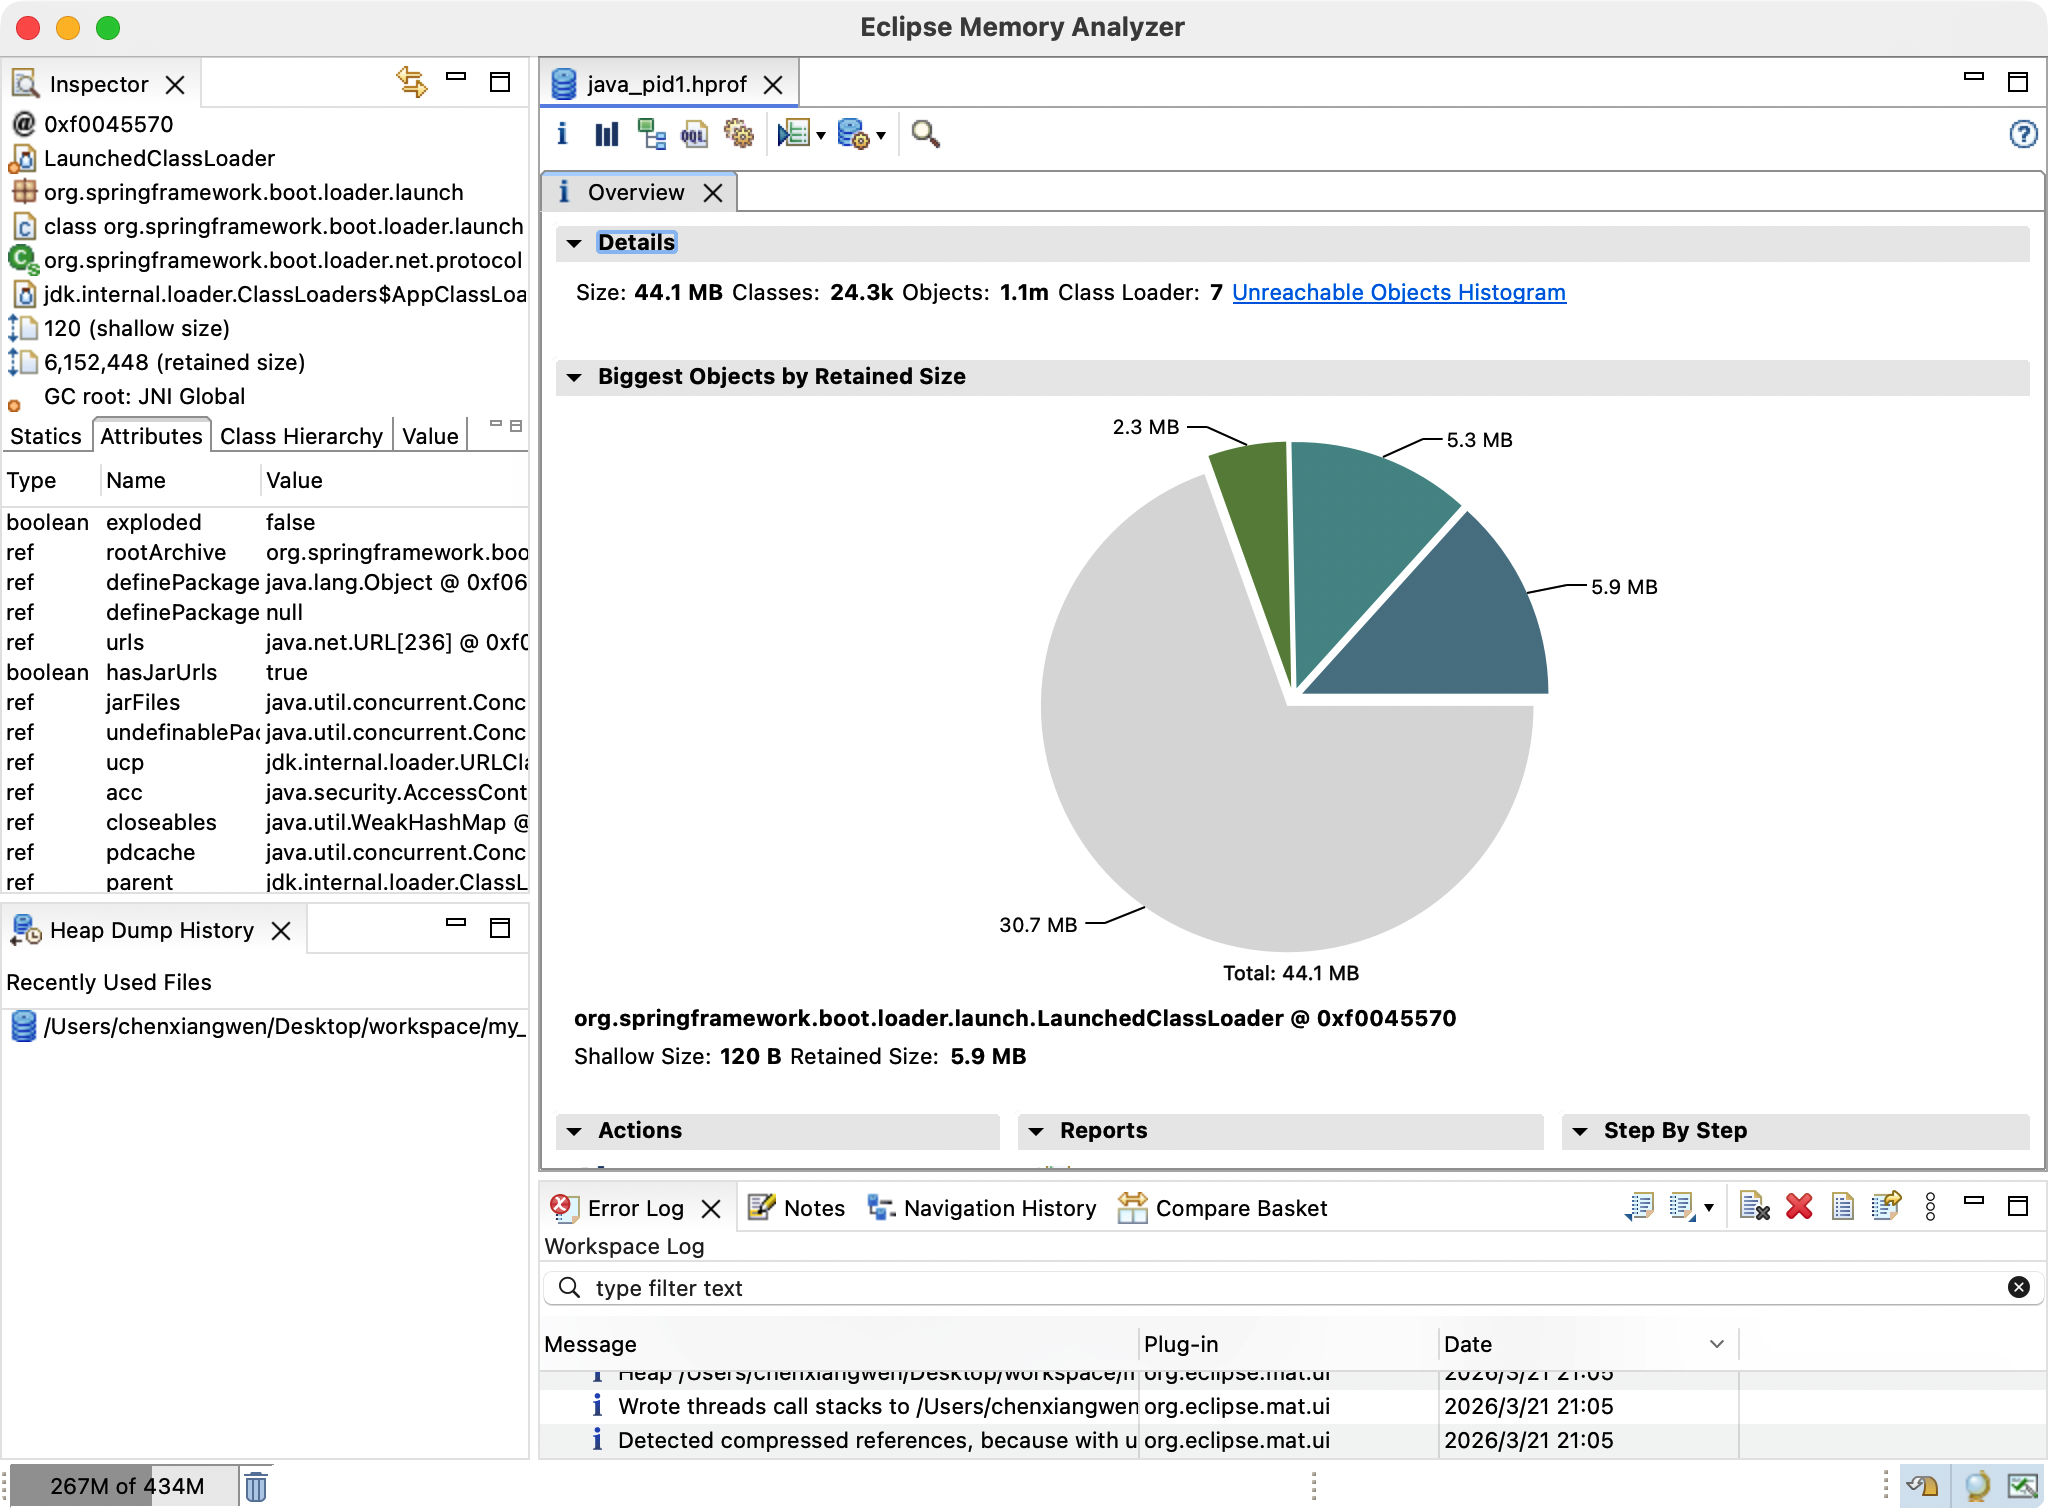
看到这个界面我的第一反应是:“这内存占用也不大呀?” 最大的对象 LaunchedClassLoader 这个实体也才占 6MB 左右的影响,整个堆内存存活对象更是少得可怜,离我设定的 -Xmx384m 堆内存上限还差得远呢!怎么就会 OOM?
划重点,这其实是所有人排查 Metaspace OOM 极其容易踩的坑!
“Java heap space OOM” 和 “Metaspace OOM” 在本质上是两码事。Histogram 等默认试图展示的是在**堆(Heap)**里的对象实例大小,而 Metaspace 存放的根本不是这些业务对象,而是类的蓝图——类元数据(Class Metadata)。我们在堆里寻找 Metaspace 的凶手,方向从一开始就全错了。
4. 锁定真凶:揪出隐藏在系统底层的庞大类群
既然是 Metaspace(元空间)溢出,我们必须将排查视角切换到:JVM 究竟加载了多少个 Class?
在 MAT 中正确的打开方式是:
- 在顶部菜单栏,找到一个带齿轮的放大镜图标(Open Query Browser),或者在菜单栏选择
Window->Query Browser。 - 在下拉菜单中选择 Java Basics -> Class Loader Explorer。
- 这时会弹出一个新标签页,重点观察列表里的
Defined Classes(定义的类数量) 这一列。
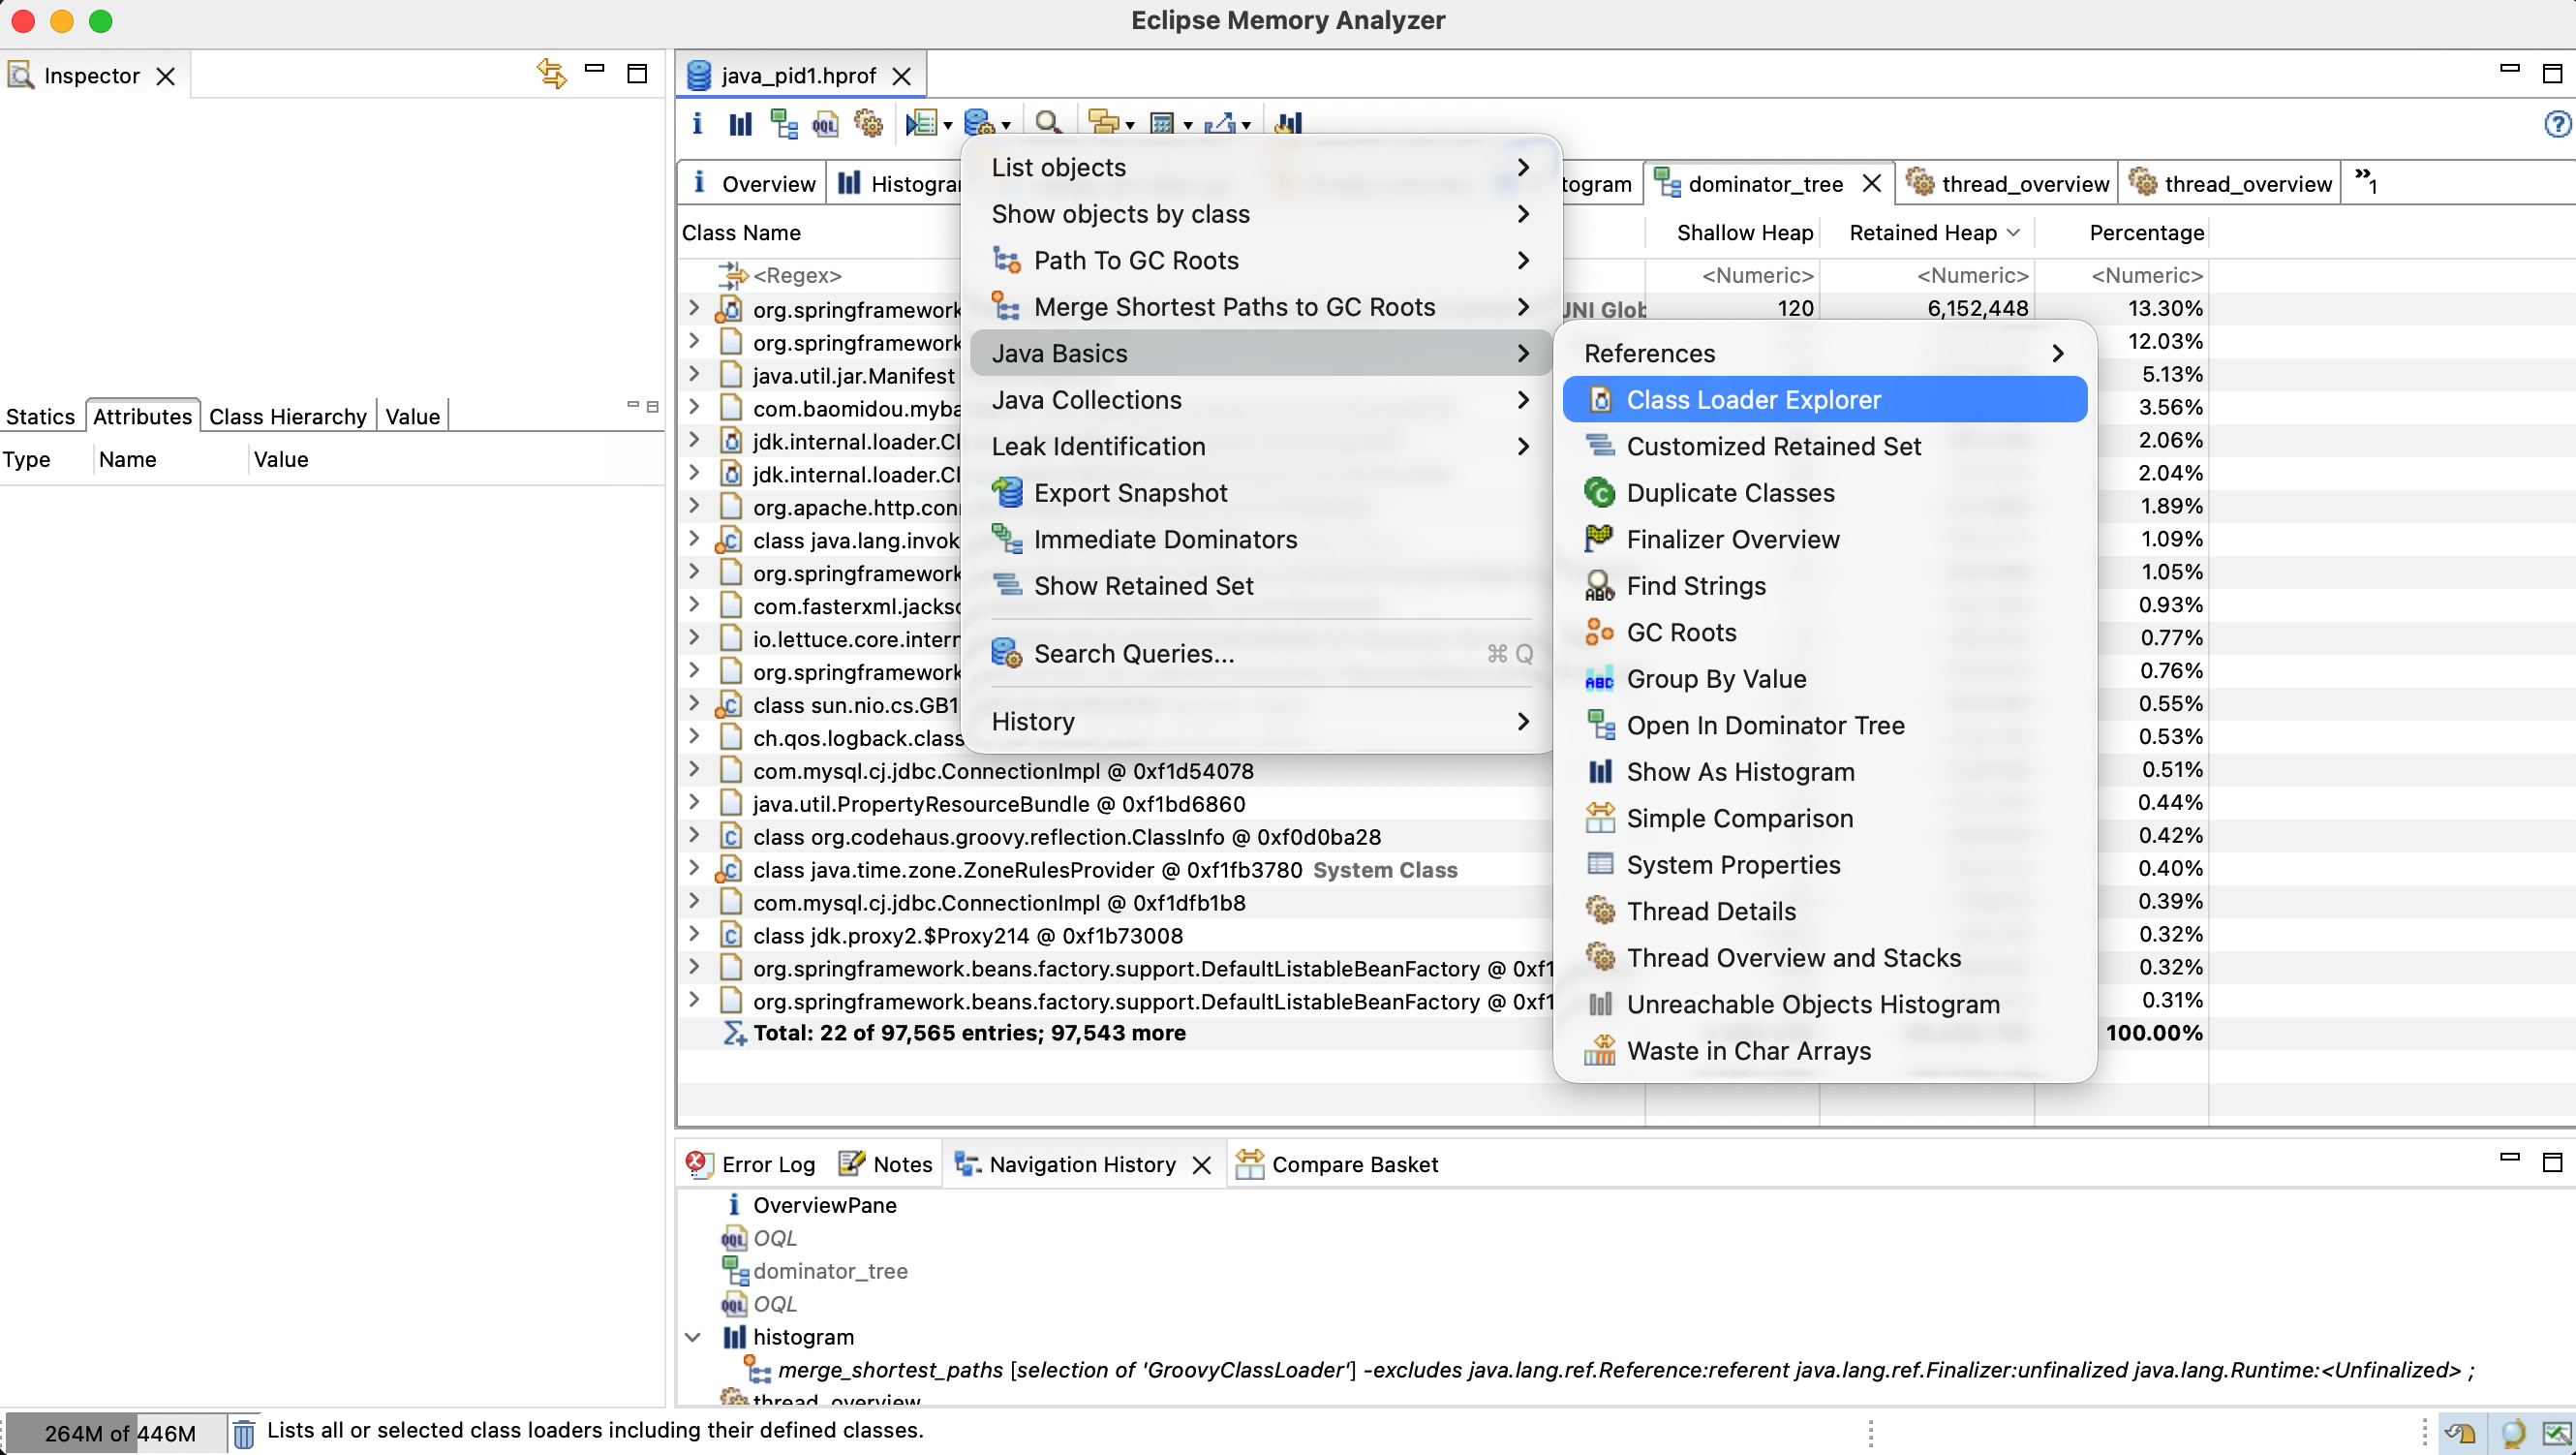
这一波操作后,水落石出:
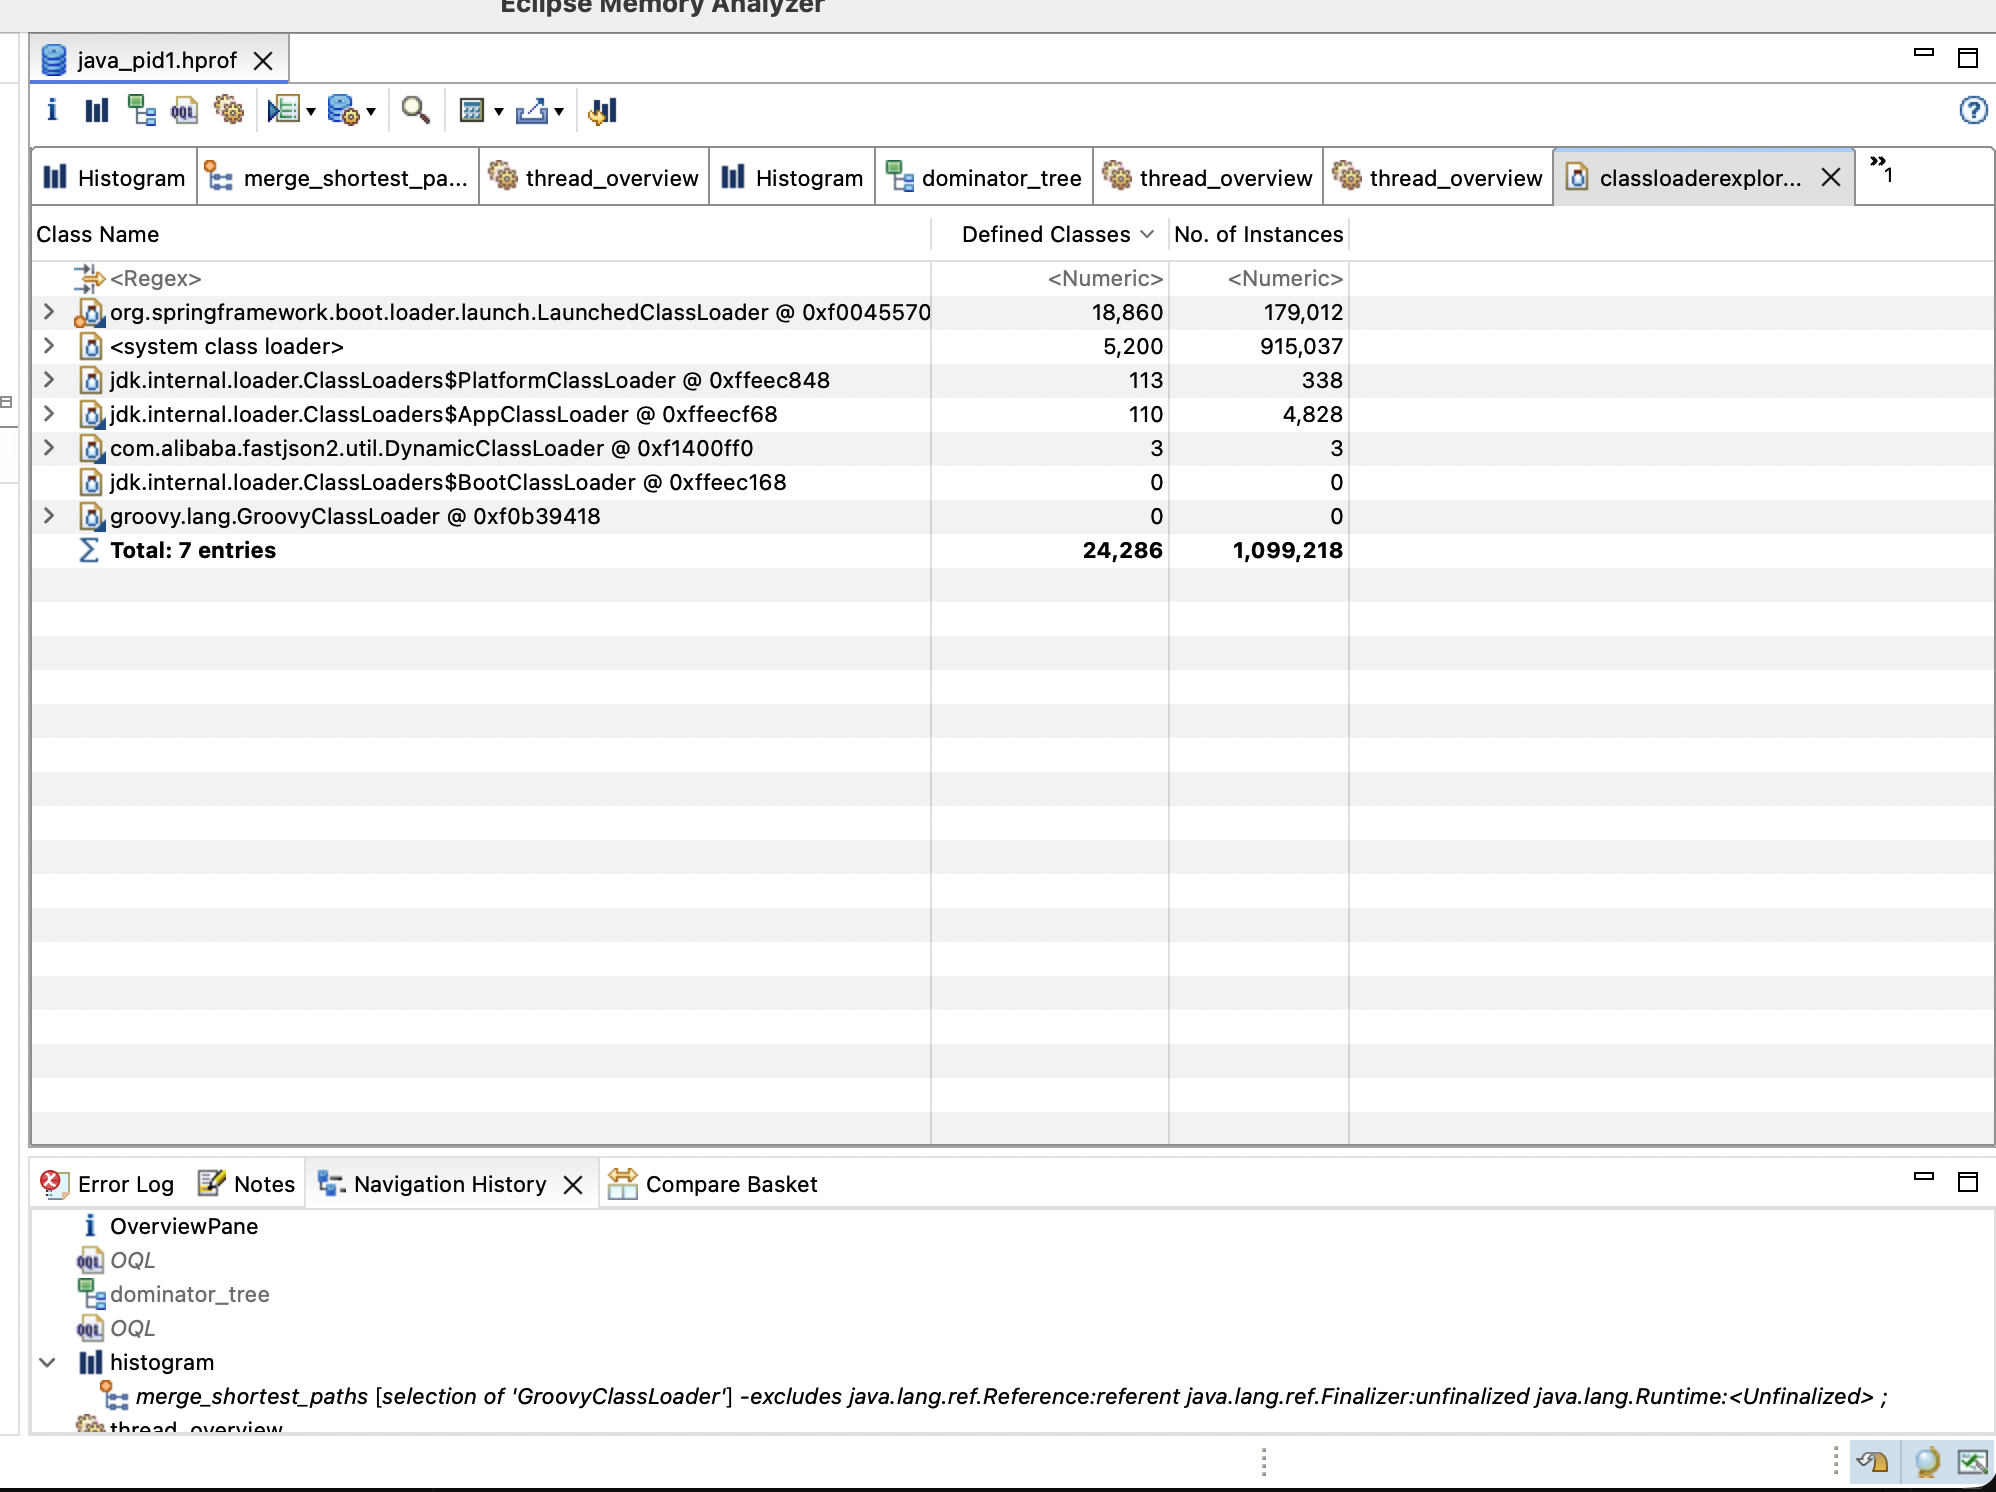
看图里触目惊心的核心数据:
<system class loader>(JDK 核心类库): 默默加载了 5,200 个基础类(如 String, List 以及底层原生类)。LaunchedClassLoader(Spring Boot 的主加载器): 你的应用代码加上 Nacos、Druid、RabbitMQ 等一大堆第三方组件,足足往虚拟机里塞进了 18,860 个类!
总计: 博客服务刚刚完成启动,根本没有开始接待任何高并发请求,就已经被迫往 Metaspace 里塞进去了 24,286 个 Class 的元信息!并且列表中只存活了 7 个类加载器,这排除了代码中因为反射、滥用 Groovy 脚本引发的无限生成新类的致命内存泄漏。
真相只有一个:不是内存泄漏,纯粹是加载的干货类太多了!
5. 数据计算与最终结论
为什么仅仅是微服务启动,256MB 的区域就会被毫不留情地撑爆?我们可以做个简单的算术题:
在现代 JVM 规范中,普通的 Java 业务代理类,加上它内部极其庞大的方法字节码、方法常量池、Spring 和 MyBatis 的各种反射注解信息,平均一个类在 Metaspace 大约会吃掉 8KB~12KB 的物理内存。
我们粗略换算一下:
24,286 个类 × 10KB ≈ 240+ MB。
这就完美解释了报错崩溃的真正原因。在这场事故里,没有任何一行代码写得烂,而是基于这套 Spring Cloud 架构的重量级服务,它的“出厂体重”就已经快达到 256MB 了。 我们昨天拍脑袋下调的那句 -XX:MaxMetaspaceSize=256m 几乎把程序逼到了窒息边缘,留给系统动态扩展与应对峰值的弹性余量为零。
6. 解决办法与排查总结
修复方案:
不需要改代码!直接进入 s-cloud/docker/compose/s-blog/docker-compose.yml,把启动参数的限制大胆放宽:
将 -XX:MaxMetaspaceSize=256m 修改为 -XX:MaxMetaspaceSize=512m。
重启服务后,世界恢复和平,监控曲线重回一条直线,彻底搞定。
本次实战避坑总结:
- 保留现场是一切的前提: JVM 启动参数一定要加上
-XX:+HeapDumpOnOutOfMemoryError,这是运维人员和后端的护身符。 - 对症下药: 很多工程师排查 Metaspace 溢出时,容易被 Heap 堆内那些几 MB、十兆的零星大对象误导。排查元空间,一定记得祭出
Class Loader Explorer,查出加载的到底是谁、有多少类。 - 敬畏框架的厚重感: 微服务架构虽好,但起步满天飞的代理类与动态生成极度吃内存,有时候不能单纯用单体应用的经验去“扣内存”。