Mysql优化
Sql优化是我们实际开发中需要掌握的技能,也是面试经常问的问题。我们首先得了解Mysql的架构设计,才能更好的理解与掌握该从哪些方面去进行优化更佳,之后我会从五个方向讲解优化。
Mysql逻辑架构
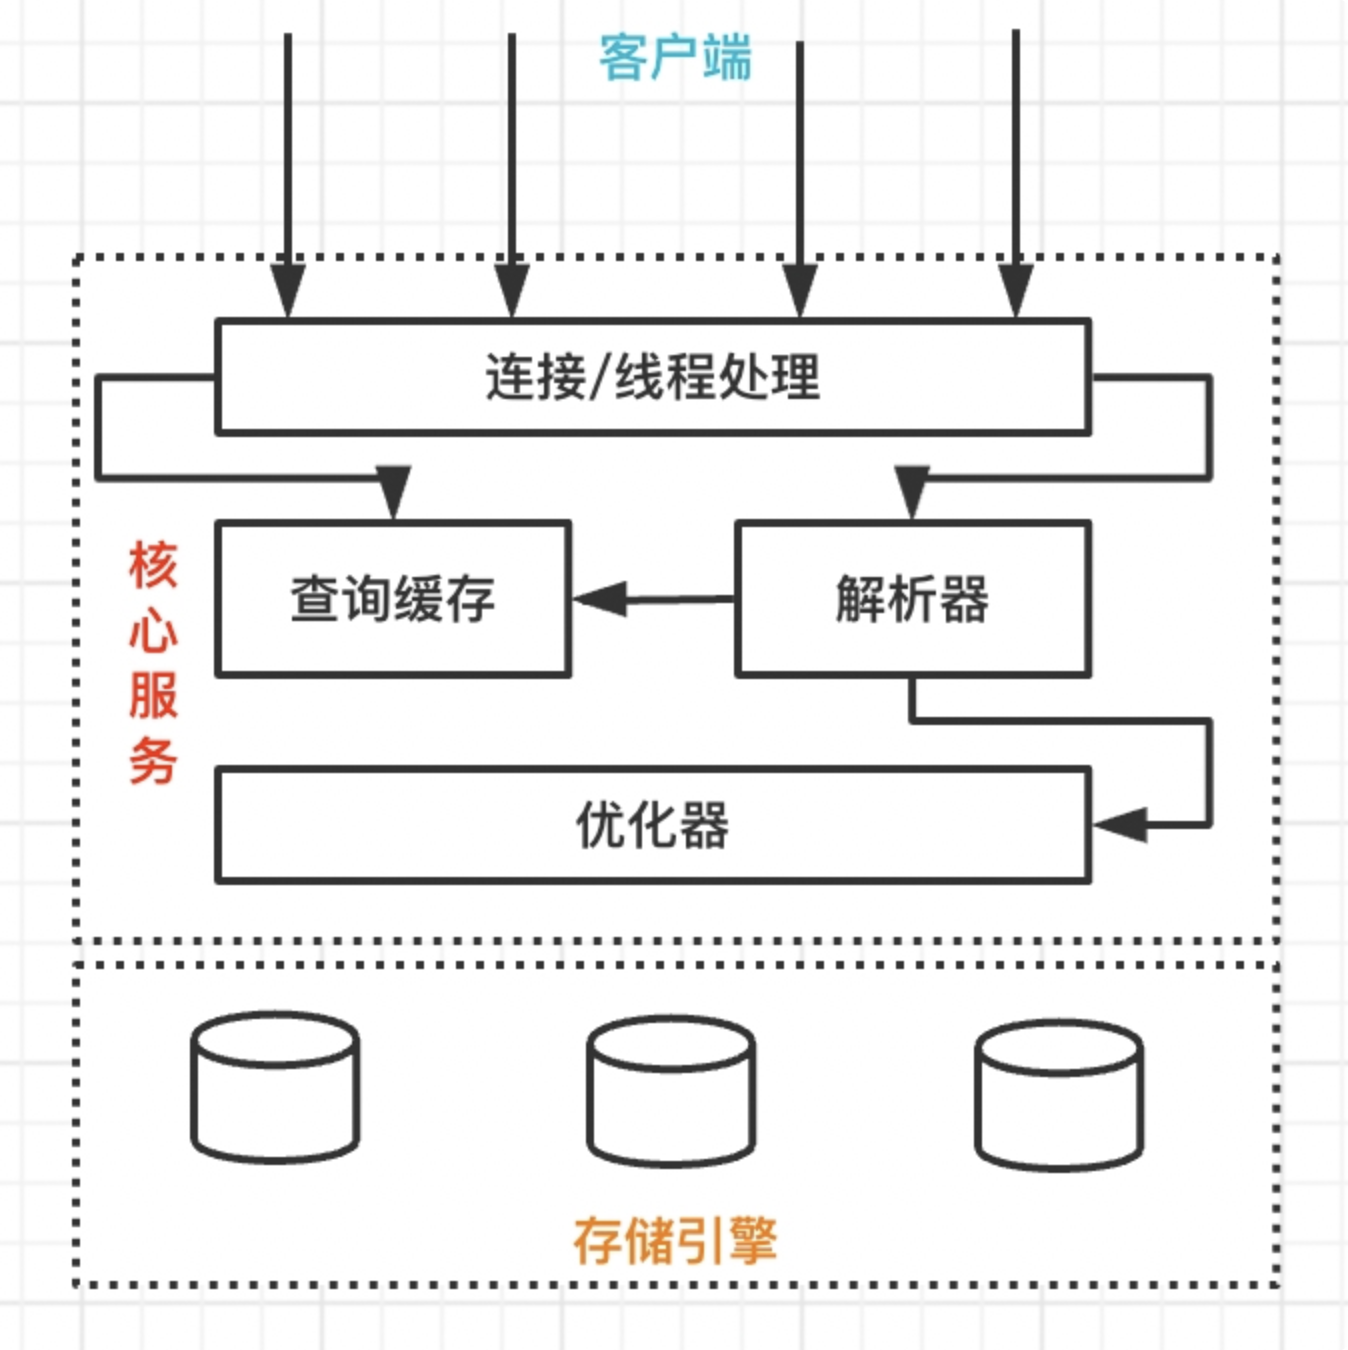
1、简介
MySQL逻辑架构整体分为三层,最上层为客户端层,并非MySQL所独有,诸如:连接处理、授权认证、安全等功能均在这一层处理。
MySQL大多数核心服务均在中间这一层,包括查询解析、分析、优化、缓存、内置函数(比如:时间、数学、加密等函数)。所有的跨存储引擎的功能也在这一层实现:存储过程、触发器、视图等。
最下层为存储引擎,其负责MySQL中的数据存储和提取。和Linux下的文件系统类似,每种存储引擎都有其优势和劣势。中间的服务层通过API与存储引擎通信,这些API接口屏蔽了不同存储引擎间的差异。
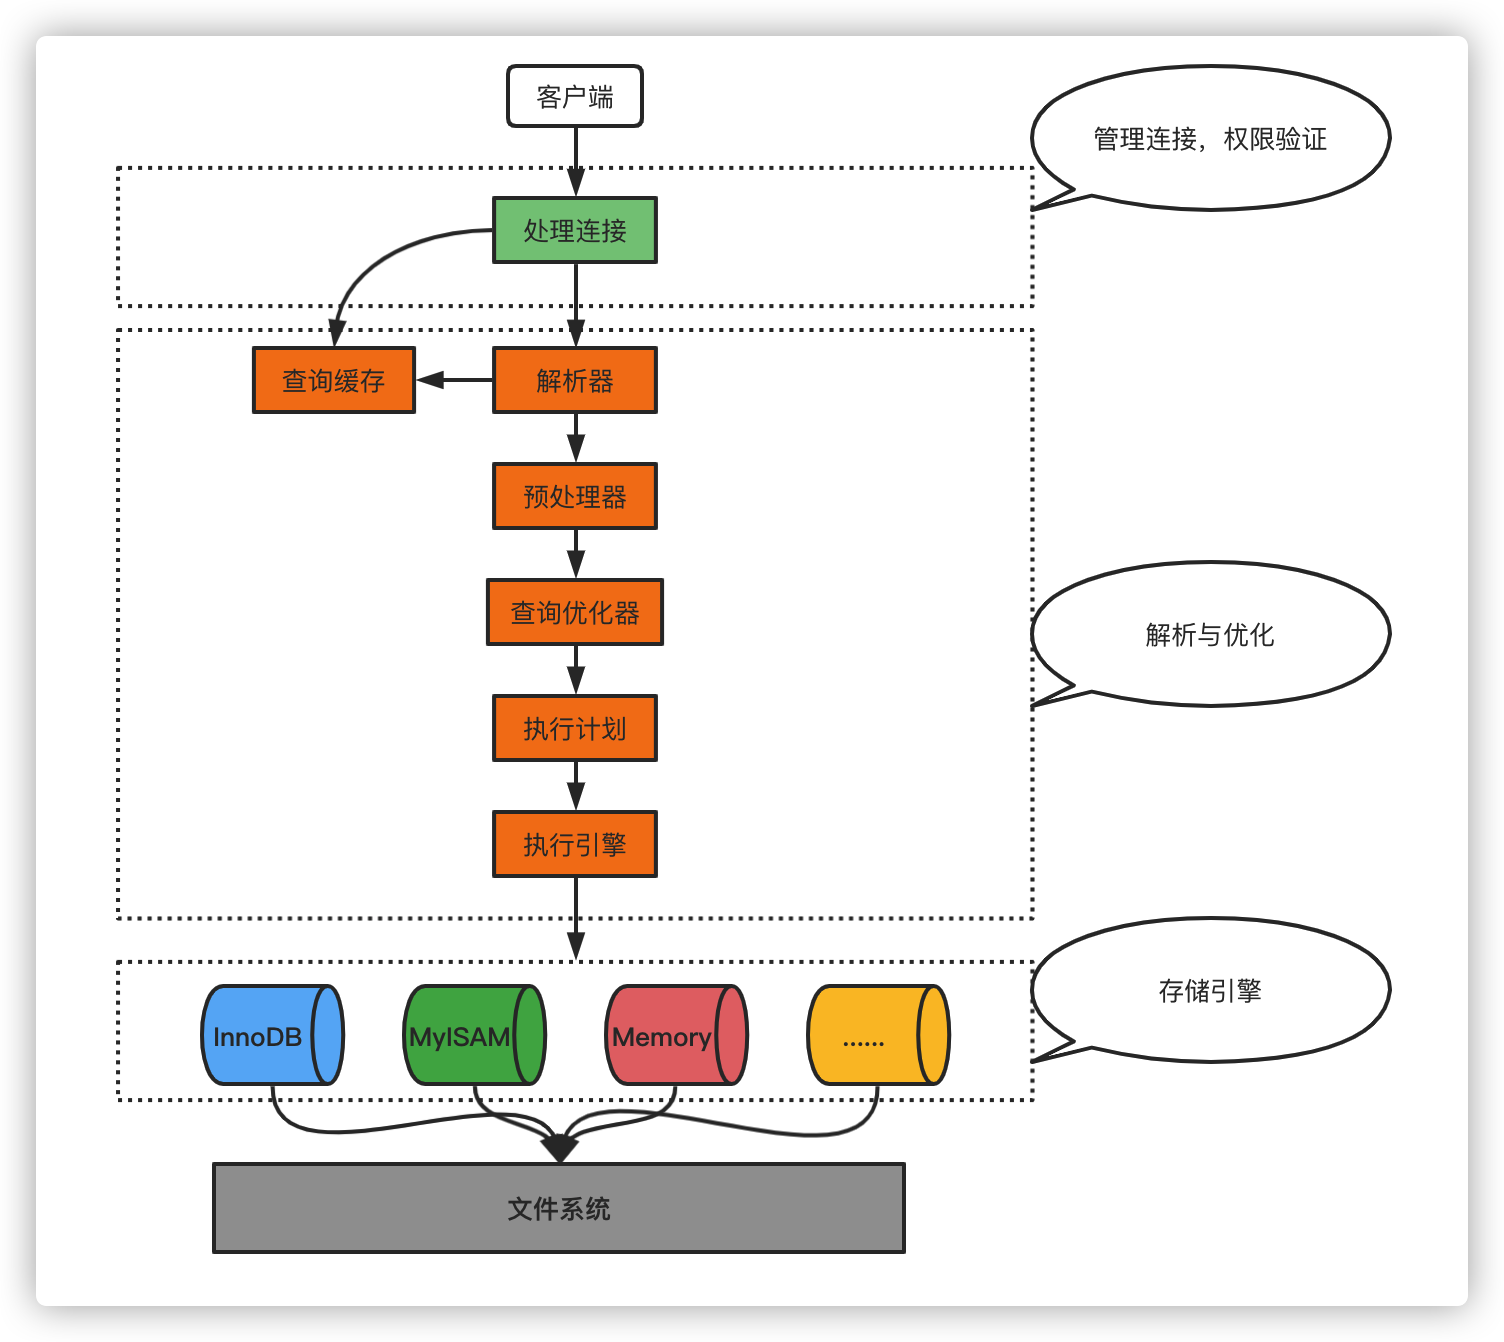
2、Mysql查询查询过程
- 客户端向MySQL服务器发送一条查询请求
- 服务器首先检查查询缓存,如果命中缓存,则立刻返回存储在缓存中的结果。否则进入下一阶段
- 服务器进行SQL解析、预处理、再由优化器生成对应的执行计划
- MySQL根据执行计划,调用存储引擎的API来执行查询
- 将结果返回给客户端,同时缓存查询结果
1、连接配置优化
这是客户端与服务端做交互的第一步。既然连接是双方的事,那就可以分为两个方面来优化
1.1、服务端优化
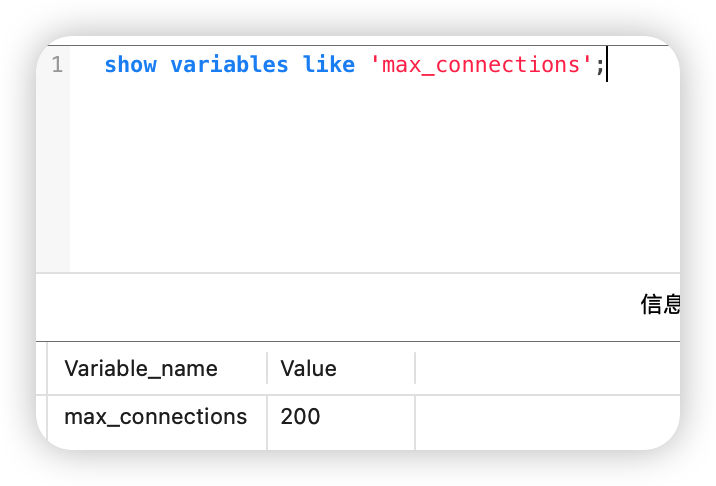
服务端就是给客户端提供服务的,那我们应该尽可能服务更多客户,我们有时候Mysql总是连接不上,报了error 1040: Too many connections,说明当前连接mysql的客户端数量已经超出配置的最大连接数了,这时我们可以修改环境变量max_connections,默认情况下服务端的最大连接数为151个,这里我修改了连接数为200.
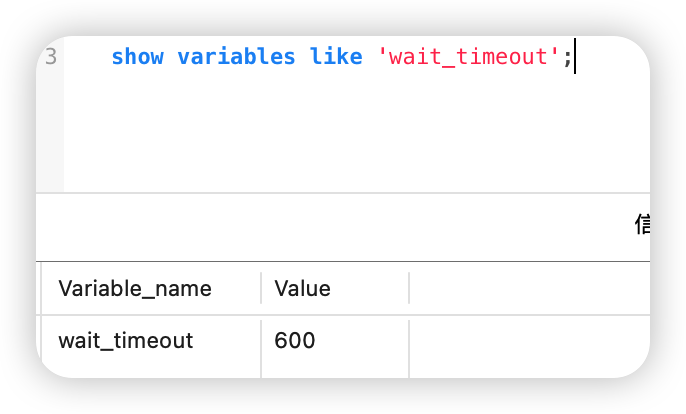
有些时候一些客户端虽然还连接着服务,但是并没有做操作,那我们可以给这些不活动的连接设置超时时间,默认的客户端超时时间为28800秒,也就是8小时,我们可以把这个时间设置小一些,这里我设置为600s,也就是10分钟。
Mysql还有其它配置参数,大家可以去了解下,这里就不再过多阐述。给大家提供一个参数详解链接---Mysql参数详解大全,相信能帮到你。
1.2、客户端优化
客户端应该避免与服务端建立连接的次数,已经建立的连接能复用就复用,避免资源浪费。不然每次执行一次sql就创建新的连接,服务端与客户端会吃不消的。
我们可以使用连接池复用。现在市面常见的数据库连接池有Druid、C3P0、DBCP、Hikari,现在市面用的比较多的是Druid与Hikari。
需要注意的是,我们使用连接池并不是越大越好。比如Druid的默认最大连接池是8,Hikari默认连接池为10,如果不经过严格的测试就加大连接池大小,系统执行效率反而降低。这是因为每创建一个连接,服务器就会创建一个线程去处理,连接数越多,创建的线程就越多。而线程数超过cpu个数情况,CPU就会通过时间分片的方式进行线程的上下文切换。频繁的上下文切换就会造成更大的性能开销。
Hikari官方给出了一个PostgreSQL数据库连接池大小的建议值公式,CPU核心数*2+1。假设服务器的CPU核心数是4,把连接池设置成9就可以了。关于这些连接池的使用以及原理,接下来有时间也会编写下。
2、架构优化
2.1、使用缓存
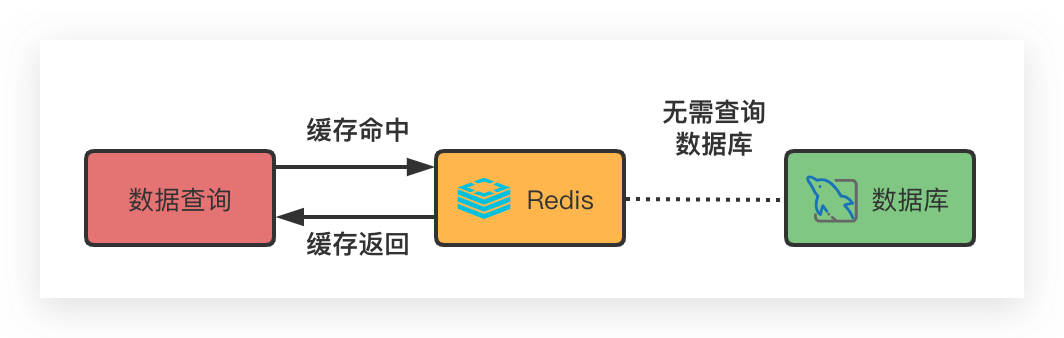
我们实际开发中,项目越来越大,业务越来越复杂,查询复杂关系表的时候,就会查询很慢,占用连接时间长。
如果我们这个数据不是实时性要求特别强的。我们可以将数据写入缓存中,加个过期时间,这样在缓存有效期内,就可以直接从缓存中获取数据,避免直接查询数据库增加网络io,减轻数据库的压力提供效率。
2.2、读写分离(集群、主从复制)
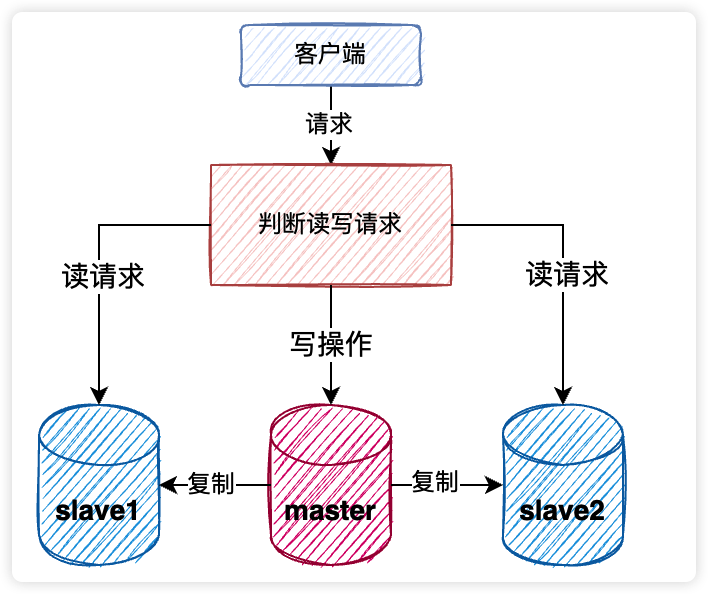
一开始我们项目一般都是连接单台mysql服务器的,但随着业务量的增加,单台mysql能承担的并发数量也是有限的。
为了解决该问题,我们可以使用多台mysql服务器,采用主从或者集群部署的方式。我们一般称主节点为master,从节点为salve,节点表示的是单台mysql服务器。我们写数据只往master上写数据,而读数据只从salve上读取数据,这就是读写分离,简单理解就是写库和读库的服务器不是同一个,这样的好处是读库服务器宕机了也不会影响写库的服务器,写库服务器宕机了也不会影响读库的服务器,我们还可以部署多台master和slave,这就是集群。
而使用那么多数据库服务器必然会面临一个问题,就是如何保证数据的一致性?我们一般称salve从master读取数据的过程叫主从复制。
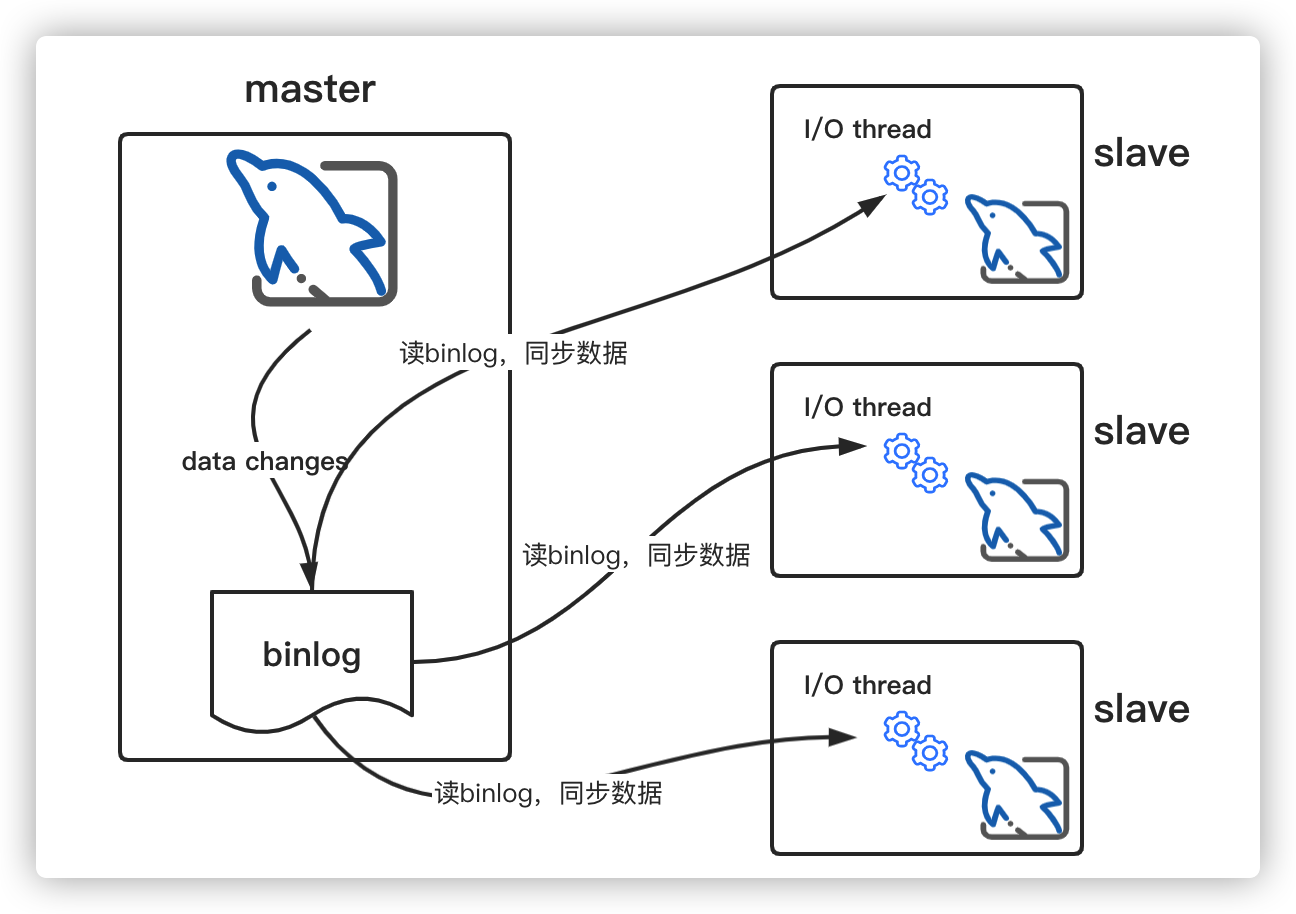
它是根据读取binlog日志来同步数据。原理是我们写数据的所有操作都会记录在binlog中,salve节点就会开专门的I/O线程去读取master节点的binlog,将写的操作同步到当前的salve节点。
根据这些配置,我们可以保证MySQL的高可用。但随着单表的数据量日益剧增,查询性能大降(Mysql单表数据量千万以上性能就会有问题),我们可以将单节点的数据分散到多个节点存储,也就是分库分表
2.3、分库分表
简单理解的话就是如果是以数据库为节点做拆分,那就是分库,如果是以单张表为节点,那就是分表。
分库分表分成垂直分库、垂直分表、水平分库、水平分表。
2.3.1、垂直分库
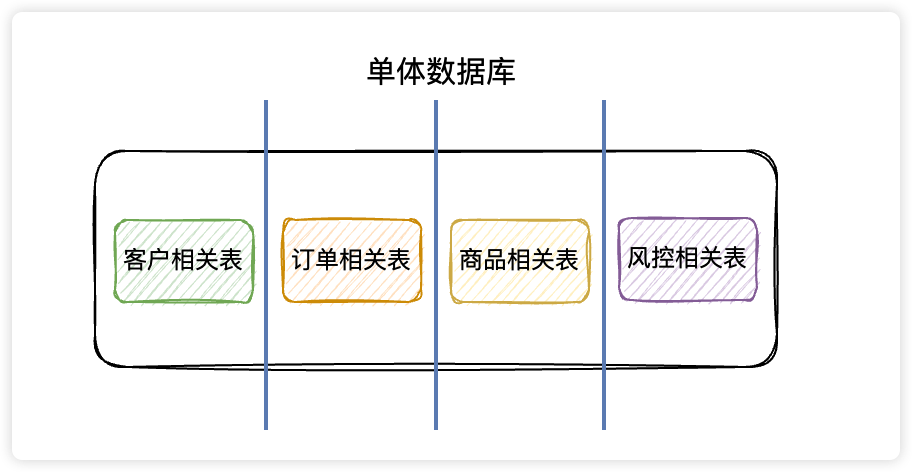
在单体数据库的基础上垂直切几刀,按照业务逻辑拆分成不同的数据库,这就是垂直分库啦。
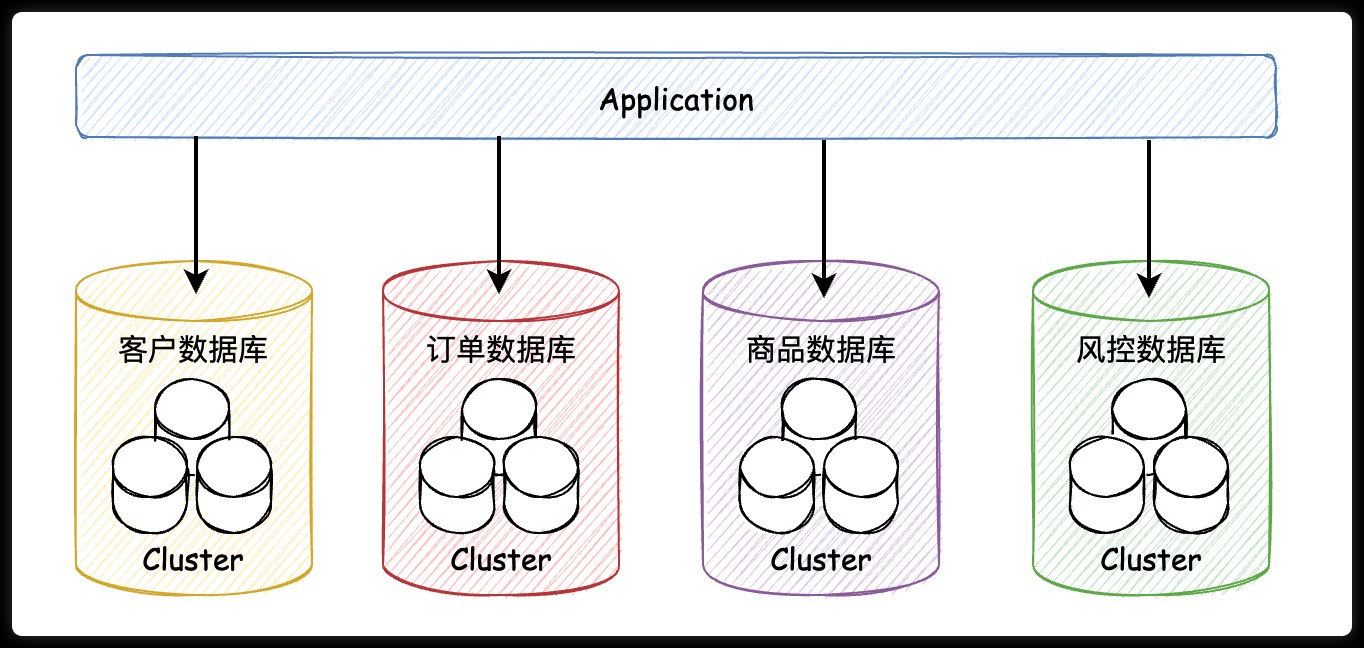
现在我们常说的单体应用改微服务应用,数据库拆分用的就是垂直分库。
2.3.2、垂直分表
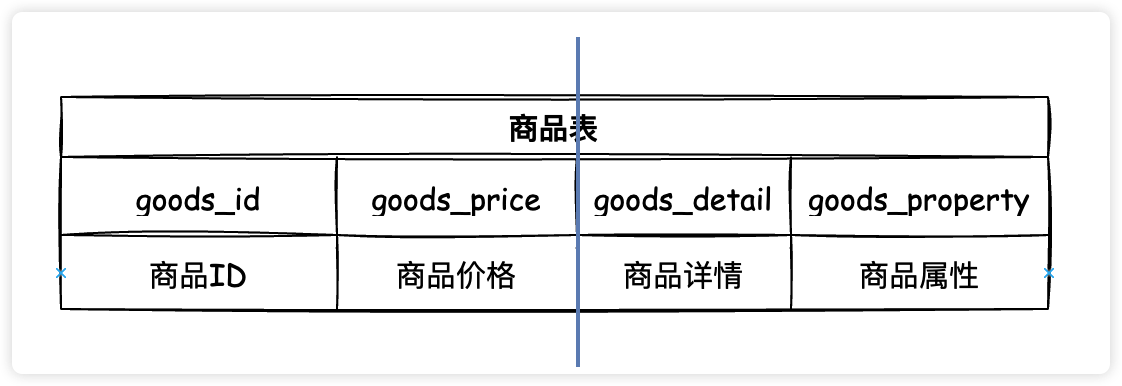
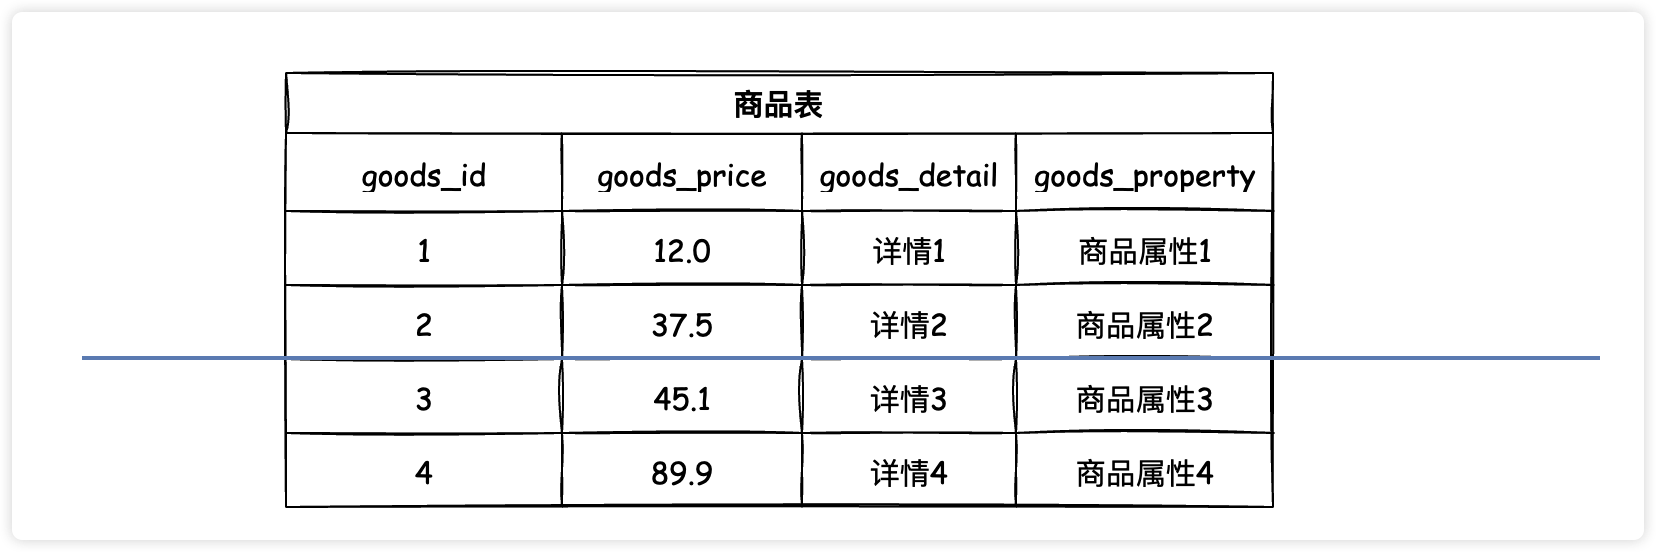
垂直分表就是在单表的基础上垂直切一刀(或几刀),将一个表的多个字短拆成若干个小表,这种操作需要根据具体业务来进行判断,通常会把经常使用的字段(热字段)分成一个表,不经常使用或者不立即使用的字段(冷字段)分成一个表,提升查询速度。
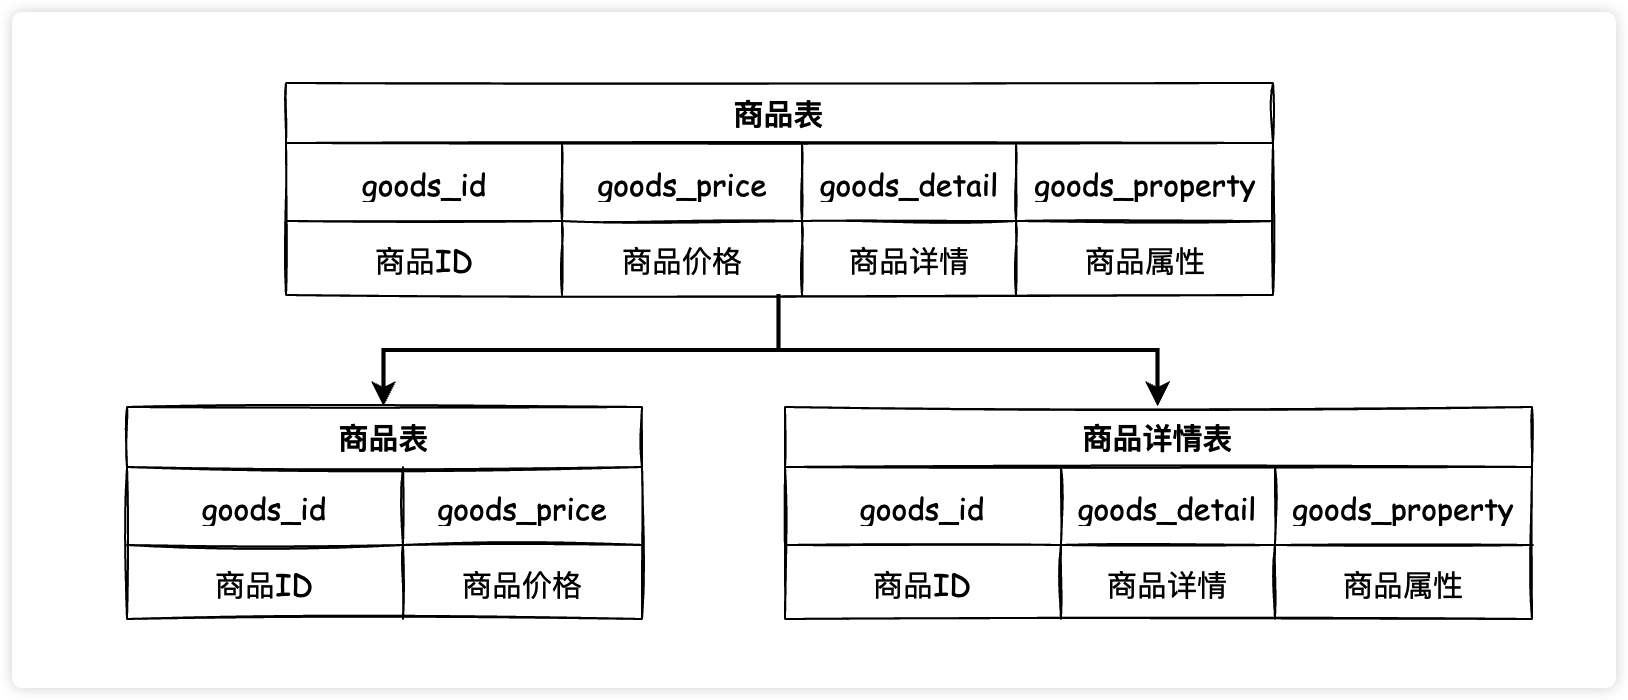
我们查看商品往往不需要直接看到商品详情,而是商品的一些基本信息,等点击该商品后才展示商品详情,所以我们可以将商品表拆分为多张表。
2.3.3、水平分库
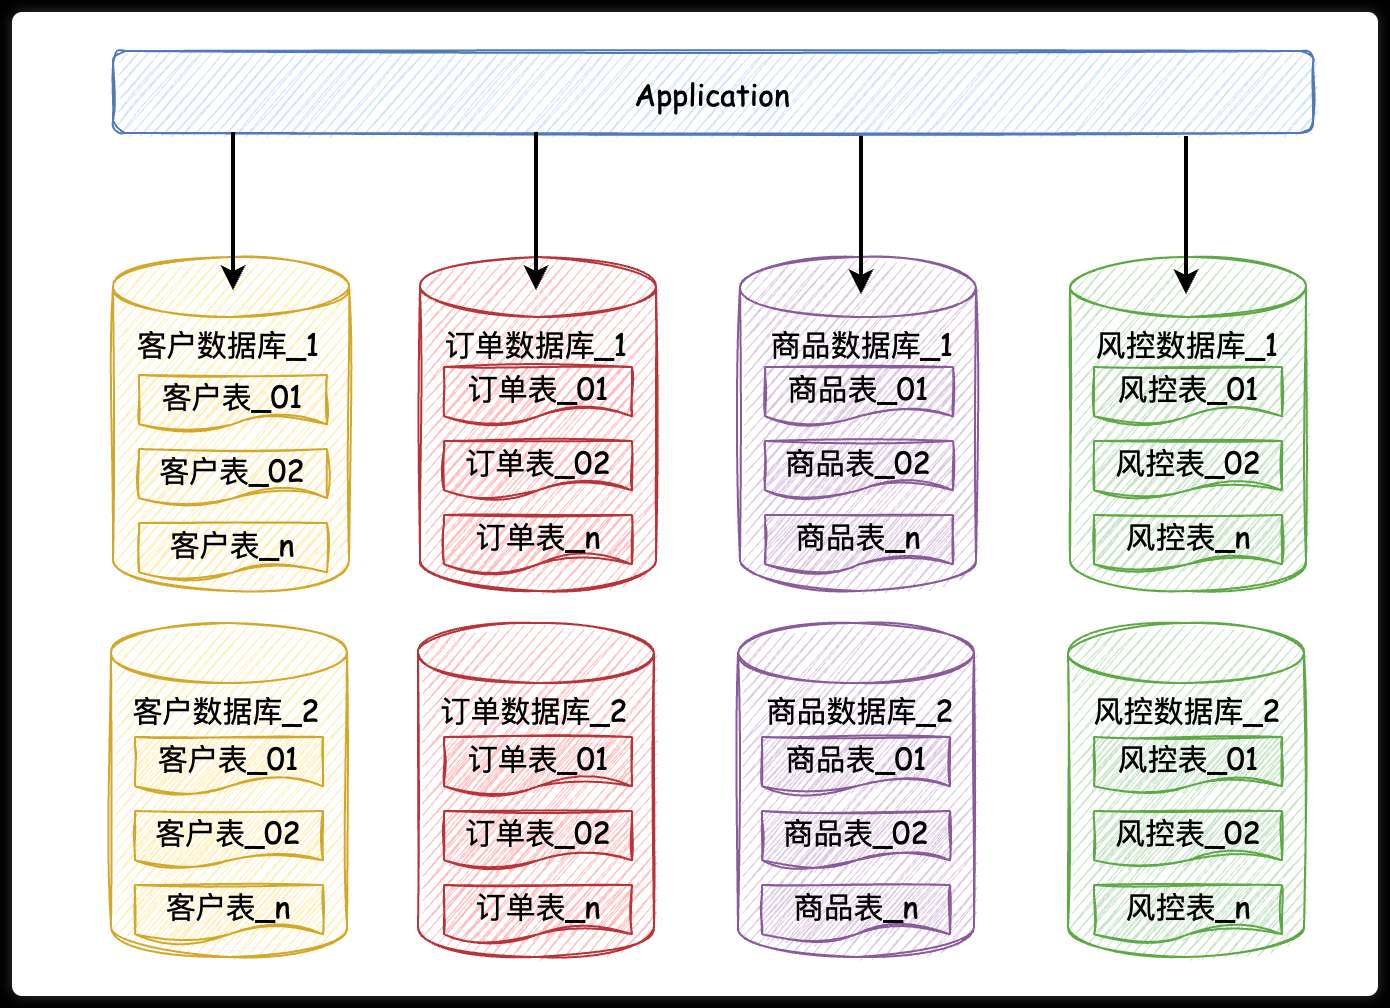
水平分库就是对单个数据库水平切一刀,往往伴随着水平分表。
2.3.4、水平分表
把单张表的数据按照一定的规则(行话叫分片规则)保存到多个数据表上,横着给数据表来一刀(或几刀),就是水平分表了。
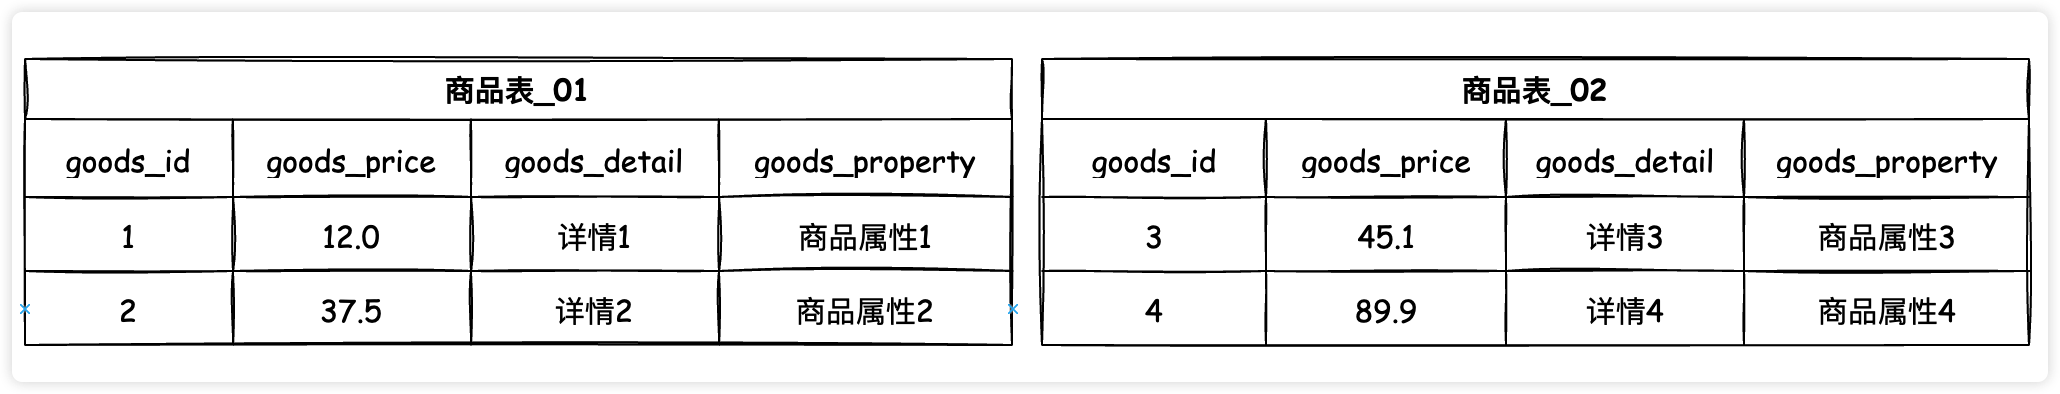
2.3.5、总结
水平分,主要是为了解决存储的瓶颈;垂直分,主要是为了减轻并发压力。
2.4、消息队列削峰
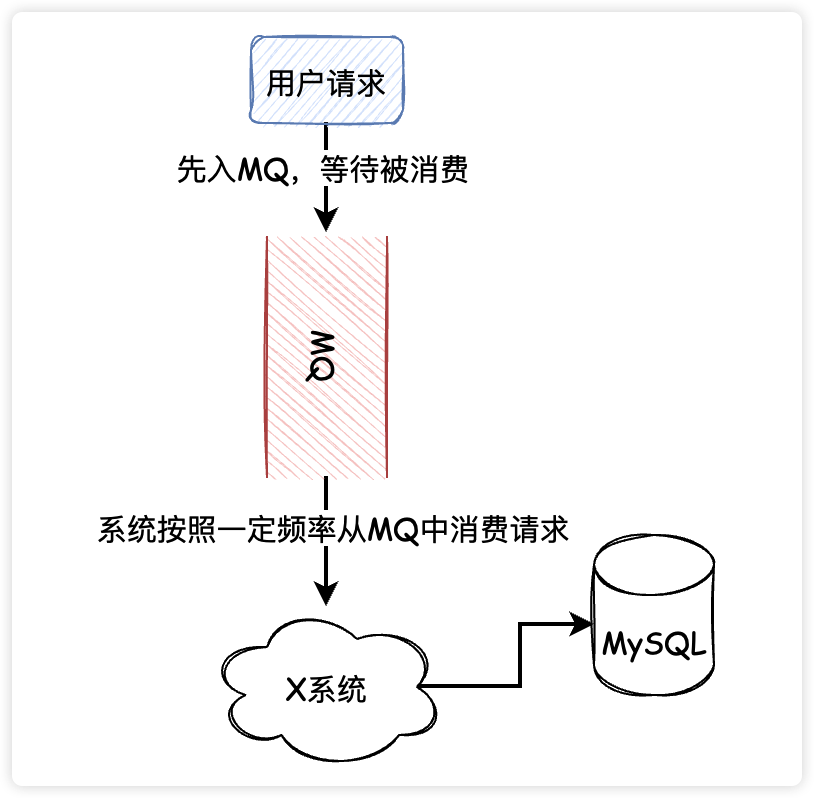
通常情况下,用户的请求会直接访问数据库,如果同一时刻在线用户数量非常庞大,极有可能压垮数据库(像最近李易峰嫖娼、吴亦凡强奸、佩洛西访台等直接把微博搞炸了)。
这种情况下可以通过使用消息队列降低数据库的压力,不管同时有多少个用户请求,先存入消息队列,然后系统有条不紊地从消息队列中消费请求。
3、Sql分析与优化
我们优化完连接,加入缓存架构,增加服务器等,还是遇到查询慢的问题,那就是sql语句有问题了。
只要你的语法不出问题,解析器就不会有问题。此外,为了防止你写的SQL运行效率低,优化器会自动做一些优化,但如果实在是太烂,优化器也救不了你了,只能眼睁睁地看着你的SQL查询沦为慢查询。
3.1、慢查询
慢查询就是执行地很慢的查询,只有知道MySQL中有哪些慢查询我们才能针对性地进行优化。
因为开启慢查询日志是有性能代价的,因此MySQL默认是关闭慢查询日志功能,使用以下命令查看当前慢查询状态。
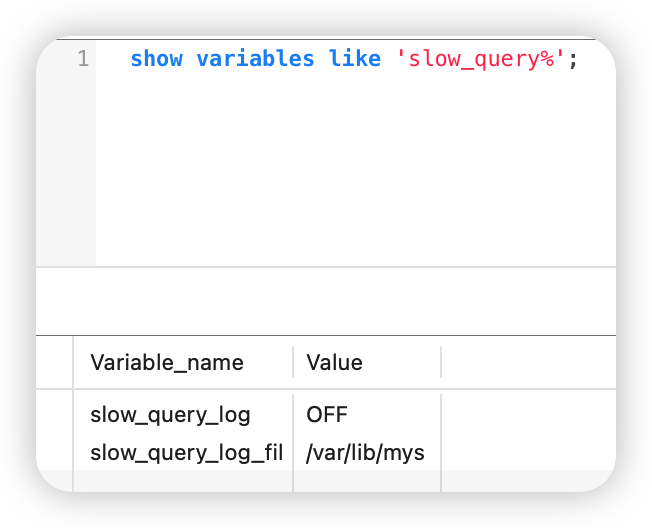
slow_query_log表示当前慢查询日志是否开启,slow_query_log_file表示慢查询日志的保存位置。
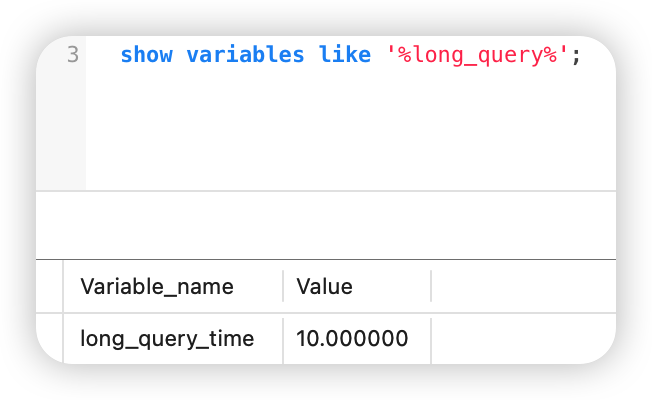
除了上面两个变量,我们还需要确定“慢”的指标是什么,即执行超过多长时间才算是慢查询,默认是10S,如果改成0的话就是记录所有的SQL。
3.1.1、打开慢日志
有两种打开慢日志的方式
- 修改配置文件
my.cnf
此种修改方式系统重启后依然有效
bash
# 是否开启慢查询日志
slow_query_log=ON
# 查询时间大于2s即为慢sql
long_query_time=2
slow_query_log_file=/var/lib/mysql/slow.log- 动态修改参数(重启后失效)
sql
mysql> set @@global.slow_query_log=1;
Query OK, 0 rows affected (0.06 sec)

mysql> set @@global.long_query_time=2;
Query OK, 0 rows affected (0.00 sec)
3.1.2、慢日志分析
MySQL不仅为我们保存了慢日志文件,还为我们提供了慢日志查询的工具mysqldumpslow,为了演示这个工具,我们先构造一条慢查询:
sql
mysql> SELECT sleep(5);然后我们查询用时最多的1条慢查询:
bash
[root@iZwz9b4u02b2oxu615p14nZ ~]# mysqldumpslow -s t -t 1 -g 'select' /var/lib/mysql/9e74f9251f6c-slow.log

Reading mysql slow query log from /var/lib/mysql/9e74f9251f6c-slow.log
Count: 1  Time=10.00s (10s)  Lock=0.00s (0s)  Rows=1.0 (1), root[root]@localhost
  SELECT sleep(N)
其中,
- Count:表示这个SQL执行的次数
- Time:表示执行的时间,括号中的是累积时间
- Locks:表示锁定的时间,括号中的是累积时间
- Rows:表示返回的记录数,括号中的是累积数
更多关于mysqldumpslow的使用方式,可以查阅官方文档,或者执行mysqldumpslow --help寻求帮助。
3.2、查看运行中的线程
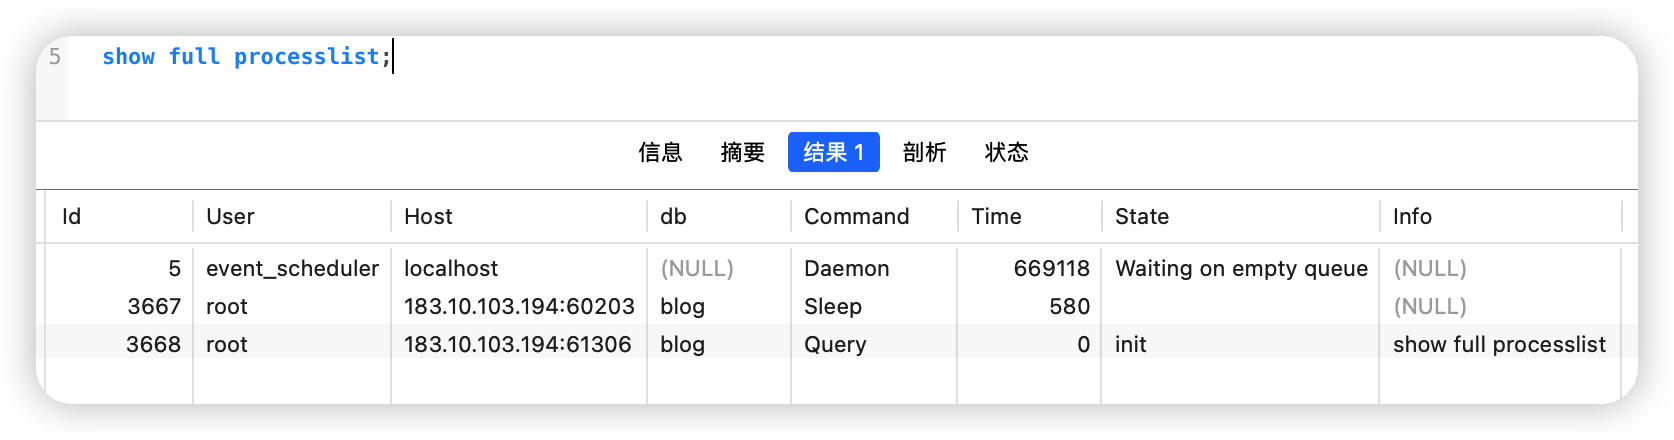
我们可以运行show full processlist查看MySQL中运行的所有线程,查看其状态和运行时间,找到不顺眼的,直接kill。
其中,
- Id:线程的唯一标志,可以使用Id杀死指定线程
- User:启动这个线程的用户,普通账户只能查看自己的线程
- Host:哪个ip和端口发起的连接
- db:线程操作的数据库
- Command:线程的命令
- Time:操作持续时间,单位秒
- State:线程的状态
- Info:SQL语句的前100个字符
3.3、查看服务器运行状态
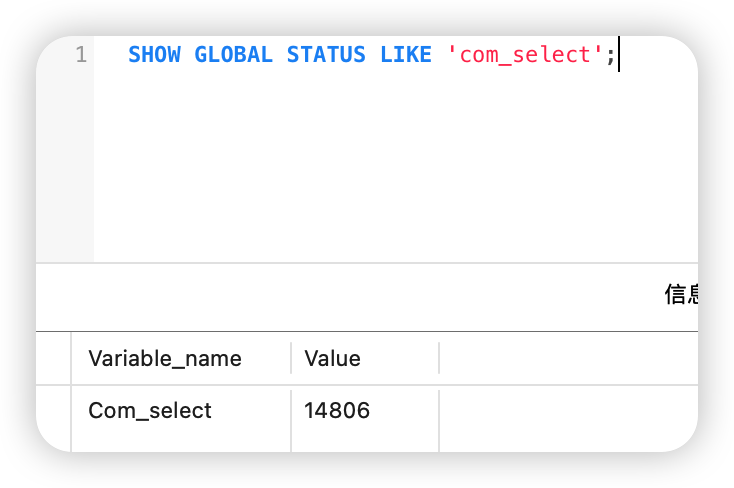
使用SHOW STATUS查看MySQL服务器的运行状态,有session和global两种作用域,一般使用like+通配符进行过滤。
3.4、查看存储引擎运行信息
SHOW ENGINE用来展示存储引擎的当前运行信息,包括事务持有的表锁、行锁信息;事务的锁等待情况;线程信号量等待;文件IO请求;Buffer pool统计信息等等数据。
例如:
sql
SHOW ENGINE INNODB STATUS;上面这条语句可以展示innodb存储引擎的当前运行的各种信息,大家可以据此找到MySQL当前的问题,限于篇幅不在此意义说明其中信息的含义,大家只要知道MySQL提供了这样一个监控工具就行了,等到需要的时候再来用就好。
3.5、EXPLAIN执行计划
通过慢查询日志我们可以知道哪些SQL语句执行慢了,可是为什么慢?慢在哪里呢?
MySQL提供了一个执行计划的查询命令EXPLAIN,通过此命令我们可以查看SQL执行的计划,所谓执行计划就是:优化器会不会优化我们自己书写的SQL语句(比如外连接改内连接查询,子查询优化为连接查询...)、优化器针对此条SQL的执行对哪些索引进行了成本估算,并最终决定采用哪个索引(或者最终选择不用索引,而是全表扫描)、优化器对单表执行的策略是什么,等等等等。
EXPLAIN在MySQL5.6.3之后也可以针对UPDATE、DELETE和INSERT语句进行分析,但是通常情况下我们还是用在SELECT查询上。
这篇文章主要是从宏观上多个角度介绍MySQL的优化策略,因此这里不详细说明EXPLAIN的细节,之后单独成篇。
3.6、SQL与索引优化
3.6.1、SQL优化
SQL优化指的是SQL本身语法没有问题,但是有实现相同目的的更好的写法。比如:
- 使用小表驱动大表;用join改写子查询;or改成union
- 连接查询中,尽量减少驱动表的扇出(记录数),访问被驱动表的成本要尽量低,尽量在被驱动表的连接列上建立索引,降低访问成本;被驱动表的连接列最好是该表的主键或者是唯一二级索引列,这样被驱动表的成本会降到更低
- 大偏移量的limit,先过滤再排序
针对最后一条举个简单的例子,下面两条语句能实现同样的目的,但是第二条的执行效率比第一条执行效率要高得多(存储引擎使用的是InnoDB),大家感受一下:
sql
-- 1. 大偏移量的查询
mysql> SELECT * FROM user_innodb LIMIT 9000000,10;
Empty set (8.18 sec)

-- 2.先过滤ID(因为ID使用的是索引),再limit
mysql> SELECT * FROM user_innodb WHERE id > 9000000 LIMIT 10;
Empty set (0.02 sec)
3.6.2、索引优化
为慢查询创建适当的索引是个非常常见并且非常有效的方法,但是索引是否会被高效使用又是另一门学问了。
可以阅读下用好MySQL索引,你必须知道的一些事情
4、存储引擎与表结构优化
4.1、选择存储引擎
一般情况下,我们会选择MySQL默认的存储引擎存储引擎InnoDB,但是当对数据库性能要求精益求精的时候,存储引擎的选择也成为一个关键的影响因素。
建议根据不同的业务选择不同的存储引擎,例如:
- 查询操作、插入操作多的业务表,推荐使用MyISAM;
- 临时表使用Memory;
- 并发数量大、更新多的业务选择使用InnoDB;
- 不知道选啥直接默认。
4.2、优化字段
字段优化的最终原则是:使用可以正确存储数据的最小的数据类型。
4.2.1、整数类型
MySQL提供了6种整数类型,分别是
- tinyint
- smallint
- mediumint
- int
- integer
- bigint
不同的存储类型的最大存储范围不同,占用的存储的空间自然也不同。
例如,是否被删除的标识,建议选用tinyint,而不是bigint。
4.2.2、字符类型
你是不是直接把所有字符串的字段都设置为varchar格式了?甚至怕不够,还会直接设置成varchar(1024)的长度?
如果不确定字段的长度,肯定是要选择varchar,但是varchar需要额外的空间来记录该字段目前占用的长度;因此如果字段的长度是固定的,尽量选用char,这会给你节约不少的内存空间。
4.2.3、非空
非空字段尽量设置成NOT NULL,并提供默认值,或者使用特殊值代替NULL。
因为NULL类型的存储和优化都会存在性能不佳的问题,具体原因在这里就不展开了。
4.2.4、不要用外键、触发器和视图功能
这也是「阿里巴巴开发手册」中提到的原则。原因有三个:
- 降低了可读性,检查代码的同时还得查看数据库的代码;
- 把计算的工作交给程序,数据库只做好存储的工作,并把这件事情做好;
- 数据的完整性校验的工作应该由开发者完成,而不是依赖于外键,一旦用了外键,你会发现测试的时候随便删点垃圾数据都变得异常艰难。
4.2.5、图片、音频、视频存储
不要直接存储大文件,而是要存储大文件的访问地址。
4.2.6、大字段拆分和数据冗余
大字段拆分其实就是前面说过的垂直分表,把不常用的字段或者数据量较大的字段拆分出去,避免列数过多和数据量过大,尤其是习惯编写SELECT * 的情况下,列数多和数据量大导致的问题会被严重放大!
字段冗余原则上不符合数据库设计范式,但是却非常有利于快速检索。比如,合同表中存储客户id的同时可以冗余存储客户姓名,这样查询时就不需要再根据客户id获取用户姓名了。因此针对业务逻辑适当做一定程度的冗余也是一种比较好的优化技巧。
5、业务优化
严格来说,业务方面的优化已经不算是MySQL调优的手段了,但是业务的优化却能非常有效地减轻数据库访问压力,这方面一个典型例子就是淘宝,下面举几个简单例子给大家提供一下思路:
- 以往都是双11当晚开始买买买的模式,最近几年双11的预售战线越拉越长,提前半个多月就开始了,而且各种定金红包模式丛出不穷,这种方式叫做预售分流。这样做可以分流客户的服务请求,不必等到双十一的凌晨一股脑地集体下单;
- 双十一的凌晨你或许想查询当天之外的订单,但是却查询失败;甚至支付宝里的小鸡的口粮都被延迟发放了,这是一种降级策略,集结不重要的服务的计算资源,用来保证当前最核心的业务;
- 双十一的时候支付宝极力推荐使用花呗支付,而不是银行卡支付,虽然一部分考量是提高软件粘性,但是另一方面,使用余额宝实际使用的阿里内部服务器,访问速度快,而使用银行卡,需要调用银行接口,相比之下操作要慢了许多。