计算机程序与设计(简答题)
笔记
-
什么是数据元素,什么是数据项?
答:数据元素是数据的==基本单位==,在计算机中通常作为一个整体进行考虑和处理,数据元素用于完整的描述一个对象。
数据项是组成数据元素的、有独立含义的、不可分割的==最小单位==。例如学生信息表的学号、姓名等。 -
什么是结构化算法?为什么要提倡结构化算法?
答:由==顺序结构、选择结构、循环结构==这三种基本结构构成的算法结构就是结构化算法。
结构化算法==不存在无规律的转向==,只在本基本结构内才允许存在分支和向前向后的跳转,==不会出现死循环==,使算法质量得到保证和提高。所以提倡结构化算法。 -
一颗度为2的树和二叉树有什么区别?
答:①一颗度为2的树每个结点==最多有两颗子树且至少有一个结点有两颗子树==。而二叉树的每个结点可以有0颗,1颗或2颗子树。
②度为2的树中两个分支没有左右之分的,即它的子树是无序的;而二叉树即使只有一个分支,也有左右之分,即二叉树是有序的。 -
什么是文件指针?通过文件指针访问文件有什么好处?
答:文件指针是==FILE类型的指针==,它指向一个文件型数据,一个FILE类型的变量对应一个文件的信息区,其中存放该文件的相关信息。
==文件指针用于跟踪当前文件的位置==。例如:向文件中输入1个字节,则文件指针会自动向前移动1个字节的位置。使用文件指针的好处是可以随机访问文件和把IO操作抽象为文件操作。 -
简述线性结构和非线性结构的不同点。
答:线性结构反映结点之间的逻辑关系是==一对一==的。例如,学生信息是根据学生学号的先后顺序来排序的,从而构成线性结构;
非线性结构反映结点之间的逻辑关系是==一对多或多对多==的。例如,一门课程可以同时有多名学生进行选修,一名学生可以同时选修多门课程,从而构成非线性结构。 -
使用C语言编写的程序的结构有何特点?
答:①程序==总是从main函数开始执行==的;
②一个程序是由一个或多个源程序文件组成,一个源程序文件包括预处理命令、全局声明、函数定义三个部分;
③每个变量的声明和语句最后必须有一个分号;
④程序应当==包含注释,增加程序的可读性==;
⑤C语言的==书写格式比较自由==;
⑥C语言本身不提供输入和输出语句。输入和输出的操作是由库函数中的scanf()、printf()等函数来完成的;
⑦函数是C语言的主要组成部分。一个函数通常包括==函数首部和函数体==两部分。 -
指针变量与整型变量的加减运算代表什么意义?
答:指针变量与整型变量的加减运算表示移动指针,以指向当前目标前面或后面若干位置的目标。指针变量与整形变量i的加减等于指针值(地址)与i的加减,使指针指向新的地址。 -
什么是编译,什么是解释,二者有什么区别?
答:编译是一次性的==将整个源程序翻译成等价的用机器语言表示的目标程序==。以后每次运行时直接执行已经翻译好的机器语言程序。
解释是==每次读取源程序的一条语句进行翻译和执行==,一边翻译一边执行,解释不产生目标程序。 -
简述顺序表和链表的区别。
答:顺序表:逻辑上相邻的数据元素其物理存储位置上==必须相邻==,优点是可以随机存取,节省存储空间;
链表:逻辑上相邻的数据数据元素其物理存储位置==不要求相邻==,用指针来表示结点之前的逻辑关系。优点是插入和删除比较方便,链表是一种顺序存储结构。 -
请列举格式声明中的几种常用的格式字符。
答:%d:用来输出一个==有符号==的十进制整数;
%c:用来以字符形式输出一个字符;
%s:用来输出一个字符串;
%f:用来以小数形式输出实数(包括单、双精度);
%l:用来输出一个长整型数据以及double类型数据;
%u:用来输出一个==无符号==的十进制整数。 -
什么是优先队列?其基本运算有什么?
答:优先队列是一个==以集合为基础的抽象数据类型==,优先队列中的每个元素都有一个优先级,其基本运算有==插入(Insert)运算和删除最小优先级元素(DeleteMin)运算==。 -
什么是串?什么是子串?什么是空格串?(2022真题)
答:串是由==零个或多个字符组成的有限序列==,又叫字符串。(串种的元素都是字符)零个字符的串称为空串,其长度为零。
串中==任意连续的字符所组成的子序列==称为该串的子串。空串是任意串的子串,任意串是其自身的子串。
由==一个或多个空格组成的串==称为空格串,其长度为串中的空格字符的个数。 -
为什么需要高级语言?高级语言的特点是什么?
答:高级语言更接近于人们习惯使用的自然语言和数学语言。
特点:功能强大,==不依赖于具体机器==。用高级语言编写的==源程序需要通过编译程序转换为机器指令的目标程序==。 -
请简述树的三种遍历方式。
答:树的三种遍历方式==分别是先序遍历,中序遍历,后序遍历==。
先序遍历:先访问根节点,再访问左子树,最后访问右子树;
中序遍历:先访问左子树,再访问根节点,最后访问右子树;
后序遍历:先访问左子树,再访问右子树,最后访问根节点。 -
算法、数据结构和程序的关系是什么?
答:算法是计算机解决问题的方法、步骤,==是对操作的描述==。
数据结构是程序中要指定用到哪些数据以及这些数据的类型和数据的组织形式,==是对数据的描述==。
程序是由人们事先编好并输入计算机的,程序包含两方面的信息,对数据和操作的描述,可以简单理解为:==算法+数据结构=程序==。 -
指针的运算都包括哪些?试举例说明。
答:指针的运算包括以下4种:
①==指针变量加(减)一个整数==。例如:p++、p--、p+5等;
②==指针变量赋值==。例如:p=&a;、*p=1;等。
③==指针变量相减==。例如:若两个指针变量都指向同一个数组中的元素,则两个指针变量值的差是两个指针之间元素的个数。
④==指针变量的比较==。例如:若两个指针变量都指向同一个数组中的元素,则指向前面元素的指针变量”小于“指向后面元素的指针变量。 -
简述数据、数据元素、数据结构的概念。
答:数据:==数据是客观事物的符号表示==,指所有能输入到计算机中并被计算机程序处理的符号总称,如整数、字符串、图形、声音等。
数据元素:==数据元素是数据的基本单位==。在计算机中通常作为一个整体进行考虑和处理。有时数据元素也称为元素、记录等。
数据结构:数据结构是==相互之间存在一种或多种特定关系的数据元素的集合==,即数据结构是带有“结构”的数据元素的集合,“结构”就是指数据元素之间存在的关系。 -
简述有符号数和无符号数的区别。
答:有符号数:==数据的范围有正值和负值之分==,数据的最高为为符号位,最高位为0表示正数,最高位为1表示负数。
无符号数:==数据的范围常常只有正值==,不用数据的最高位表示符号,把全部二进制位都用来存放数值。 -
简述编译和运行C源程序的一般步骤。
答:①上机输入和编写源程序;
②对源程序进行编译,得到目标程序;
③将目标程序与库函数连接,得到可执行的目标程序;
④运行可执行的目标程序。 -
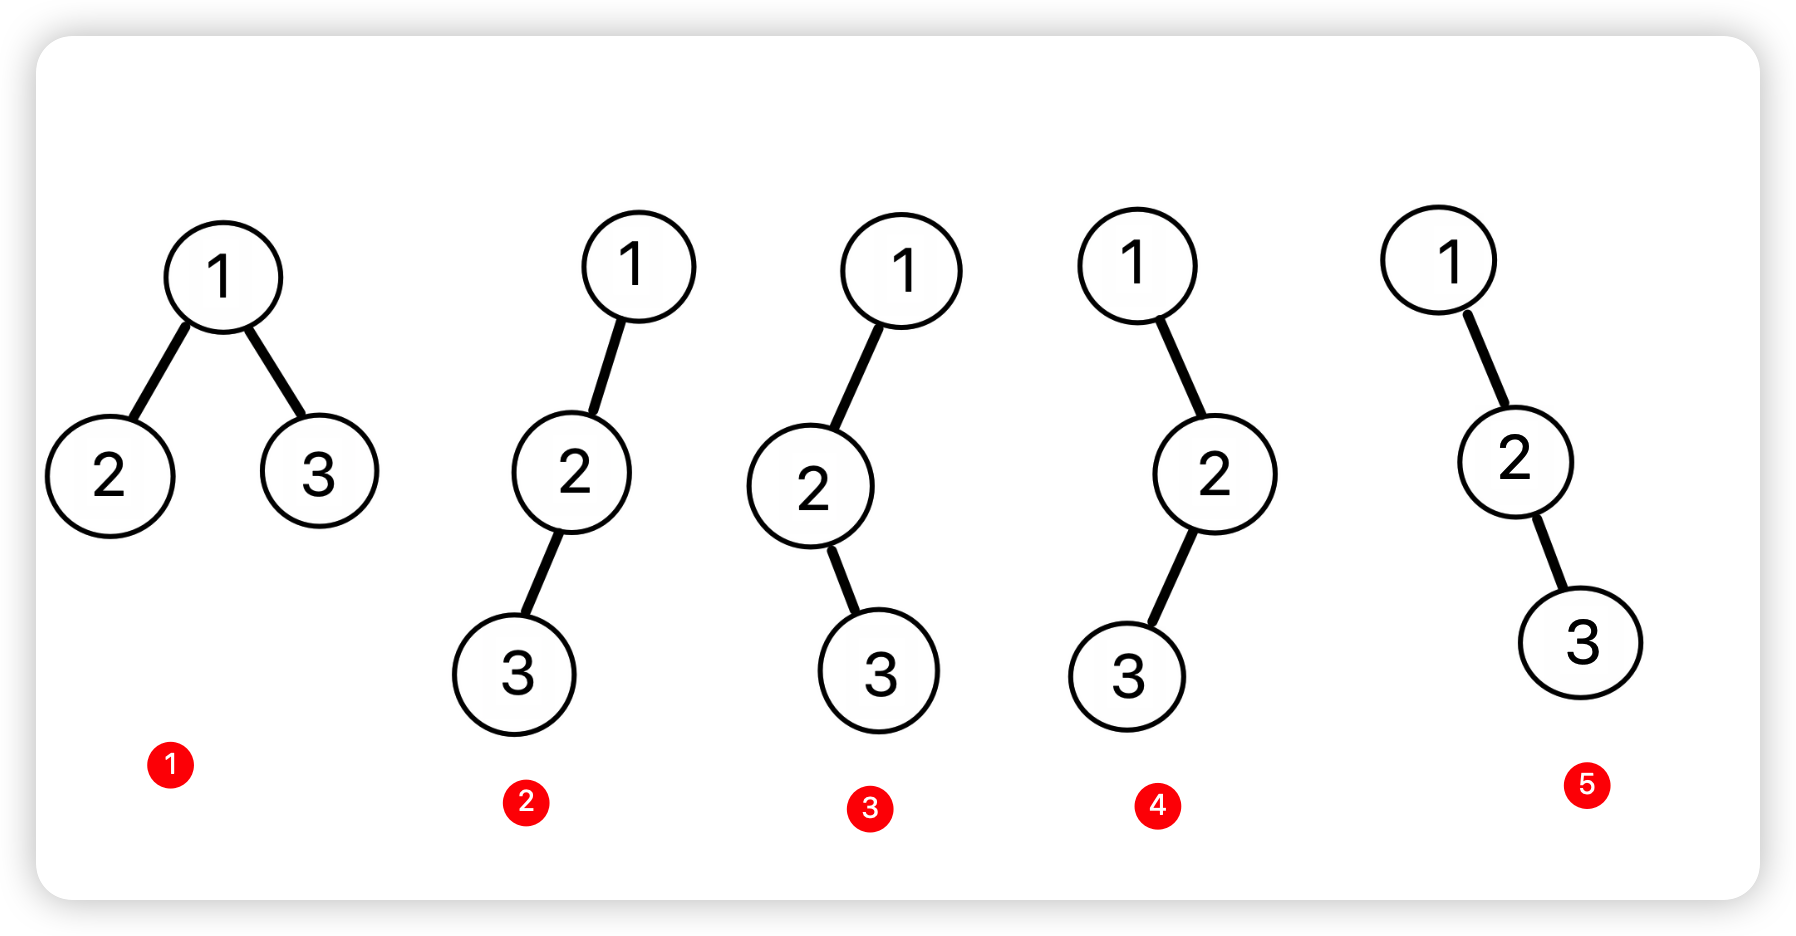
画出具有3个结点的二叉树的所有不同形态。
答:包含3个结点的二叉树具有5种形态:
-
什么是指针?什么是指针变量?它们有什么关系?
答:变量名与变量的地址有一一对应的关系,可以按此地址直接对变量i的存储单元进行访问,这个指针变量i的地址叫作指针。专门用来存放另一变量的地址(即指针)的变量称为指针变量。 -
什么是文件型指针?文件指针有什么作用?
答:在C语言中,==文件型指针是指FILE型指针,指向一个文件类型的结构==,结构里包含该文件的各种属性。通过文件指针可以找到与他相关联的文件。也就是说,==文件指针用于跟踪当前文件的位置==。 -
简述下列概念:数据、数据元素、数据项、数据对象、数据结构。
答:数据:==是对客观事物的符号表示==,是所有能被输入到计算机中并被计算机程序处理的符号的总称;
数据元素:==是数据的基本单位==,在计算机中通常作为一个整体进行考虑和处理,数据元素也称为元素、记录等;
数据项:==是组成数据元素的、具有独立含义、不可分割的最小单位==,例如学生信息表中的学号、姓名等;
数据对象:==是性质相同的数据元素的集合,是数据的一个子集==;
数据结构:==是相互之间存在一种或多种特定关系的数据元素的集合==,即数据结构是带“结构”的数据元素的集合,“结构”是数据元素之间存在的关系。 -
存储结构由哪两种基本的存储方法实现?
答:存储结构具有==顺序存储结构==和==链式存储结构==两种。
顺序存储结构:是借助元素在存储器中的相对位置来表示数据元素之间的逻辑关系。顺序存储结构==要求所有元素依次存放在一片连续的存储空间中==。
链式存储结构:==无须占用一整块存储空间==。为了表示结点之间的关系,需要给==每个结点附加指针字段,用于存放后继元素的存储地址==。 -
写出循环队列出队的算法步骤。
答:(1)判断队列是否为空,若空则返回ERROR。
(2)保存队头元素。
(3)队头指针加1。 -
什么是程序设计语言?程序设计语言主要分为哪类?
答:程序设计语言是指能够被计算机执行和处理的,具有一定格式的语言。
程序设计语言主要分为机器语言、汇编语言、高级语言。其中,机器语言是唯一能够被计算机识别和执行的语言,机器语言和汇编语言统称为低级语言。 -
简述编译程序和解释程序的区别。
答:编译程序:将高级语言所编写的源程序翻译成等价的用机器语言表示的目标程序。
解释程序:对源程序一边翻译、一边执行、不产生目标程序。 -
简述C语言中的变量必须“先定义后使用”的原因。
答:凡是未被事先定义的不作为变量名,这就能保证程序中变量名使用得正确,便于编译时能发现错误。避免变量名使用时出错。每个变量被指定一确定类型,在编译时就能为其分配相应的存储单元。指定每一个变量属于一个类型,便于在编译时检查该变量所进行的运算是否合法。 -
将二进制数11100101转换为十进制数,要求写出其具体过程。
答:
-
算法有些特点?算法和程序的主要区别是什么?
答:算法具有以下五个特性:
①==输入==,在算法中可以有零个或多个输入;
②==输出==,在算法中至少有一个或多个输出;
③==有穷性==,任意一个算法在执行有穷个计算步骤后必须终止;
④==确定性==,算法的每一个步骤都具有确定的含义,不会出现二义性;
⑤==可行性==,算法的每一步都必须是可行的,也就是说,每一步都能够通过执行有限的次数完成。
算法和程序的区别是:
①算法是解决问题的步骤;程序是一组计算机能识别和执行的指令,决定计算机所进行的一切操作。
②算法+数据结构=程序,算法是程序的灵魂,算法的好坏很大程度上决定一个程序的效率。 -
什么是数据结构?什么是数据类型?
答:(1)数据结构:数据结构是相互之间存在一种或多种的特定关系的数据元素的集合。也可以说数据结构是带“结构”的数据元素的集合,“结构”是数据元素之间存在的关系。
(2)数据类型:数据类型是一个值的集合和定义在这个值集上的一组操作的总称。 -
简述数据逻辑结构的四种基本结构关系。
答:数据的逻辑结构有两个要素:==数据元素、关系==。根据数据元素之间关系的不同特性,通常有四类基本结构关系:
(1)==集合结构==。数据元素属于同一个集合。
(2)==线性结构==。数据元素之间存在一对一的关系。
(3)==树结构==。数据元素之间存在一对多的关系。
(4)==图结构或网状结构==。数据元素之间存在多对多的关系。 -
简述在线性表的链式存储结构中,头指针、头结点和首元结点的区别。
答:(1)首元结点是指==链表中存储第一个数据元素的结点==。
(2)头结点是在==首元结点之前附设的一个结点,其指针域指向首元结点==。头结点的数据域可以存储与数据元素类型相同的其他附加信息,也可不存储任何信息。
(3)头指针是==指向链表中第一个结点的指针==。若链表设有头结点,则头指针所指结点为线性表的头结点;若链表不设头结点,则头指针所指结点为首元结点。
例如:head->next=p1,head为头结点,p1是链表中第一个结点,也就是首元结点。 -
简述全局变量和局部变量的区别。(2022真题)
答:==全局变量==,是在函数之外定义的变量,它的有效范围为从定义变量的位置开始到本源程序文件结束,可以被本文件中函数所共用。
==局部变量==,是在一个函数内部或复合语句中定义的变量,只在本函数或复合语句范围内有效。 -
评价排序算法效率的指标有哪些?
答:评价排序算法好坏的标准主要有执行时间和辅助空间两点。
(1)==执行时间==。排序算法的时间复杂度主要由关键字的比较次数和记录移动次数这两个指标决定。
(2)==辅助空间==。排序算法的空间复杂度由排序算法所需的辅助空间决定。辅助空间是除了存放待排序记录占用的空间之外,执行算法所需要的其他存储空间,理想的空间复杂度为O(1)。 -
简述程序的三种基本结构。
答:程序的三种基本结构包括顺序结构、选择结构、循环结构。
==顺序结构==的各操作步骤是顺序执行的,顺序结构是最简单的一种基本结构,任何一个算法都包含顺序结构。
==选择结构==又称判断结构或分支结构,此结构中必包含一个判断条件,根据给定的条件是否成立而选择执行的语句。
==循环结构==又称重复结构,即在某一条件下反复执行某一部分的操作。 -
什么是机器语言?什么是汇编语言?两者的共同点是什么?
答:==机器语言==是由0、1二进制代码组成的能被机器直接理解、执行的指令集合,==是机器唯一能够执行的语言==。
==汇编语言==采用一定的助记符来代替机器语言中的指令和数据,因此,汇编语言又称为符号语言。
==共同点:两者都属于低级语言,都依赖于机器,可移植性差。== -
简述引用数组元素的方法。
答:通过指针引用数组元素的方法有下标法和指针法两种。
==使用下标法引用数组元素时==,直接引用即可,如a[i],其中a为数组名,i为要引用的元素在数组中的序号;
==使用指针法引用数组元素时==,可以通过数组首元素的指针变量或数组名与要引用的元素在数组中的序号进行简单的计算后再引用,如*(a+i)或*(p+i)。其中a是数组名,i为要引用的元素在数组中的序号,p是指向数组首元素的指针变量。 -
什么是交换类排序?
答:交换类排序是==通过“交换”无序序列中的记录从而得到其中关键字最小或最大的记录,并将它加入到有序子序列中,以此方法增加记录的有序子序列的长度==。如冒泡排序、快速排序。 -
写出循环队列入队的算法步骤。
答:(1)判断队列是否为满,若满则返回ERROR。
(2)将新元素插入队尾。
(3)队尾指针加1。 -
什么是函数的定义?什么是函数的声明?
答:函数的定义:在C语言中,程序中用到的所有函数,必须“先定义,后使用”,即指定函数的名字、函数返回值类型、函数实现的功能以及参数的个数与类型,并将这些信息通知编译系统。如果事先不定义,编译系统就不知道这个函数是什么、要实现什么功能。
函数的声明:如果使用用户自己定义的函数,而该函数的位置在调用它的函数的后面,应该在主调函数中对被调用的函数作声明。声明的作用是把函数名、函数参数的个数和参数类型等信息通知编译系统,以便在遇到函数调用时,编译系统能正确识别函数并检查调用是否合法。 -
简述default语句对switch语句段的影响。
答:执行switch语句时,先计算switch后面的”表达式“的值,然后将它与各case后面的常量的值比较,如果与某一个case中的常量值相同,就执行此case后面的语句,如果没有与switch表达式相匹配的case常量:
①若程序中有default语句,流程转去执行default后面的语句;
②若程序中没有default语句,则不执行任何语句,流程转到switch后的下一条语句。 -
有哪些常用的排序方法?并指出哪些排序方法是稳定的,哪些是不稳定的。
答:常用的排序算法有直接插入排序、折半插入排序、希尔排序、冒泡排序、快速排序、堆排序、简单选择排序、归并排序等。
其中直接插入排序、冒泡排序、折半插入排序和归并排序是稳定的排序方法;
希尔排序、快速排序、简单选择排序和堆排序是不稳定的排序方法。 -
简述栈和队列这两种数据类型的相同点和不同点。
答:相同点:栈和队列都是==操作受限的线性表==。
不同点:栈是只能在一端进行插入和删除的线性表,==插入和删除都在栈顶进行==,它的特点是“先进后出”。
队列是只能在一端进行插入在另一端进行删除的线性表,==进行插入的那端是队尾,进行删除的那端是队头==,特点是“先进先出”。 -
简述定义二维数组的一般形式,并试着定义一个行的二维数组s,用“green”“red”“orange”对其进行初始化。
答:(1)二维数组常用矩阵形式表示,写出行和列的排列形式,二维数组定义的一般形式为:类型名 数组名[常量表达式1][常量表达式2];
(2)定义和初始化二维字符数组:
char color[3][7]={"green","red","orange"};
评论
1 条
希望对各位同学能有帮助<img src= 'https://static.talkxj.com/emoji/goutou.jpg' width='24'height='24' style='margin: 0 1px;vertical-align: text-bottom'/>