2023软件设计师做题记录
上午题
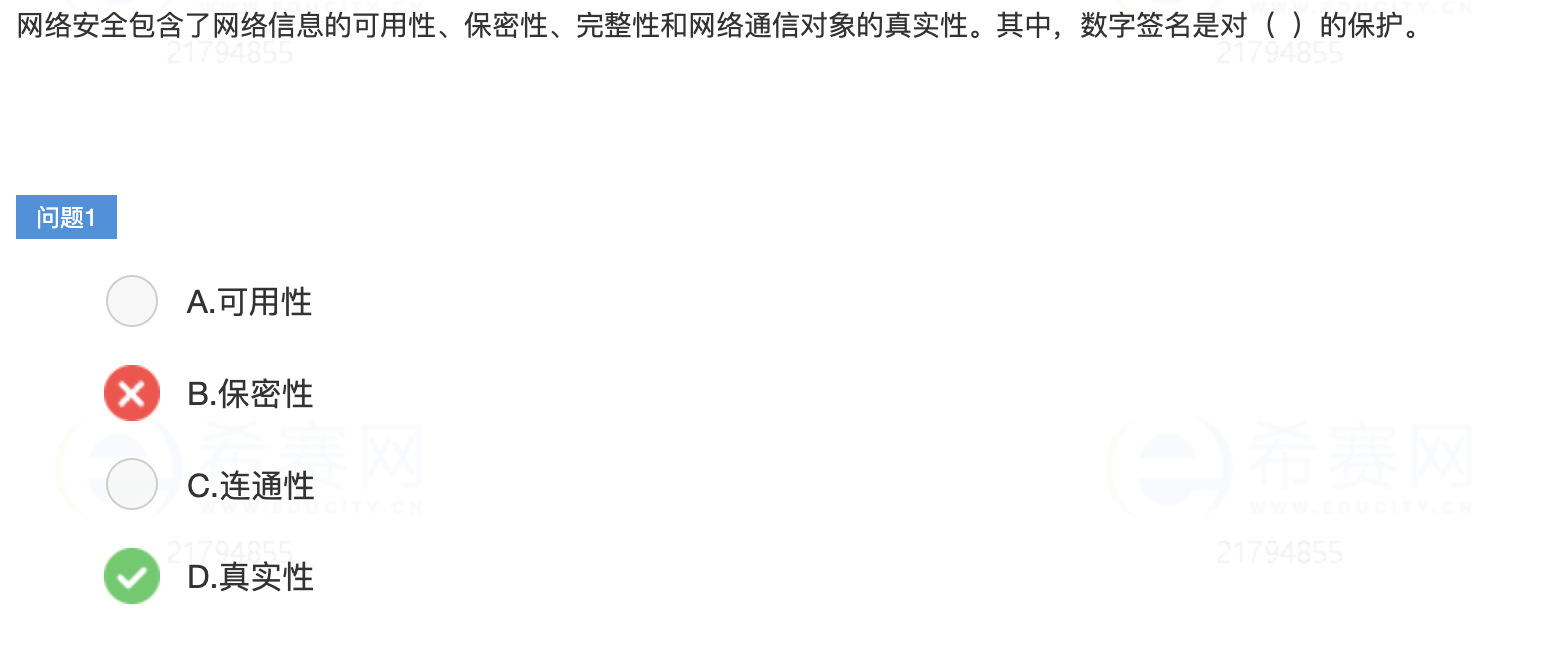
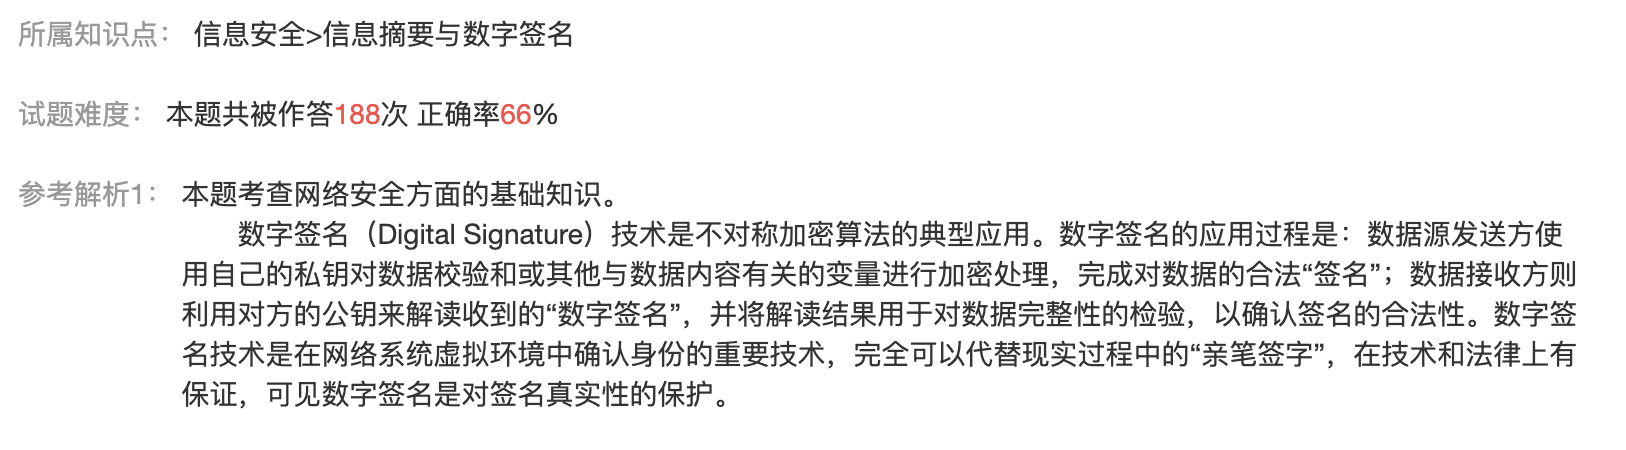
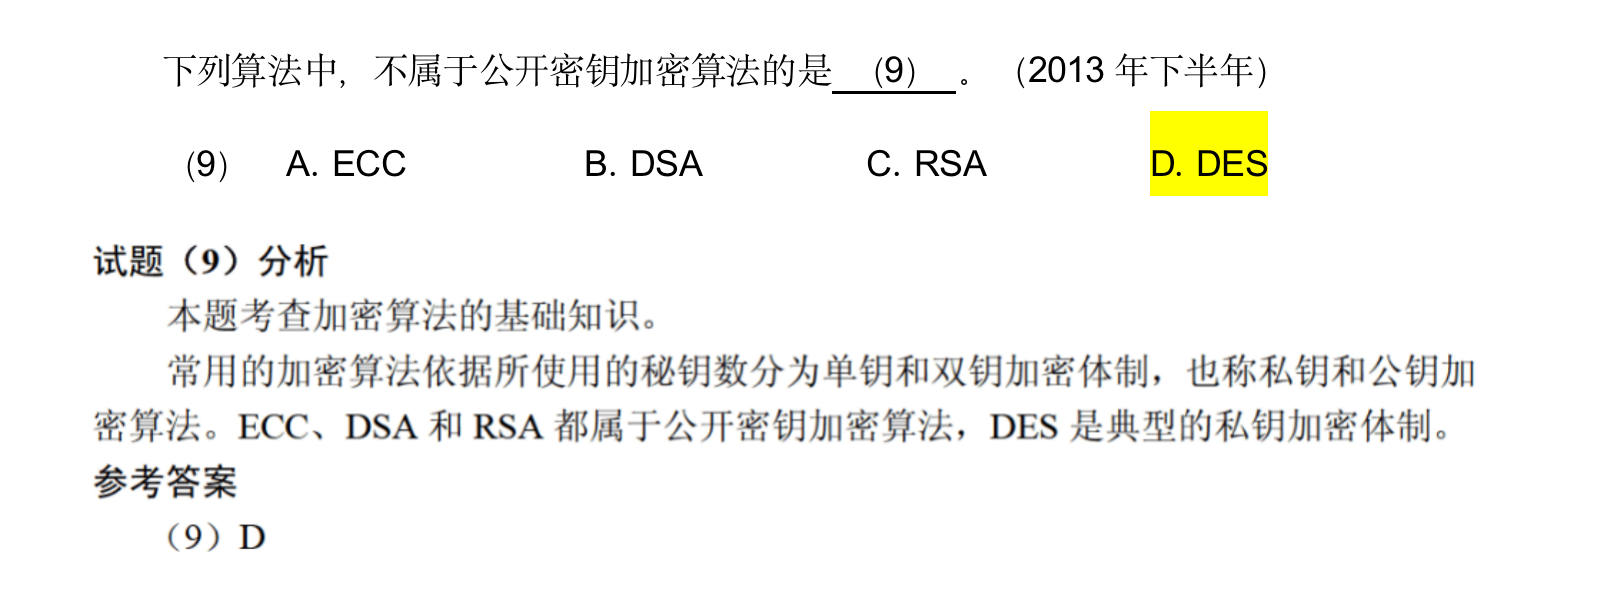
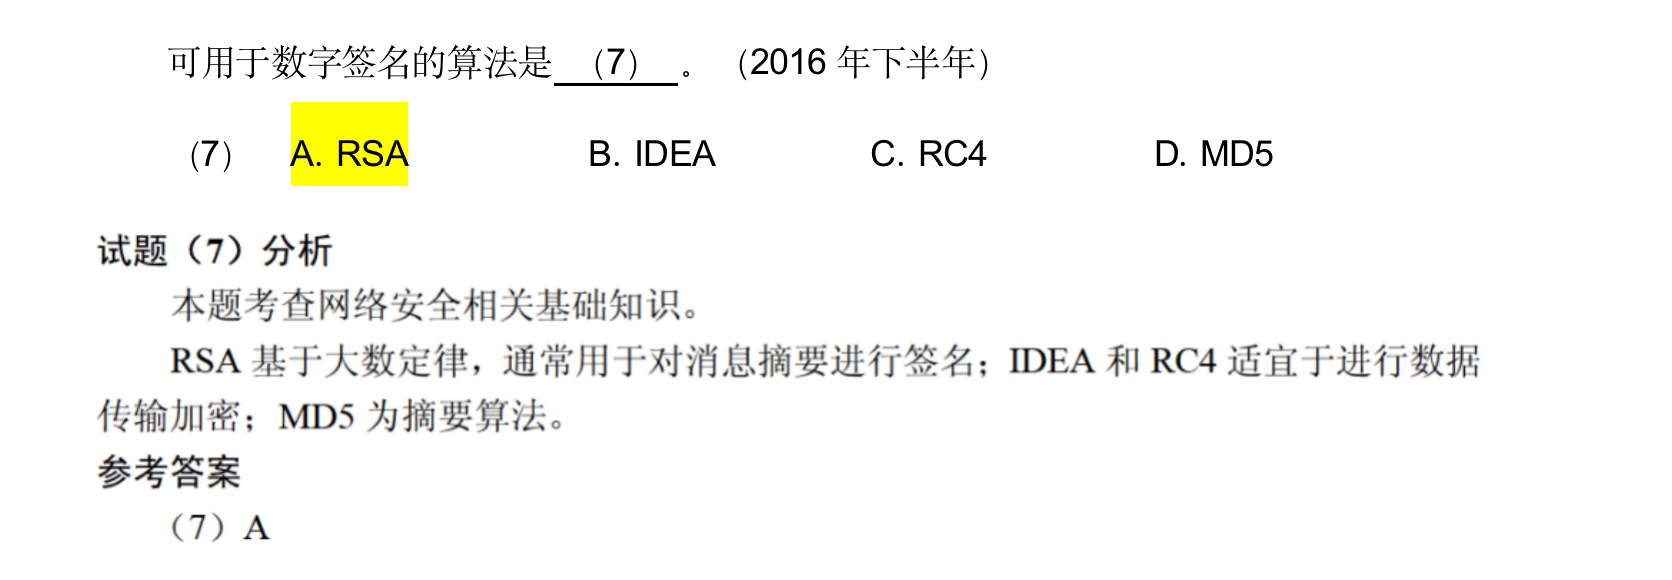
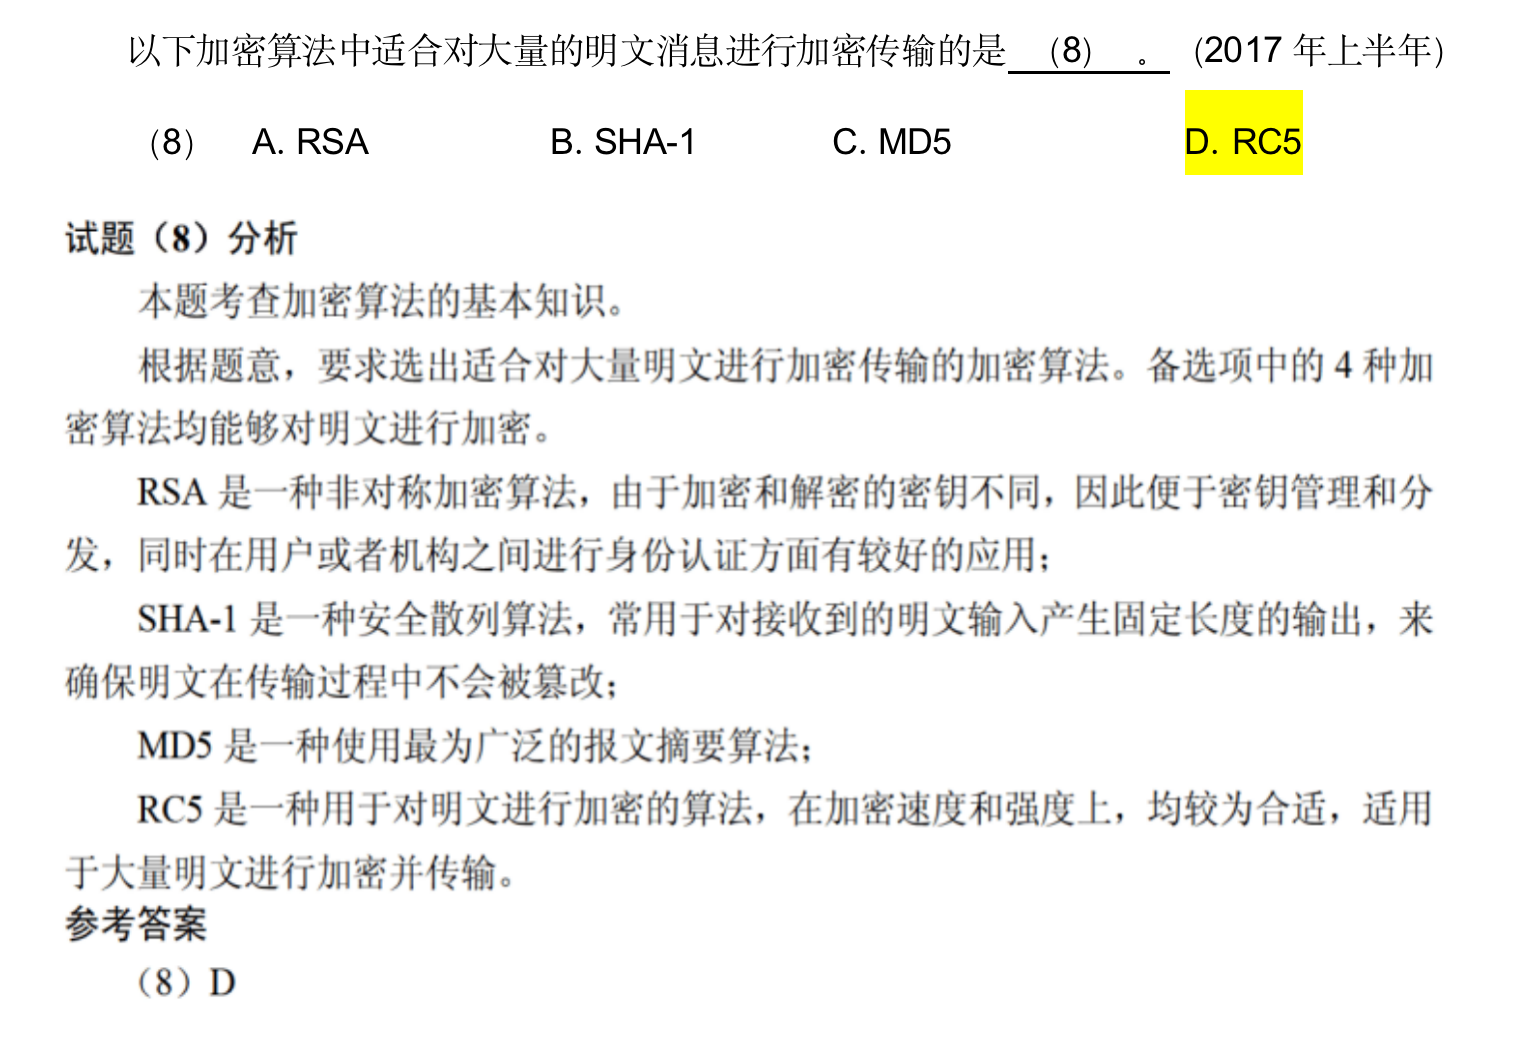
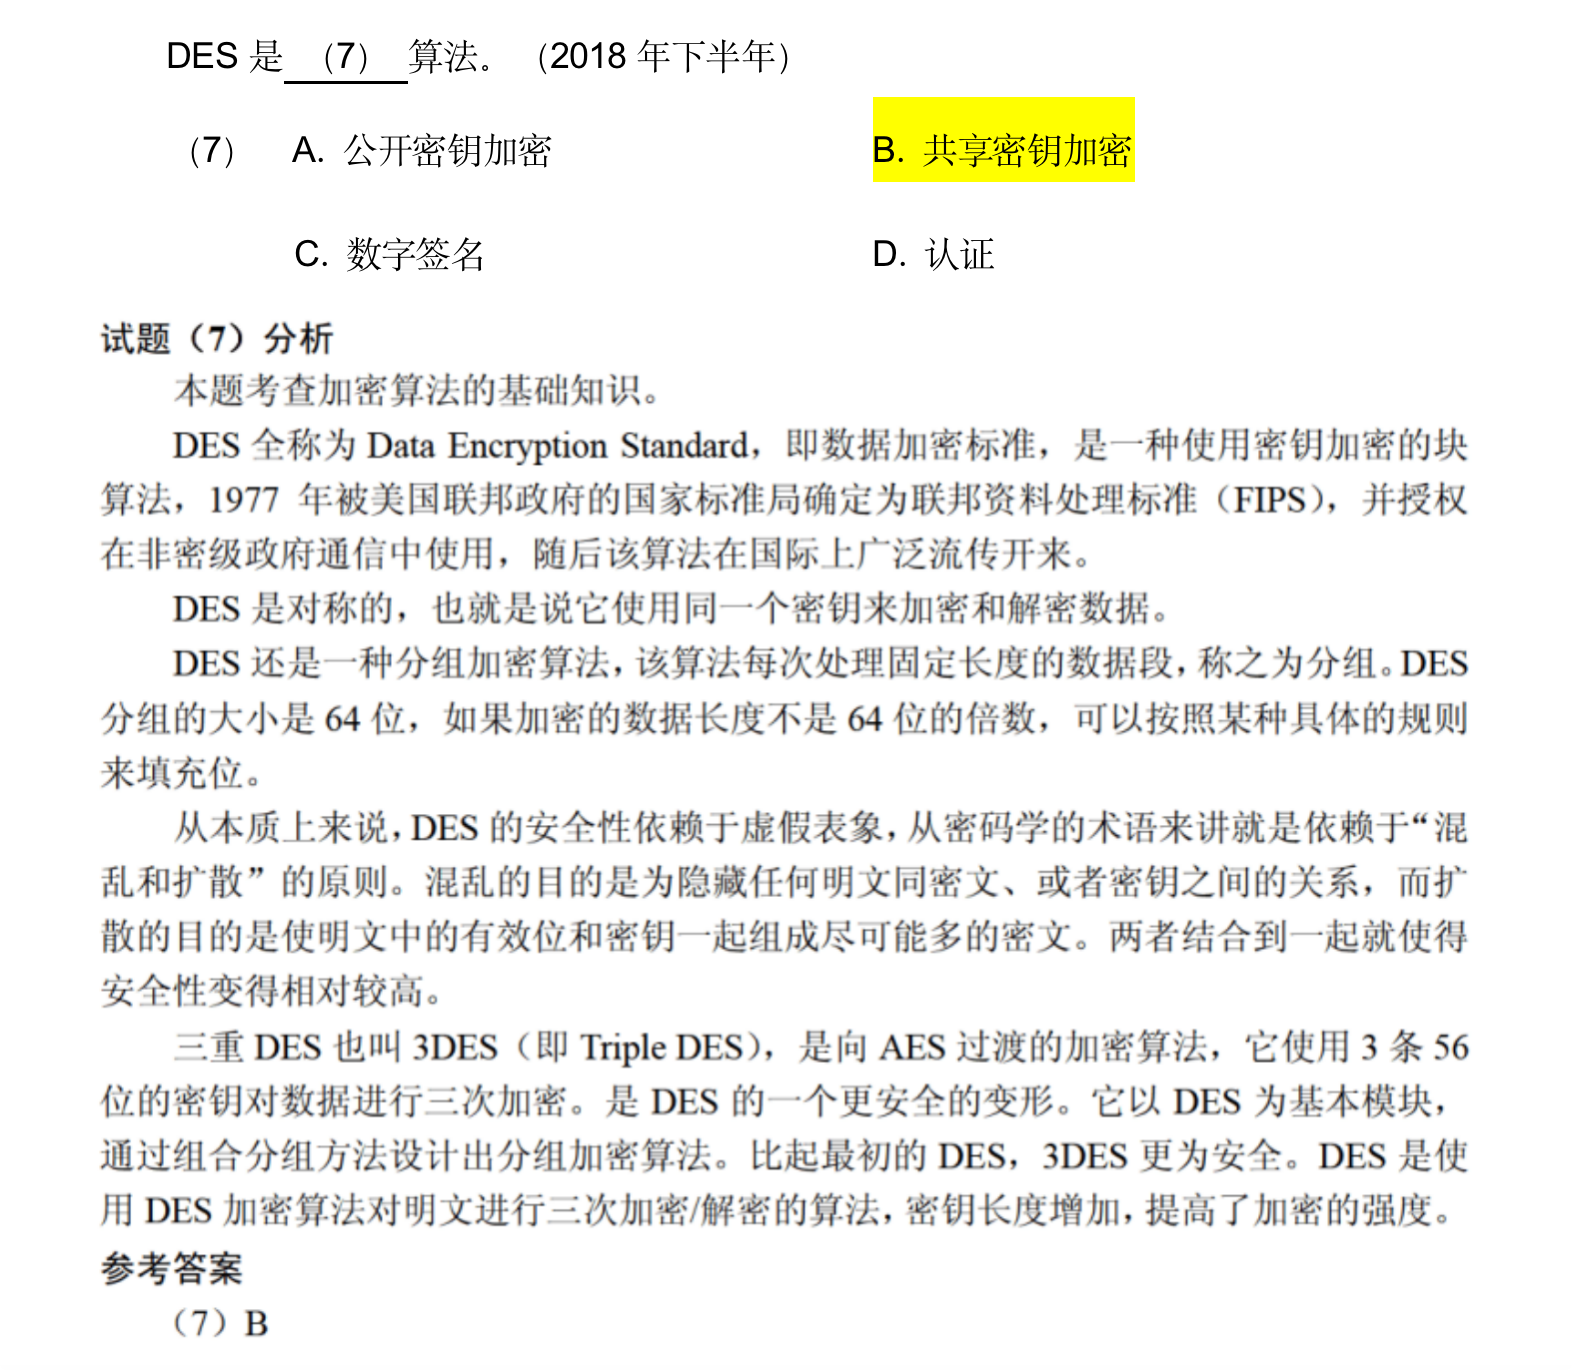
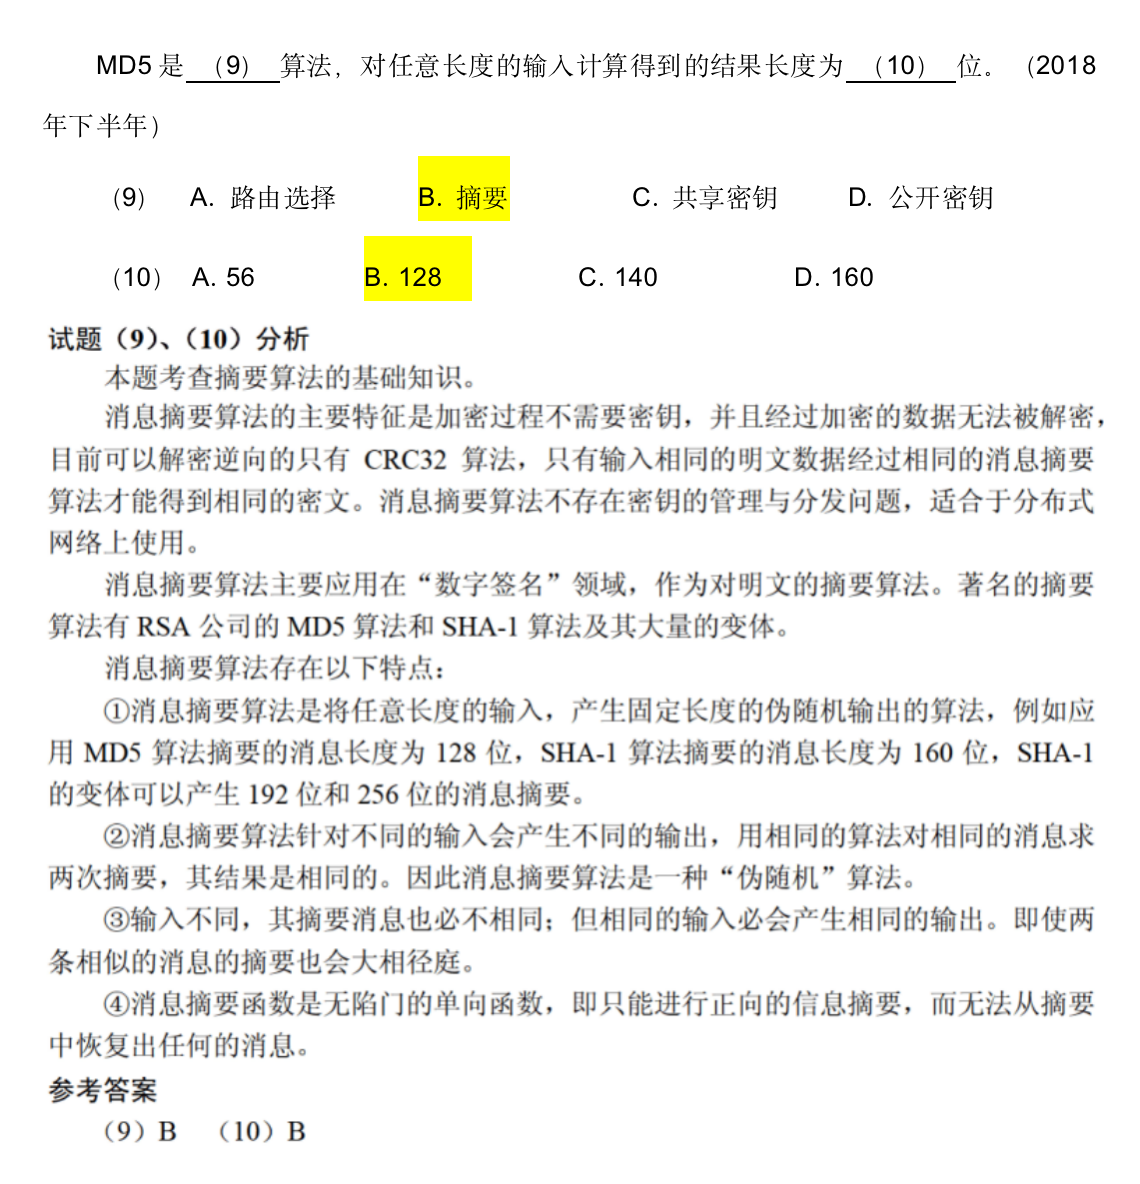
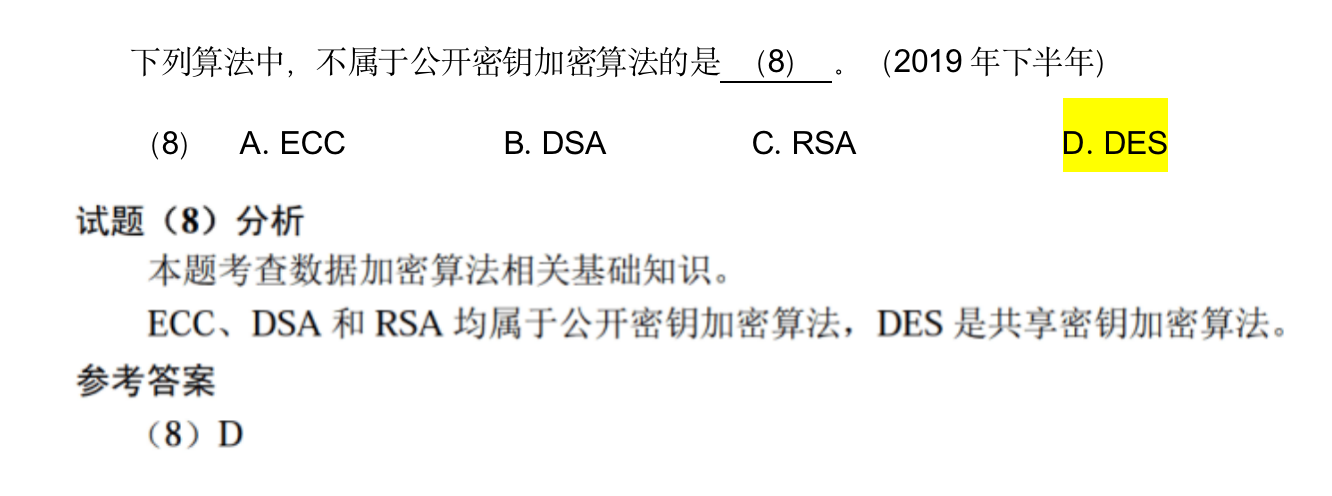
加密算法
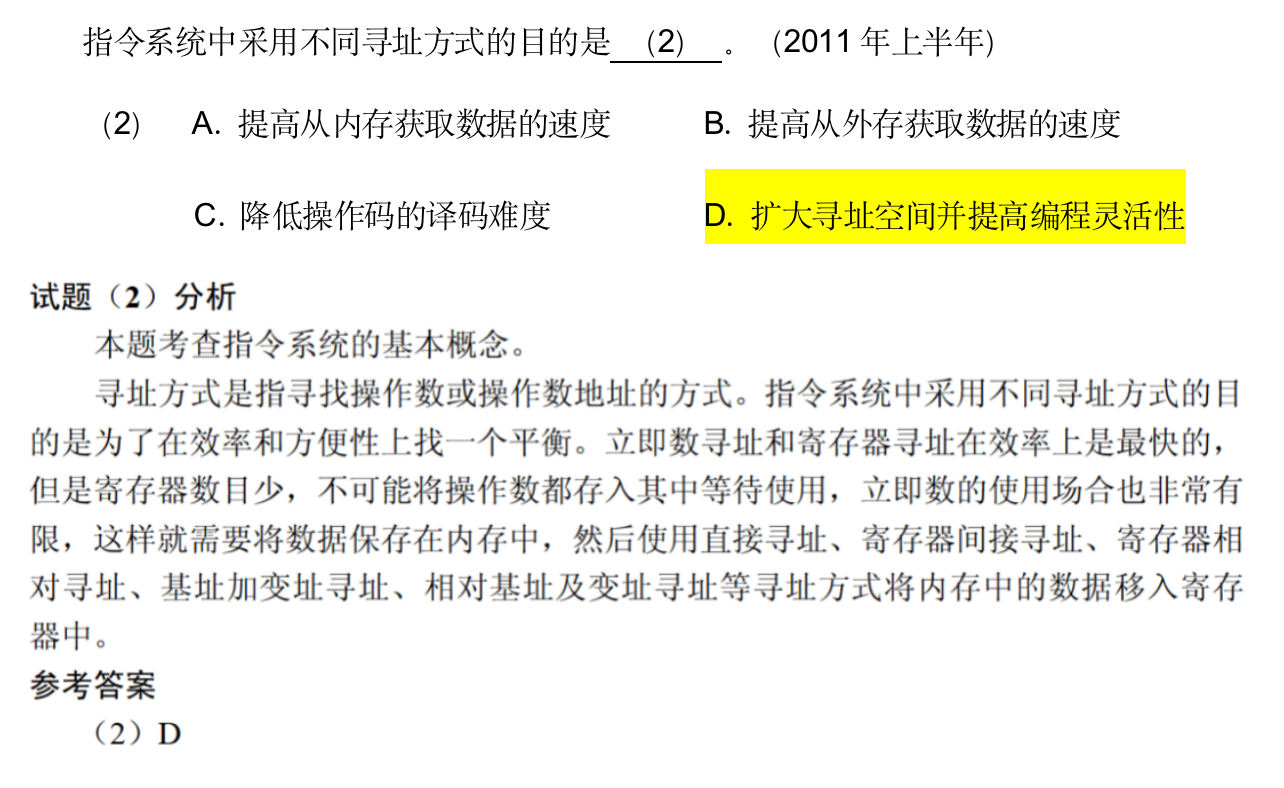
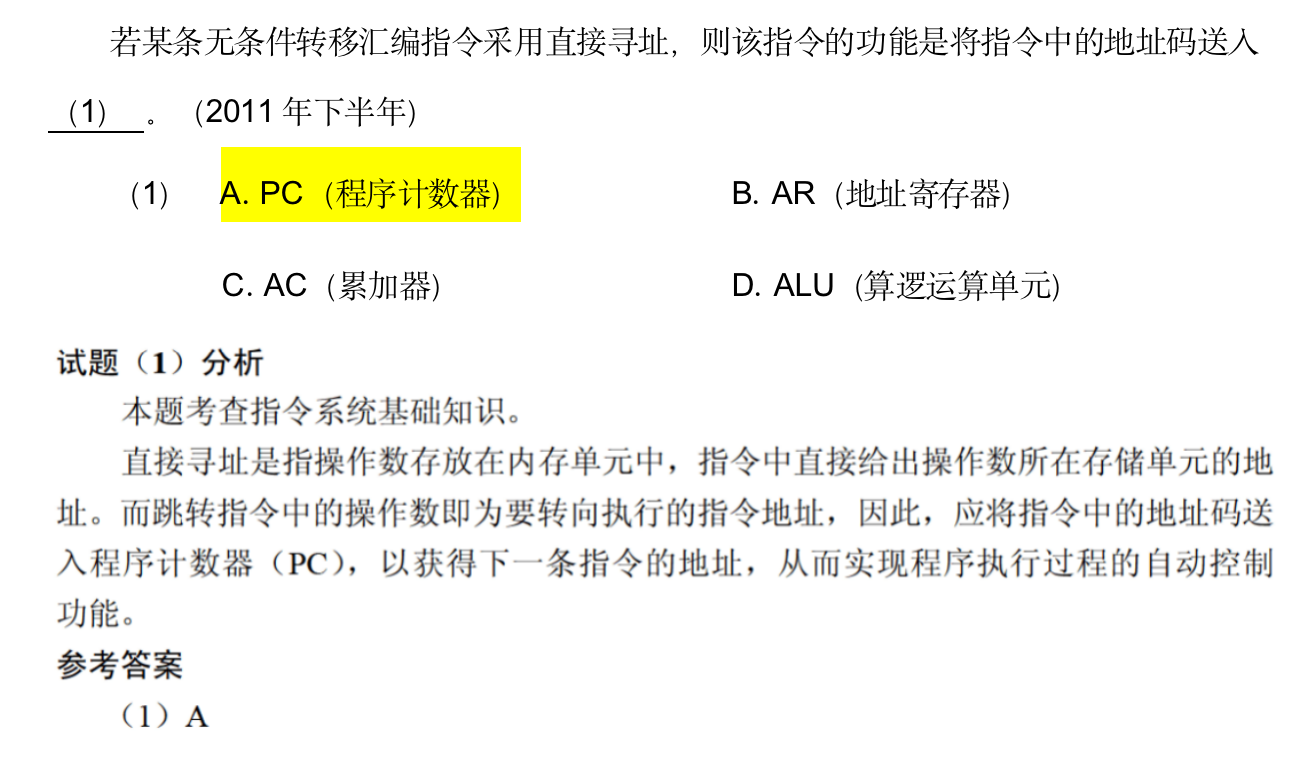
寻址
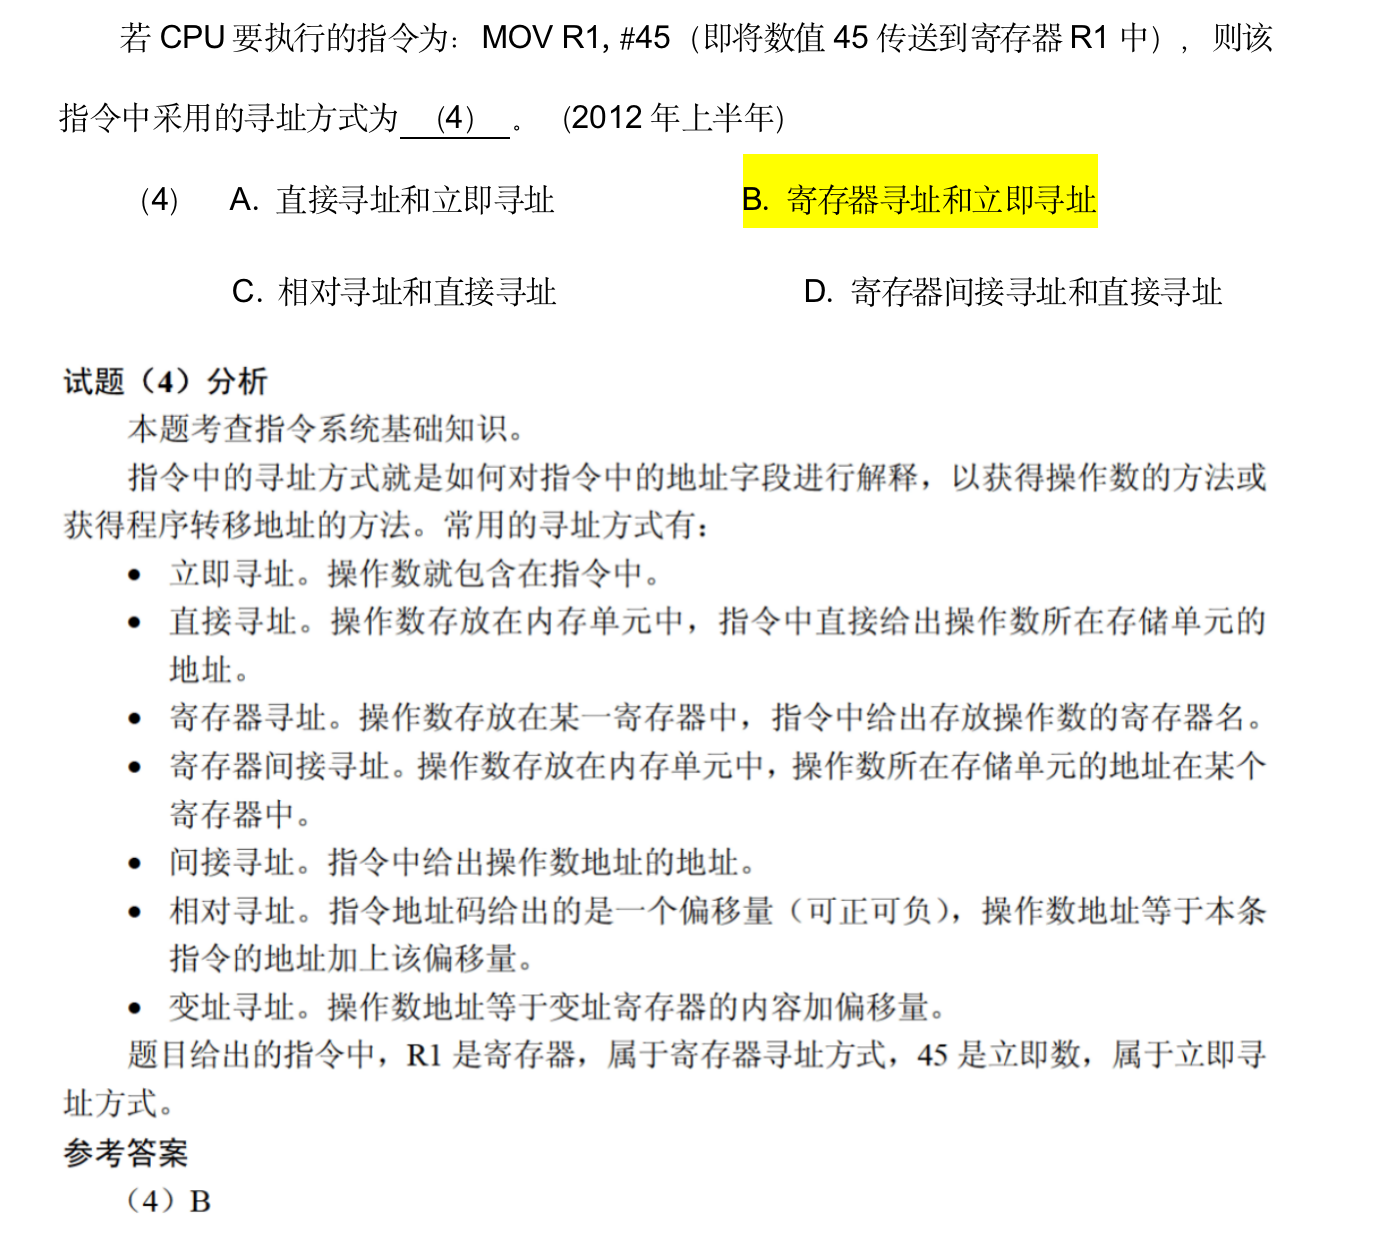
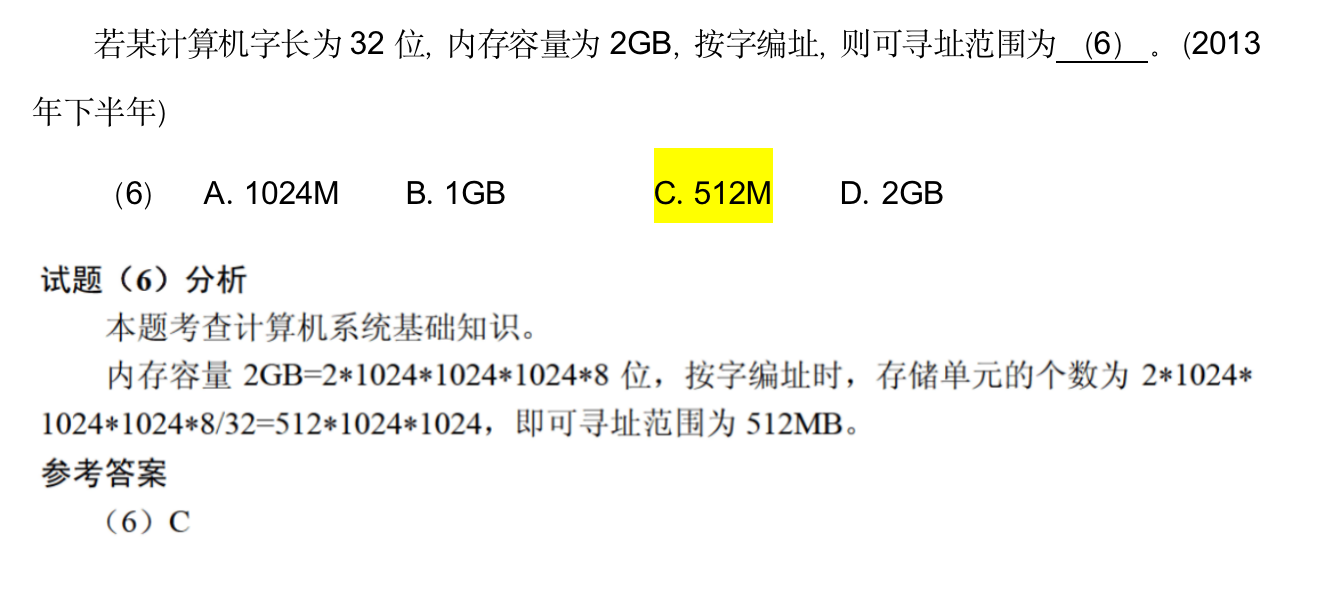
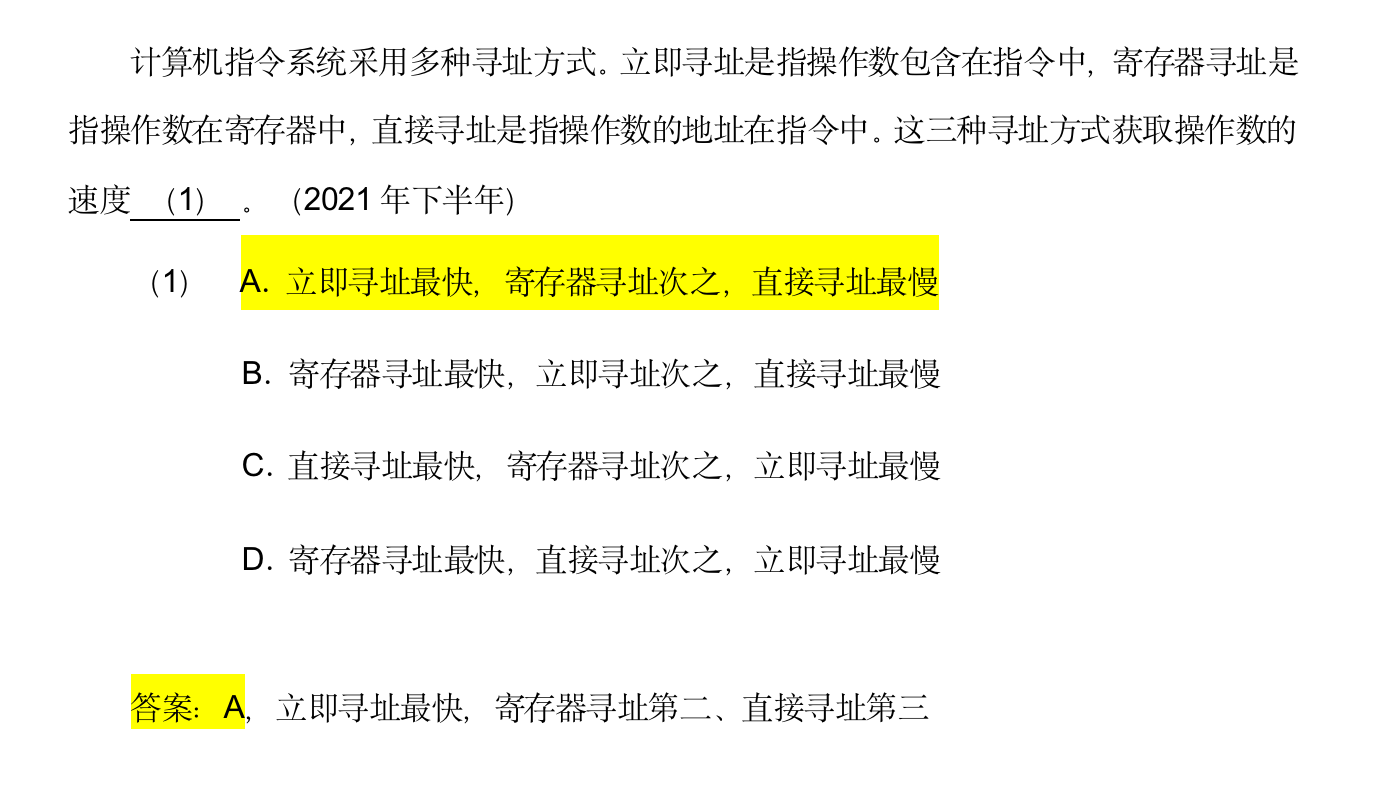
计算周期
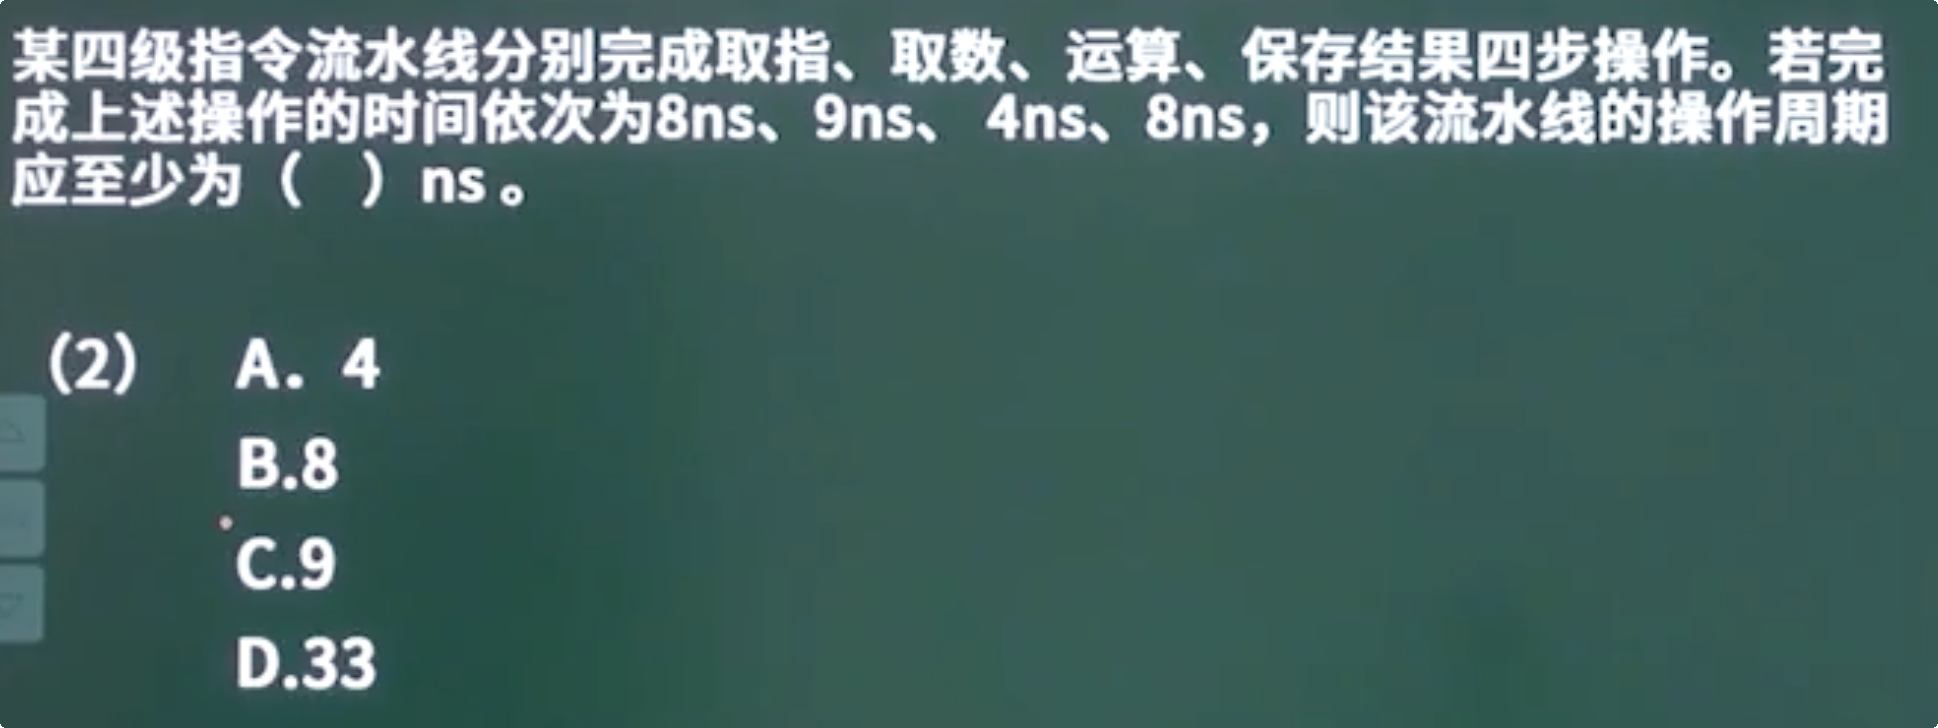
答:选C。由于题意中流水线分别完成四个操作,可得出为并行操作。故取操作中时间最长的,即为流水线的操作周期,即至少为9ns。
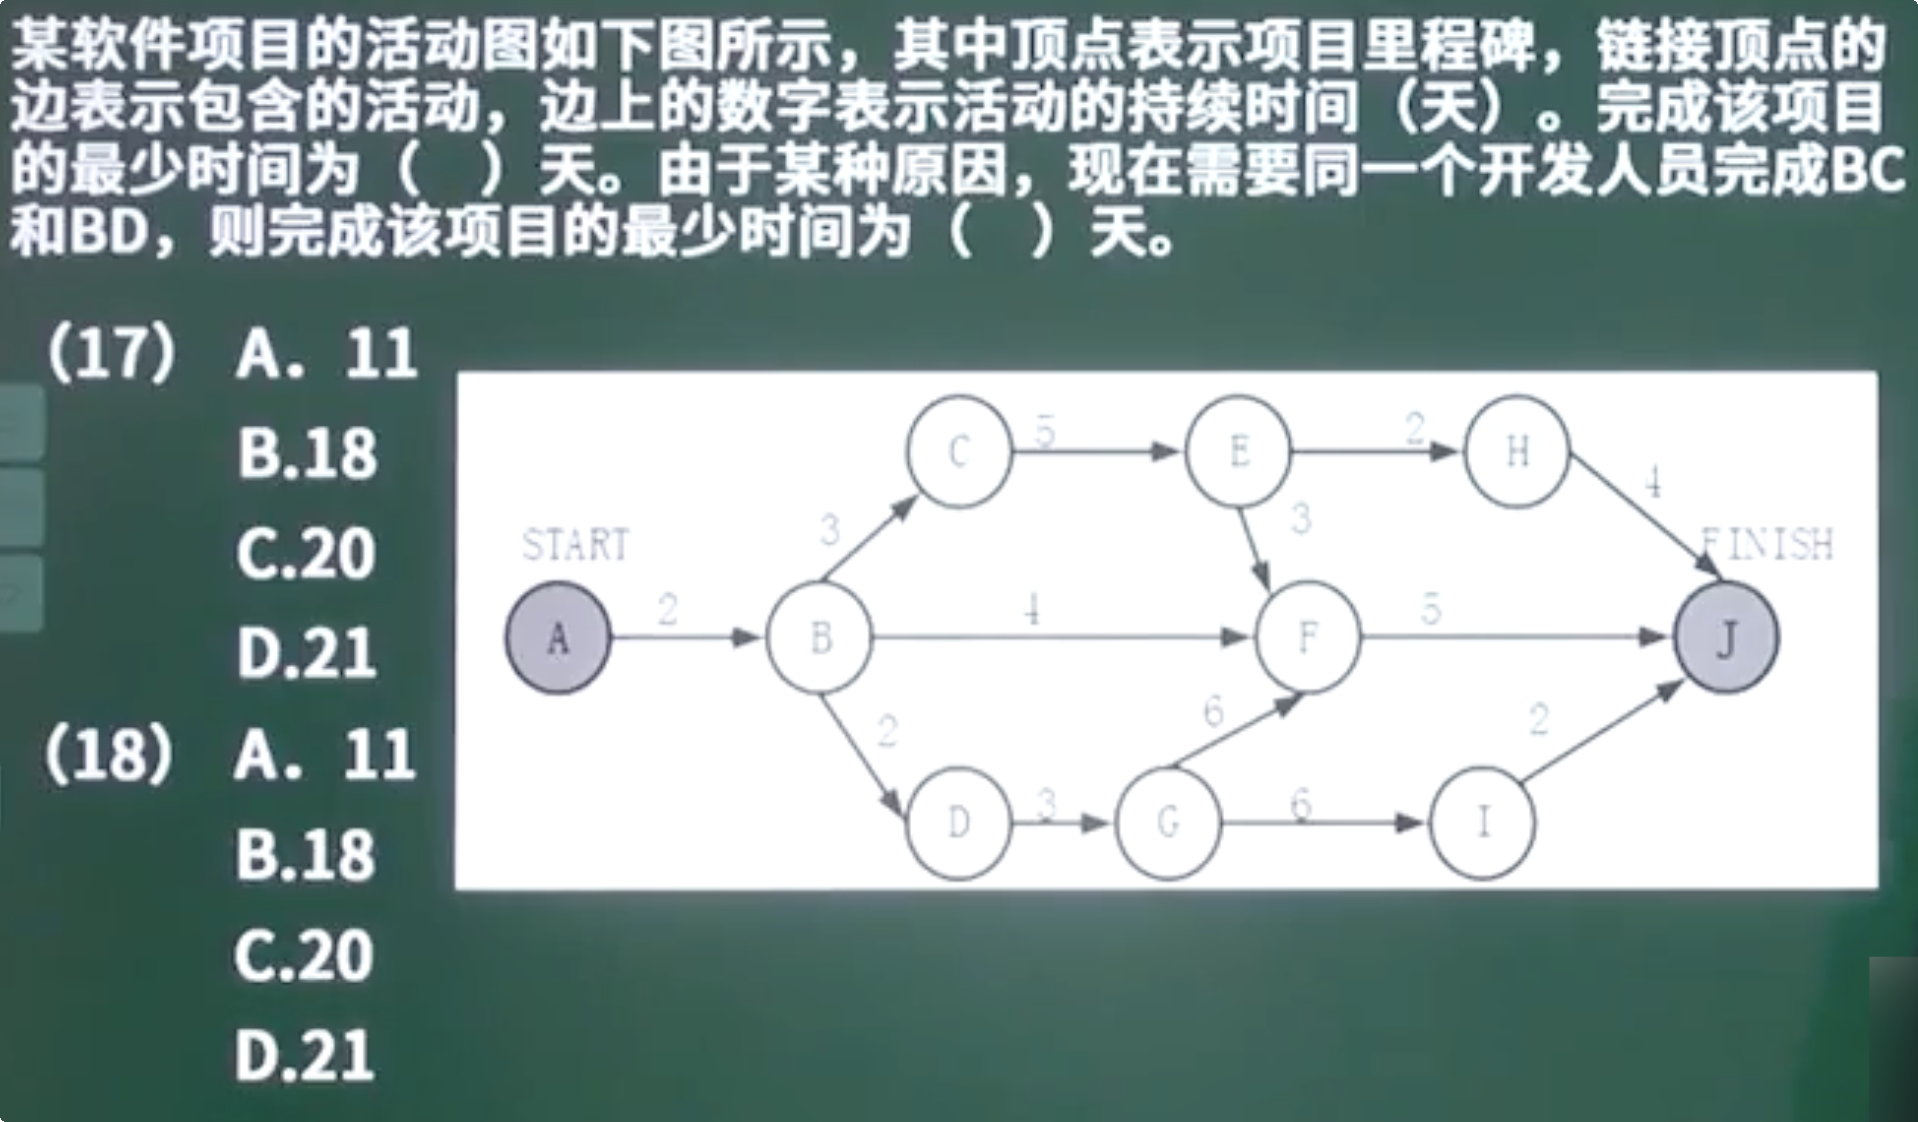
答:17、选B。 18、选C。
(17)对于拓扑图中,计算最少时间,是由其中最大的路径时间决定。
关键路径有两条,如下:
A->B->C->E->F->J (2+3+5+3+5=18)
A->B->D->G->F->J (2+2+3+6+5=18)
故该项目的最少时间为18天。
(18)由于先完成BC,再从BD完成项目,BD的开始时间由原来的2变成5,则总的项目时间由原来的18变成21天。先完成BD,再从BC完成项目,BC的开始时间由原来的2变成4,总的项目时间由原来的18变为20天,故完成该项目的最少时间为20天。
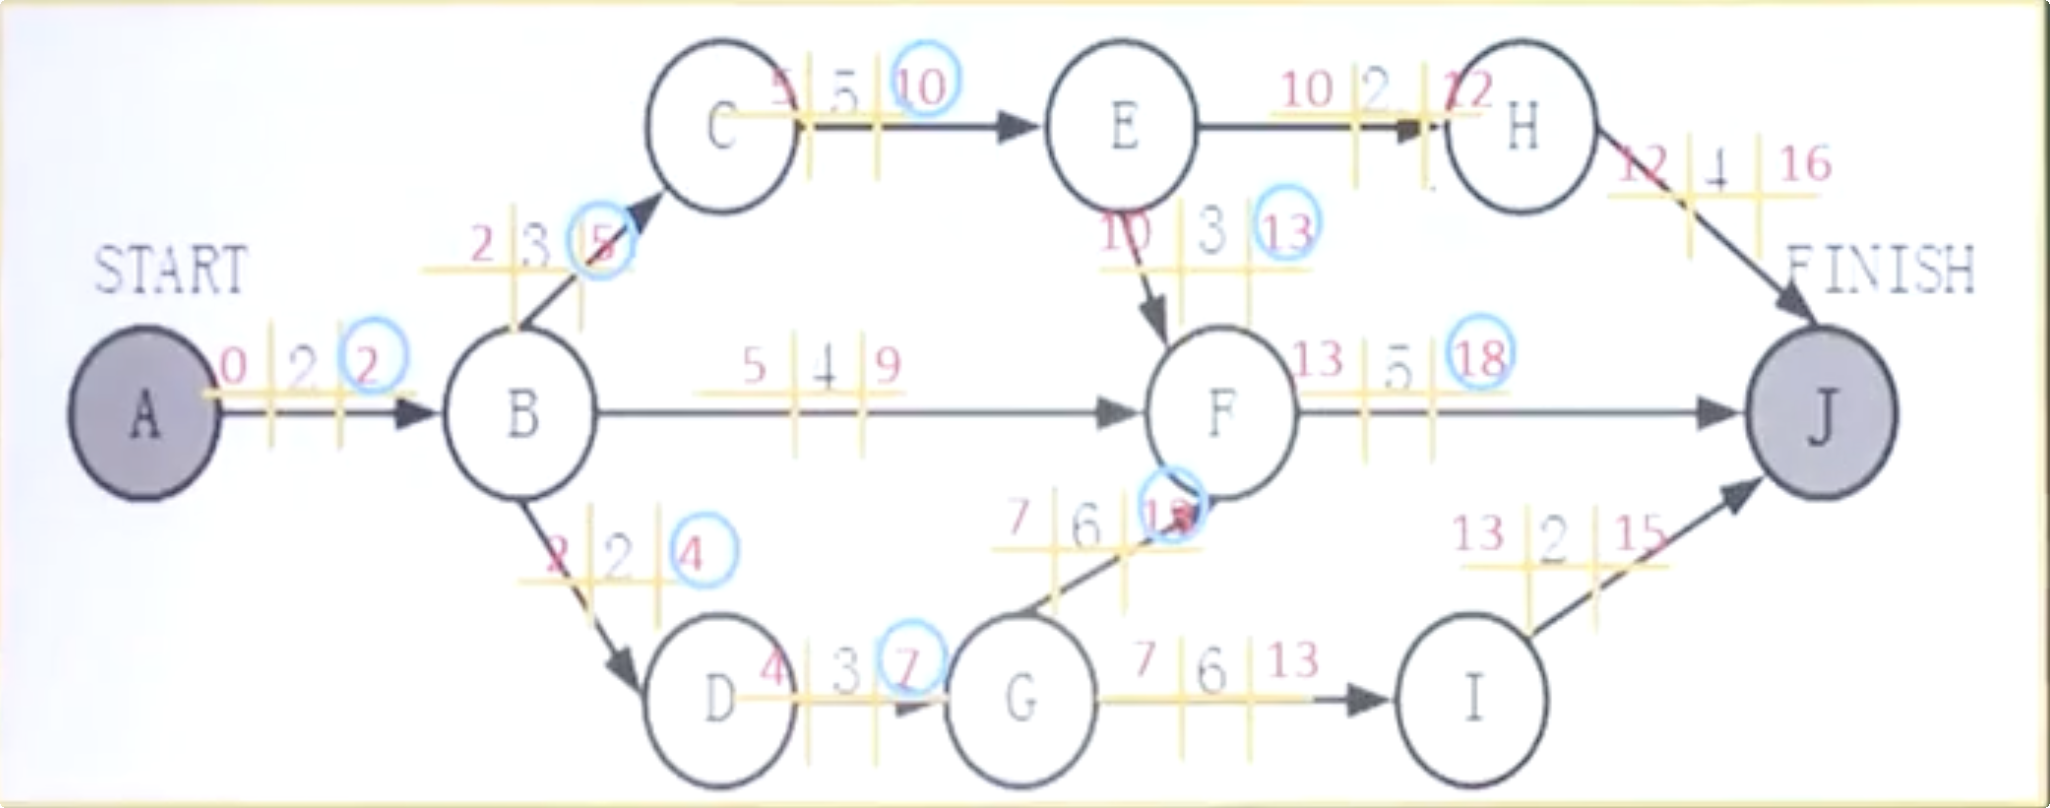
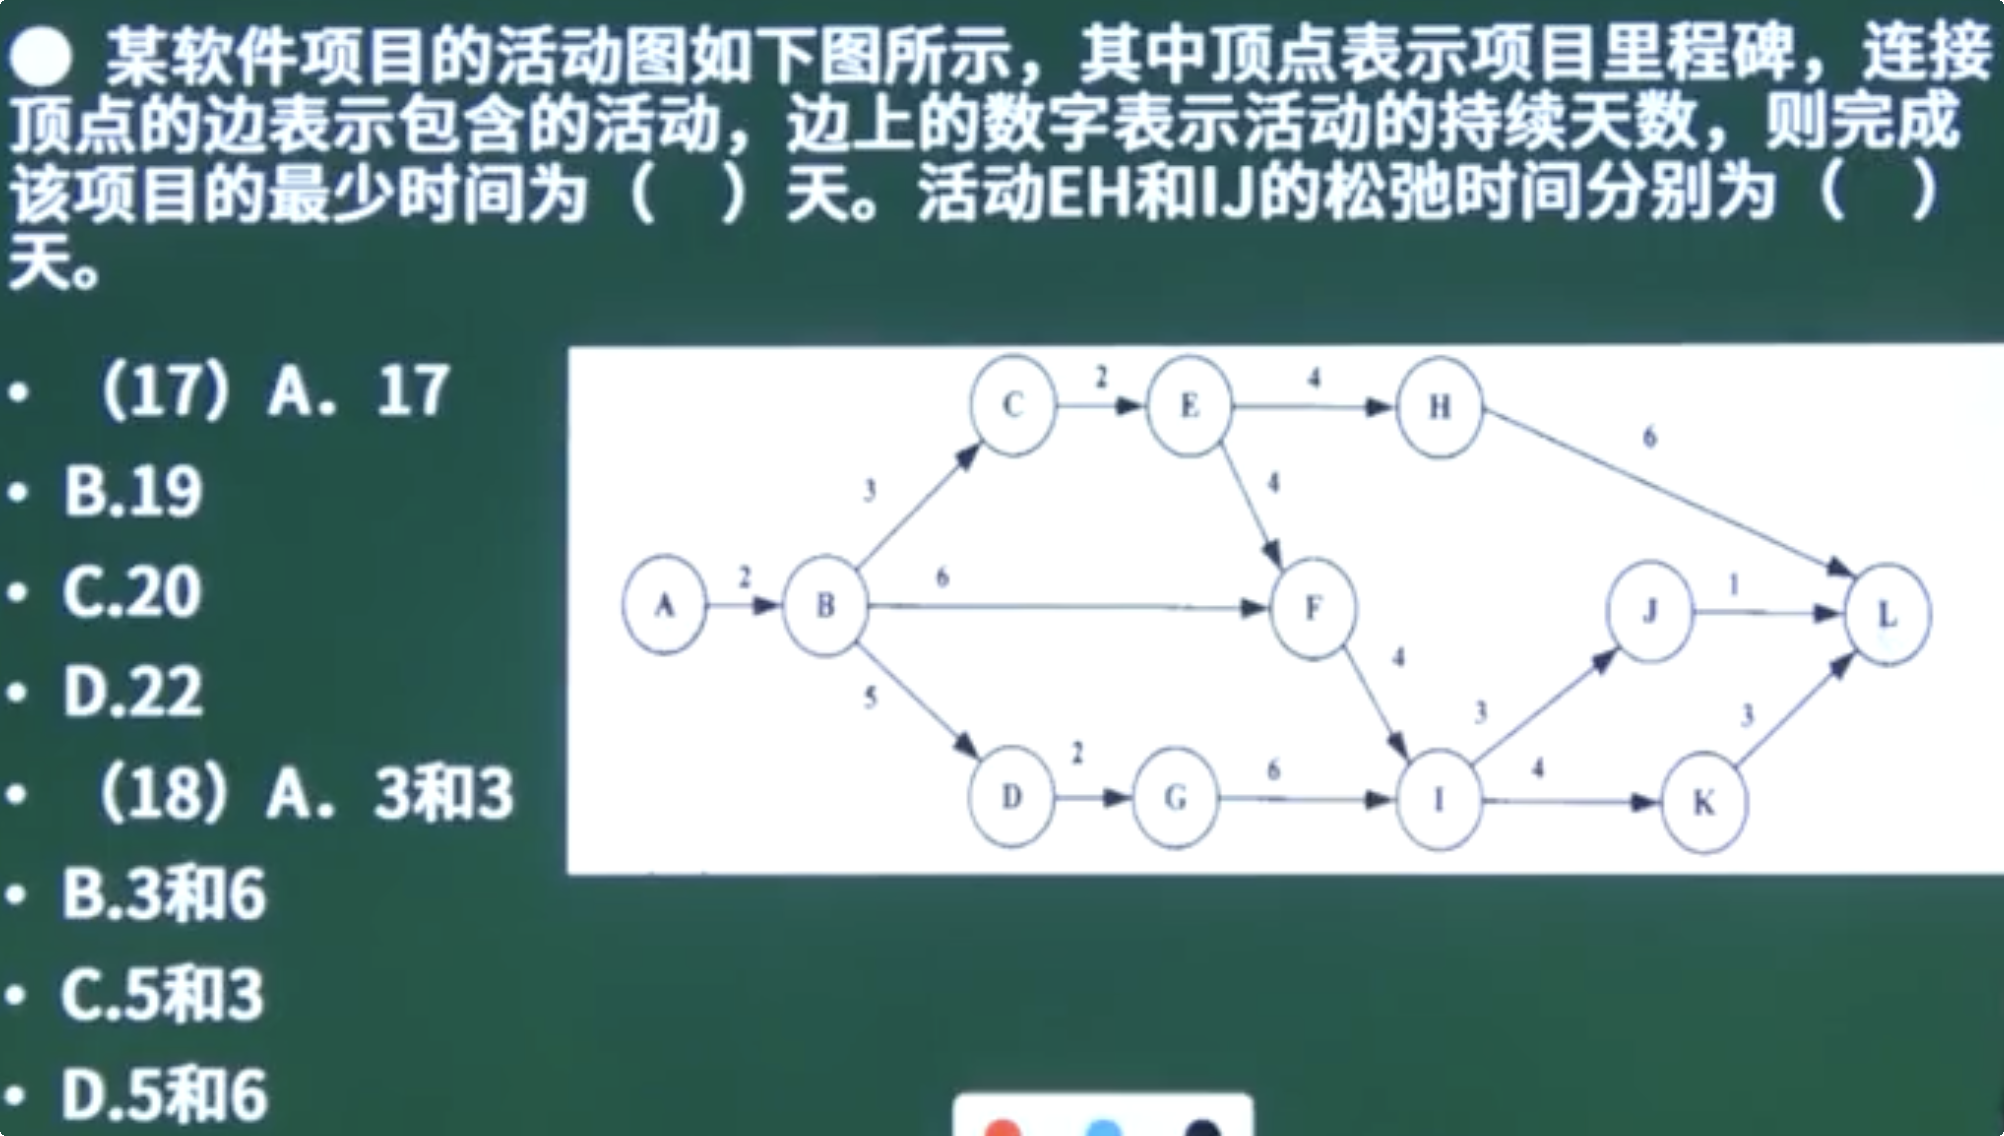
答:(17)D (18)C。
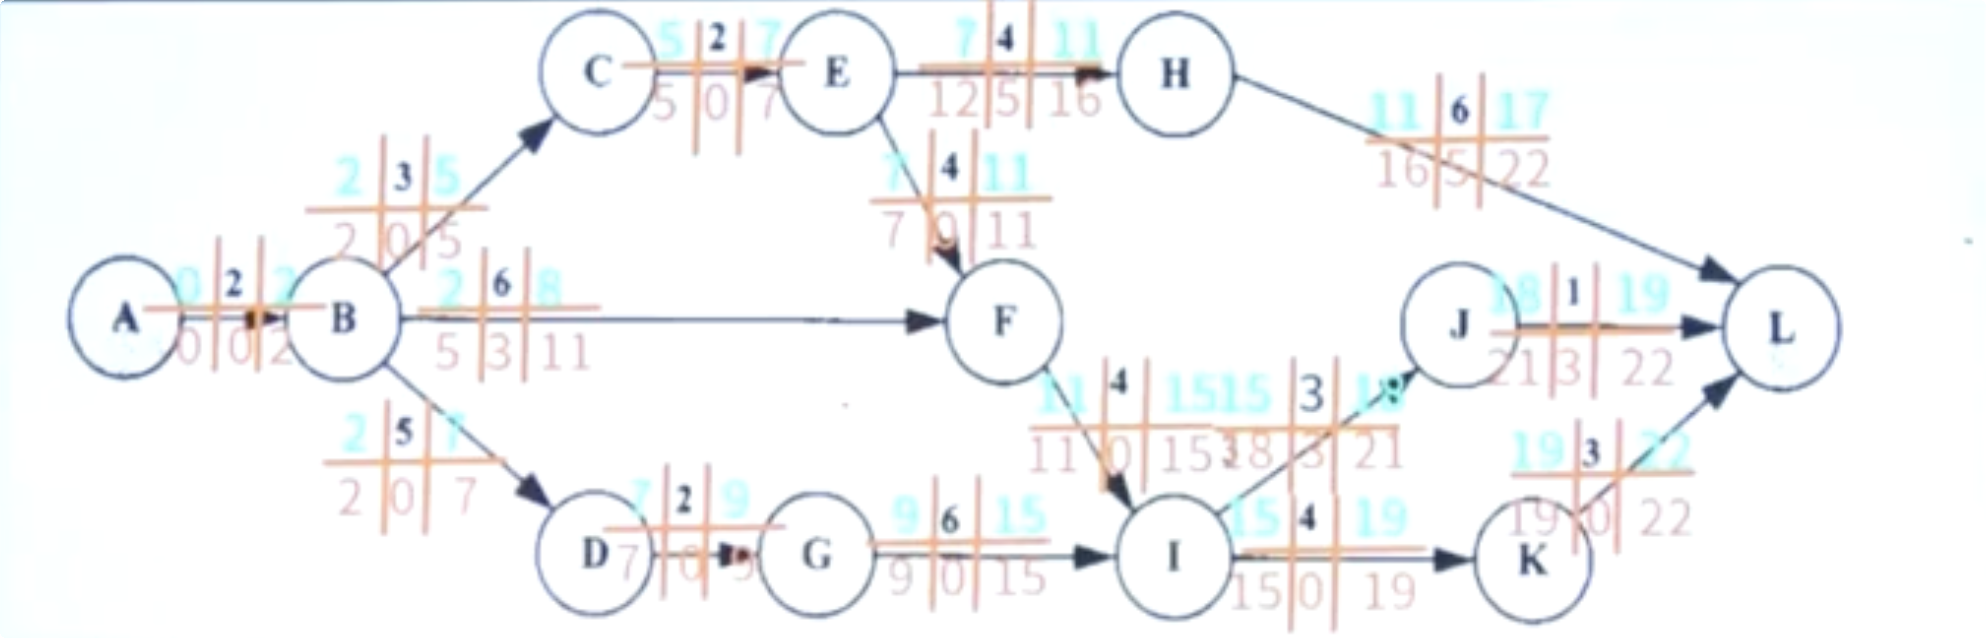
(图中:上边是:最早开始时间|持续时间|最早完成时间,下边是:最晚开始时间|松弛时间|最晚结束时间)
项目的最少时间=项目周期=最长活动路径,从图中可得知最晚结束时间是22天。
松弛时间=最晚结束时间-最早结束时间时间,从图中得知松弛时间分别是5天和3天。
CPU
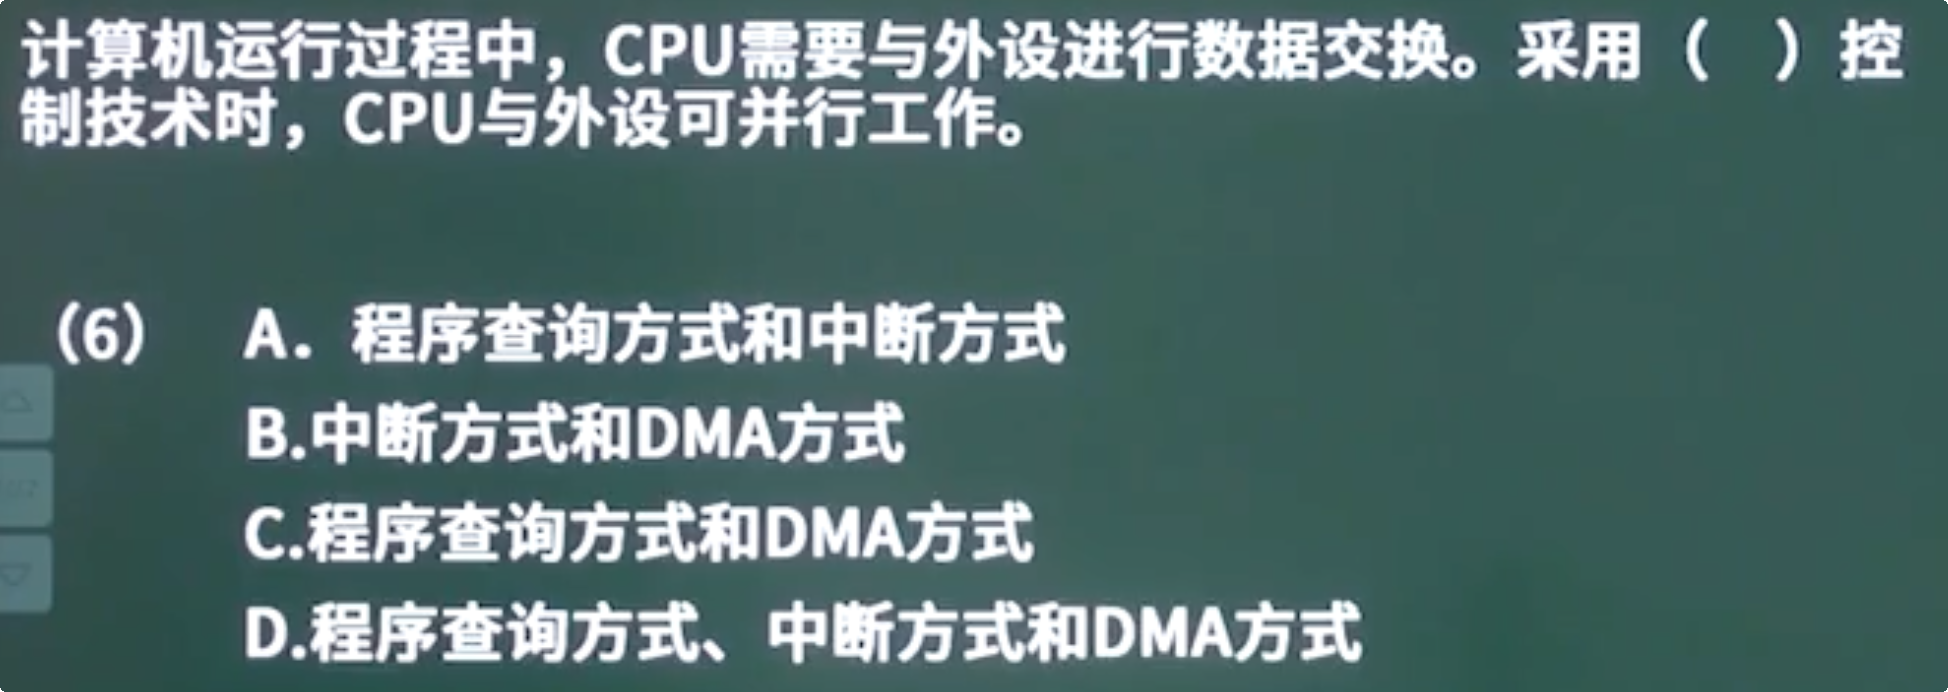
答:选B。在CPU与外设进行数据交换,如果使用程序查询方式,CPU会一直的发送查询请求查看数据是否交换完成,没有则持续等待,故无法与外设并行工作。排除选项故选B。
安全
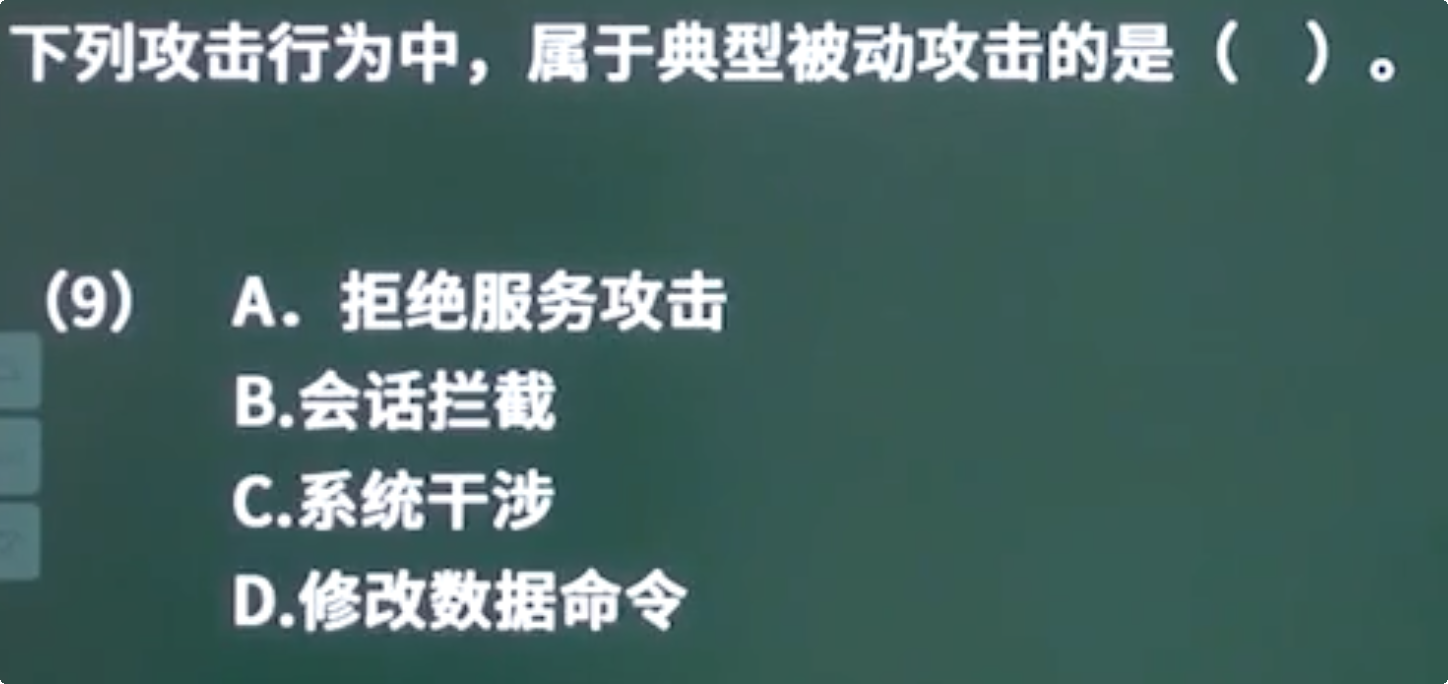
答:选C。A、B、D是典型的主动攻击。
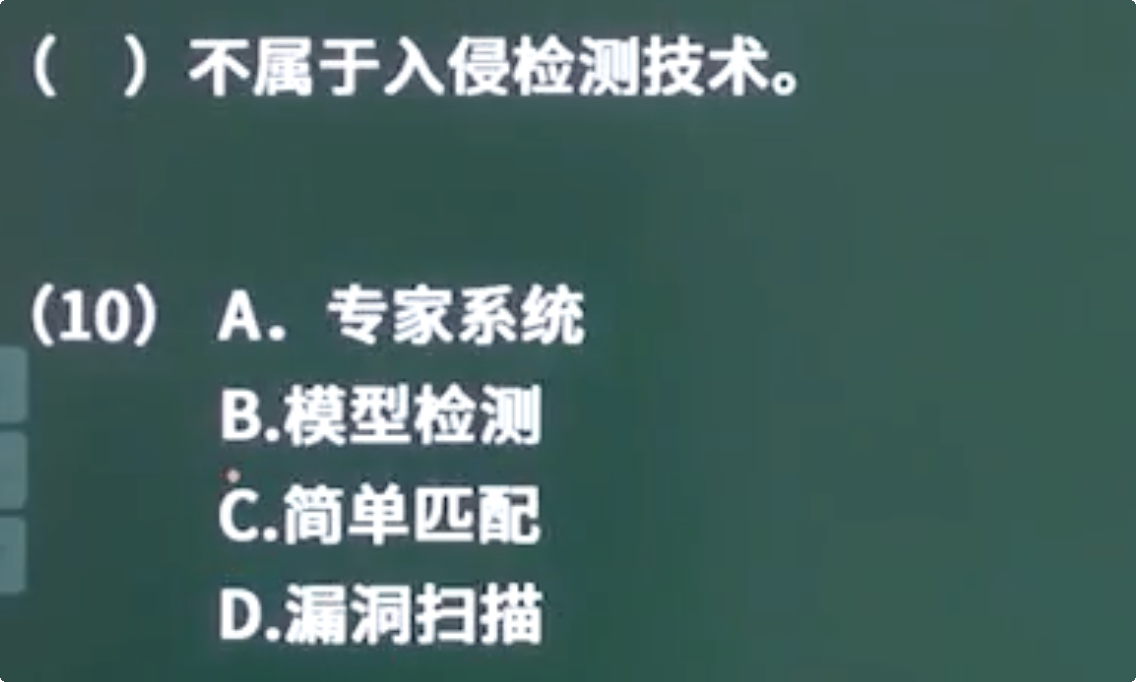
答:选D。
专家系统、模型检测和简单匹配都属于入侵检测技术,用于检测和响应潜在的安全威胁。
然而,漏洞扫描并不属于入侵检测技术。漏洞扫描是一种安全防护策略,它基于漏洞数据库,通过扫描等手段对指定的远程或本地计算机系统的安全脆弱性进行检测。
与入侵检测技术不同,漏洞扫描主要用于发现系统的弱点,而不是检测恶意活动或入侵行为。
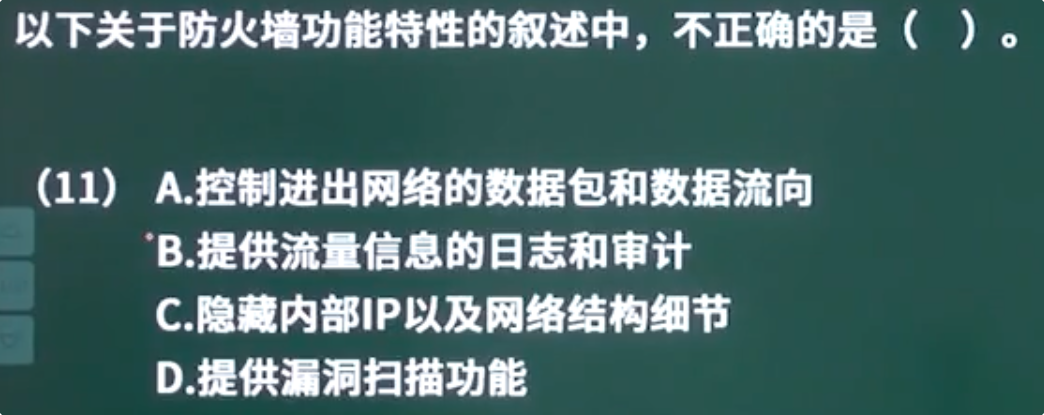
答:选D。
防火墙是一种网络安全系统,由软件和硬件设备组合而成,用以及时发现并处理计算机网络运行时潜在各种安全问题的网络安全系统。防火墙的主要功能是策略(policy)和机制(mechanism)的集合,它通过==对流经数据流的报文头标识进行识别,以允许合法数据流对特定资源的授权访问==,==从而防止那些无权访问资源的用户或程序对受保护的网络资源进行非法访问、使用、篡改或破坏==。
防火墙具有以下优点:
1、强化安全策略;
2、有效地记录Internet上的活动;
3、限制暴露用户点;
4、隔开网络中一个网段与另一个网段。
数据流
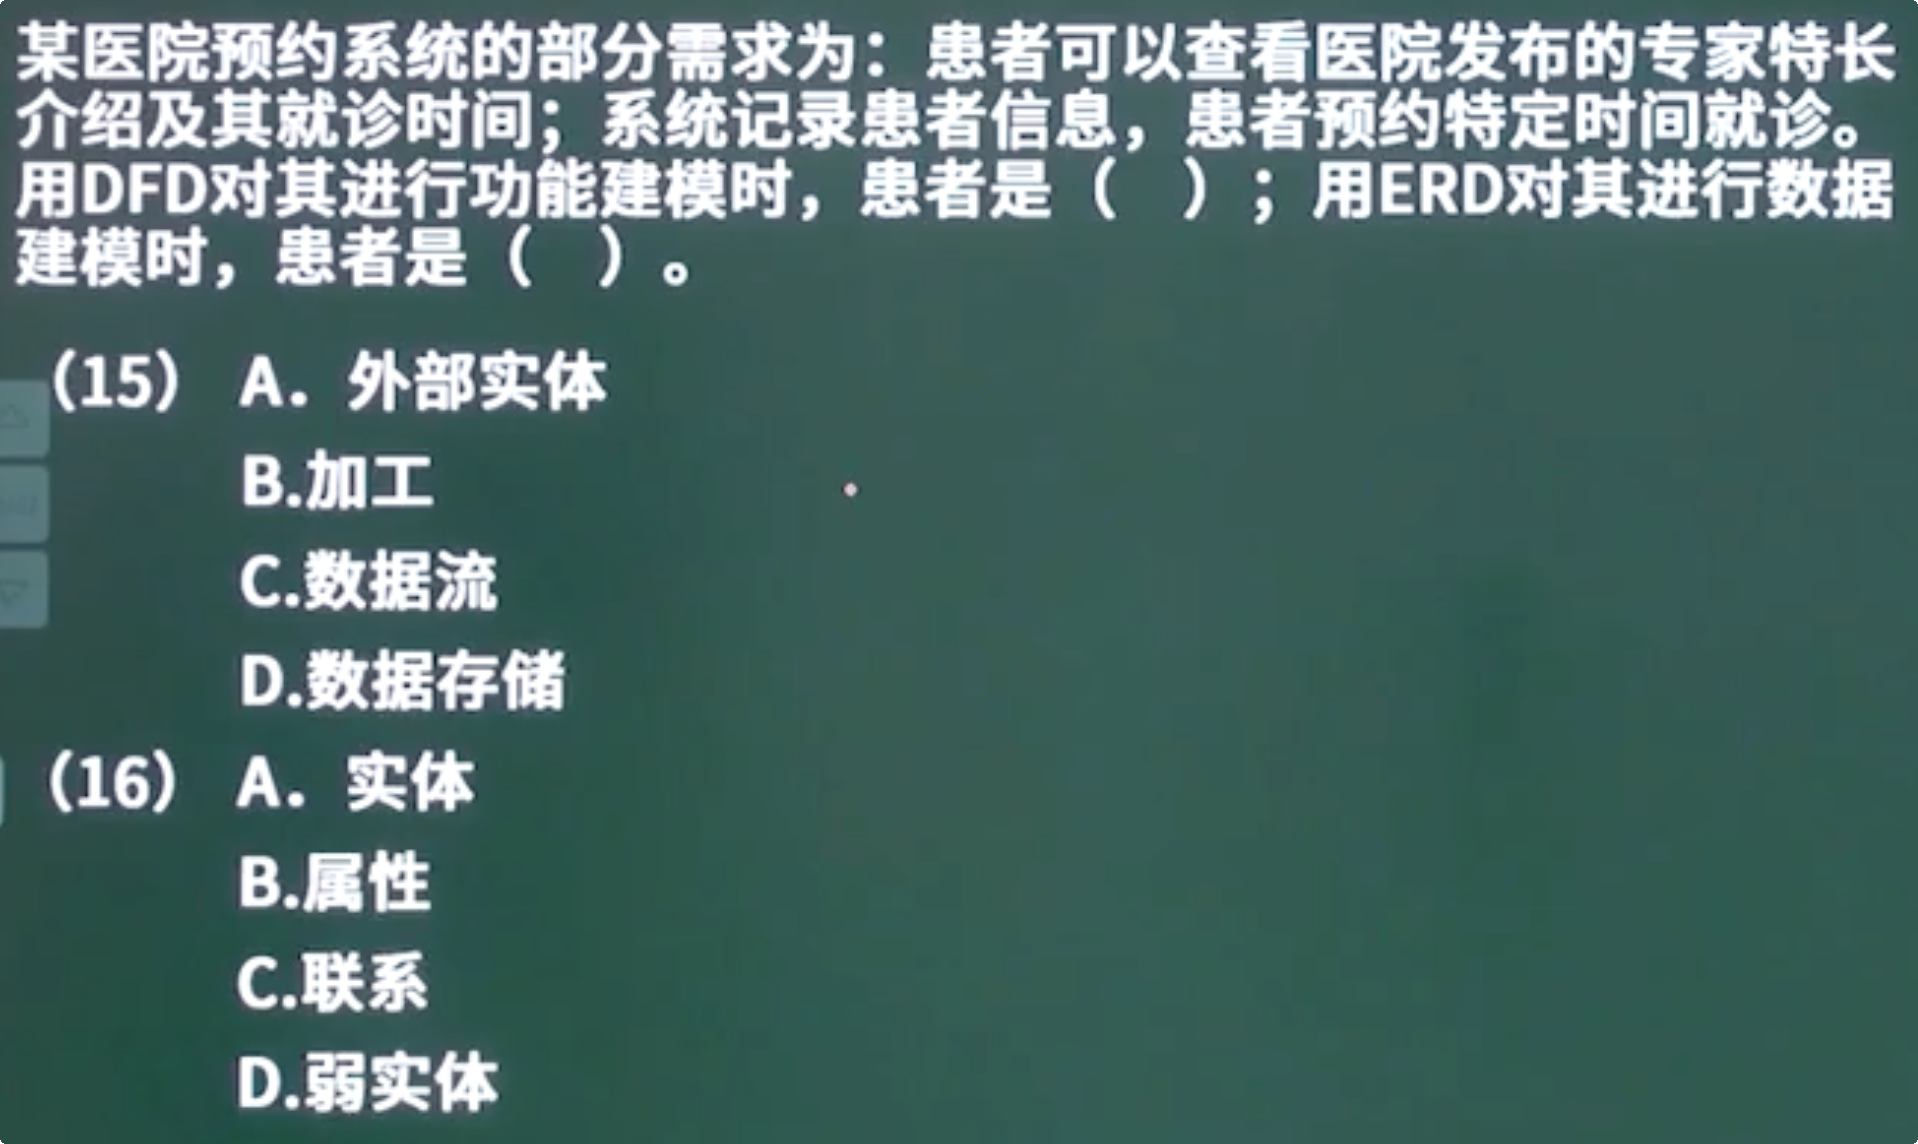
答:(15)A (16)A。
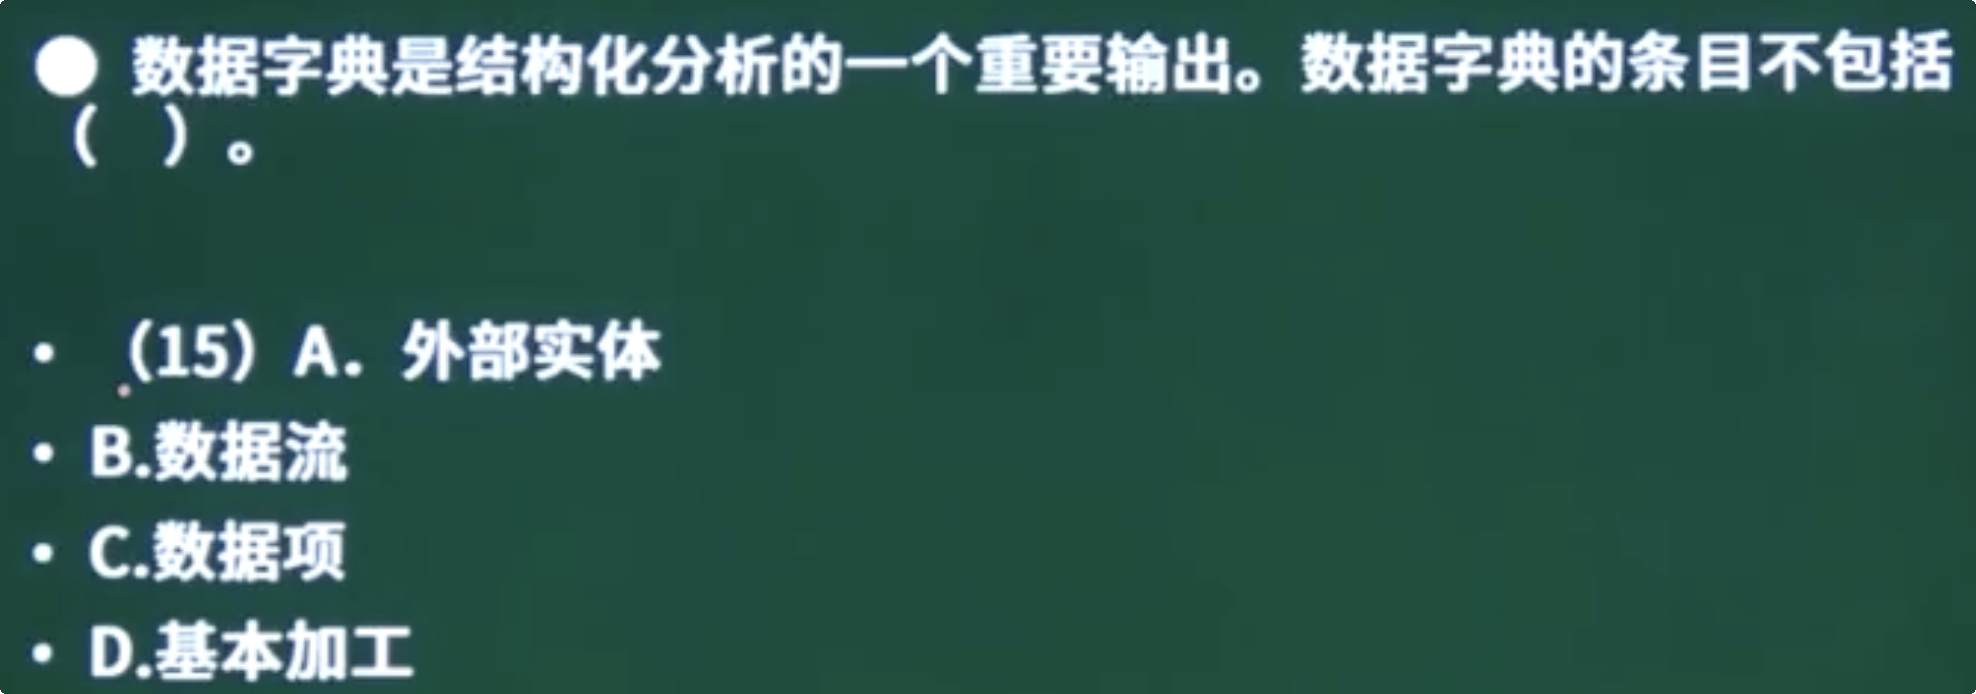
答:选A。数据字典的条目包括数据流、数据项、基本加工。
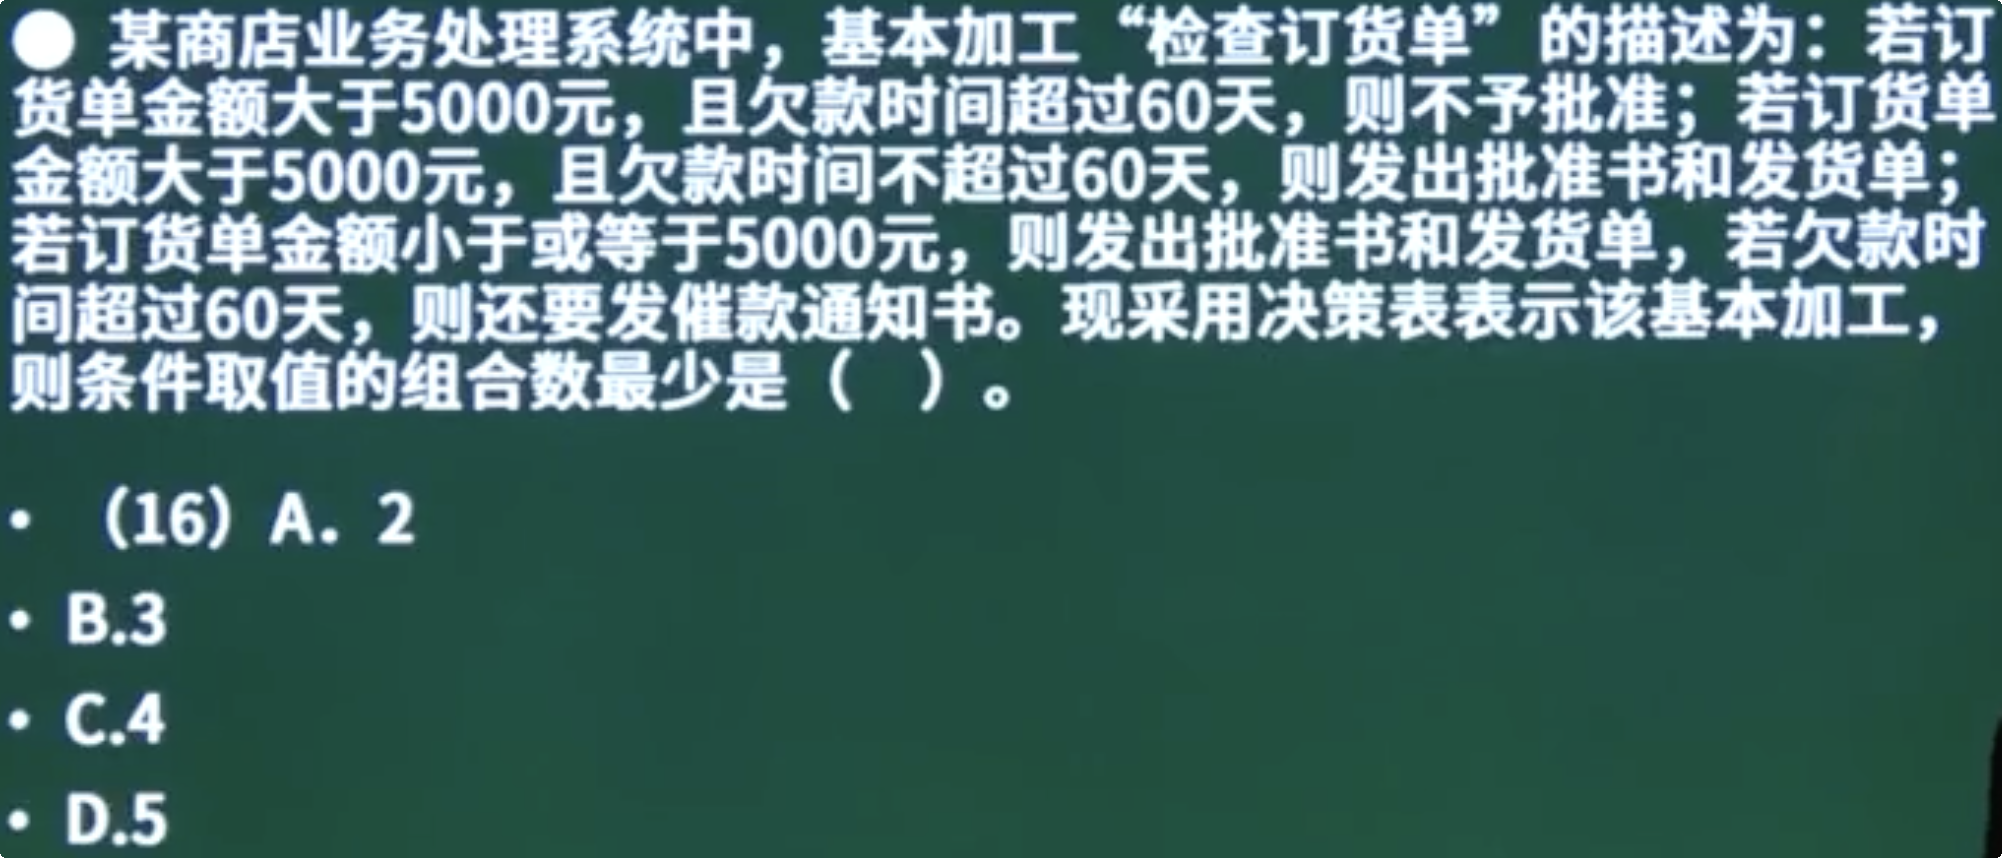
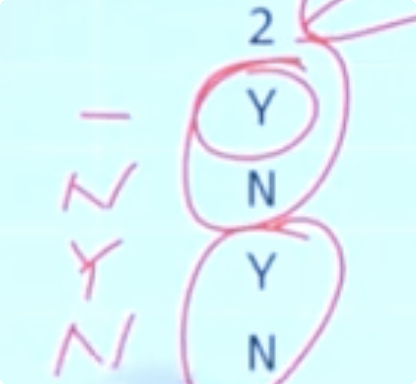
答:选B。
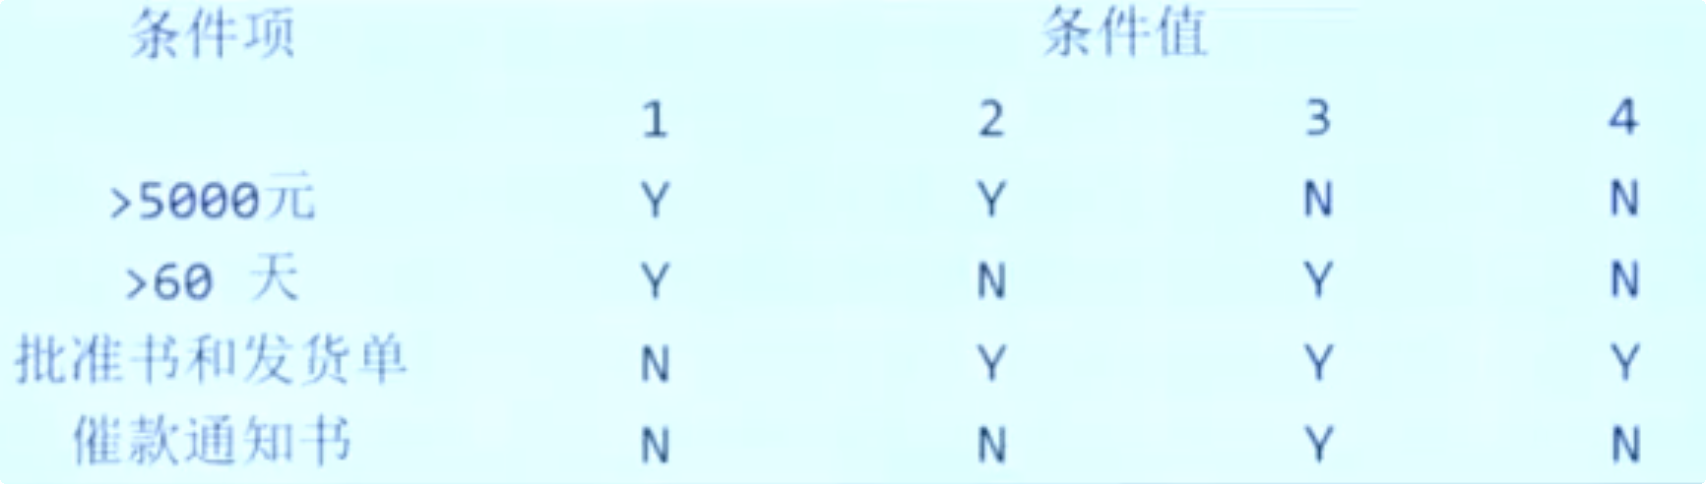
决策表形式:
可以看到有四种条件,但其中有两种条件的结果一致,条件2和条件4,无论订单金额是否大于5000元,都会发放批准书和发货单,故两者可以合并成一个,如下:
5000元的那一栏因为无论取何值都不影响,故用横线“——”表示。
操作系统
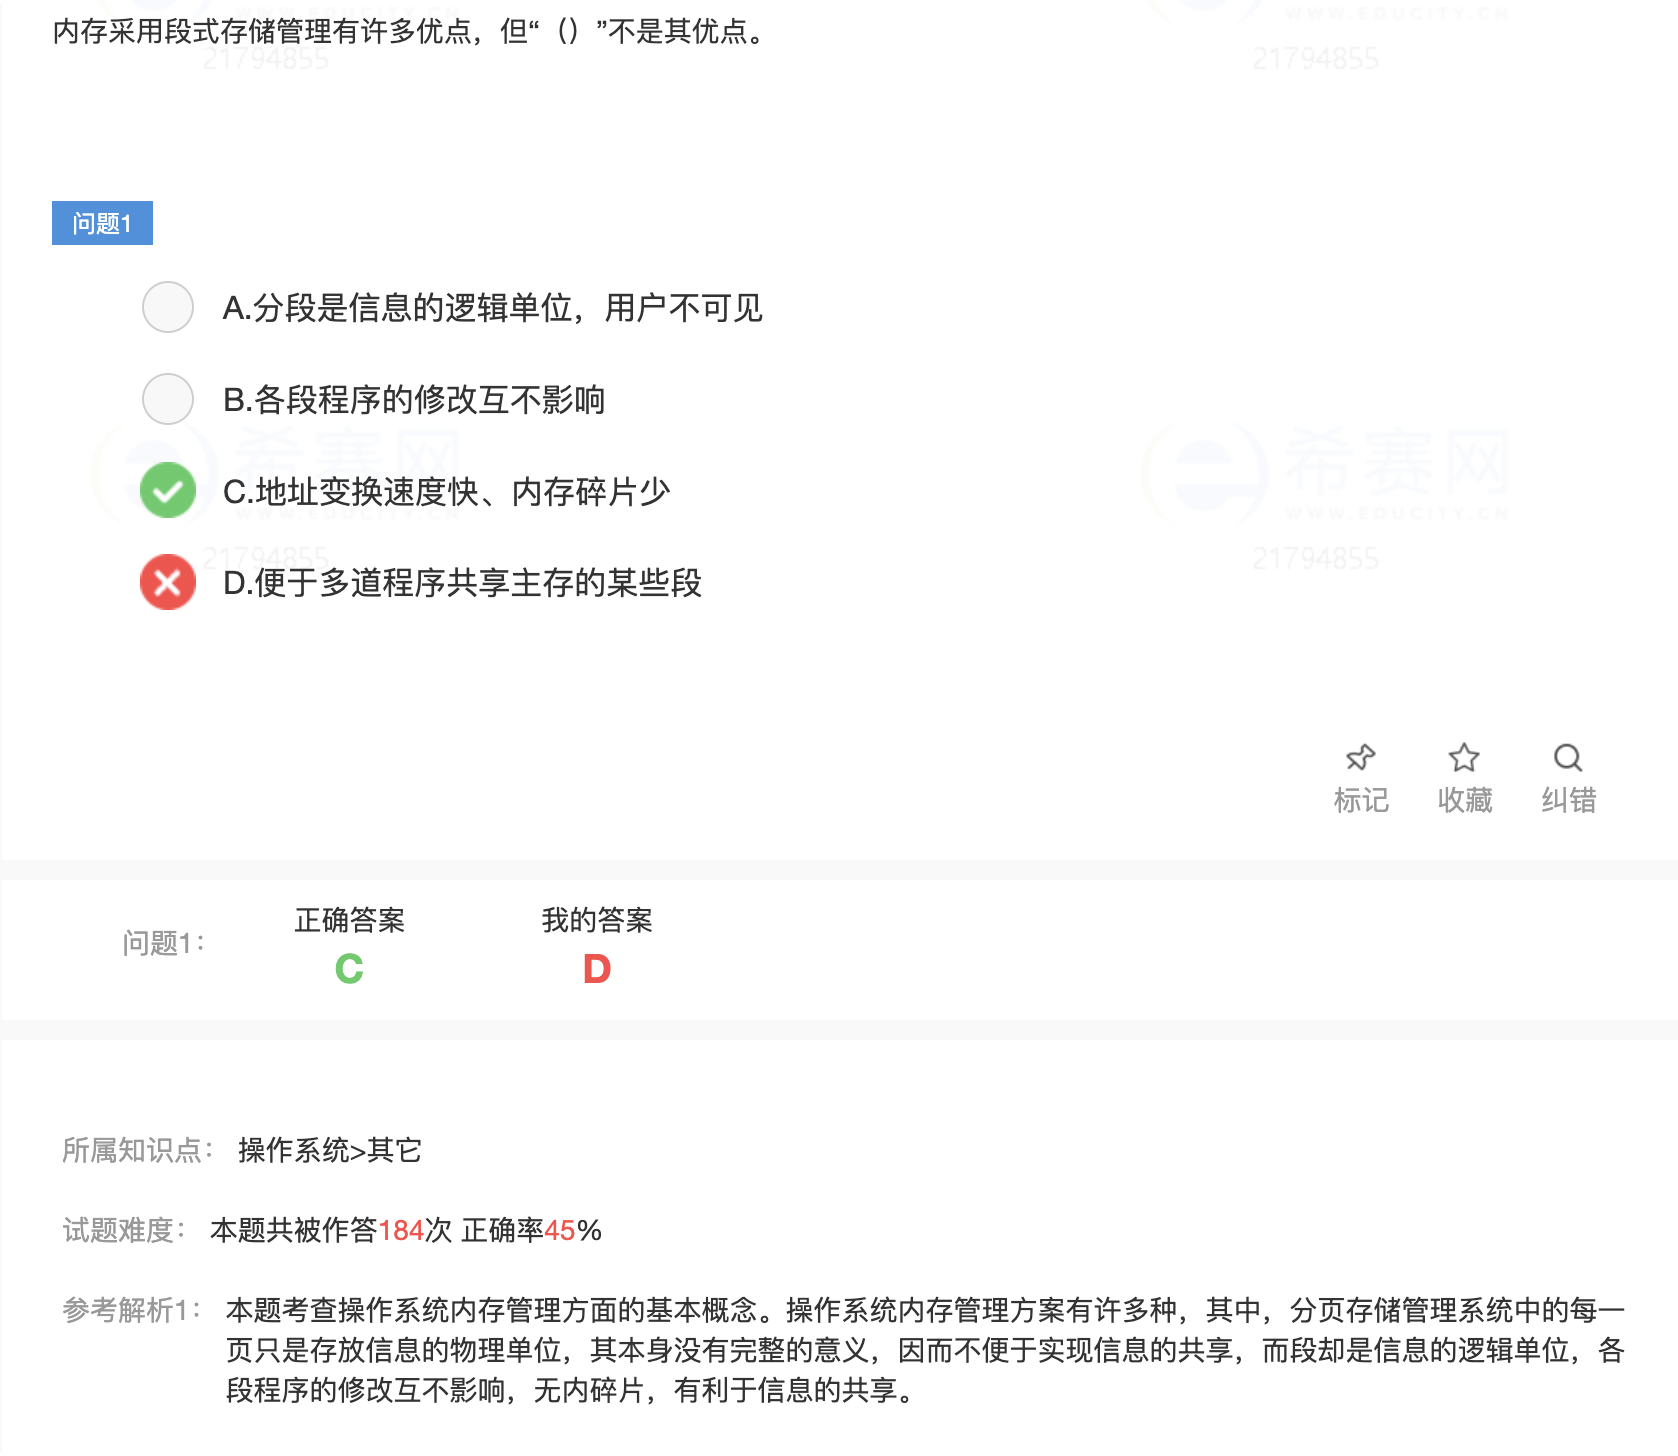
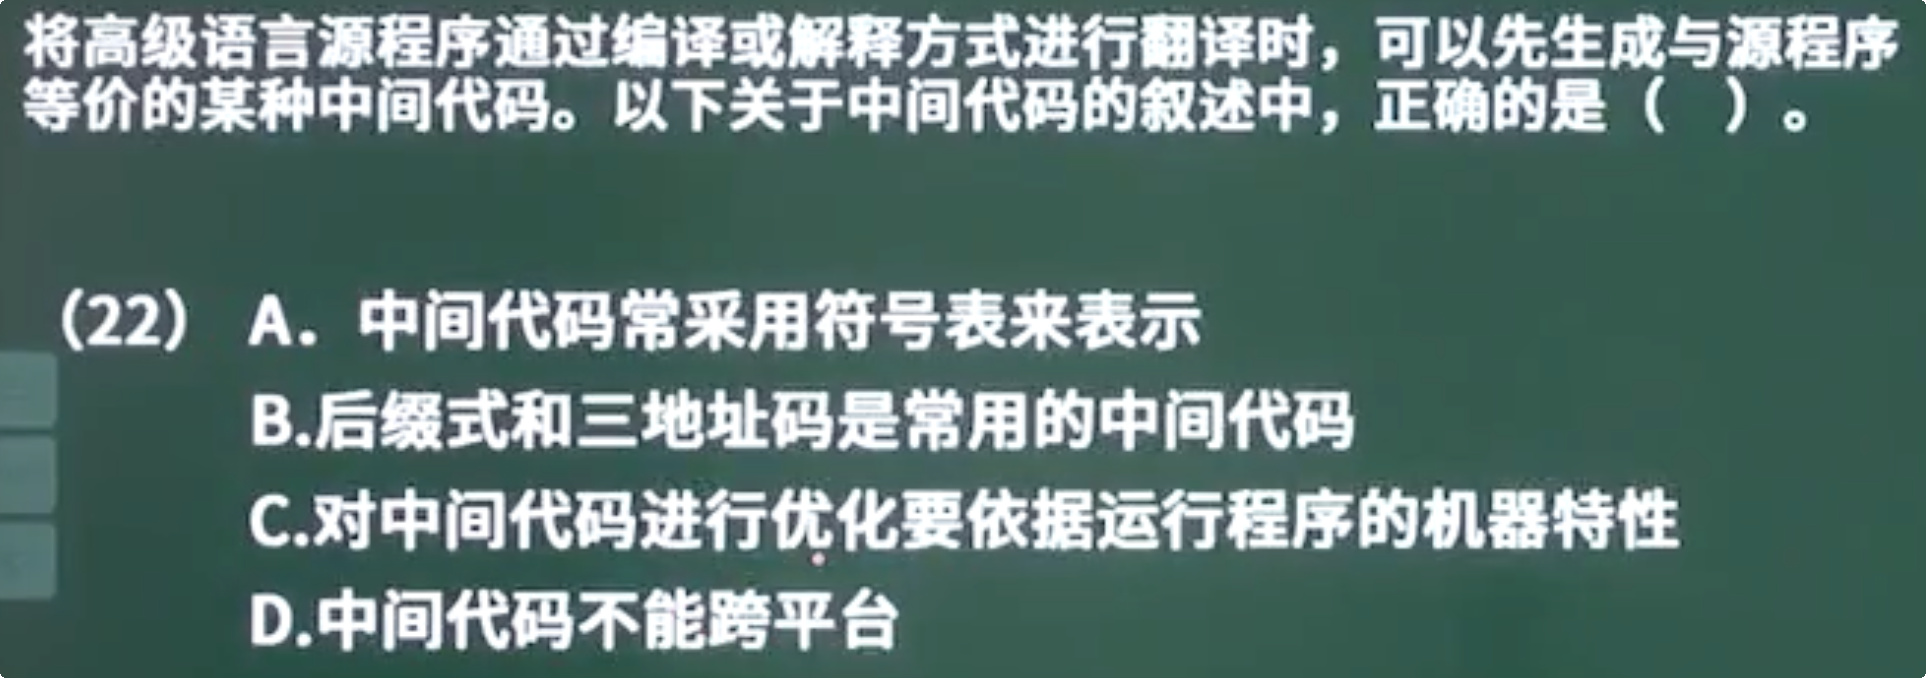
答:选B。中间代码常用的形式有:逆波兰式、三元式、四元式和树形表示,不依赖于具体的计算机。
符号表通常用于词义分析,故A错误;
中间代码是与具体使用的机器无关的代码,是可跨平台的代码,故C、D错误。
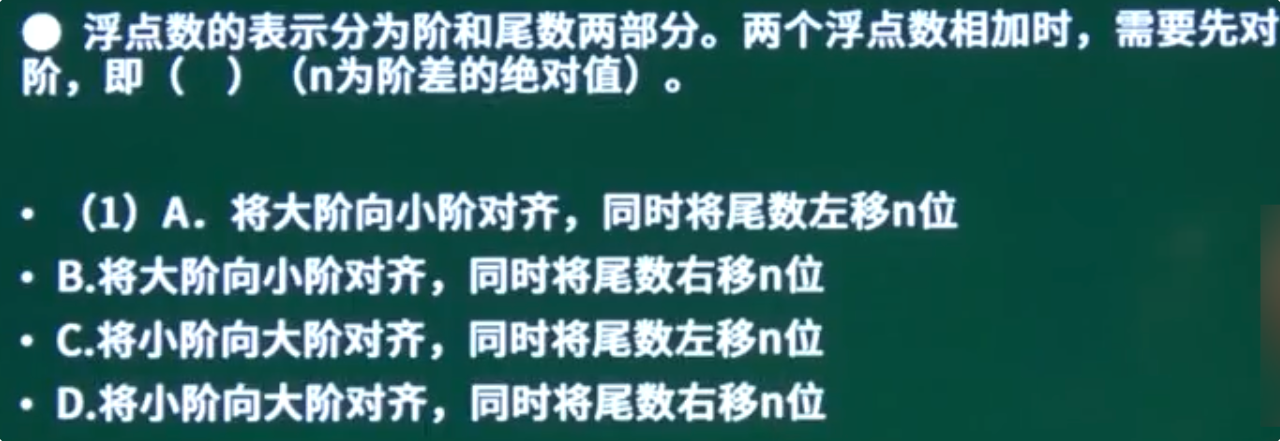
答:选D。
例如:
将其对阶,得:,
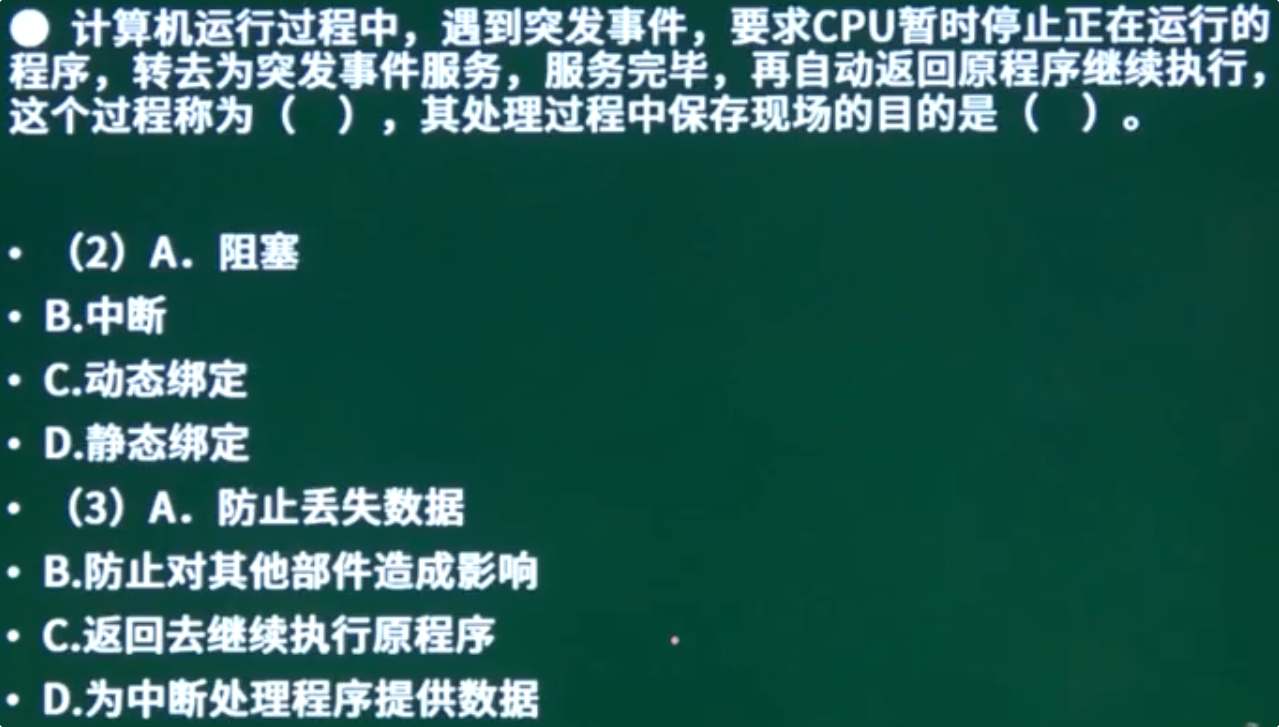
答:(2)B (3)C
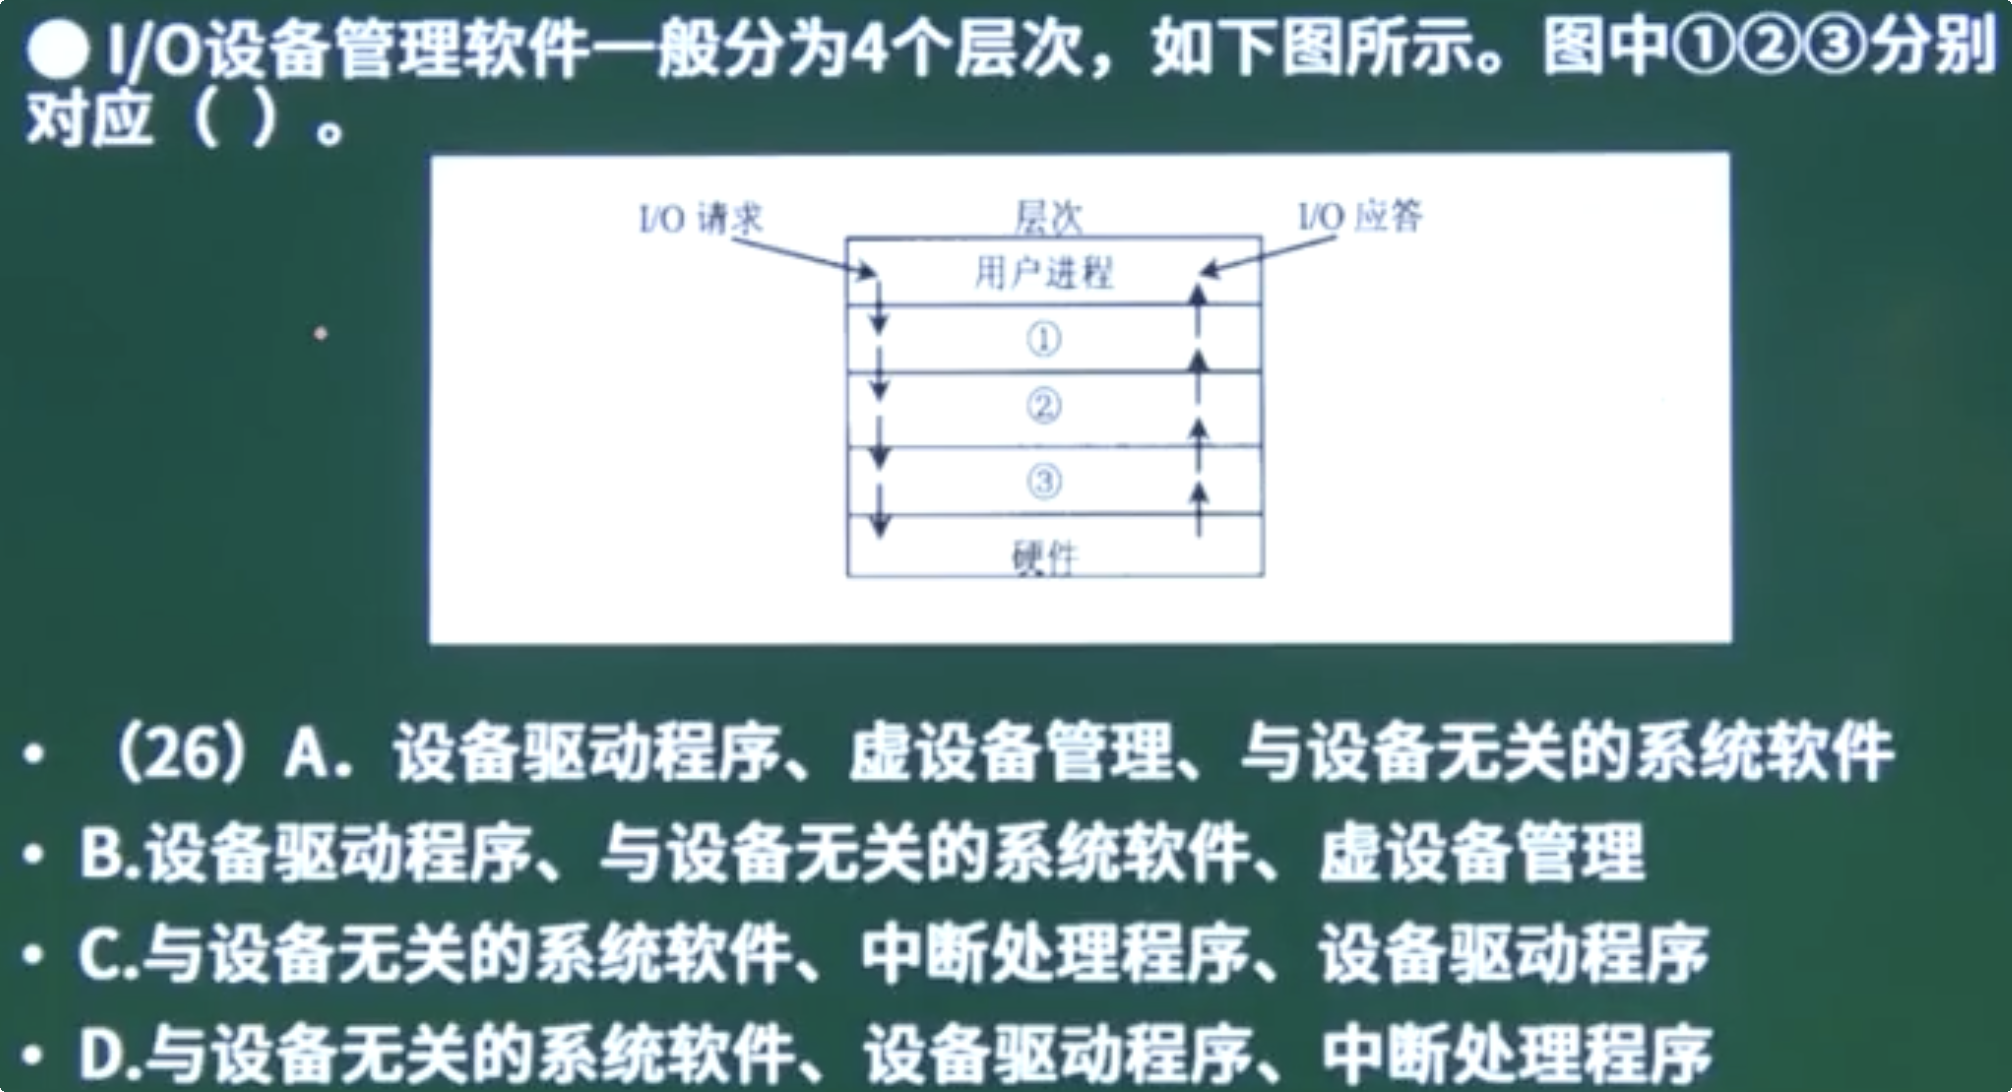
答:选D。
D选项中与硬件最接近的是中断处理程序,与用户最接近的是与设备无关的系统软件,故选D。
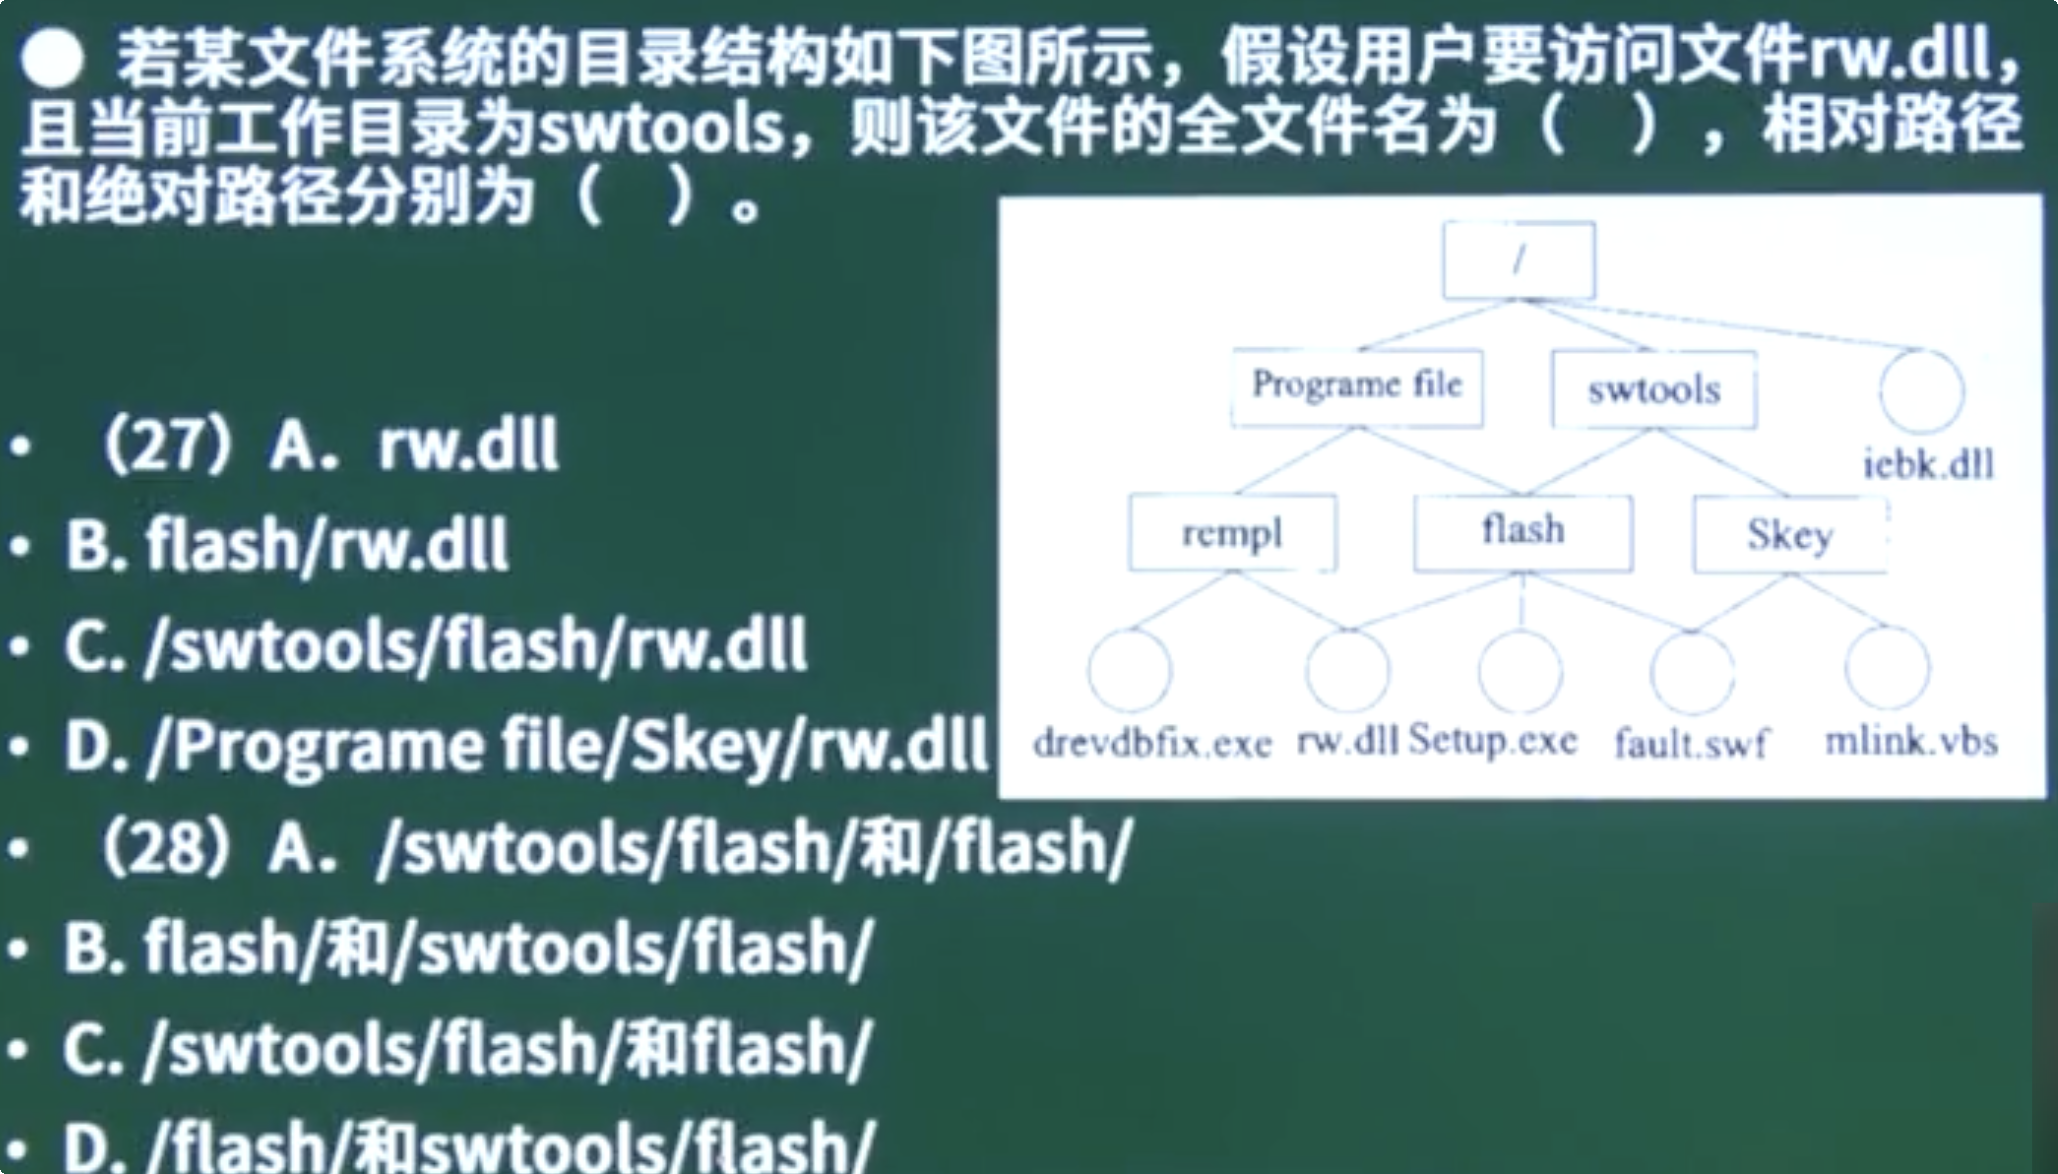
答:(27)C (28)B。
全文件名是从根路径开始,只有C选项满足条件。
当前所在工作目录是swtools,故访问rw.dll的相对路径是flash,绝对路径则是从根路径开始/swtools/flash。
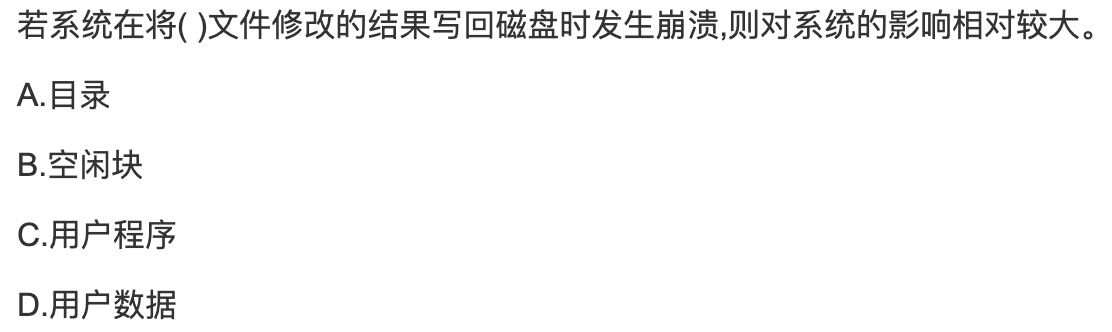
答:选A。因为目录的文件数据是最多的。
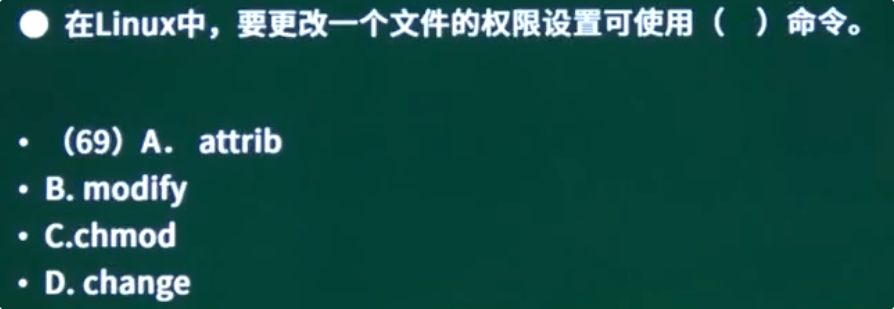
答:选C。chmod是linux下修改文件权限的指令,如:chmod u+rwx aaa.txt
概念相关
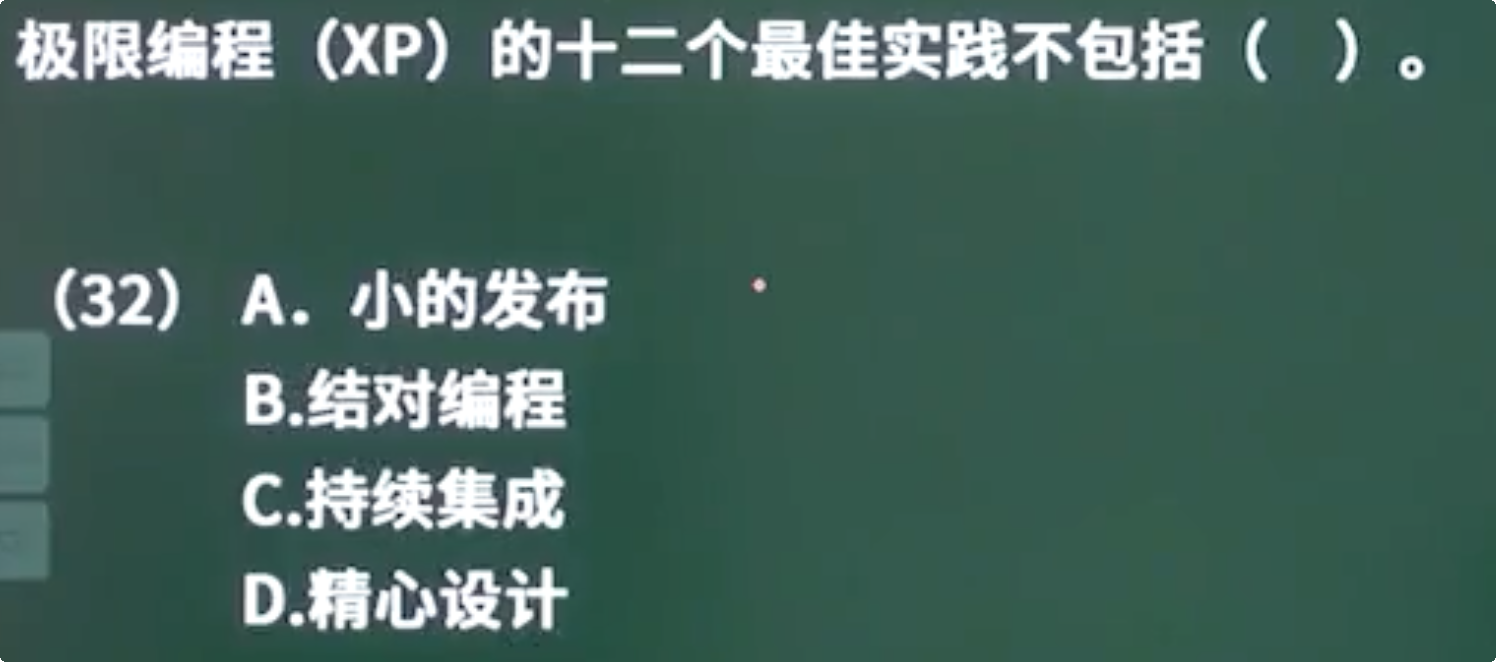
答:选D。
极限编程(XP)的12个最佳实践:
1、==现场客户==:与客户紧密合作,确保软件满足他们的需求。
2、==代码规范==:遵循一致的编码标准,提高代码质量和可读性。
3、==每周40小时工作制==:保持高效的工作状态,避免过度劳累。
4、==简单设计==:通过简单的设计和实现,降低系统复杂性。
5、==小版本==:频繁发布小版本,以便快速响应客户需求和市场变化。
6、==计划制定==:在项目开始时制定详细的计划,包括需求、任务和时间表。
7、==系统隐喻==:使用易于理解的系统隐喻,帮助团队成员更好地理解系统架构。
8、==测试==:在开发过程中进行持续的测试,确保软件质量。
9、==持续集成==:将代码集成到共享存储库中,以便团队成员可以实时查看和合并代码。
10、==代码重构==:定期对代码进行重构,以提高可读性、可维护性和性能。
11、==结对编程==:两个程序员共同完成一个任务,以提高代码质量和沟通效率。
12、==编码标准==:遵循一致的编码标准,提高代码质量和可读性。
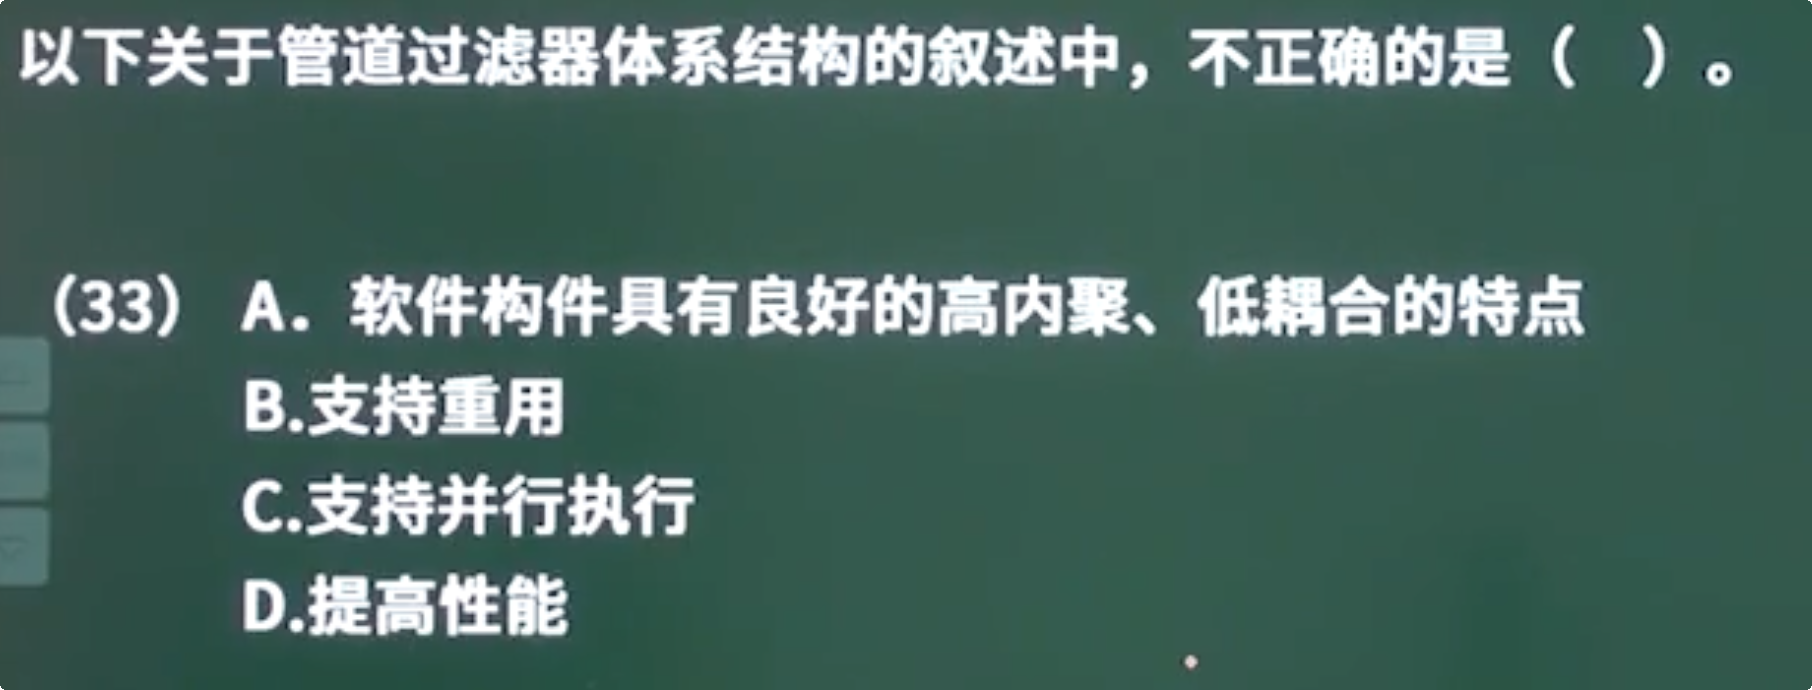
答:选D。
管道-过滤器体系结构是一种面向数据流的软件架构,具有以下特点:
1、==功能分解==:每个处理步骤都被封装在一个过滤器组件中,数据在过滤器之间流动。
2、==提高重用性和移植性==:通过将不同的功能用不同的过滤器进行实现,然后在用管道将各个过滤器相连,利用管道-过滤器模式架构开发的软件可以很好地进行移植,提高了软件模块的重用性。
3、==易于修改和更新==:当需要修改或更新某个功能时,无需改动软件项目中的其他部分,只需要更换对应的过滤器即可。
4、==高内聚、低耦合==:管道/过滤器风格的软件架构使得软构件具有良好的隐蔽性和高内聚、低耦合的特点。
5、==隐藏复杂性==:允许设计者将整个系统的输入/输出行为看成一个简单的数据处理过程,隐藏了系统内部的复杂性。
6、==支持并行执行==:每个过滤器被看作是一个单独的任务,因此它们可以与其他任务并行执行,这种并行性提高了系统的性能和吞吐量。
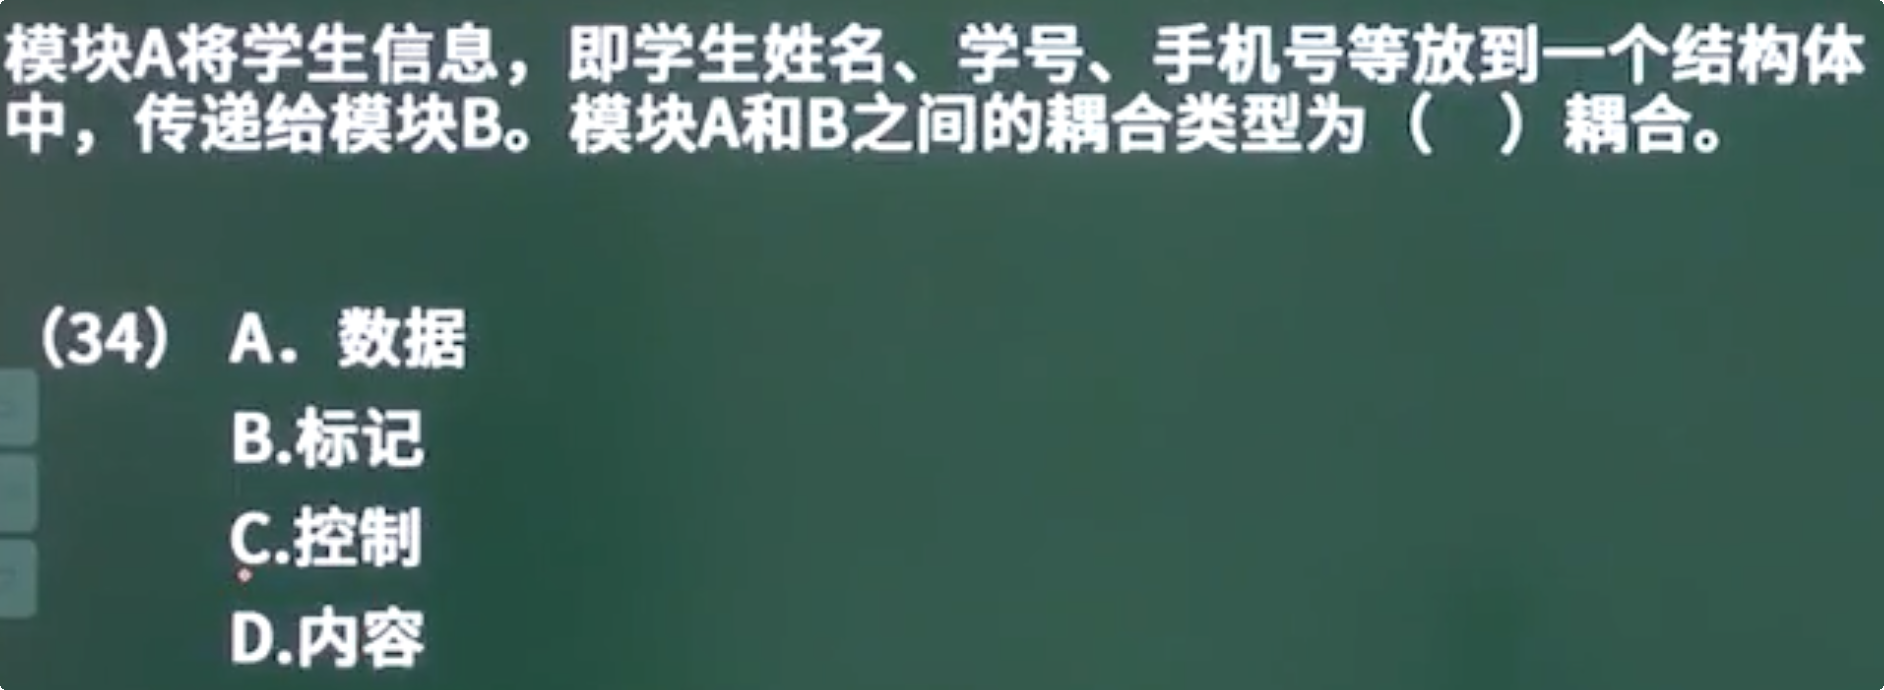
答:选B。
数据耦合、内容耦合、标记耦合和控制耦合是软件设计中描述不同级别和类型的模块间连接性的术语。
1、数据耦合:当一个模块访问另一个模块时,它们之间是==通过数据参数(而非控制参数、公共数据结构或外部变量)来交换输入和输出信息==的,这种耦合被称为数据耦合。
2、标记耦合:发生在两个模块之间==传递的是数据结构==,例如高级语言的数组名、记录名、文件名等这些名字即为标记,其实质是传递这个数据结构的地址。
3、控制耦合:如果一个模块通过==传送开关、标志、名字等控制信息,明显地控制选择另一个模块的功能==,就是控制耦合。
4、内容耦合:这是==耦合性最强的类型==,当一个模块直接访问另一个模块的内部数据,或者一个模块不通过正常入口转到另一个模块内部,又或者两个模块有一部分程序代码重叠(只可能出现在汇编语言中),甚至一个模块有多个入口时,两个模块之间就发生了内容耦合。
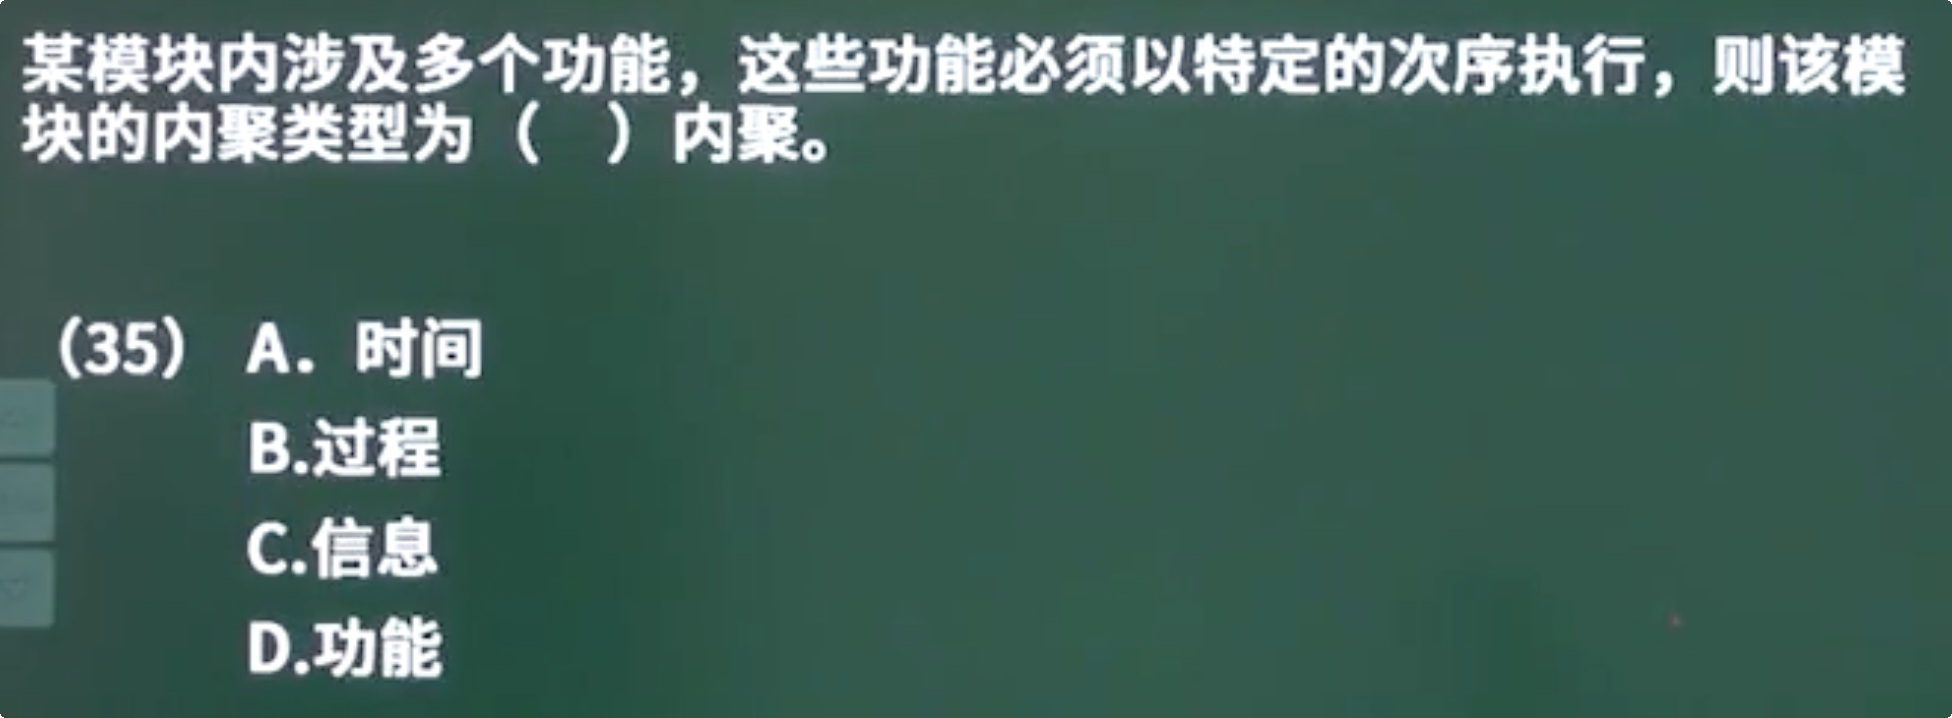
答:选B。
时间内聚、功能内聚、信息内聚和过程内聚是软件设计中描述模块内部任务关系和紧密程度的术语。
1、时间内聚:也被称为瞬时内聚,如果一个模块包含的任务==必须在同一时间间隔内执行==,这些任务就具有时间内聚。即它们需要在同一时间段内被完成。
2、功能内聚:指模块内部的==所有任务都是为了完成某一个具体的功能==。换句话说,完成同一类功能的代码被放在同一个模块中,这个模块就被称为具有功能内聚。
3、信息内聚:是指==模块内部处理的元素都在同一个数据结构上操作,或者指模块内部处理的元素都与同一个数据库实体有关==。比如多个操作都是对同一个数据表进行操作,就说这些操作具有信息内聚。
4、过程内聚:处理元素相关,而且必须==按特定的次序执行==。顺序内聚中是数据流从一个处理单元流到另一个处理单元,而过程内聚是控制流从一个动作流向另一个动作。
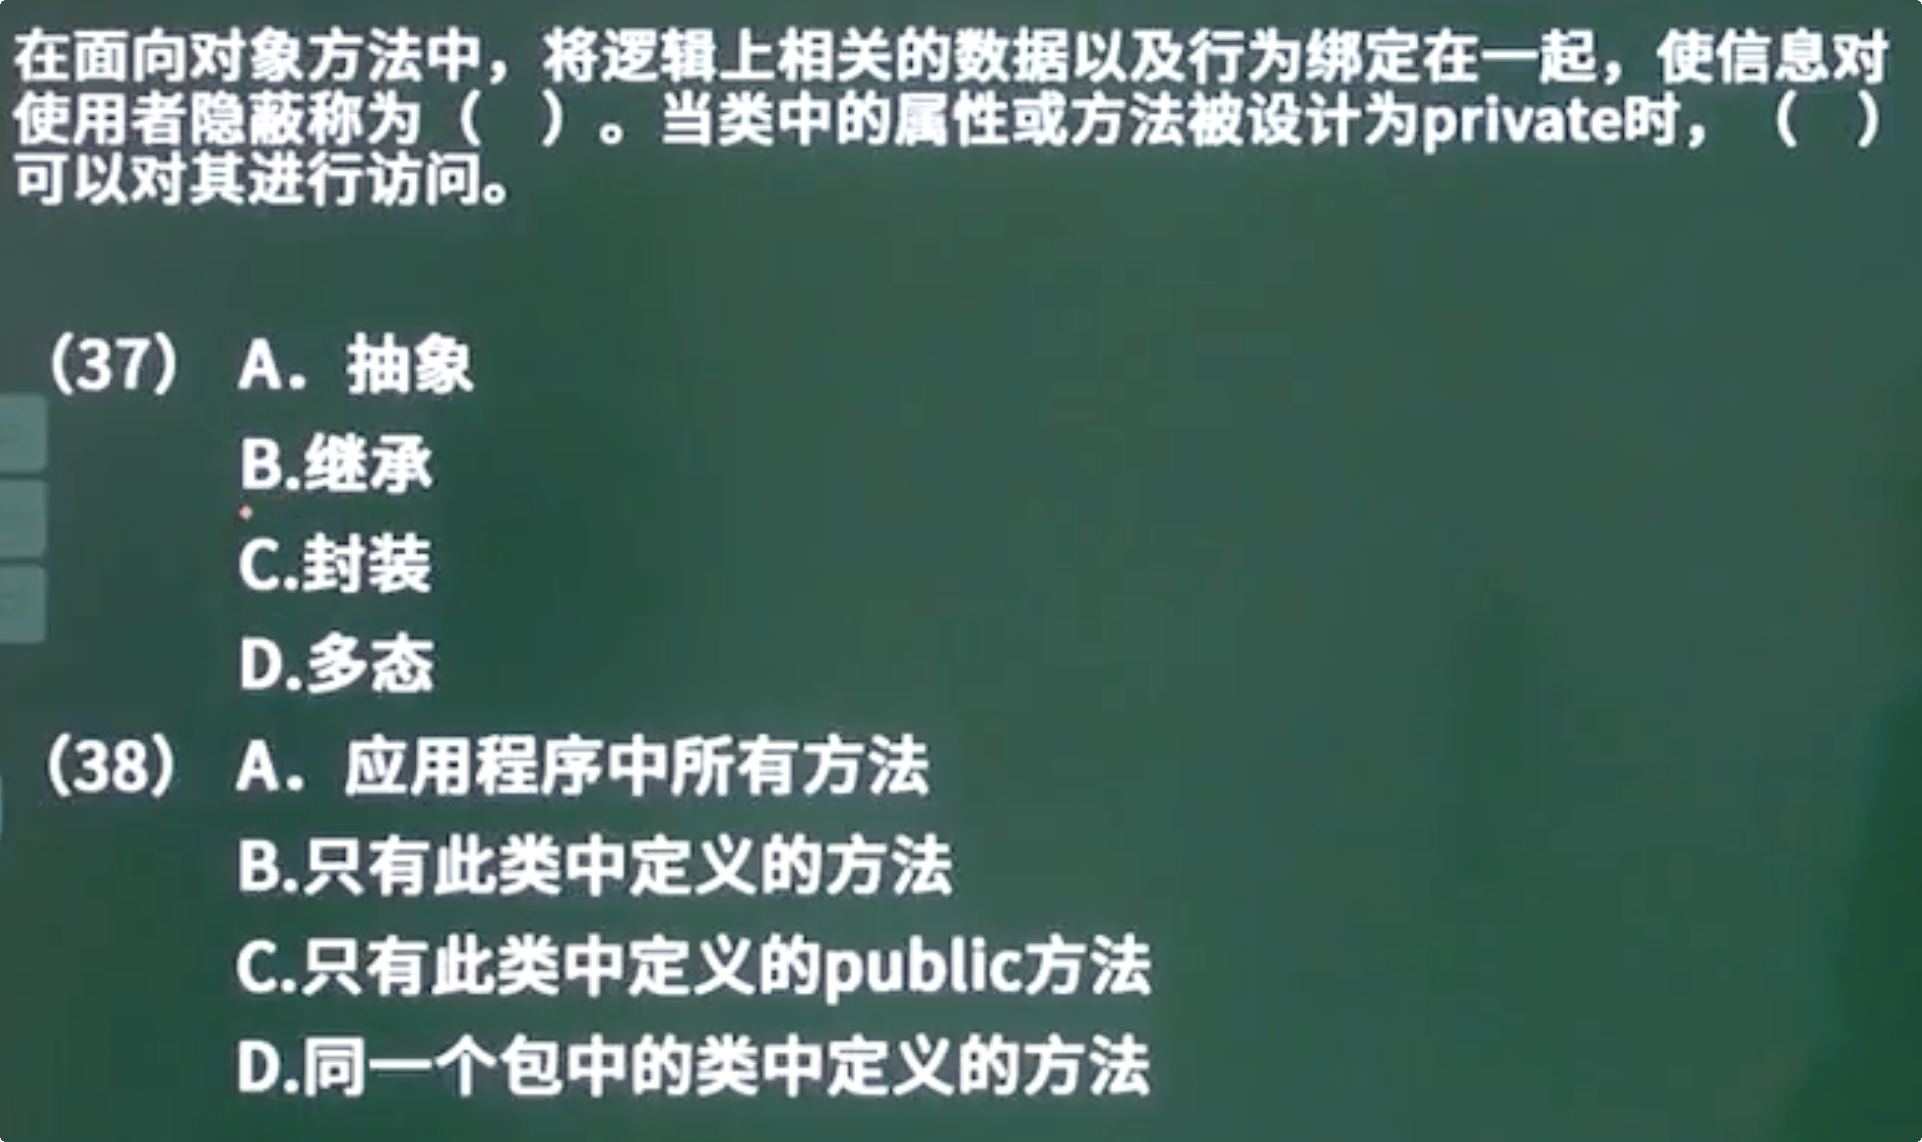
答:37、选C。 38、选B。
(37)抽象、继承、封装和多态是面向对象编程的四大特性,它们是理解和掌握面向对象编程语言的关键。
1、封装:这是面向对象编程的基本特征之一,它的主要目的是将数据(变量)和操作数据的函数绑定在一起,形成一个整体,即对象。这样可以==隐藏对象的内部细节==,只对外公开必要的接口,从而降低了系统的耦合度,减少了程序出错的可能性。
2、继承:继承是一种能够创建新类的方式,在Java等面向对象编程语言中,==新创建的类被称为子类或派生类,被继承的类被称为父类或基类==。子类会继承父类的所有属性和方法,同时还可以添加新的属性和方法或者重写父类的方法。
3、多态:多态是指允许你使用父对象指向子对象,同时==使用父类类型的变量来引用子类对象==。多态的实现主要有两种方式,一种是编译时多态,也称为静态多态,另一种是运行时多态,也就是我们常说的动态多态。
4、抽象:抽象是将一类事物的共同特点总结出来构造成类的过程,包括数据抽象和行为抽象。抽象只关注对象的属性和行为,不关注行为的细节。例如,我们可以定义一个“动物”类,它具有吃、喝等行为,==但不关心具体是如何实现这些行为==的。
(38)被private修饰的变量或方法只能被本类中的定义的方法调用。
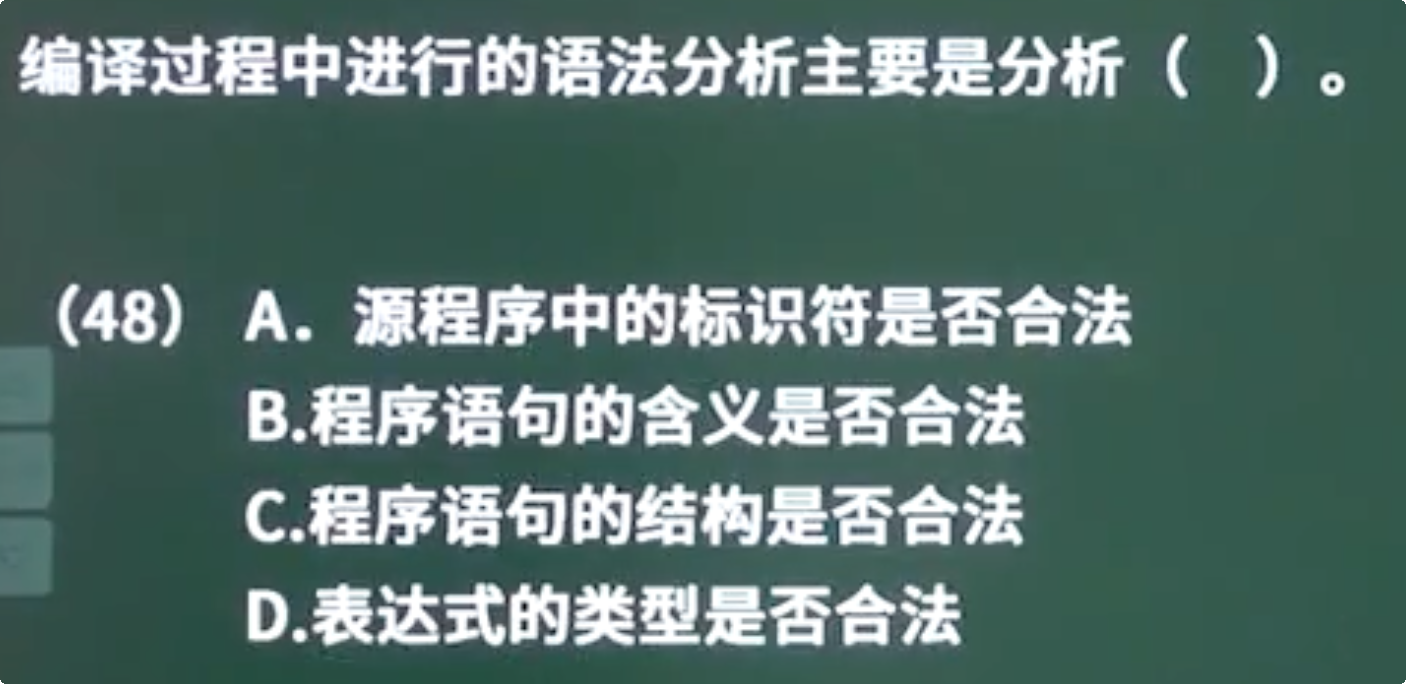
答:选C。
A选项是词法分析,B、D选项是语义分析,C选项是语法分析。
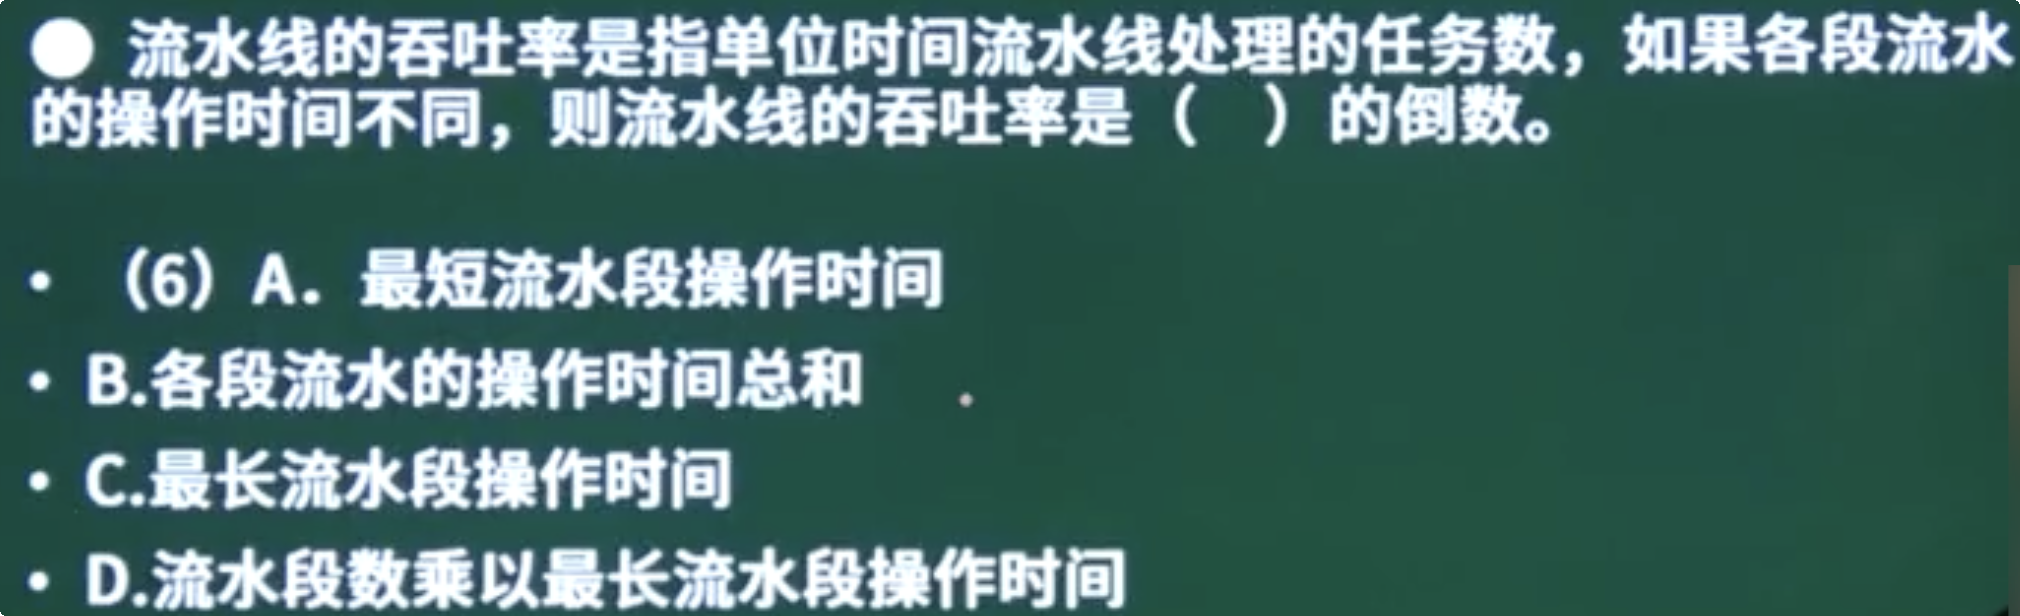
答:选C。
,由于选项中无执行时间,故我们求最大吞吐率,即选C。
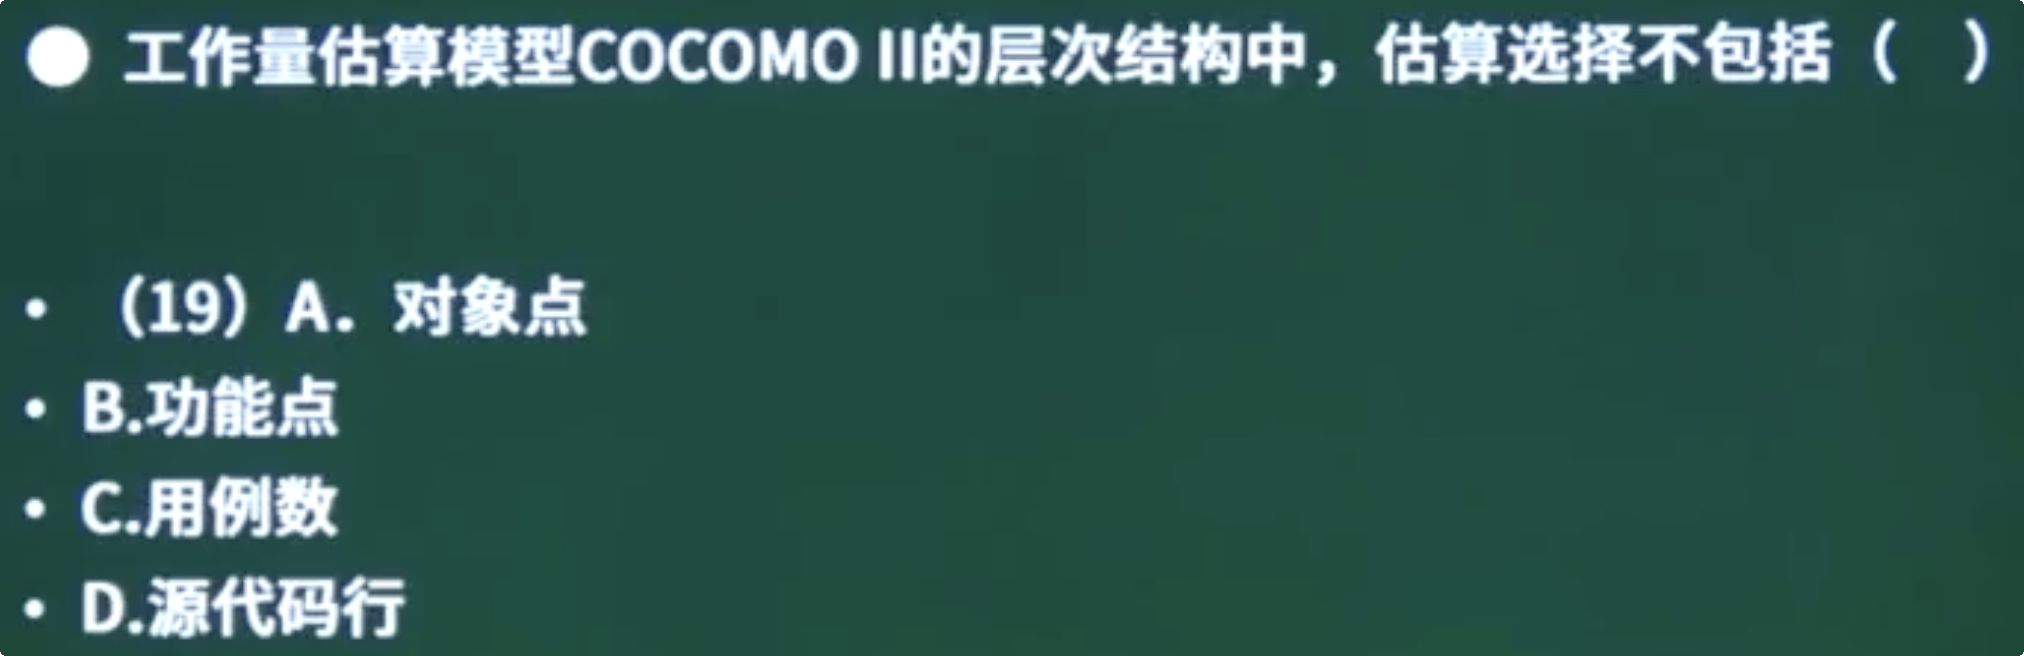
答:选C。工作量估算模型中估算选择包括对象点、功能点、源代码行。
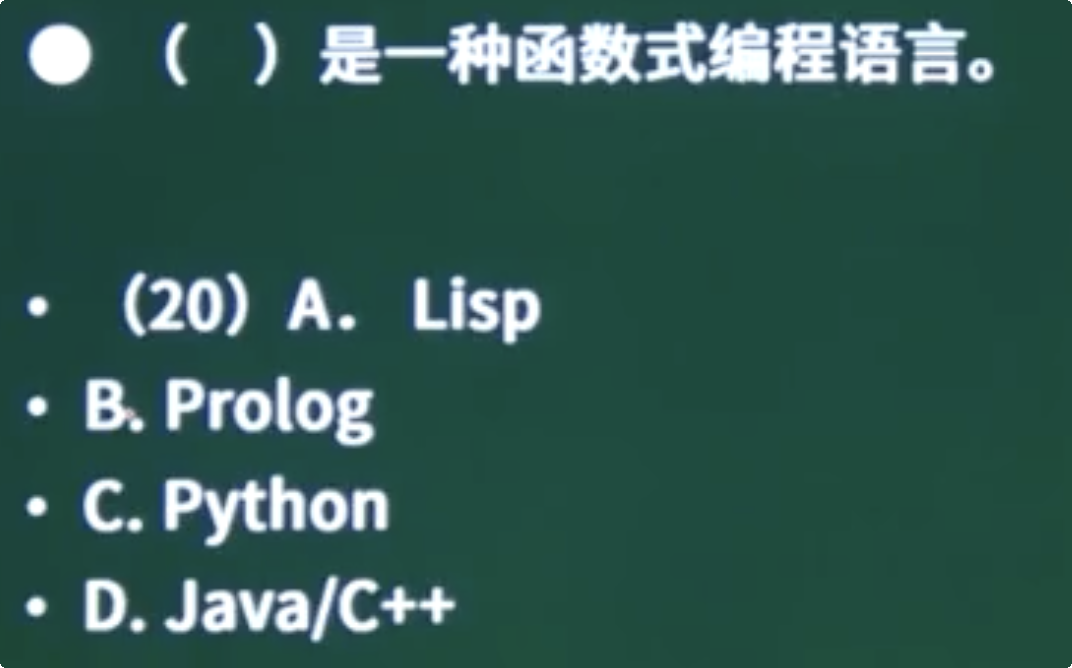
答:选A。
Lisp是一种函数式程序设计语言;
Prolog是一种逻辑编程语言;
Python是一种多范式编程语言,支持面向对象、命令式和函数式编程;
Java/C++是一种面向对象的编程语言。
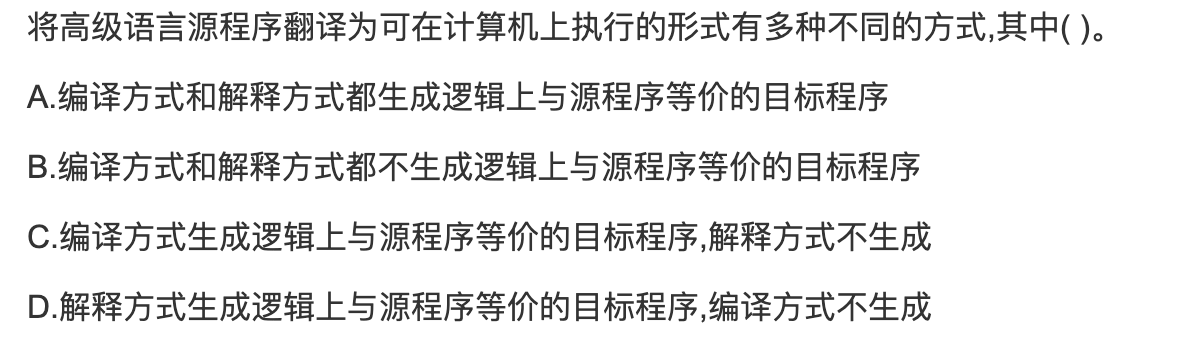
答:选C。
编译型语言是将源代码一次性全部转换成机器语言,生成可执行文件;
解释型语言则是逐行将源代码解释并执行,无需预先编译成二进制文件;依赖于解释器。
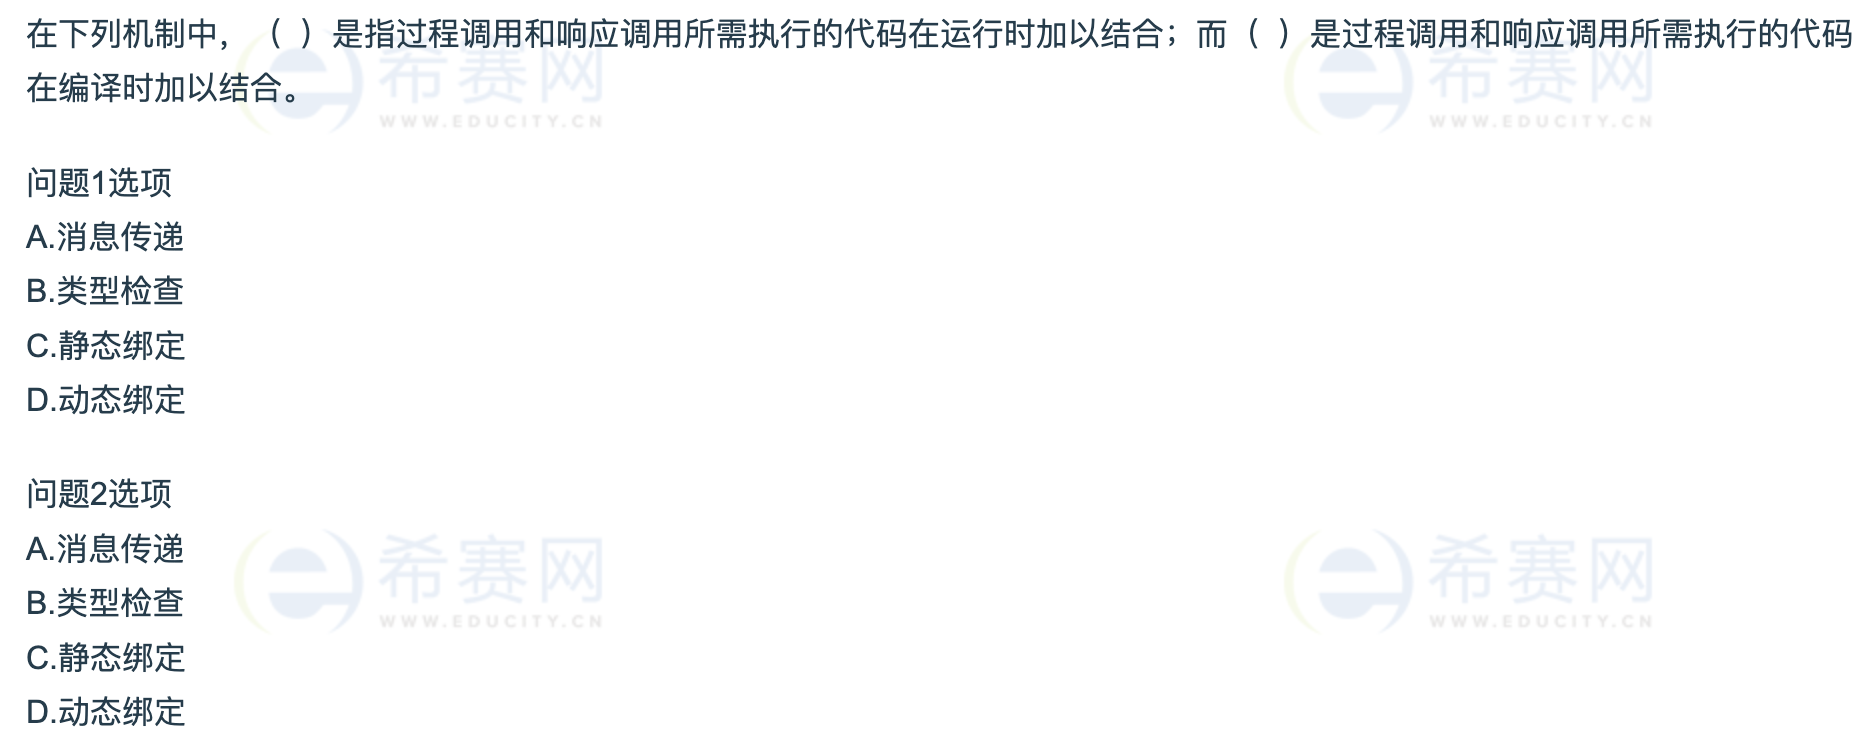
答:(1)D (2)C。
程序==运行过程==中,把函数(或过程)调用与响应调用所需要的代码相结合的过程称为动态绑定。静态绑定是指在程序==编译过程==中,把函数(方法或者过程)调用与响应调用所需的代码结合的过程称之为静态绑定。
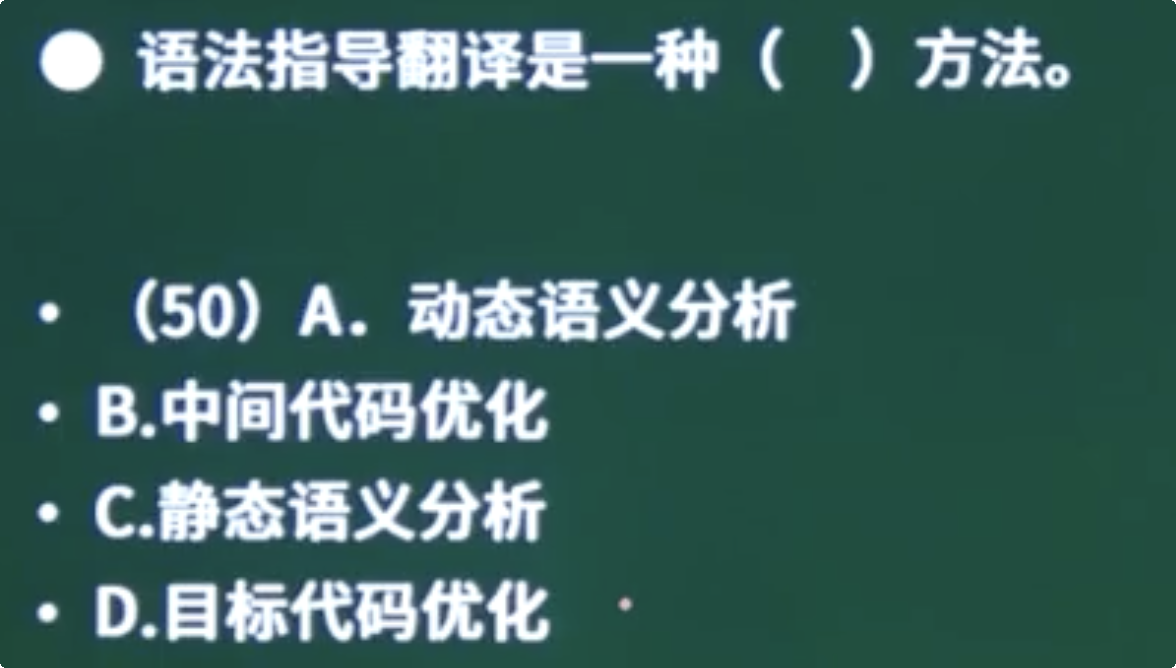
答:选C。
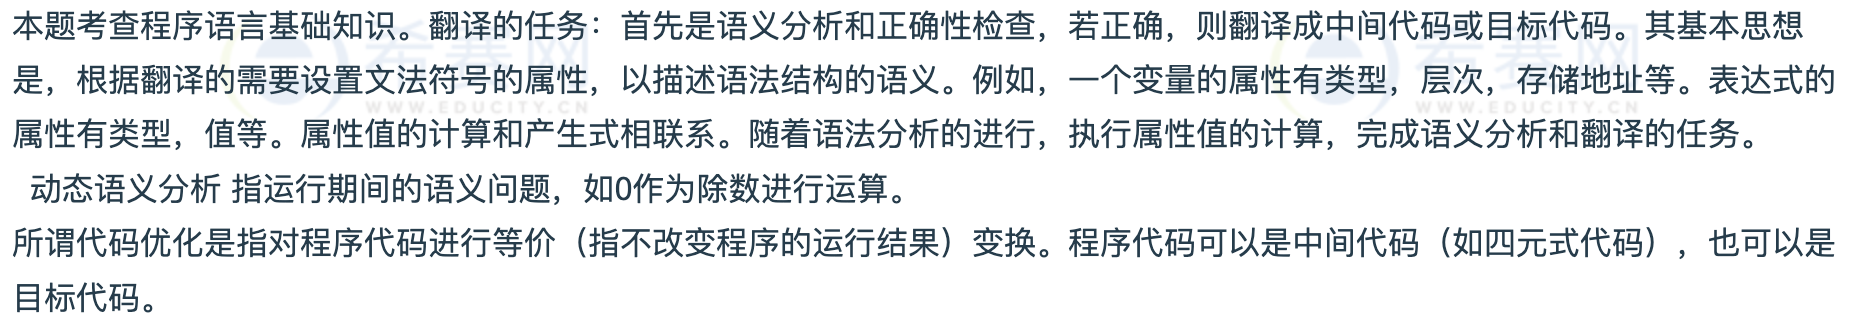
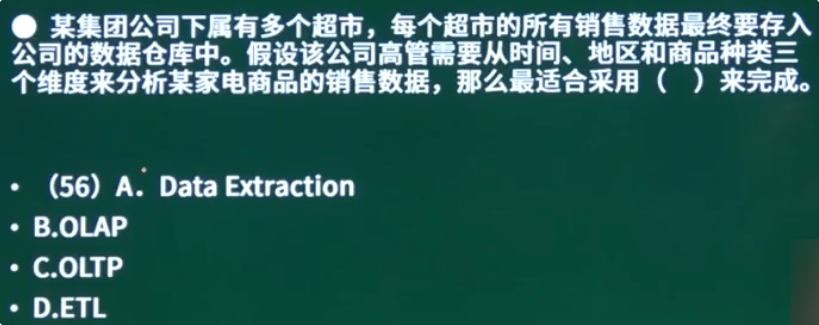
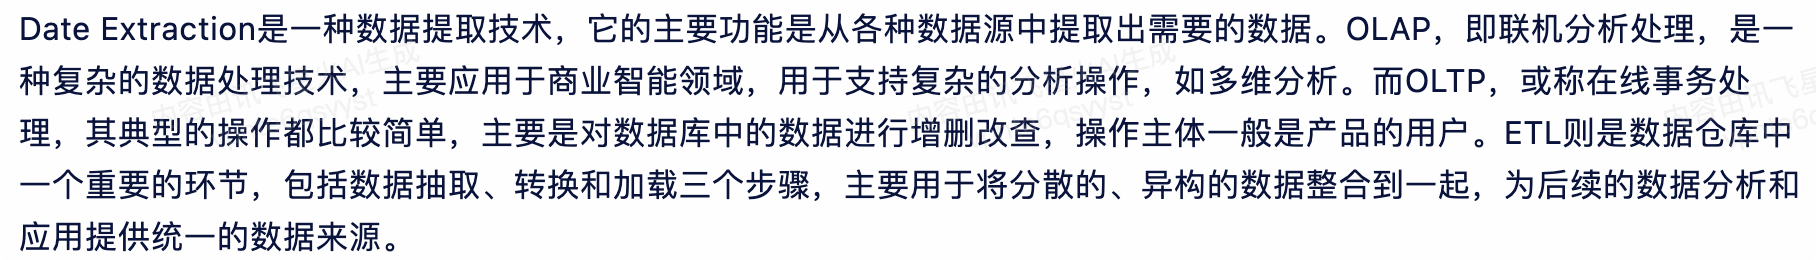
答:选B。
网络
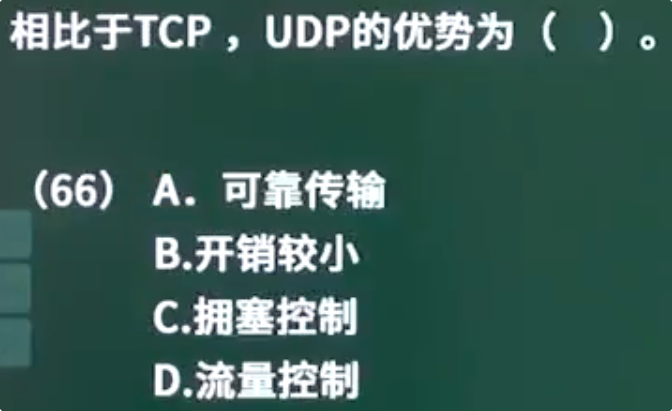
答:选B。
其他选项都是TCP的优势。
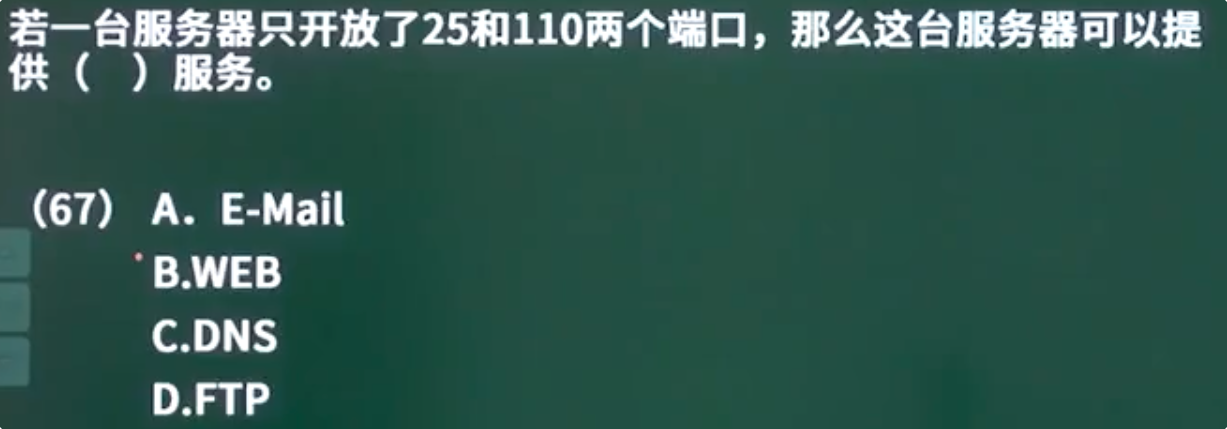
答:选A。
B的端口一般是http端口80或者https端口443;
C的端口一般是53;
FTP文件传输协议基于两个主要端口:21端口和20端口。21端口是FTP传输控制信息端口,20端口,是FTP传输数据端口,用于实际传输文件过程中的数据流。
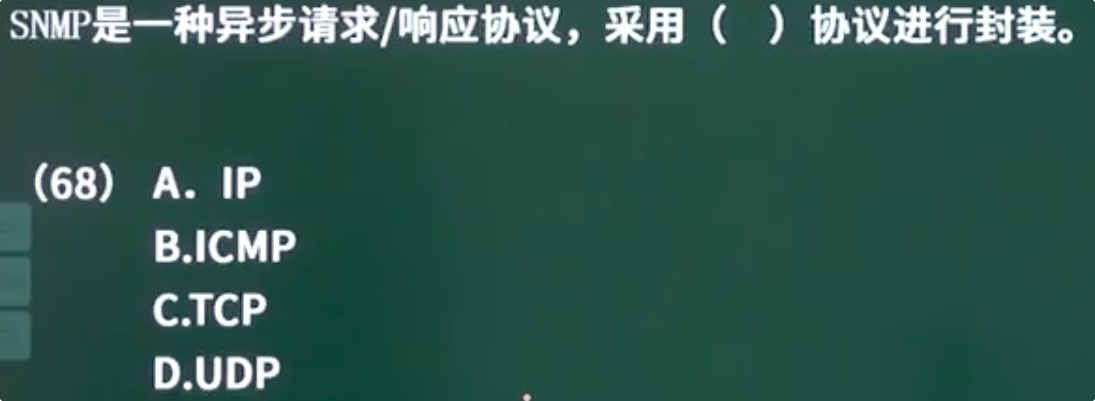
答:选D。
有点相似的stmp协议采用的是tcp协议。
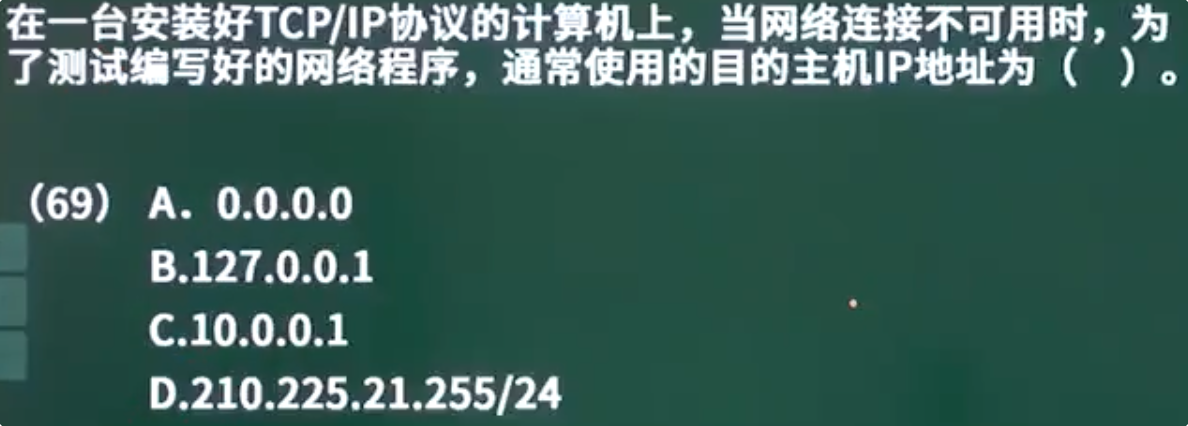
答:选B。一般本地调试程序都用127.0.0.1地址来测试。
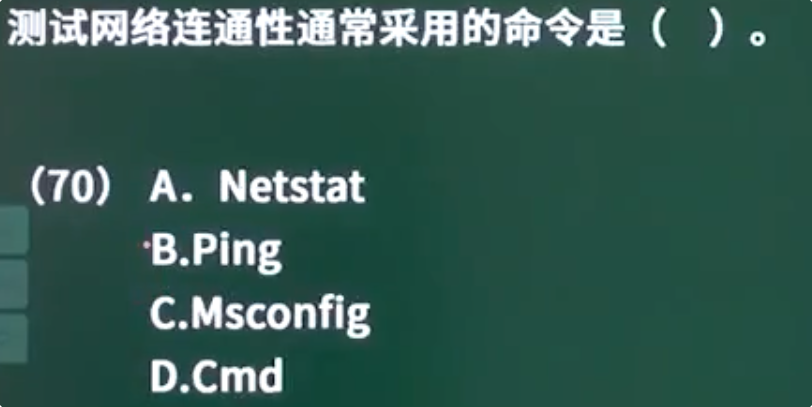
答:选B。
A选项:Netstat是一个控制台命令,是一种非常有用的工具,用于监控TCP/IP网络。它的主要功能是显示路由表、实际的网络连接以及每一个网络接口设备的状态信息。
B选项:MSConfig可以方便地管理和调整计算机的启动项,帮助禁止不需要运行的程序,这样可以加快电脑的运行速度;
D选项:Cmd是Windows操作系统中的一种命令行程序,有时也被称为命令处理器、命令提示符窗口或cmd.exe。。
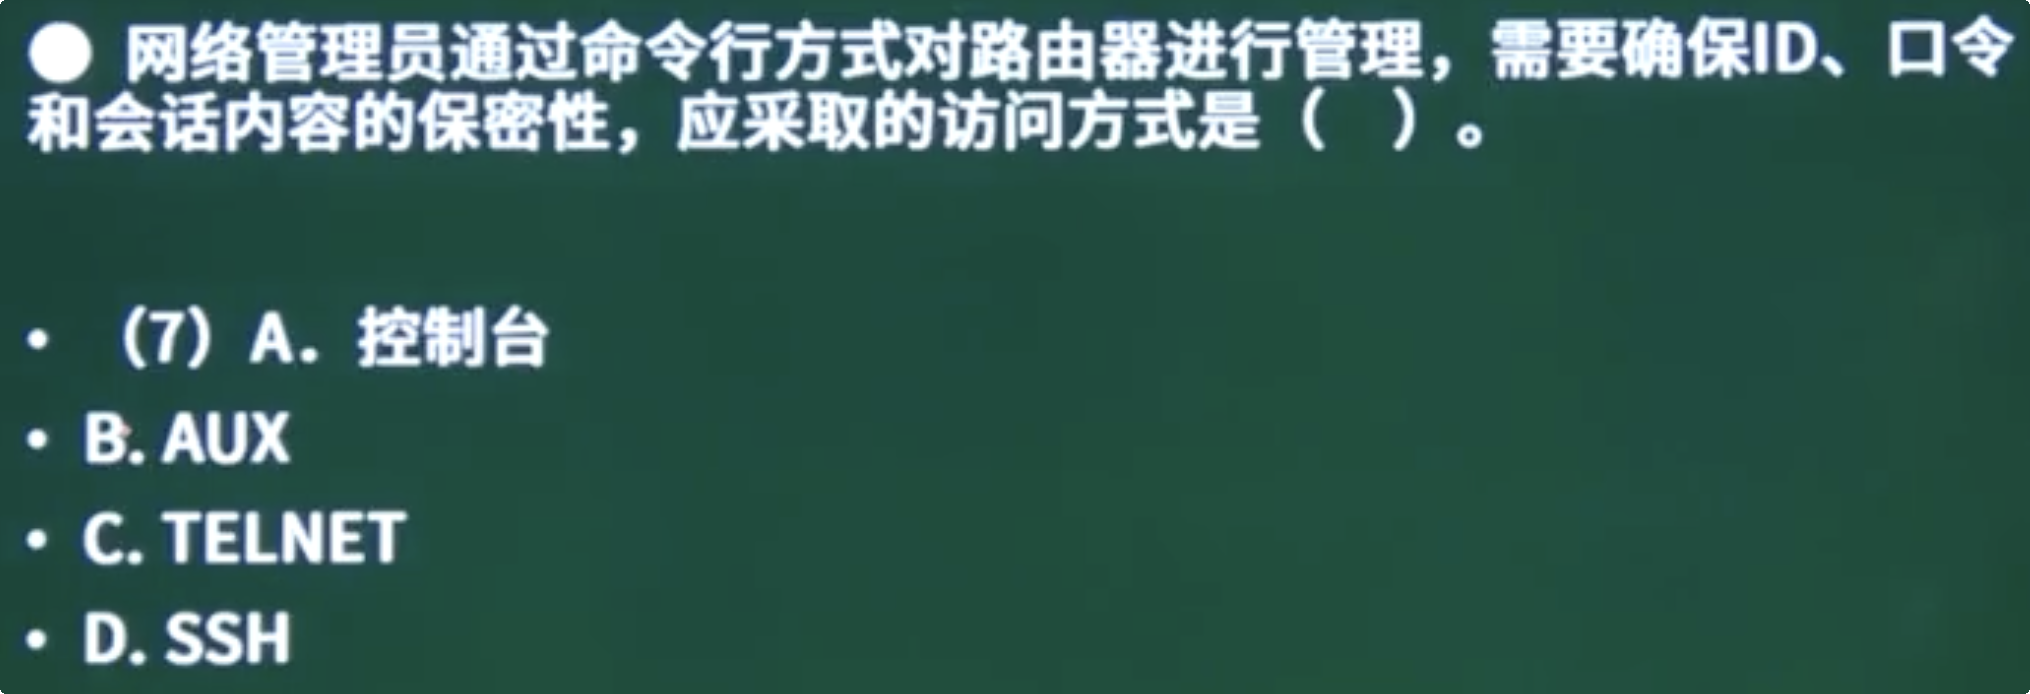
答:选D。
只有C、D选项可对路由器进行管理,但只有SSH涉及保密性,故选D。
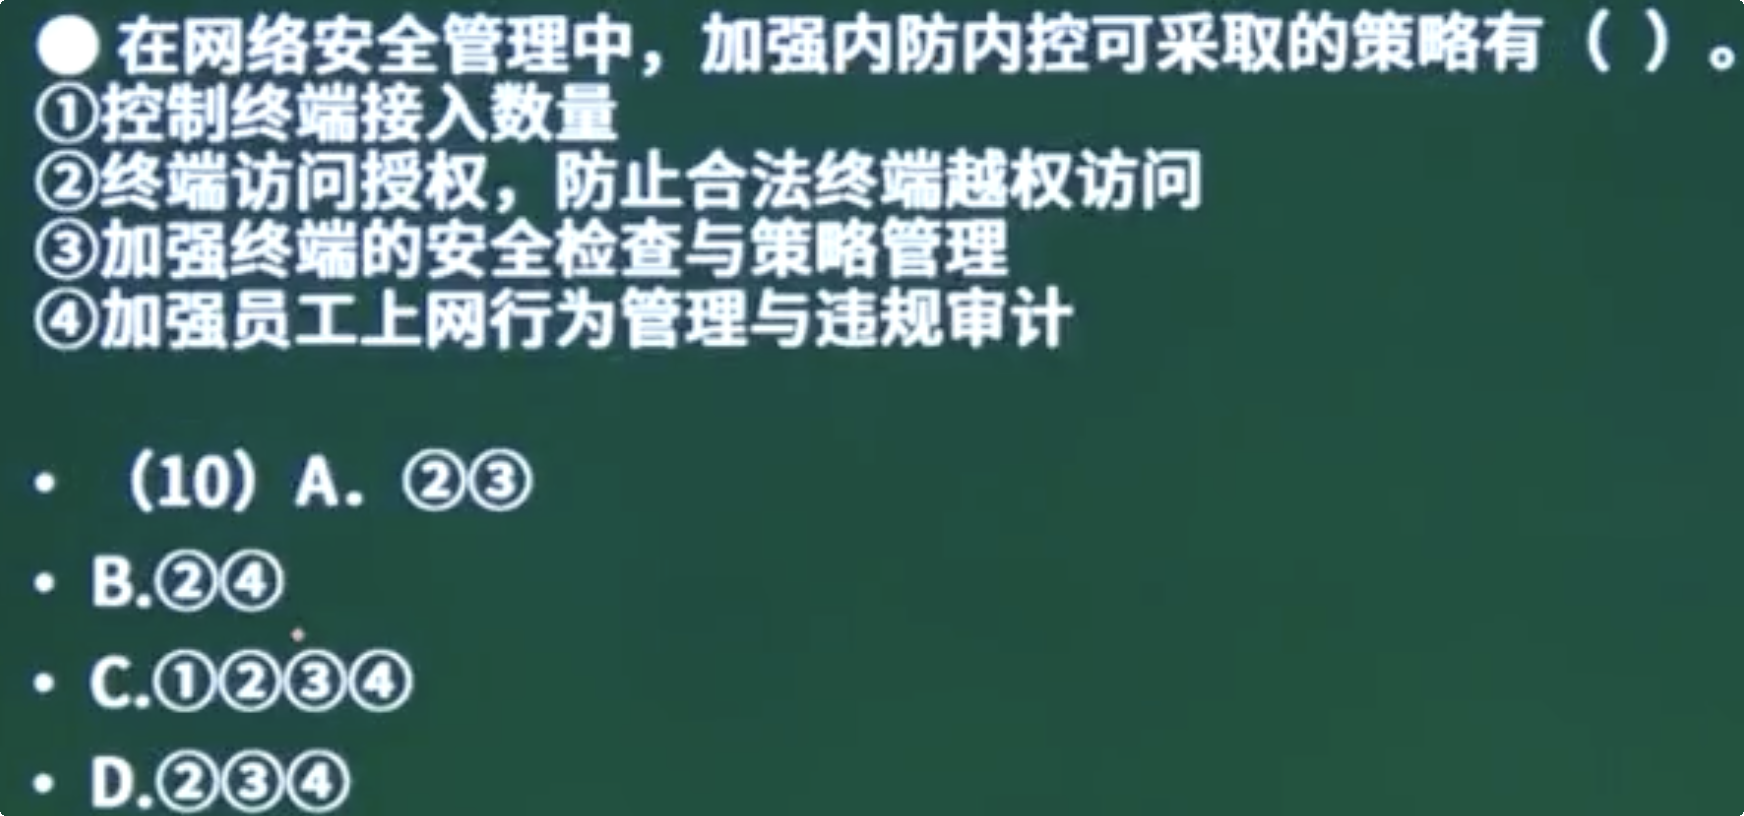
答:选C。
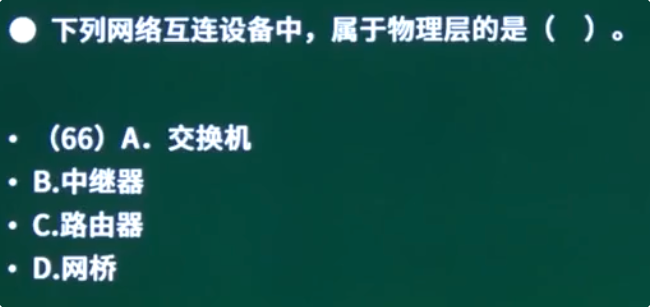
答:选B。
A、交换机是属于数据链路层的,而三层交换机属于网络层;
B、中继器属于物理层;
C、路由器属于网络层;
D、网桥属于数据链路层。
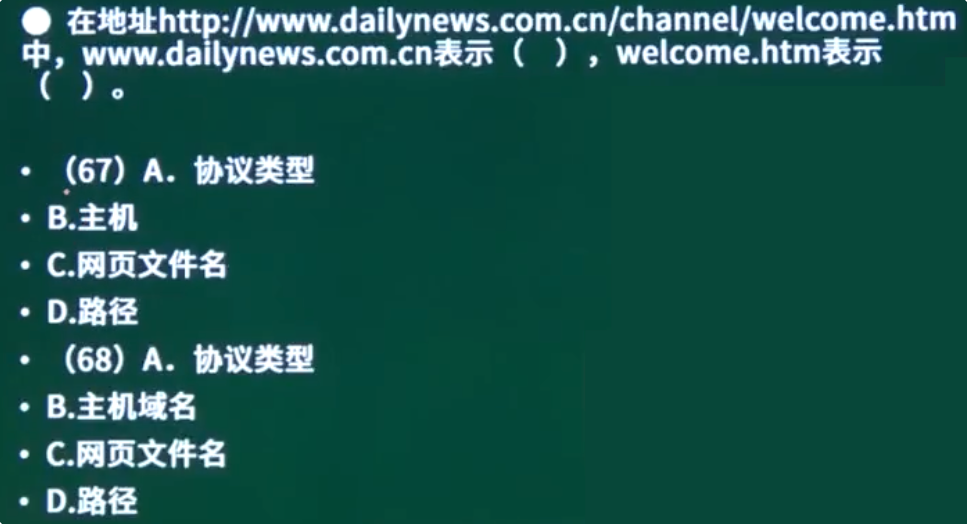
答:(67)B (68)C。
http是网络协议类型;www.xxxx.cn,这是域名,一般映射主机IP地址;/channel/为路径;.htm是网页文件。
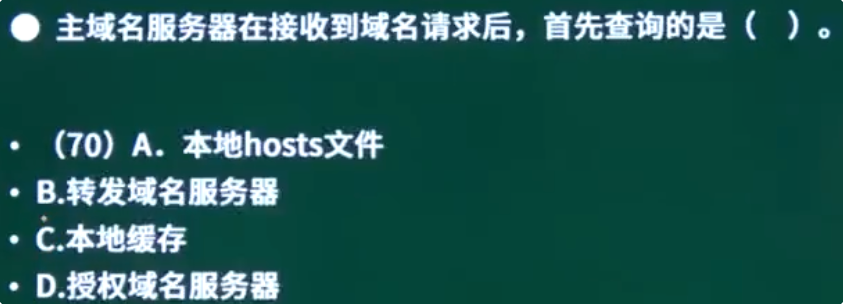
答:选C。
在主域名服务器收到域名请求后,首先查的是本地缓存;客户端在域名分析时,首先查的是本地hosts文件。
计算相关
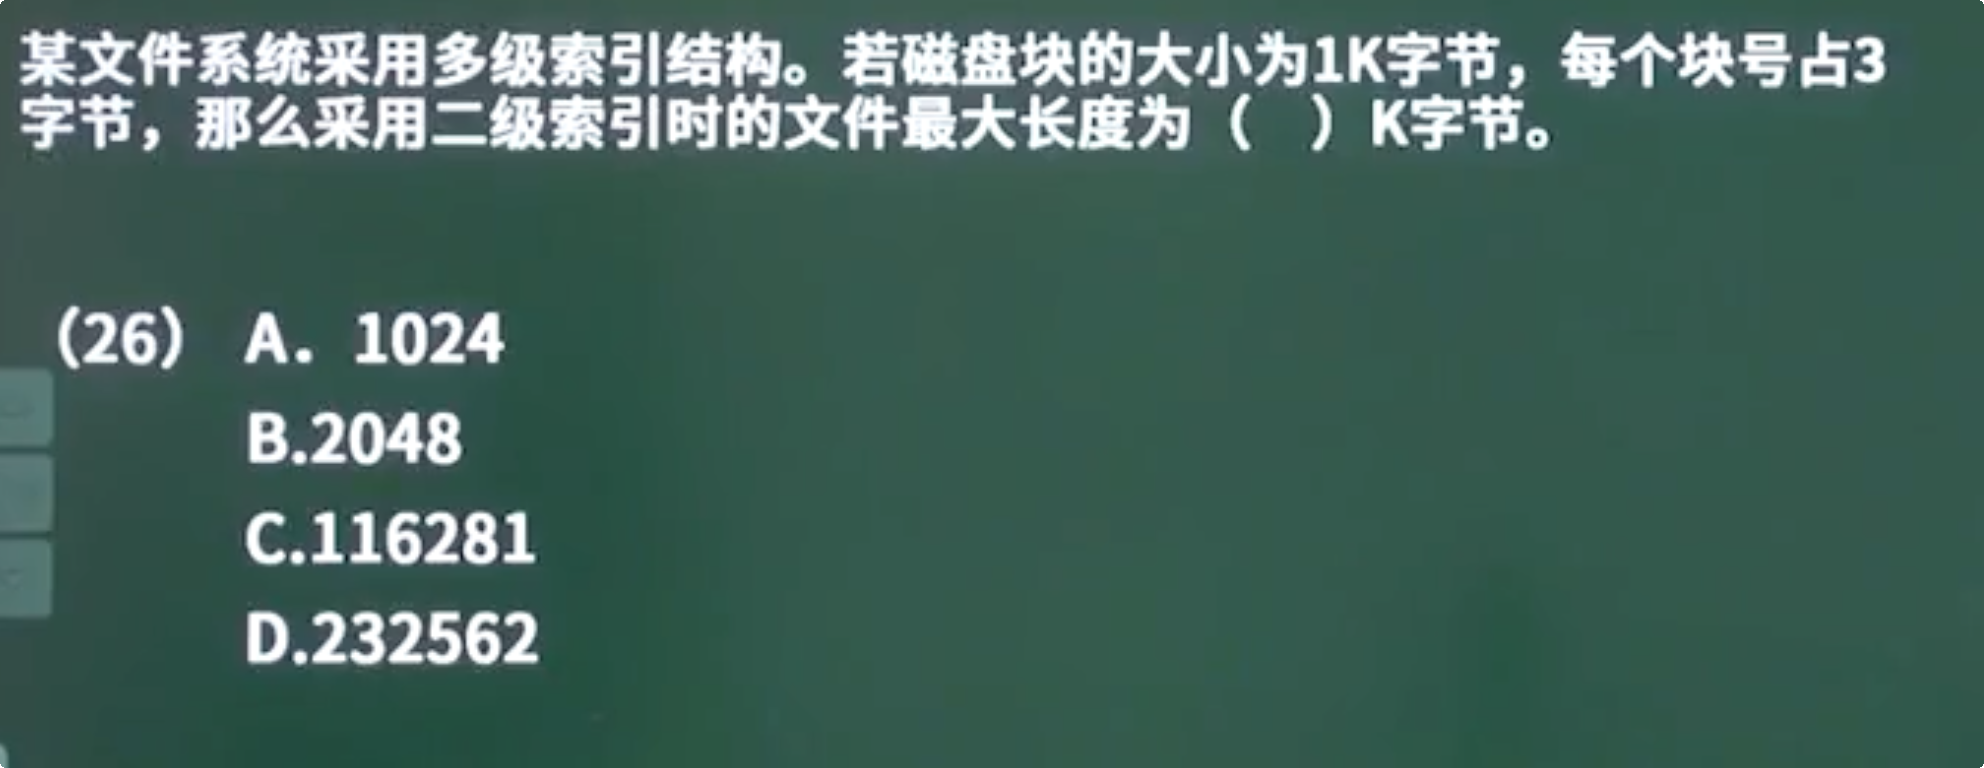
答:选C。
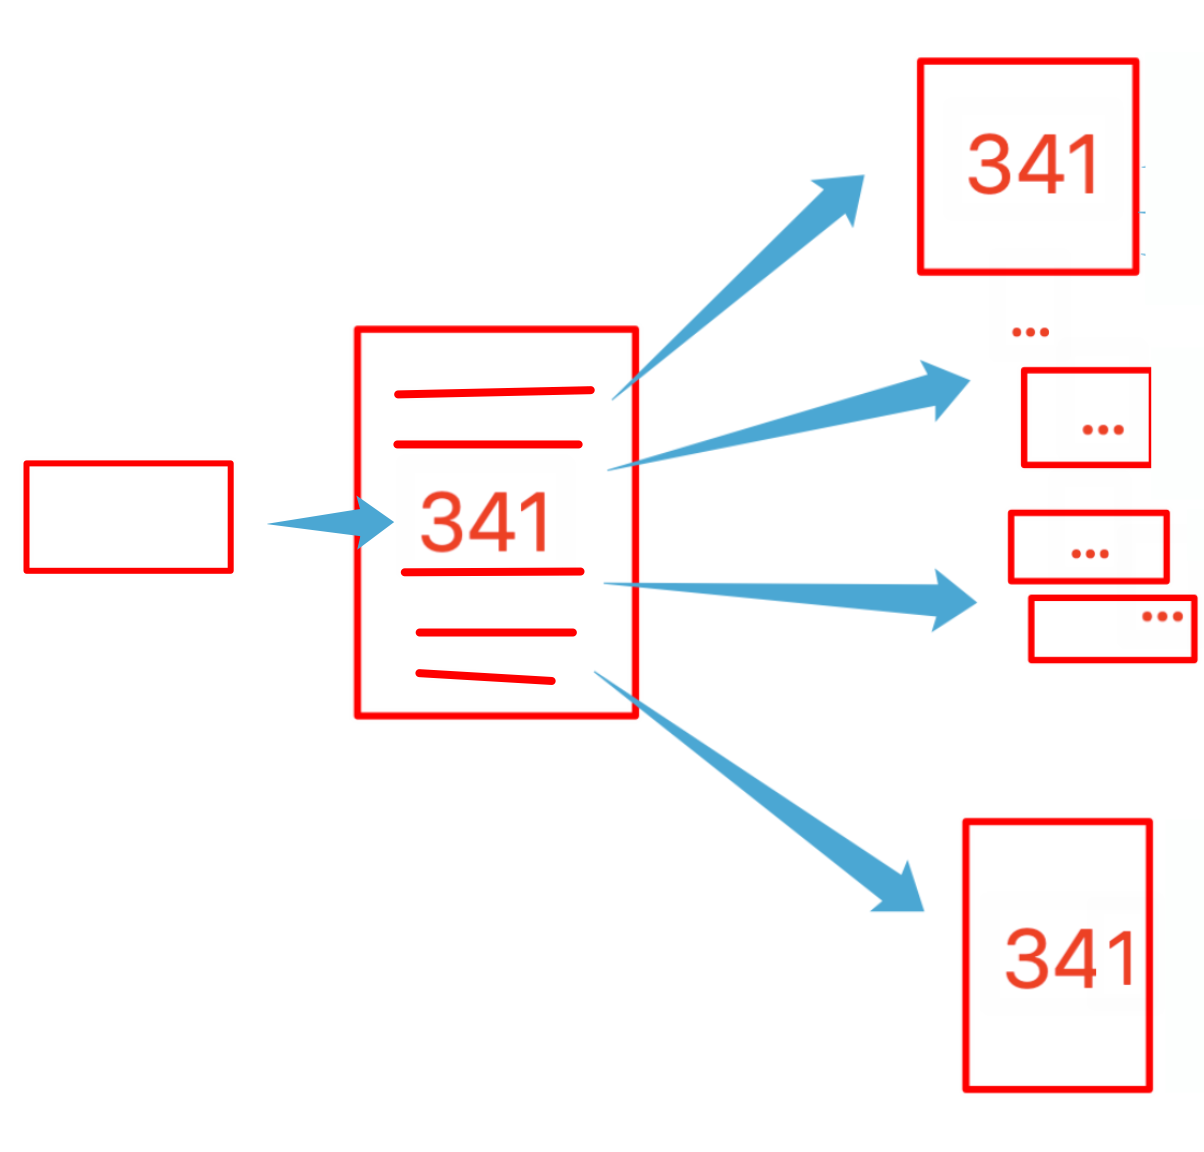
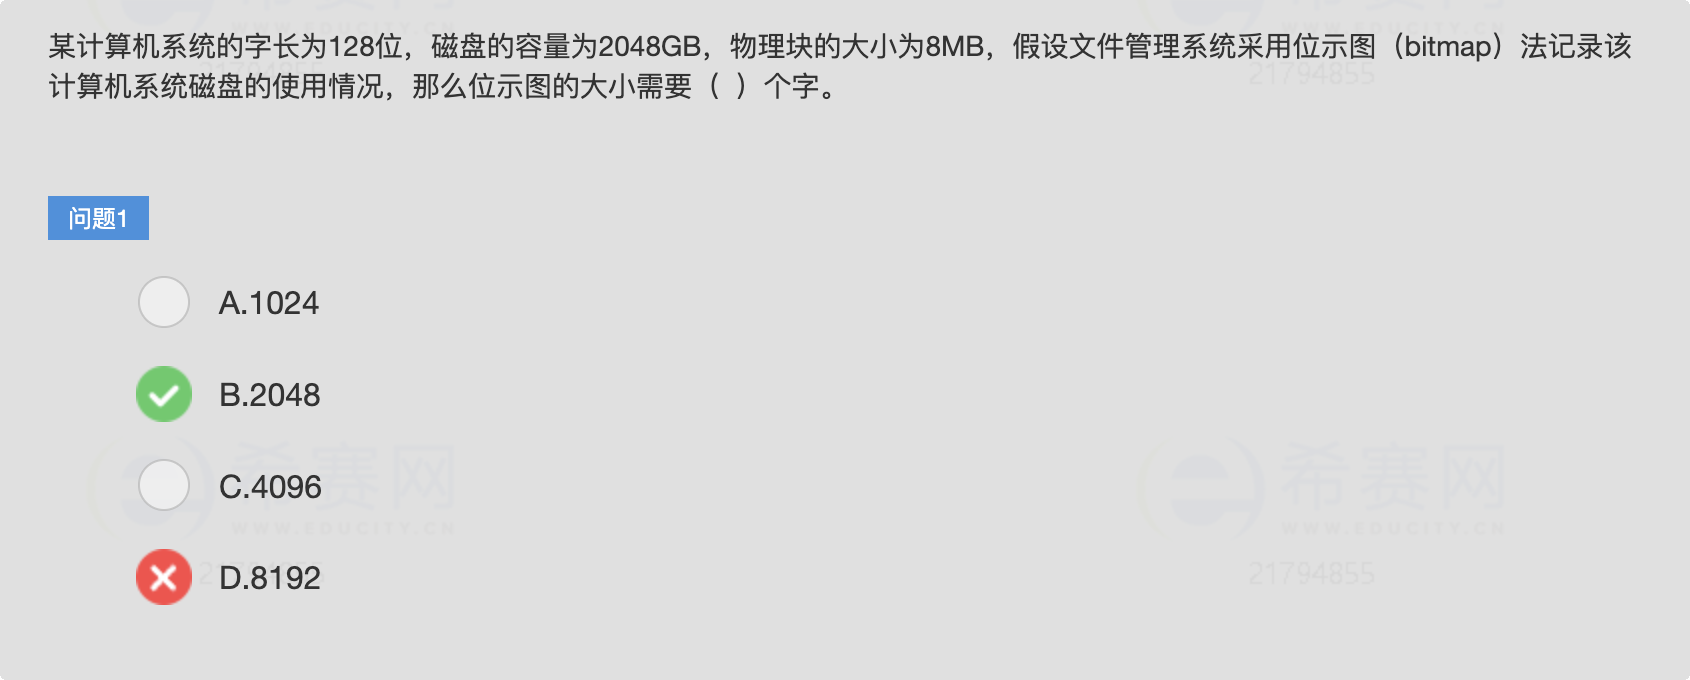
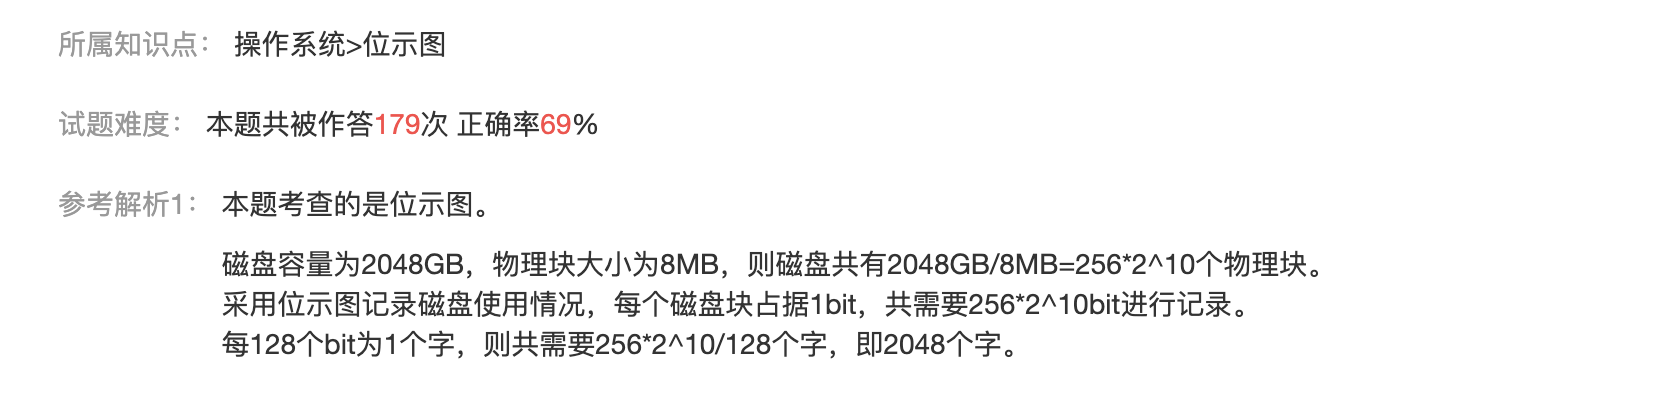
对于一个磁盘块,可以存放个块号(余数部分放不下一个块号,故舍弃),采用二级索引时,则共有个磁盘,每个磁盘块的大小为1K字节,所以采用二级索引时的文件最大长度为116281K字节。
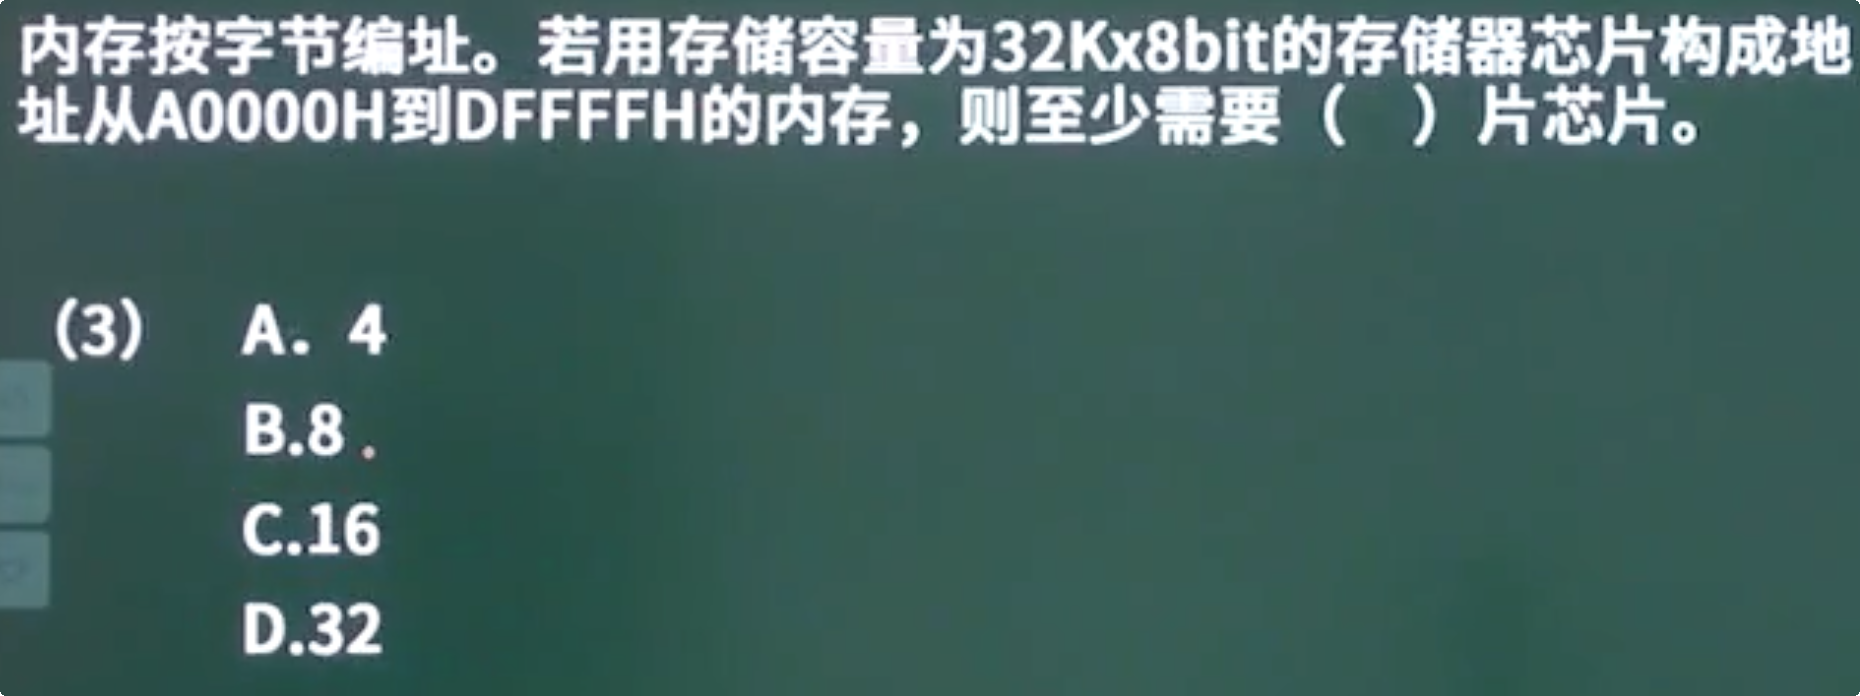
答:选B。存储器芯片地址所构成的存储单元个数为:最大地址+1-最小地址,即:DFFFFH+1-A0000H=40000H=。由于内存按字节编制,故存储容量为。
所以,
即至少需要8片芯片。
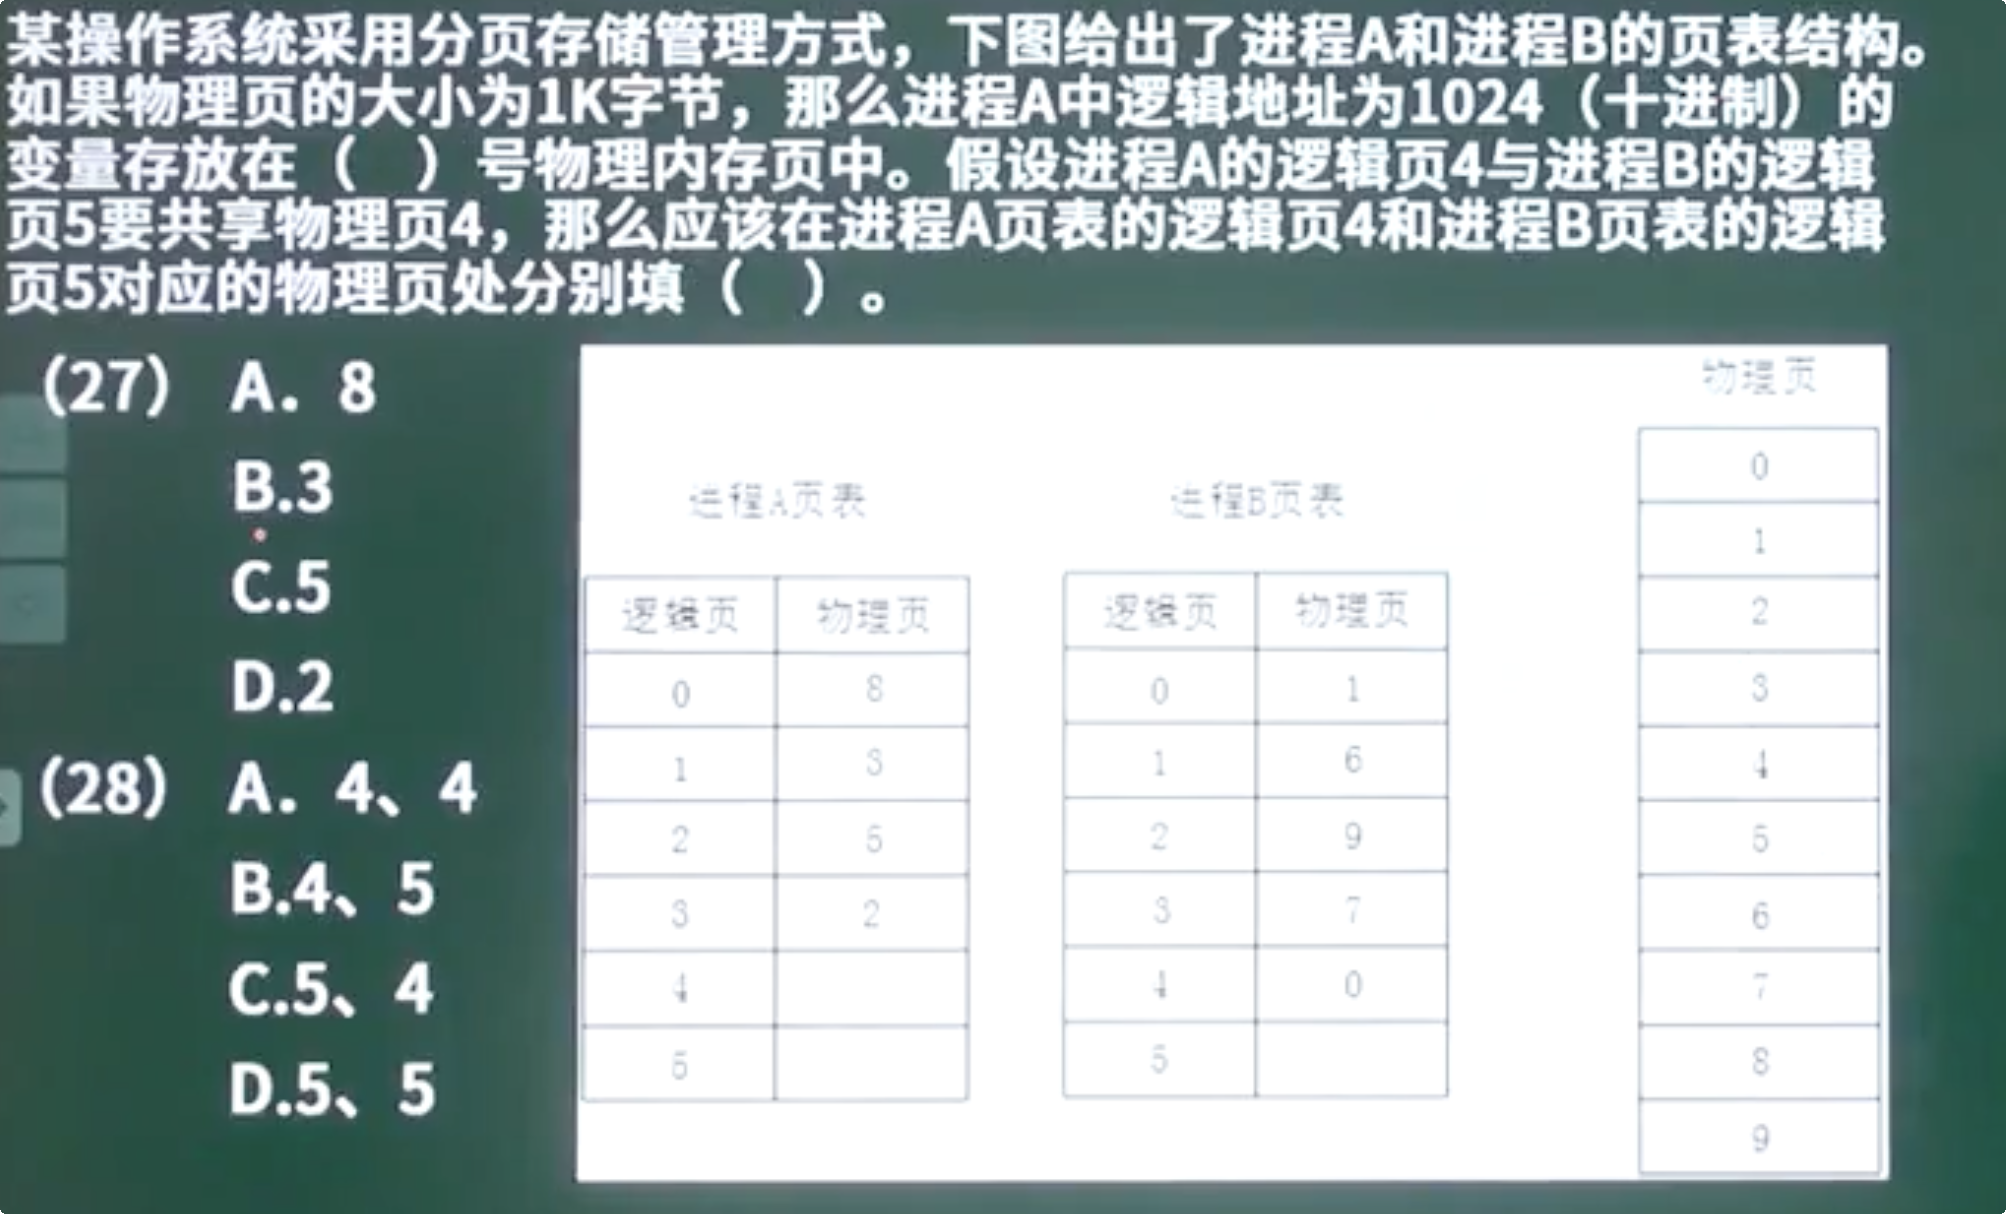
答:27、选B。 28、选A。
(27)由于物理页大小为1K字节,故表示需要十位二进制数表示页内地址。又逻辑地址为十进制数1024转为为二进制为,其中1为逻辑页,后边10个0为页内地址,故存放在逻辑页为1所对应的3号物理内存页中。
(28)进程A的逻辑页4要与进程B的逻辑页5共享物理页4,故其物理页分别都填写4。
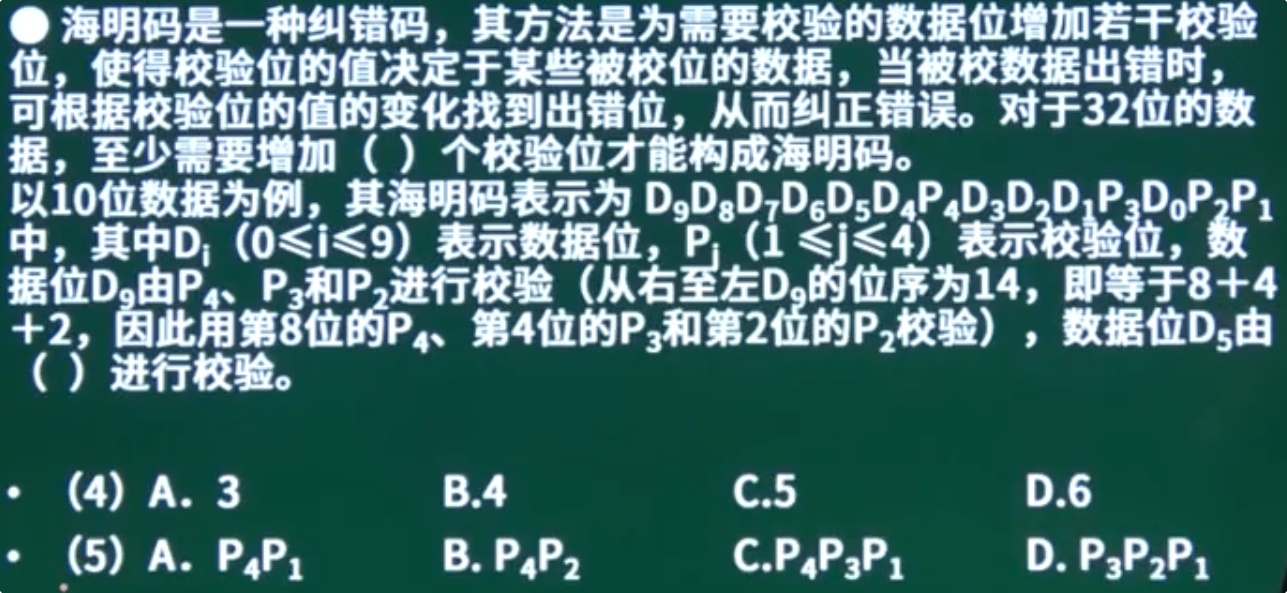
答:(4)D (5)B
(4)由(r为校验位,m为数据)可得:,故需增加6个校验位。
(5)
由上图可知D9的位序是14,而D5的位序是10,14=8+4+2,即由P4、P3、P2校验,故10=8+2,即由P4、P2校验。

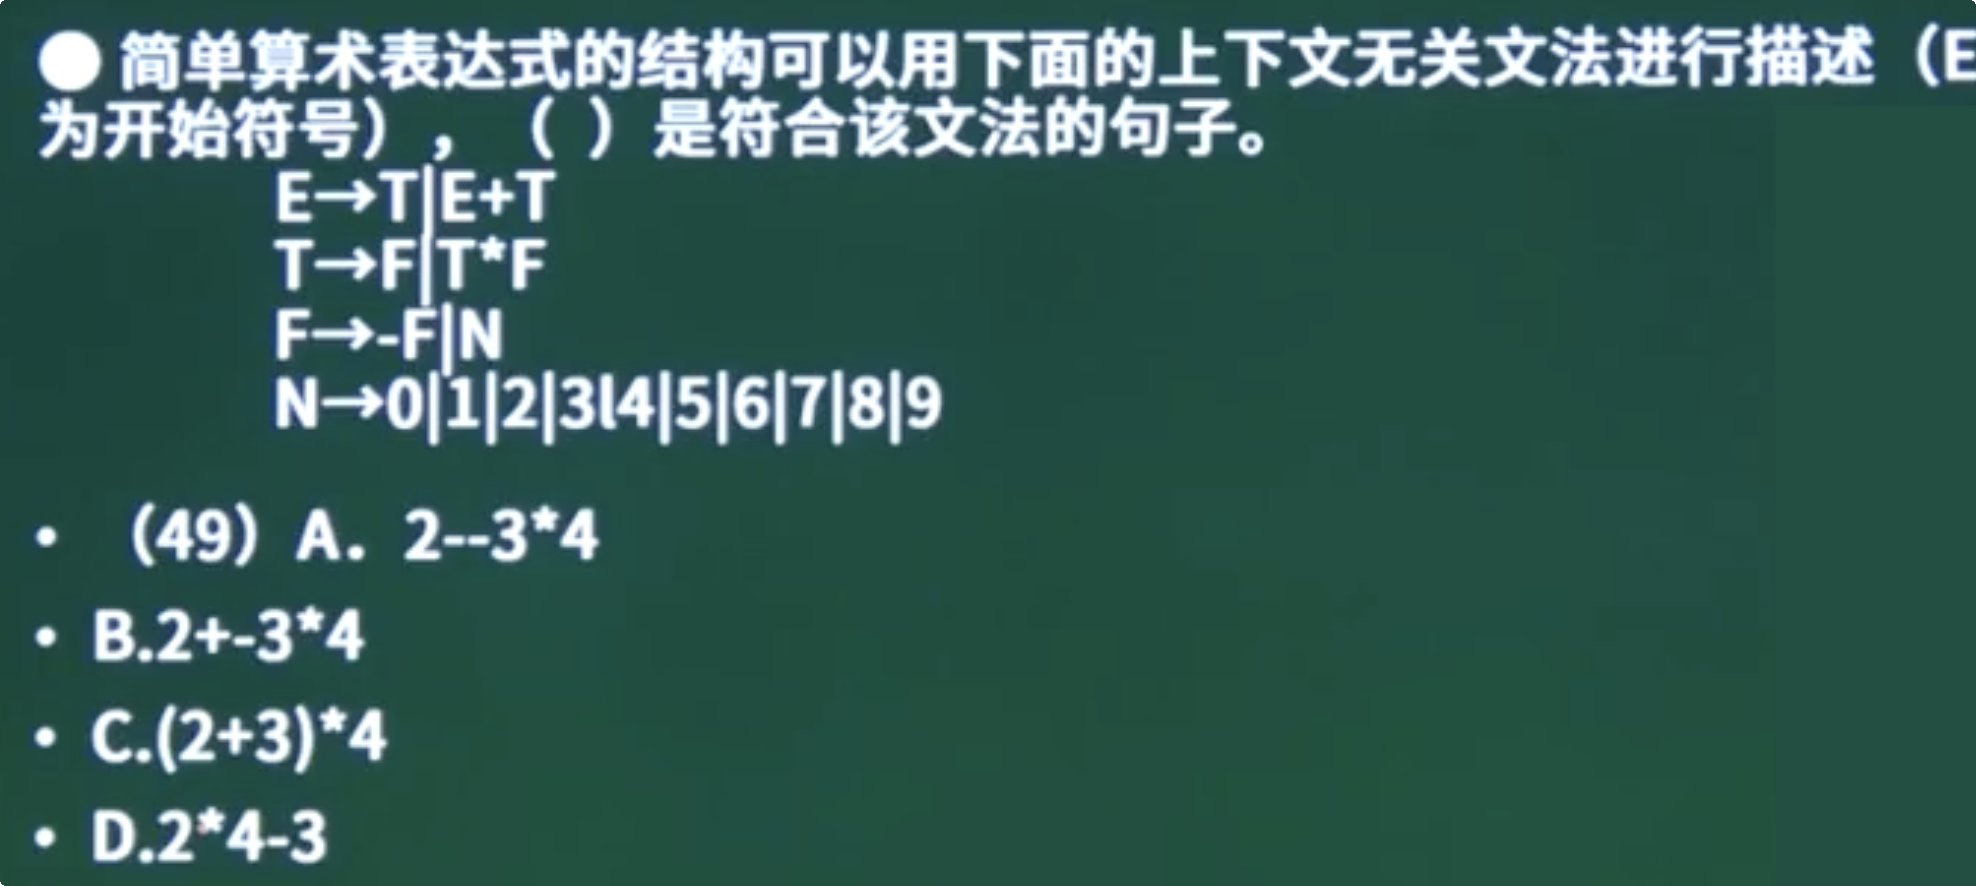
答:选B。
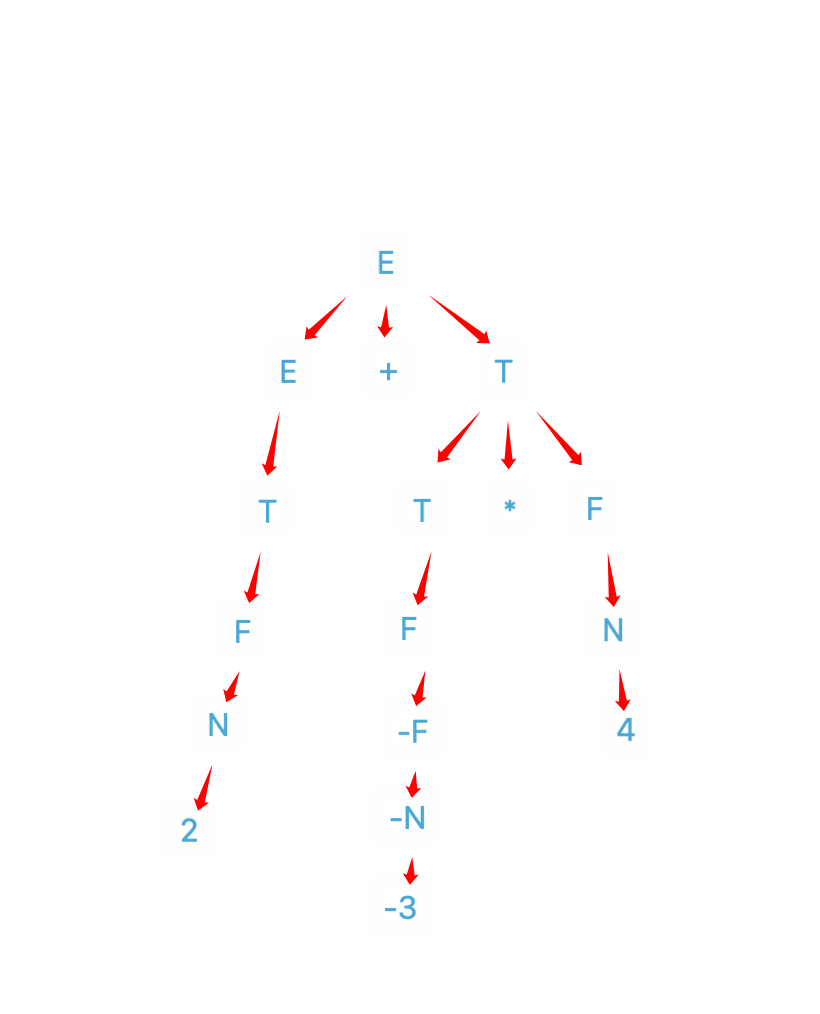
推导如下,A选项有两个-,故可以先排除,D选项先*的话得不到有三个数
图相关
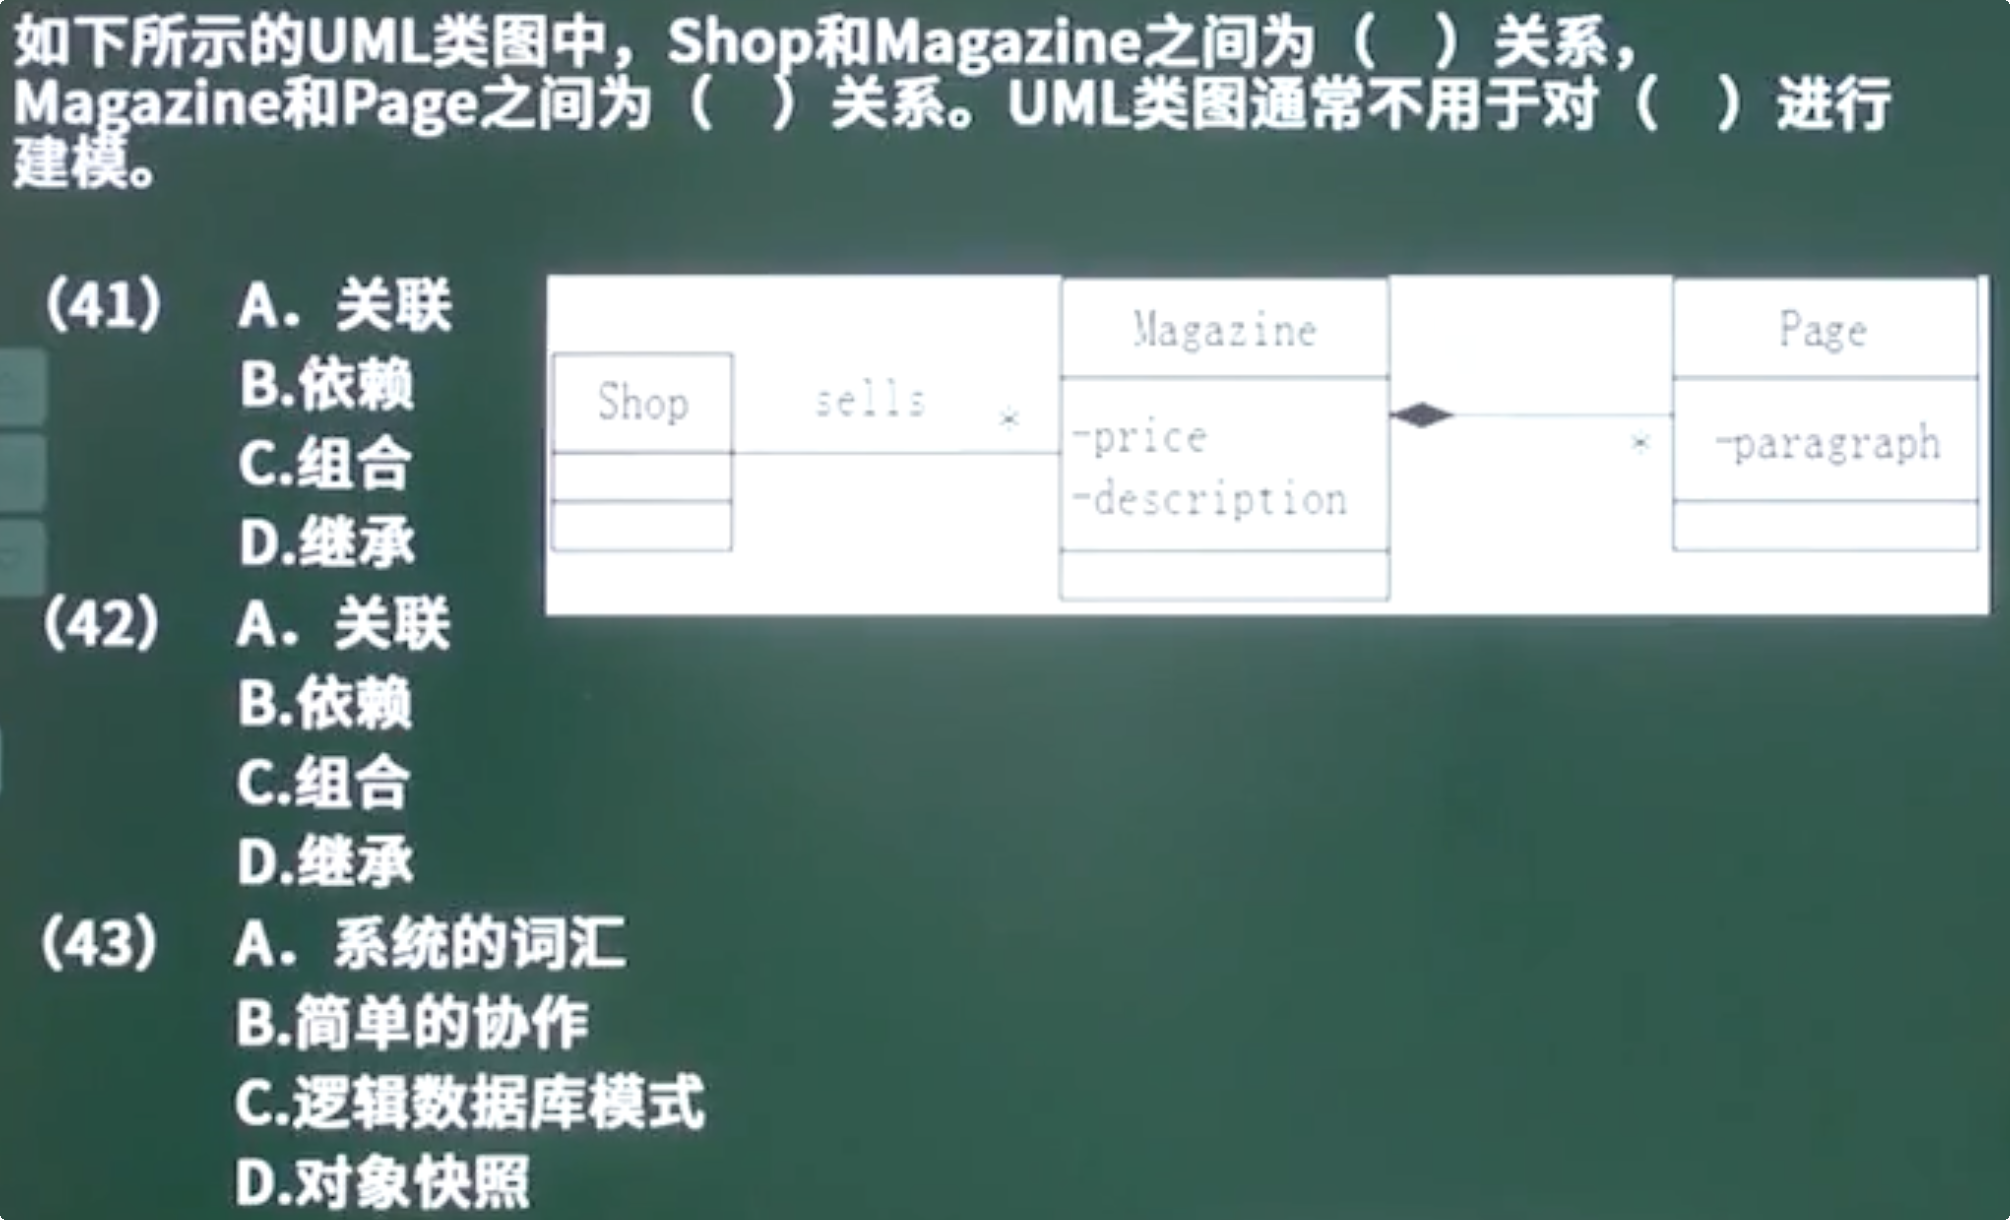
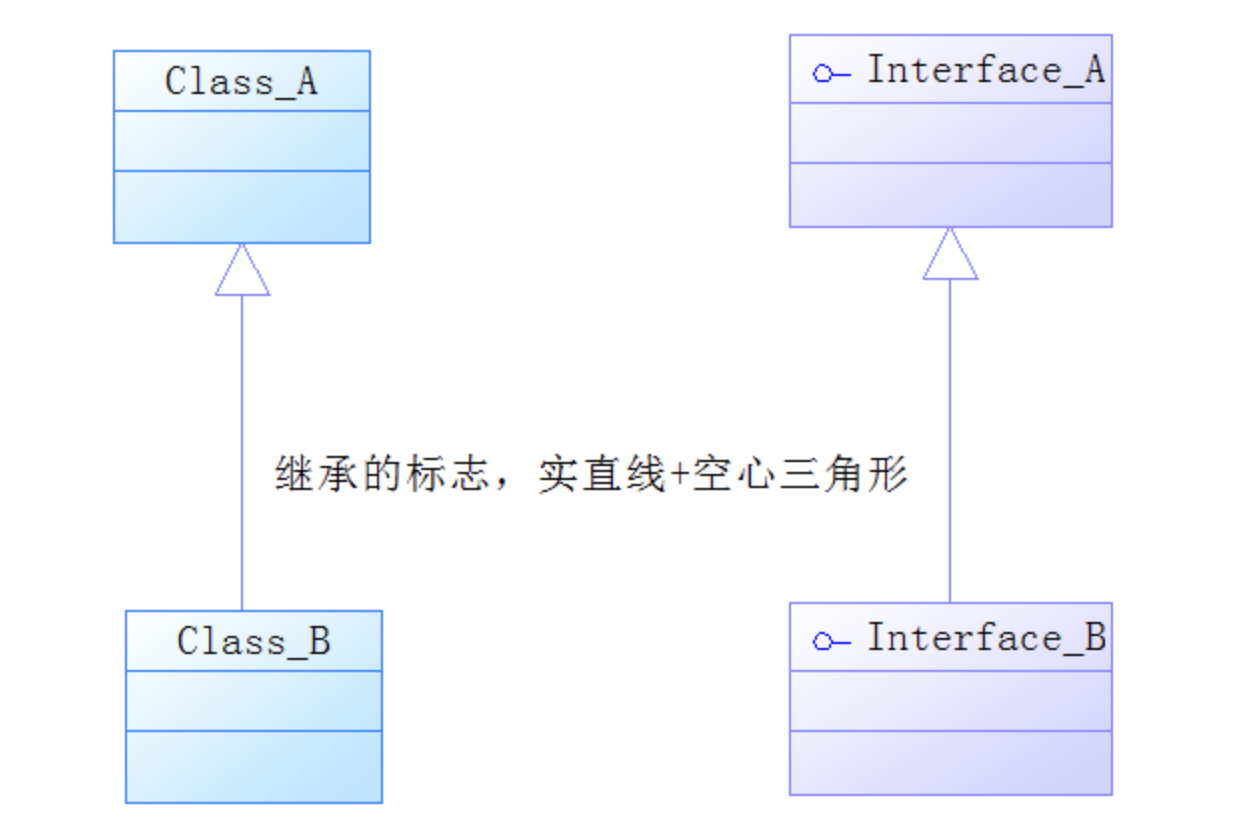
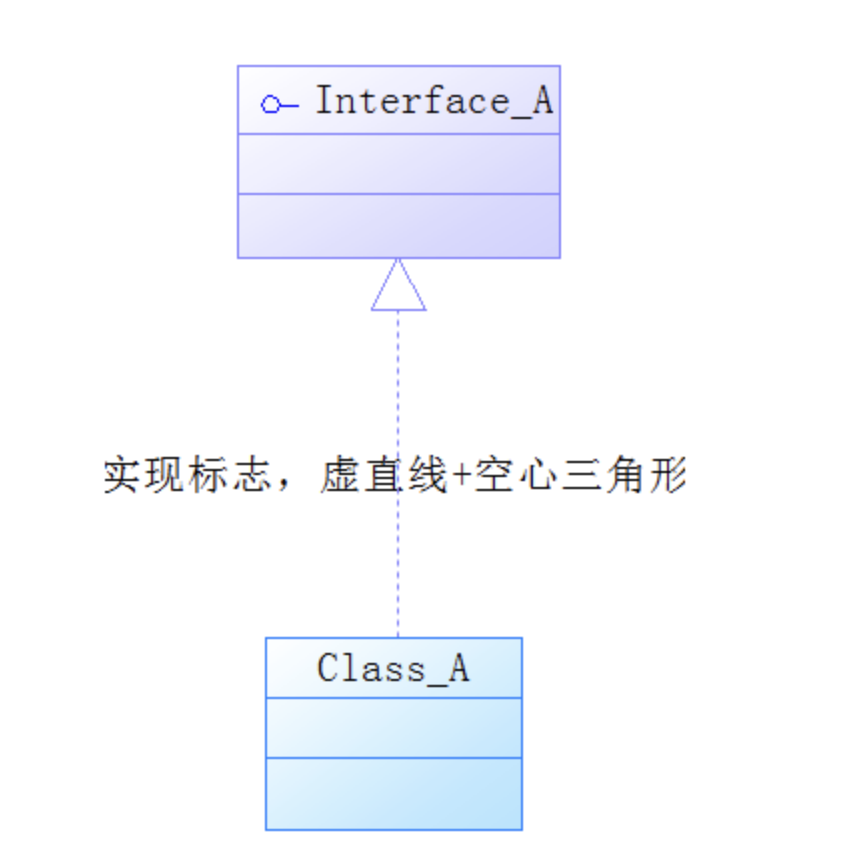
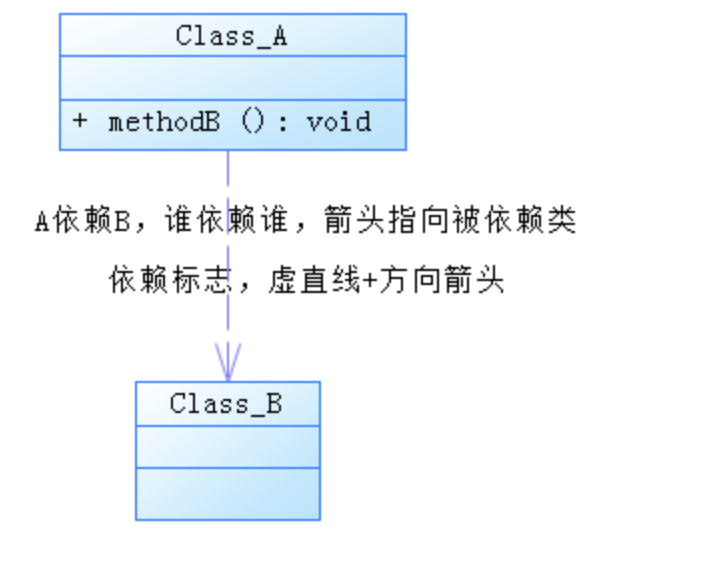
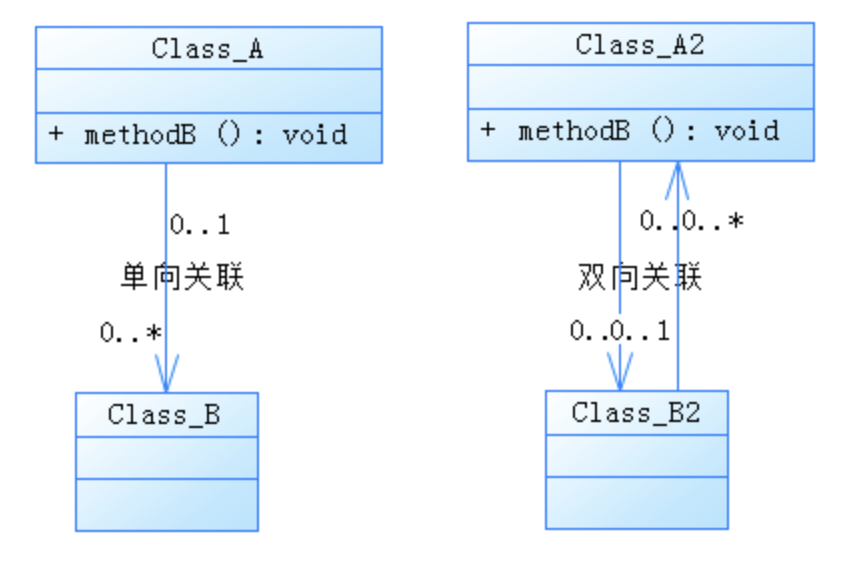
答:(41)A (42) C (43)D
(41)与(42)
继承:
实现:
依赖:
关联:
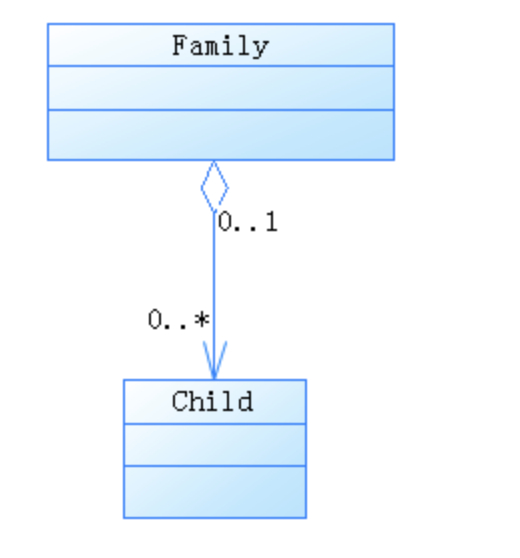
聚合:
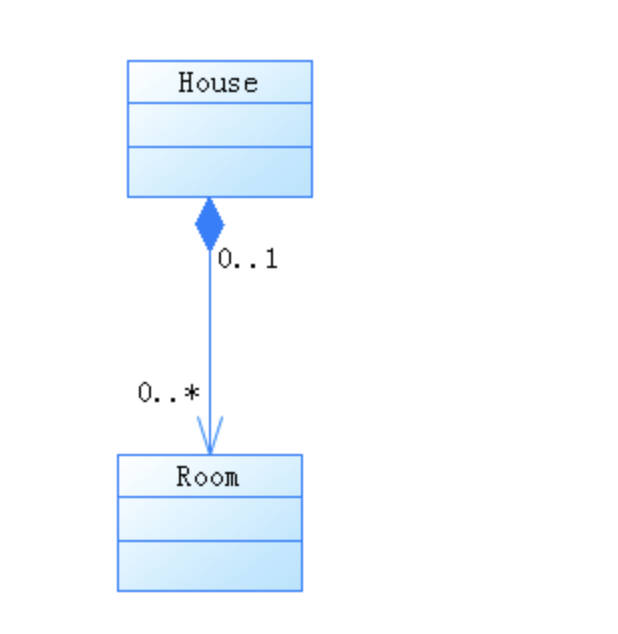
组合:
(43)对象快照是对象图。
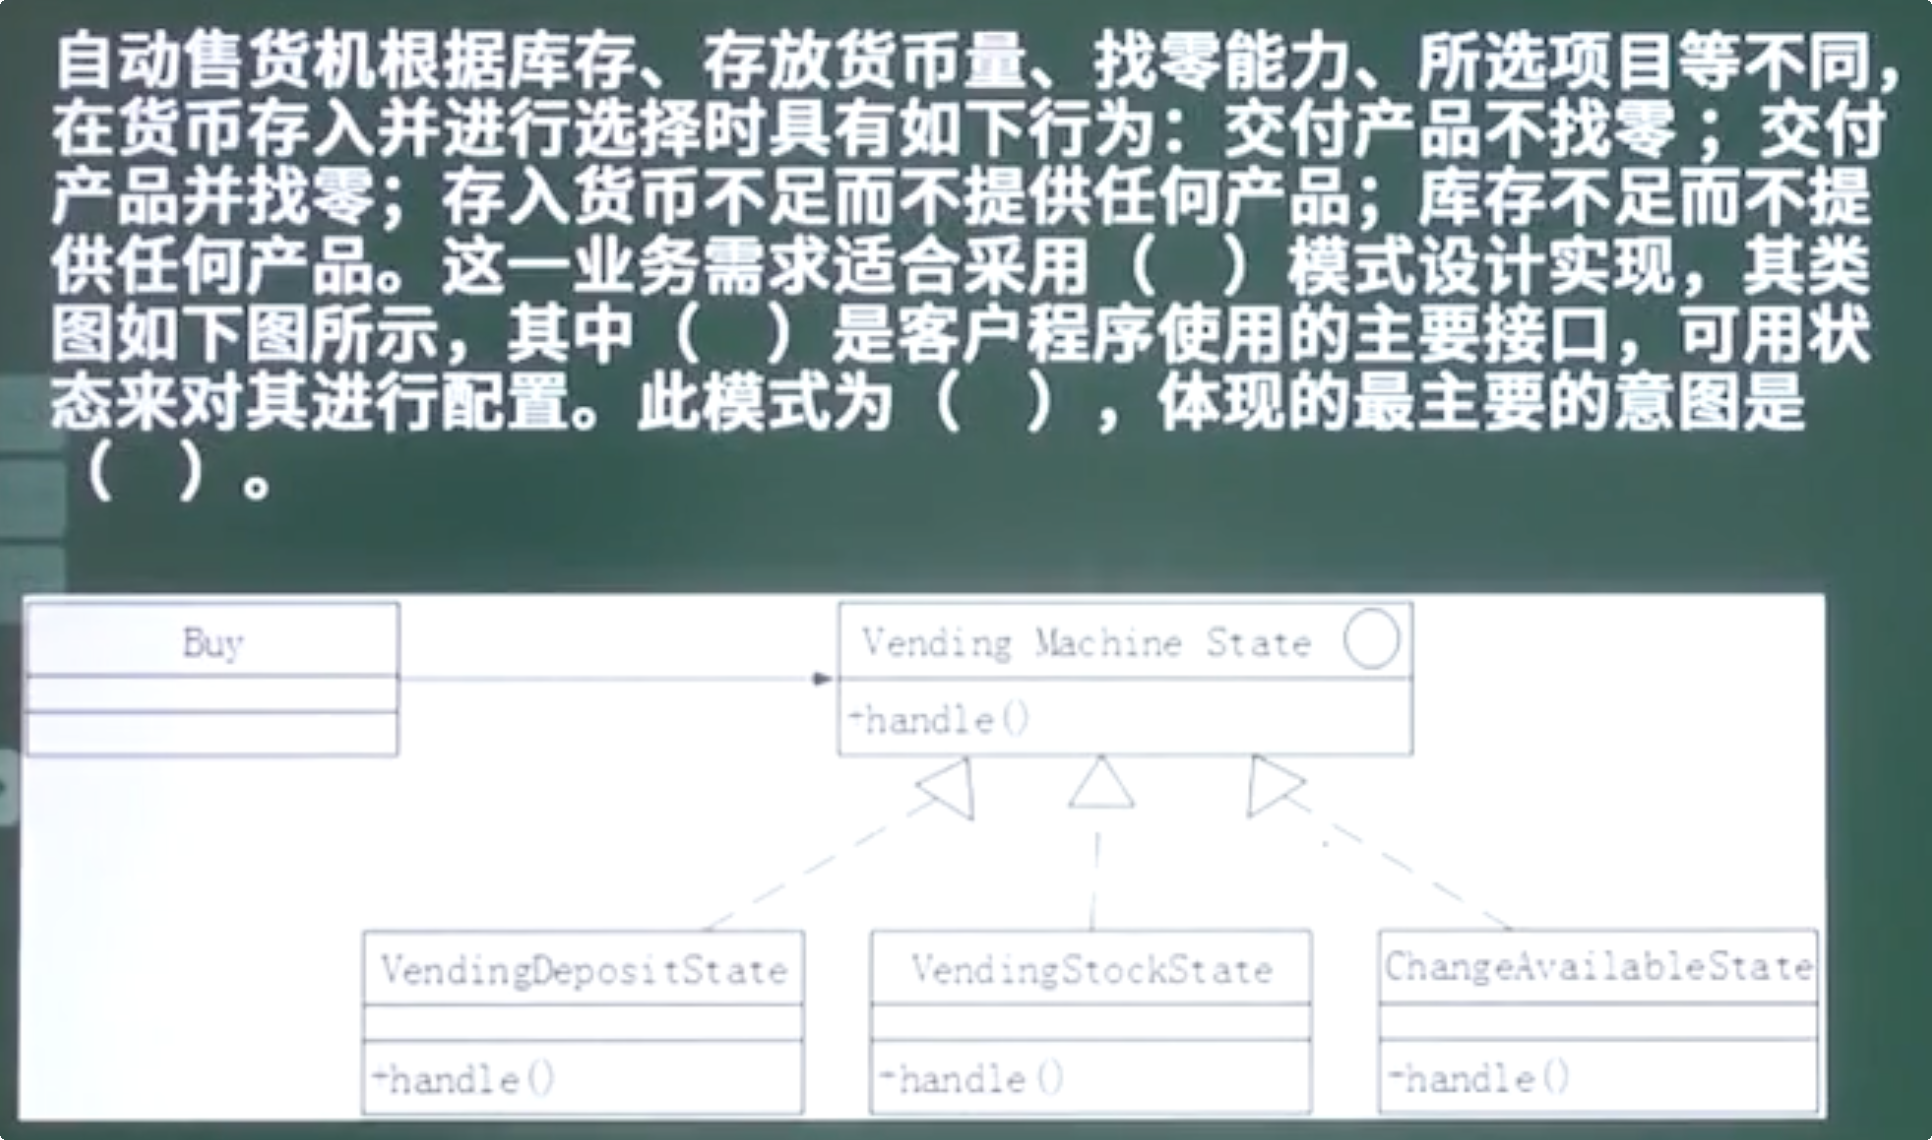
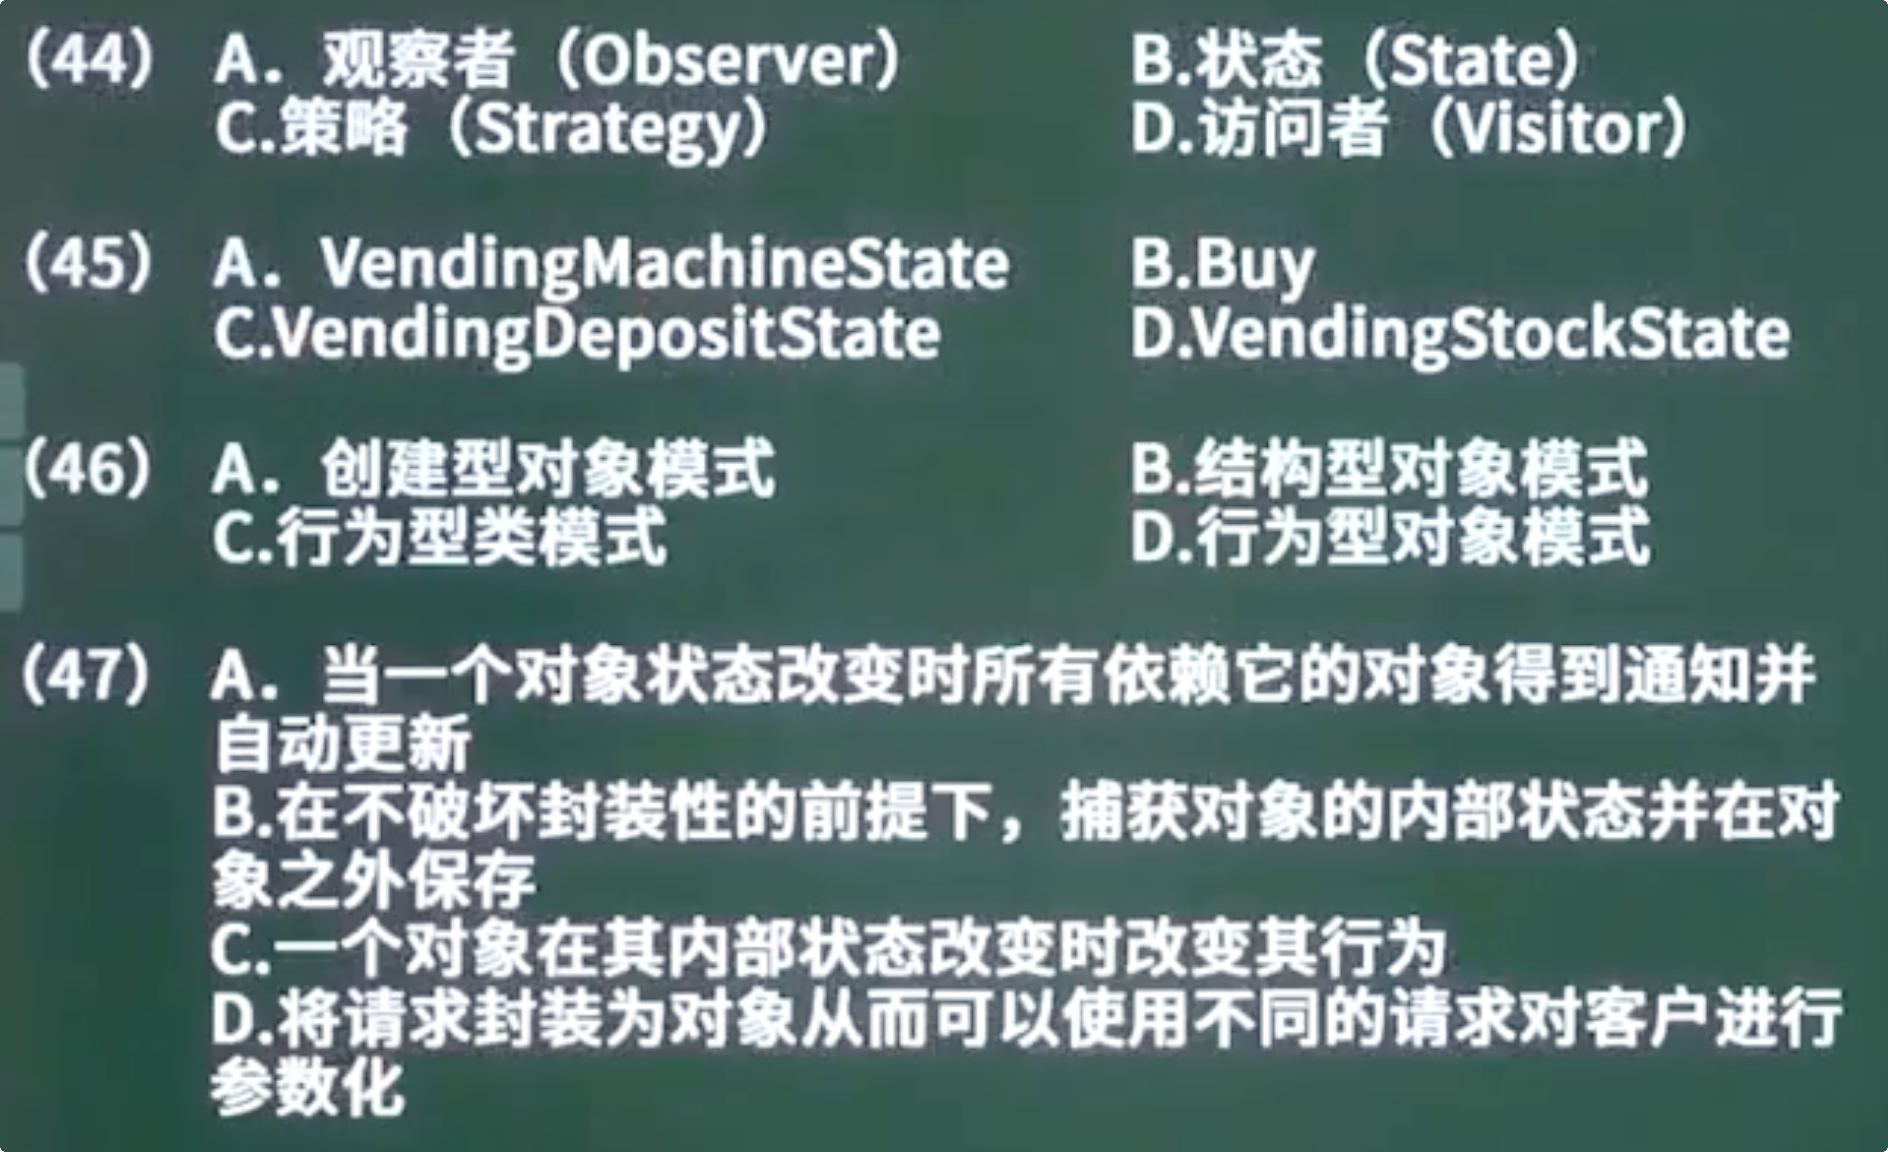
答:(1)B (2)B (3)D (4)C
状态模式,一种行为型设计模式,允许一个对象在其内部状态改变时改变它的行为。这种类型的设计模式将与特定状态相关的行为局部化到一个状态中,并将不同状态的行为分割开来,从而满足“单一职责原则”。
行为型模式分为类行为模式和对象行为模式,前者采用继承机制来在类间分派行为,后者采用组合或聚合在对象间分配行为。在状态模式中,我们创建表示各种状态的对象和一个行为随着状态对象改变而改变的 context 对象。因此,状态模式可以被视为行为型对象模式。
(45)Buy是提供给用户使用的,故为客户程序使用的主要接口。
(47)A是观察者模式的描述;B是对备忘录模式的描述;D访问者模式的描述。
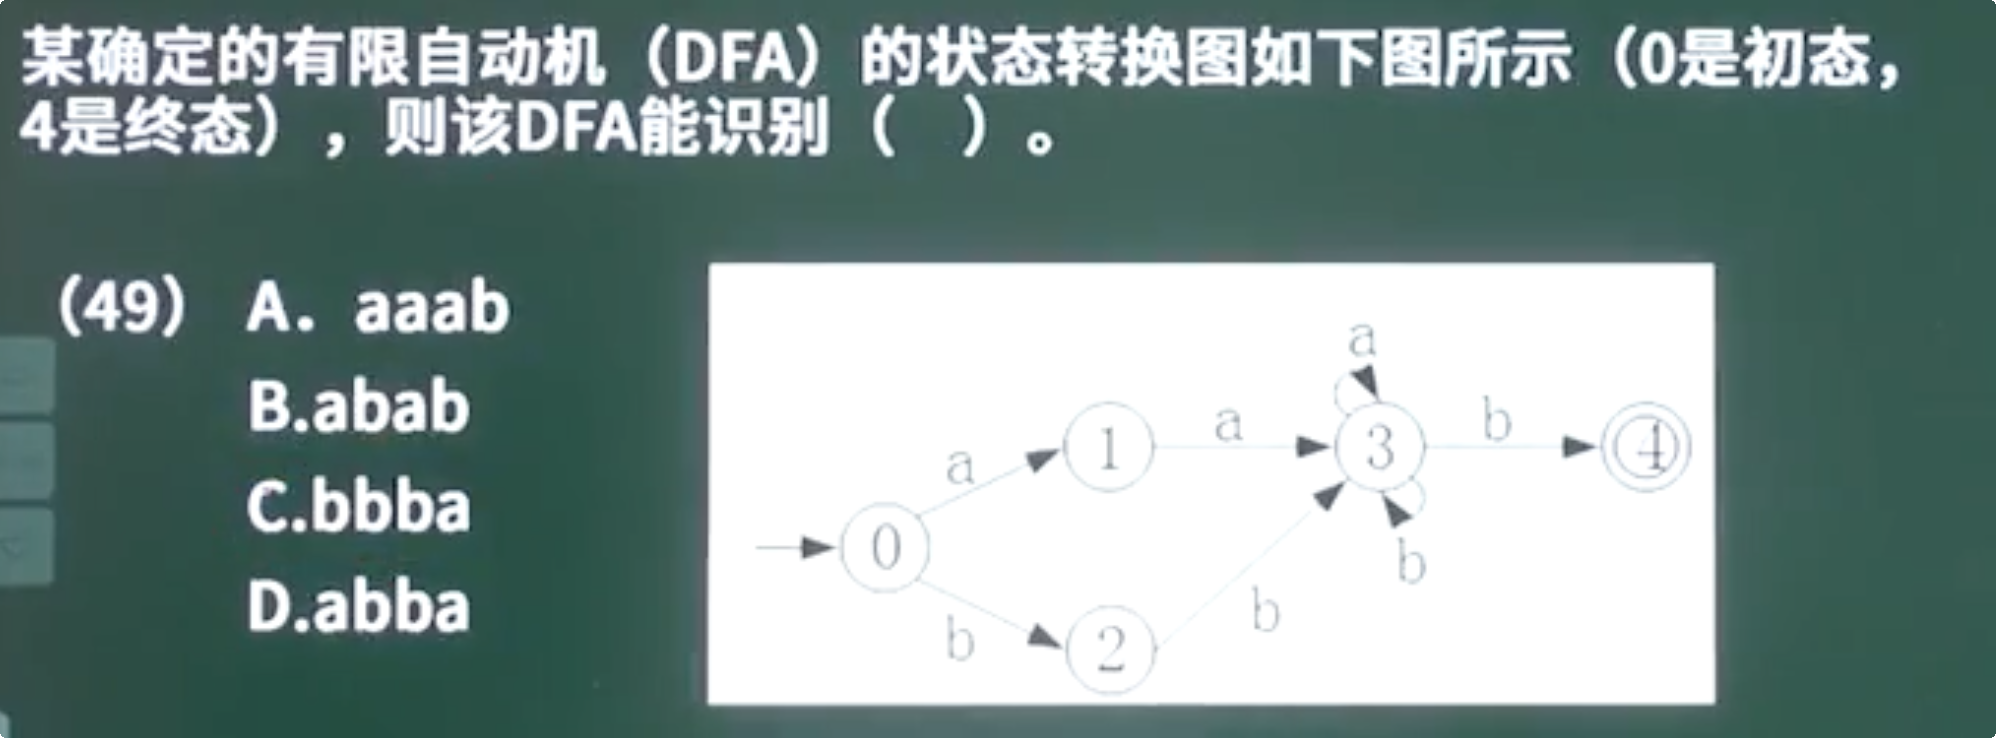
答:选A。
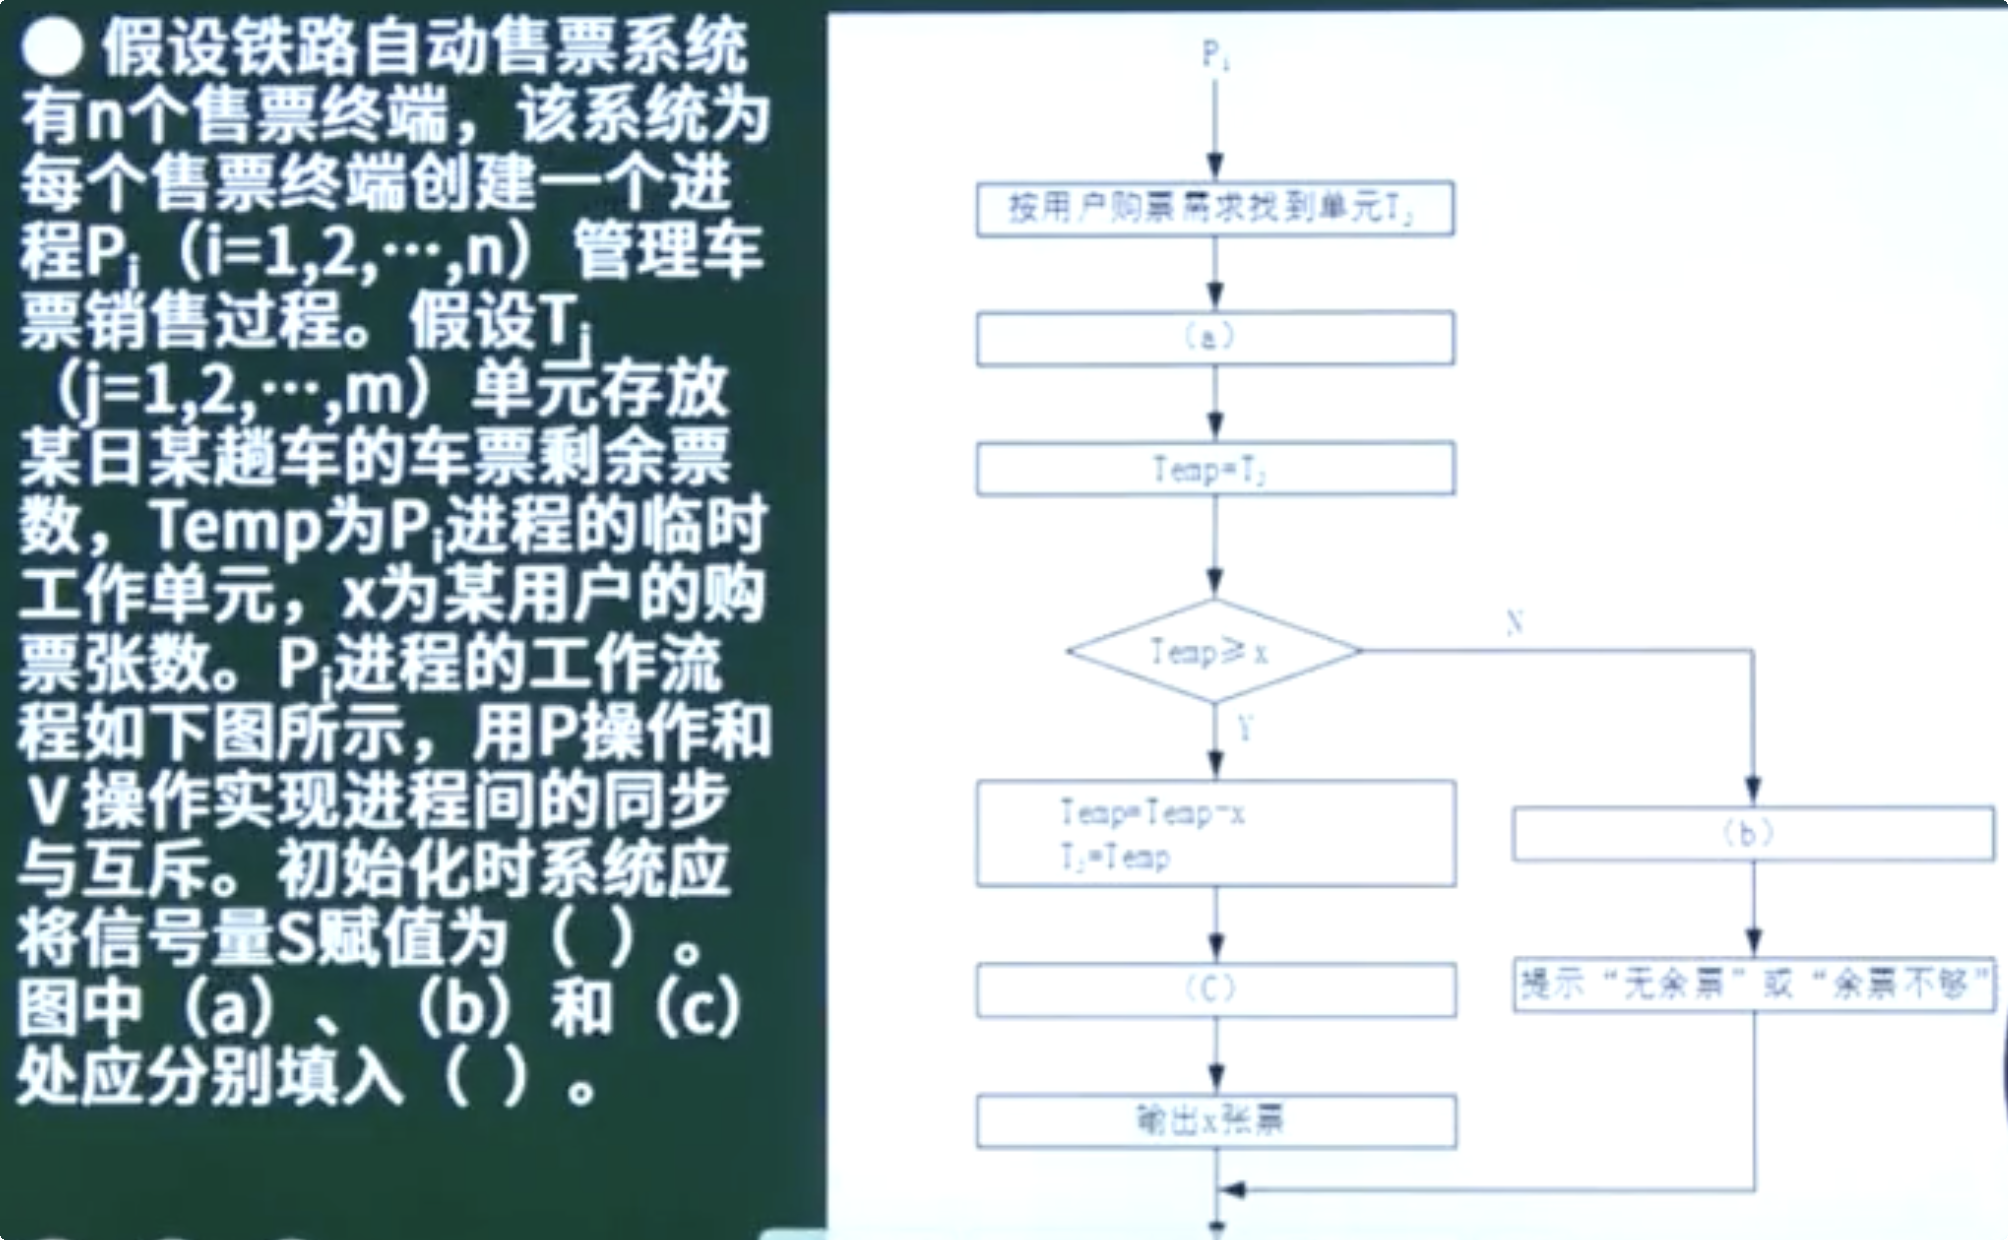
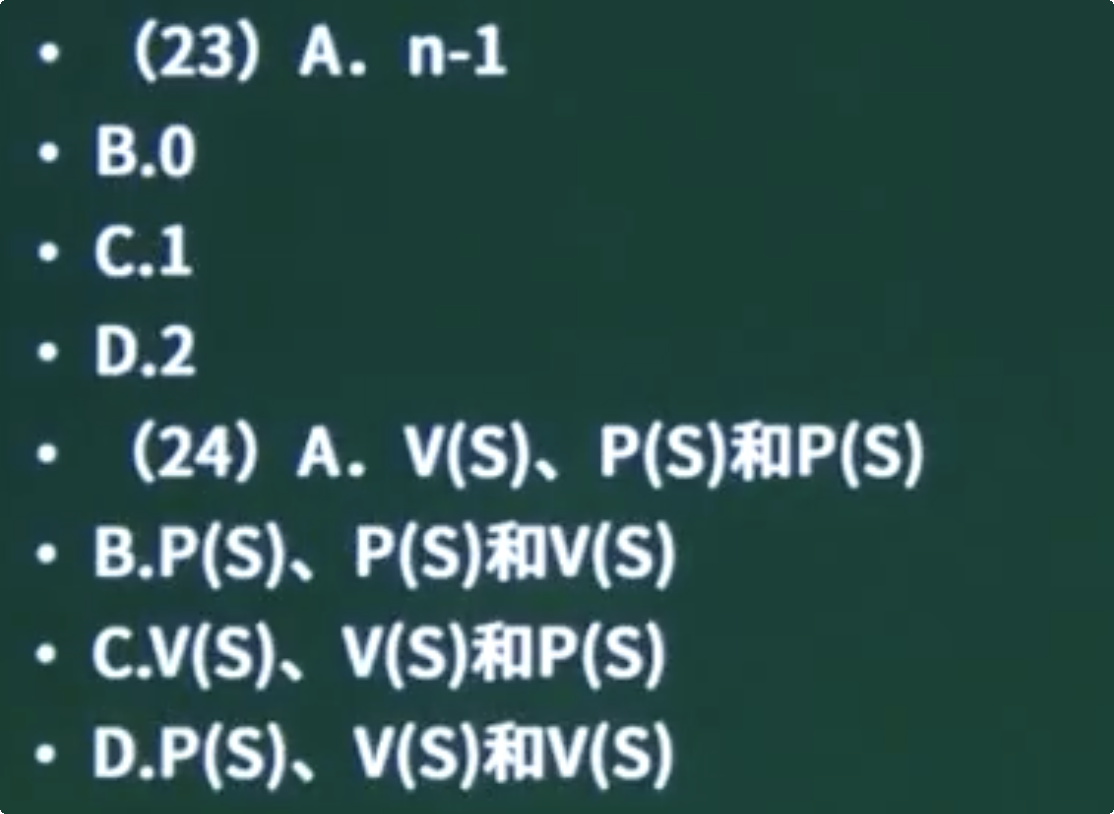
答:(23)C (24)D。
信号量S赋值为1,因为同一时刻只能有一个进程来售票,多个进程可能会使售票数据异常。
在开始进行操作时,需要先进行申请资源(P(S)),若票充足,则执行Y操作,结束后释放资源(V(S)),若余票不足,同样得释放资源(V(S)),避免资源占用浪费,故选D。

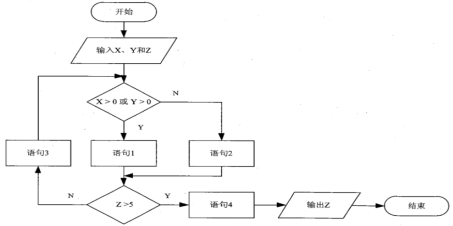
答:(34)A (35)B。
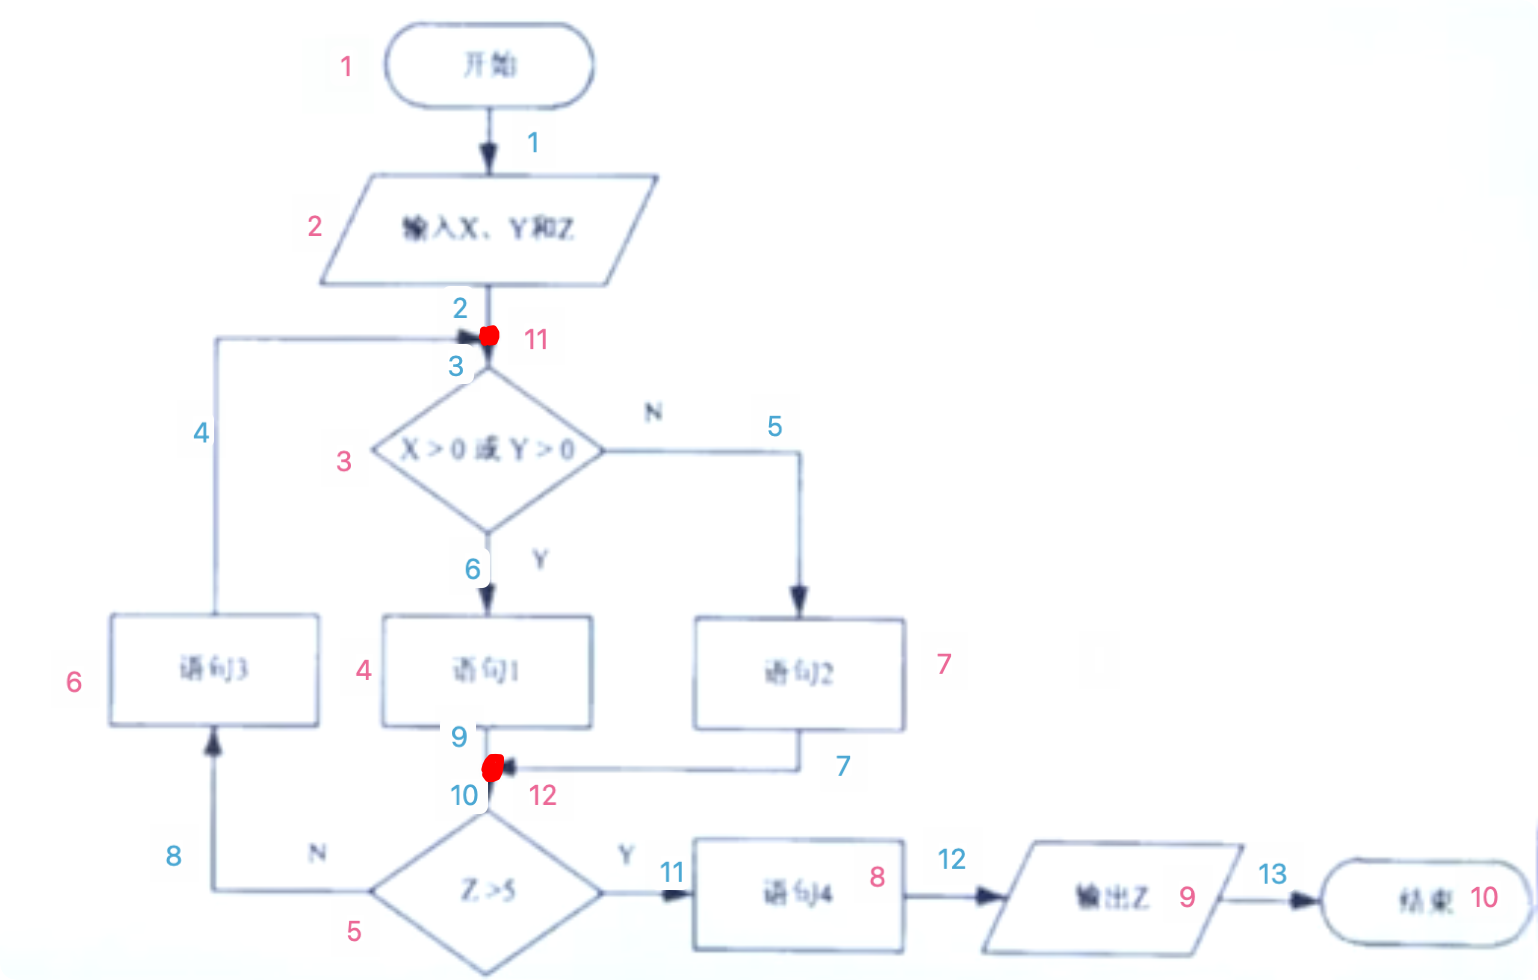
(34)第一个条件分支与第二个条件分支的条件互不影响,故可对其设两个不同的测试用例条件,即可实现覆盖测试;
(35)计算环路复杂度一般用公式:(其中,m是边,n是点),又由于这里是程序流程图,对于交点位置,需要当做一个结点。如下图所示:(蓝色为边的序号,粉色为点的序号),故其环路复杂度等于。
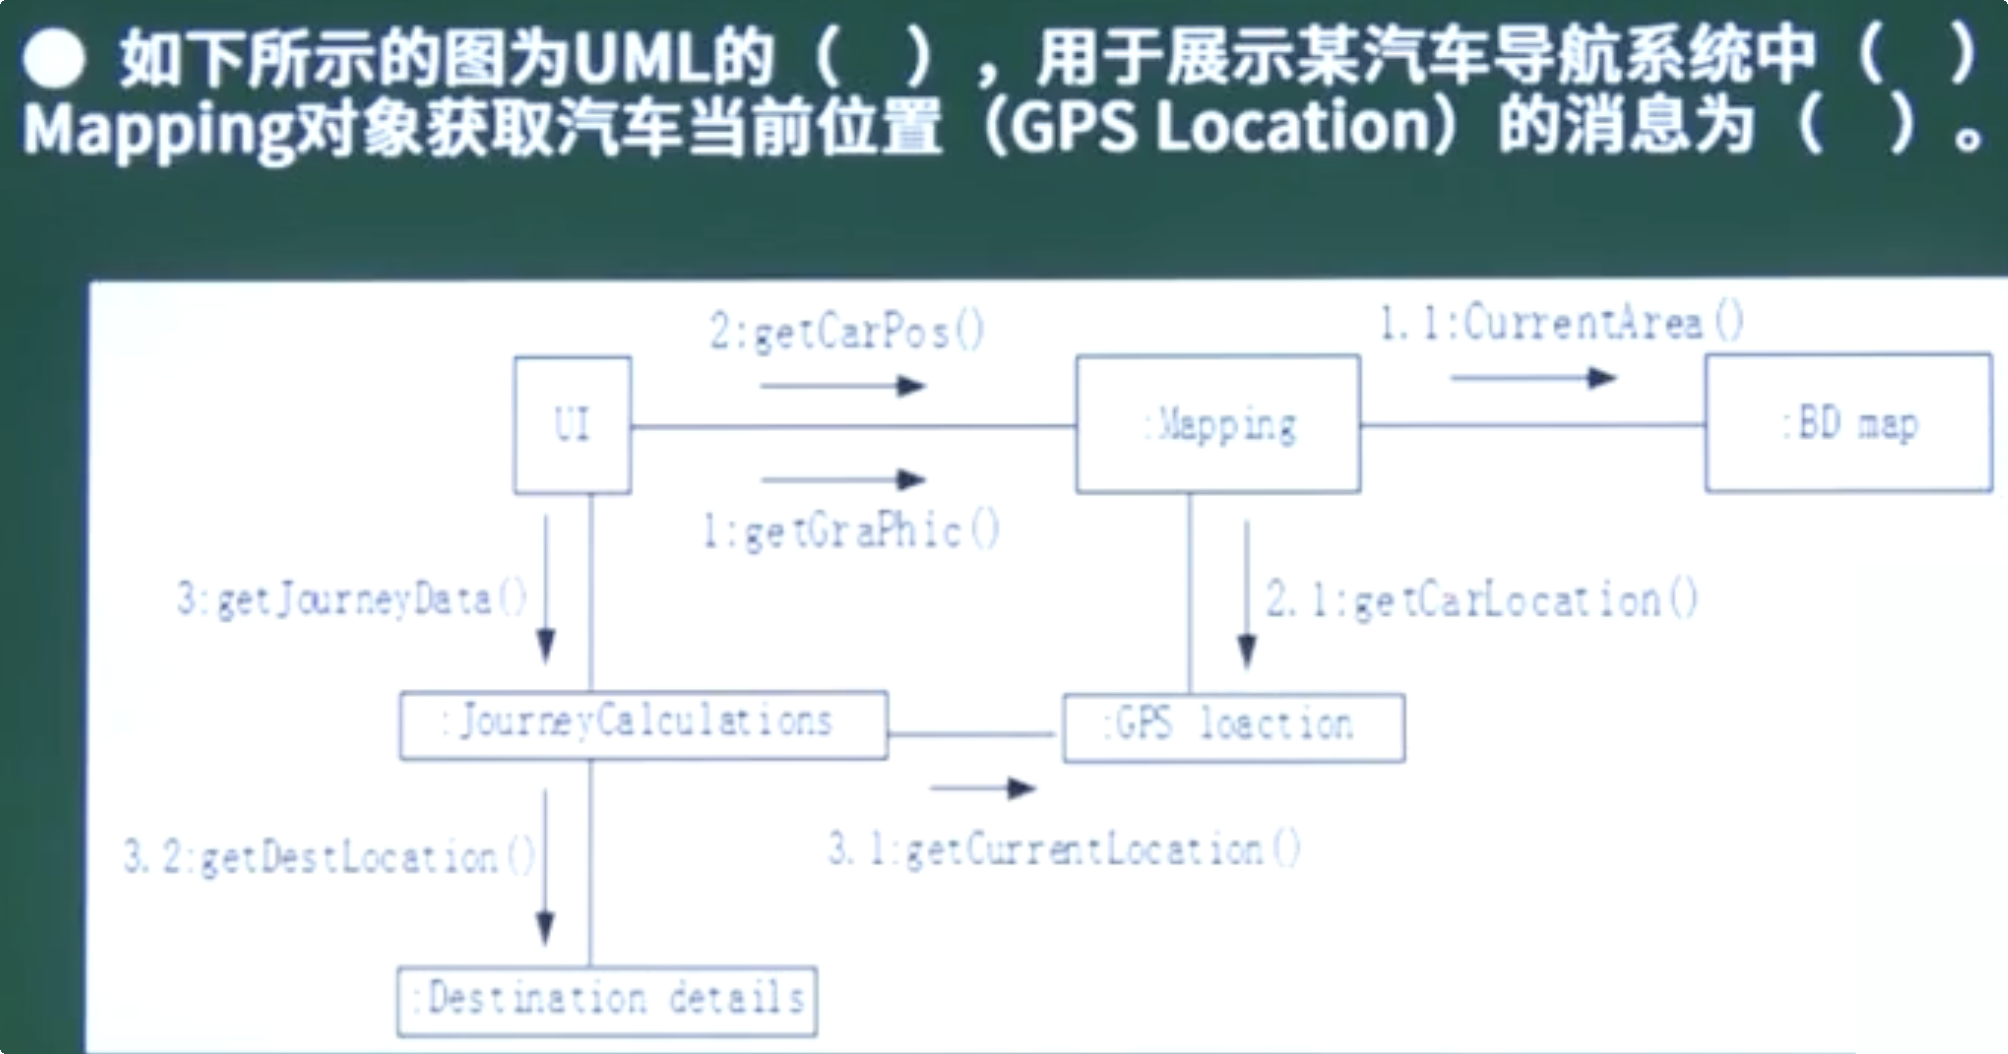
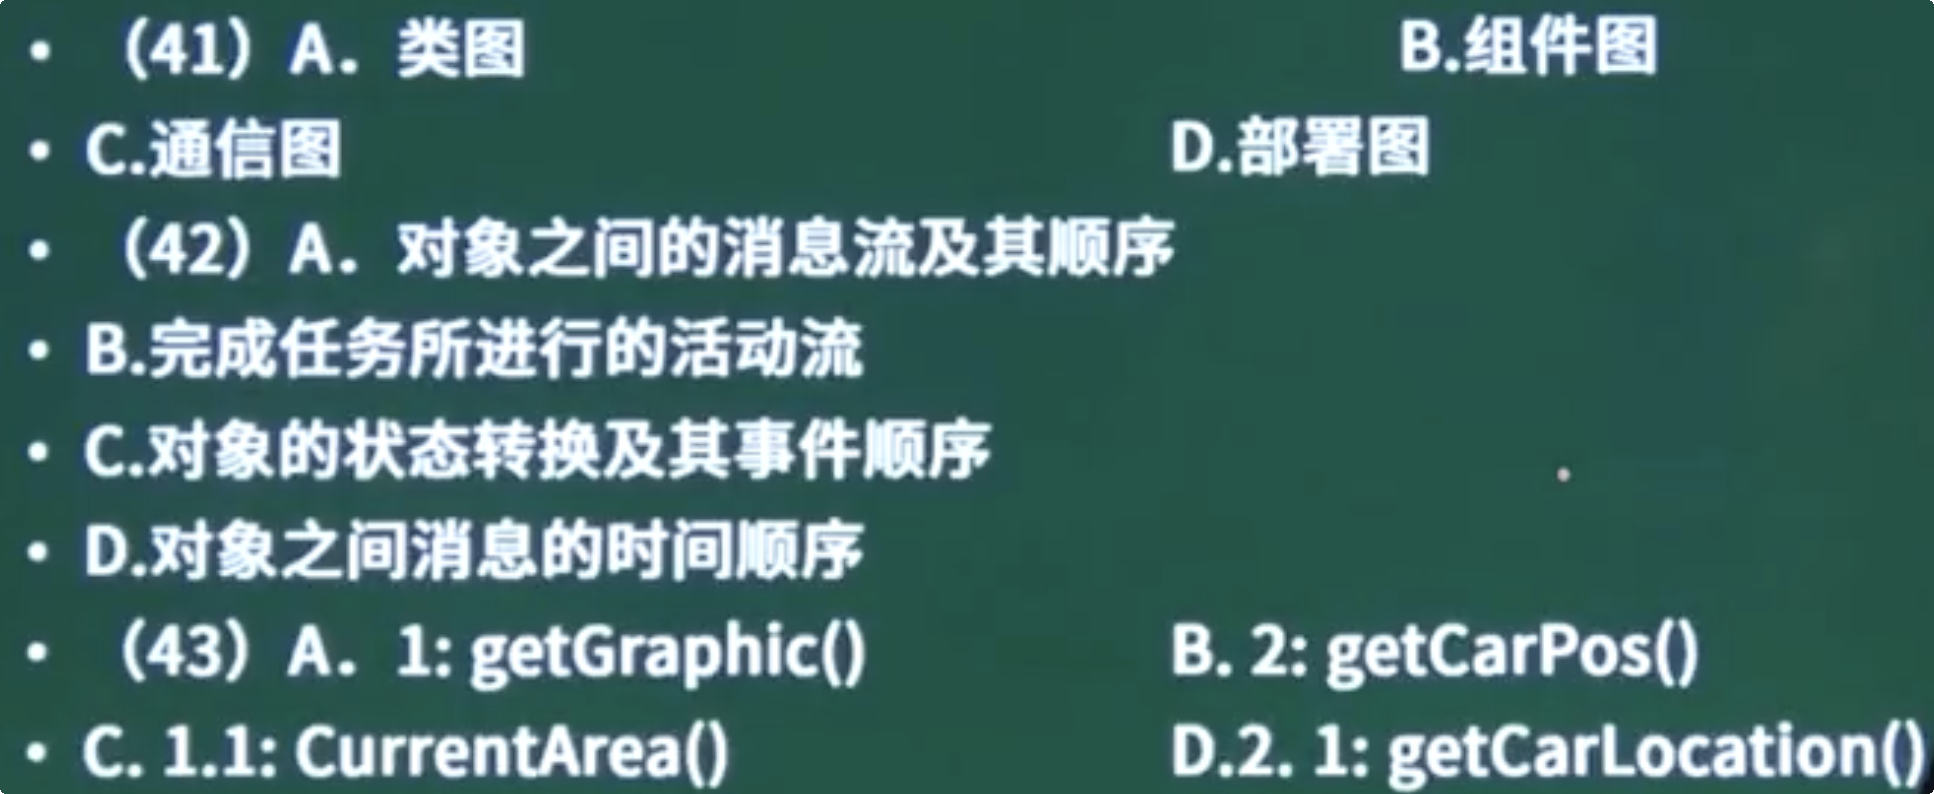
答:(41)C (42)A (43)D。
(42)B选项是活动图的描述,C选项是状态图的描述,D选项是顺序图的描述。
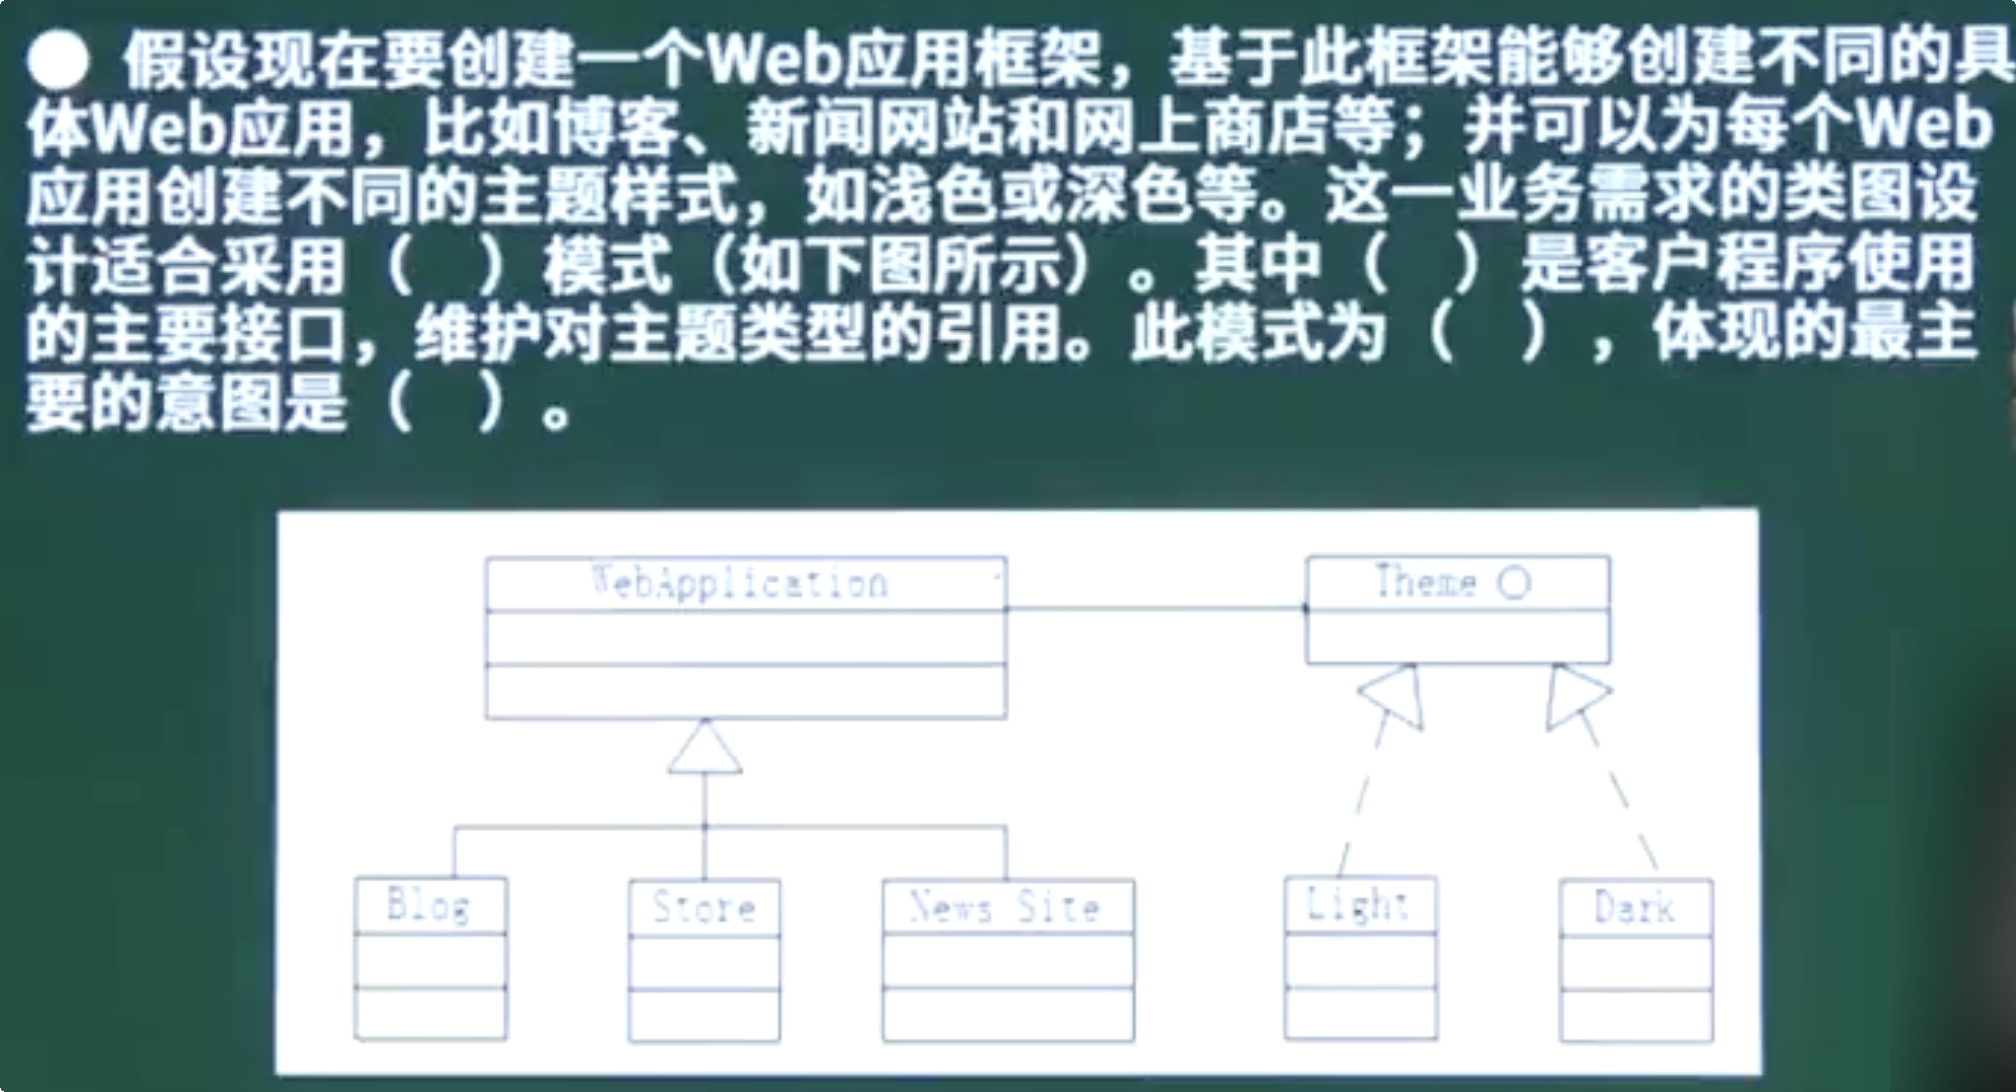
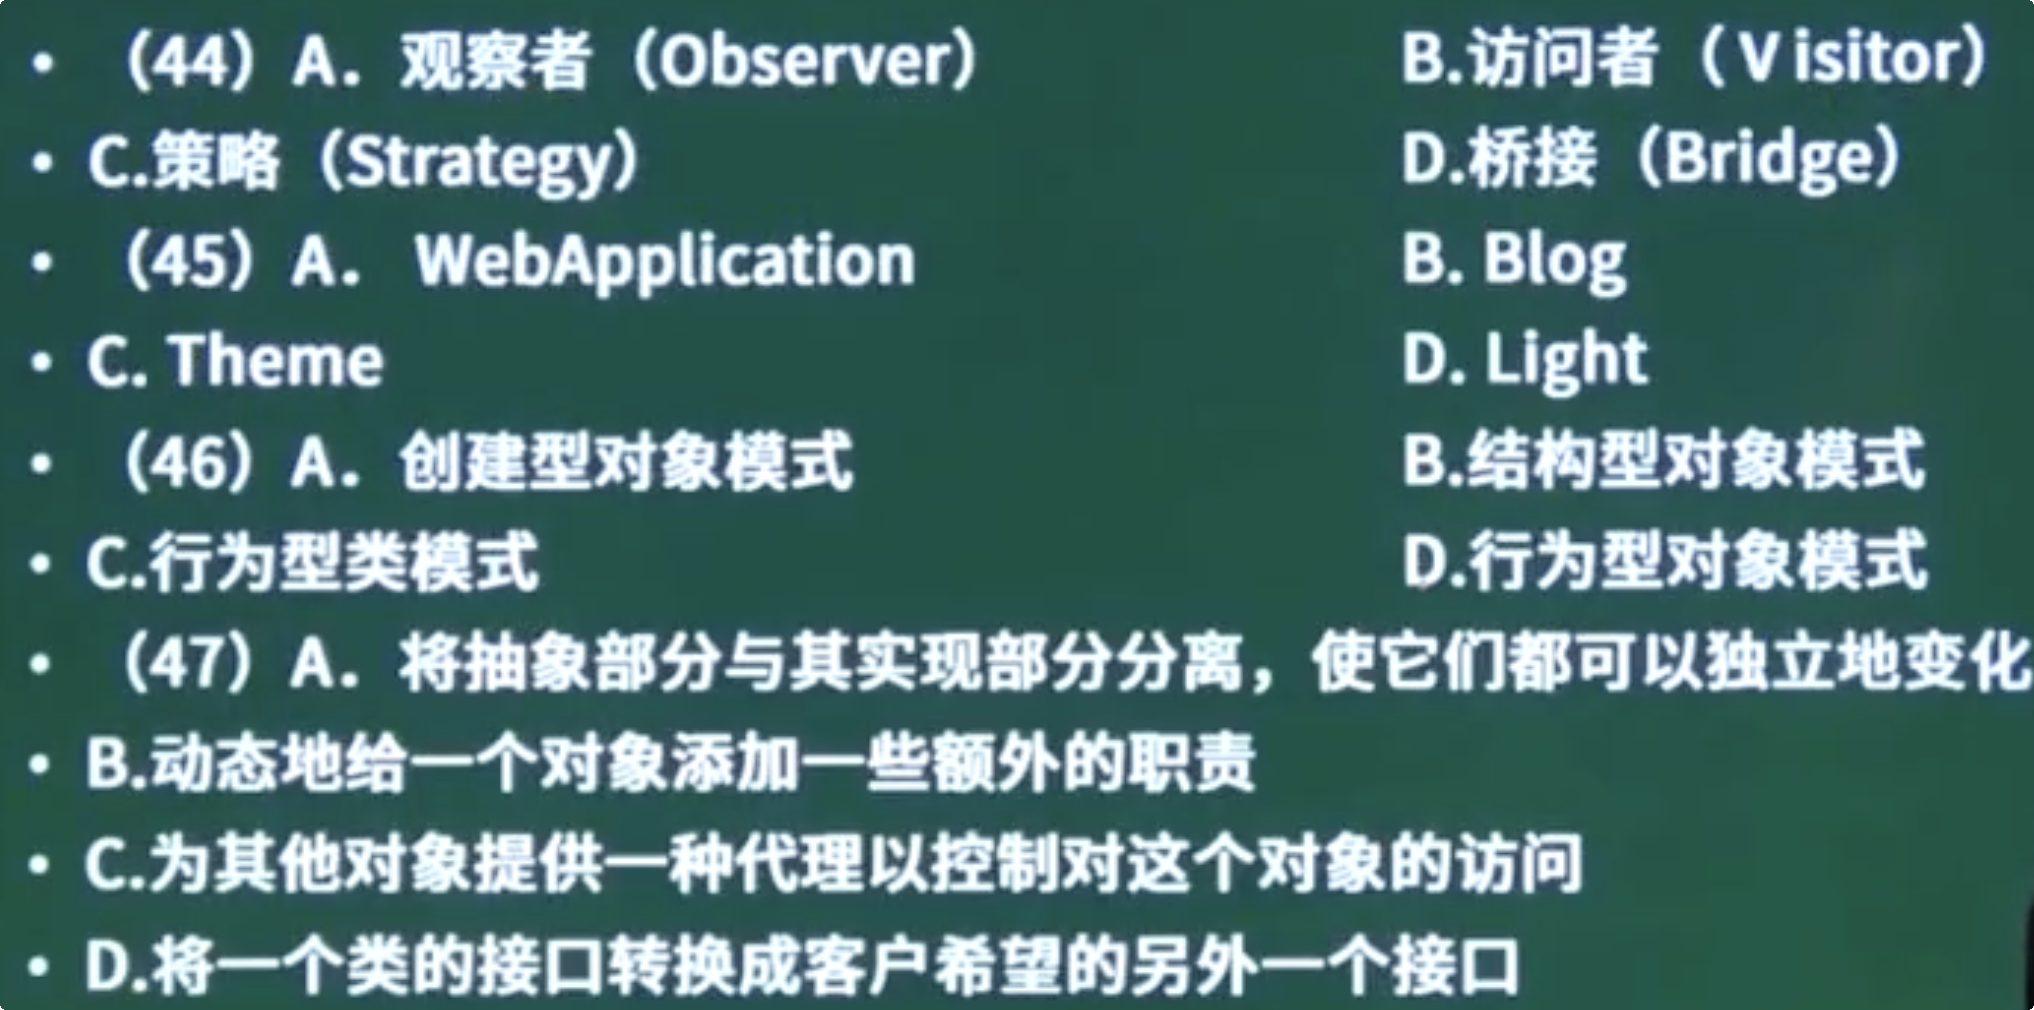
答:(44)D (45)A (46)B (47)A。
==桥接模式是一种对象结构型设计模式==,它旨在==将抽象部分与实现部分分离,使它们都可以独立地变化==。这种模式用组合关系代替继承关系来实现,从而降低了抽象和实现这两个可变维度的耦合度。
从实际应用角度来看,==例如在绘制不同颜色和形状的图形中,我们可以使用桥接模式来达到目的==。在这种情况下,可以将颜色和形状定义为两个不同的接口,而具体的圆形和矩形等则可以实现这些接口。这样,如果将来需要更改形状或颜色的表示方式,我们只需要调整对应的实现类,而无需修改使用这些类的代码。
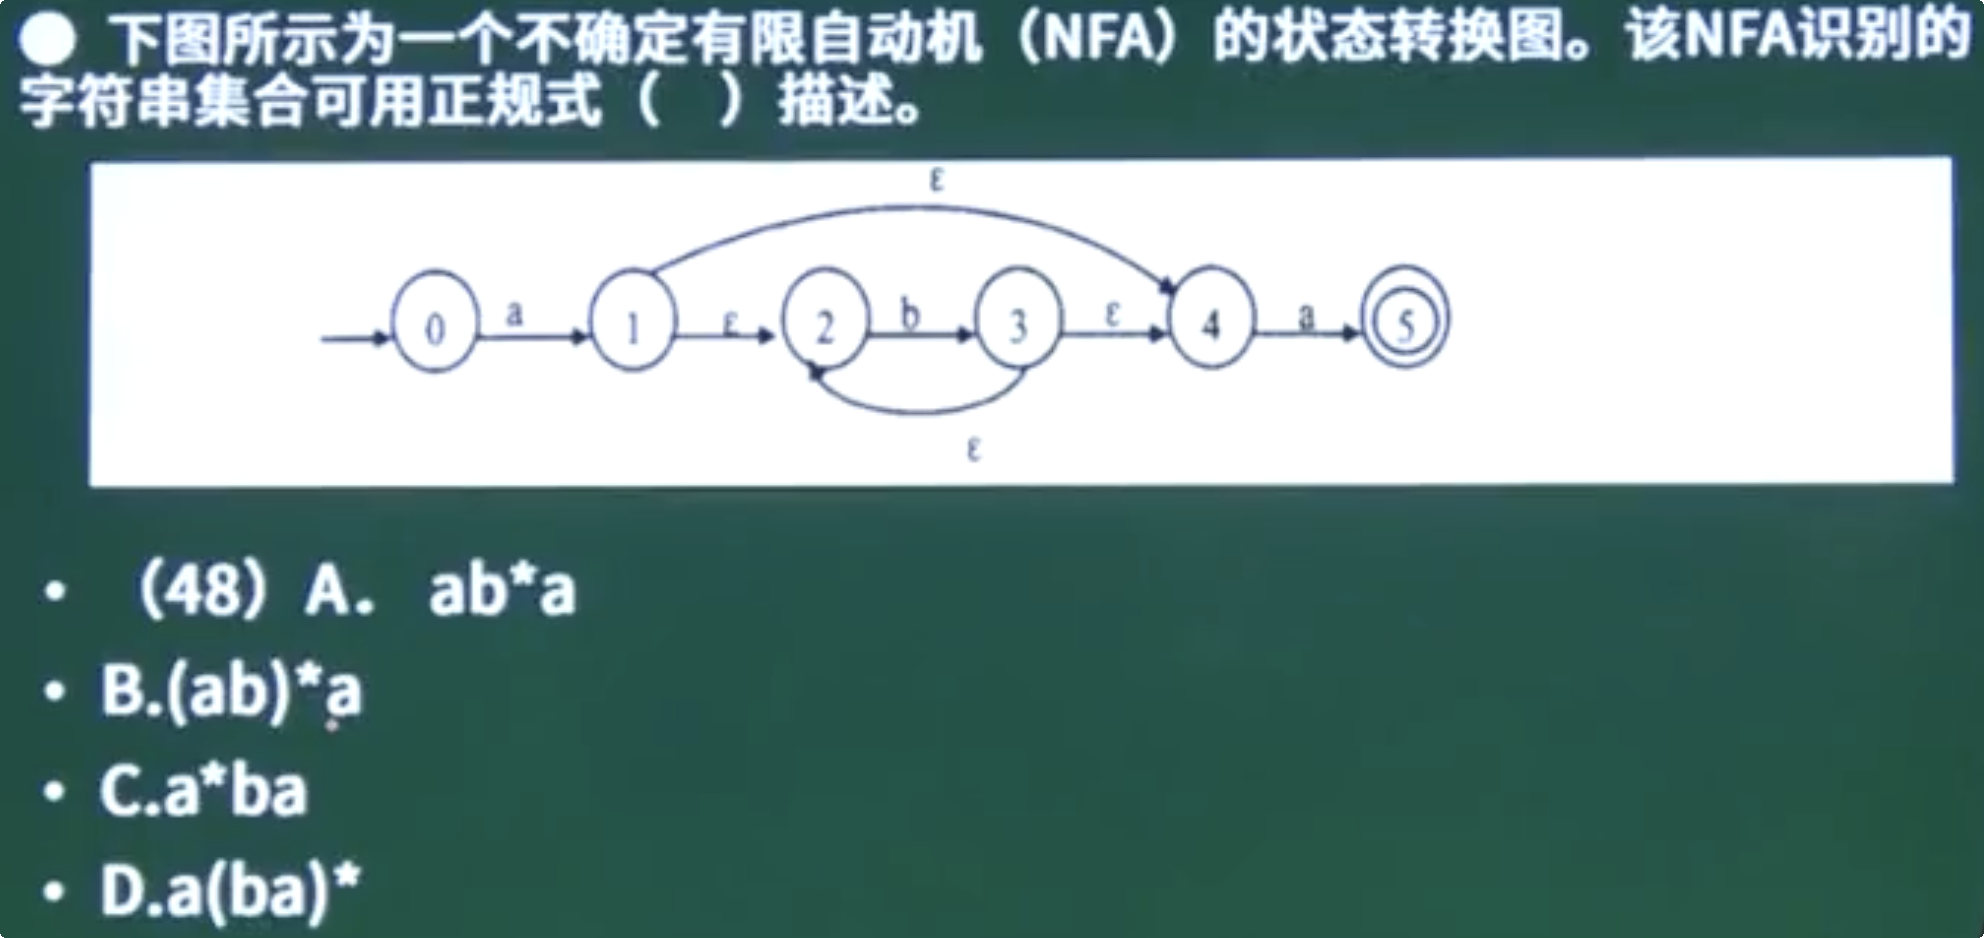
答:选A。
我们从图可知从a开始,a结束,而中间部分是不确定的字符表示。根据选项可得知只有A选项能保证有两个a,其他选项只能保证有一个a。
数据库
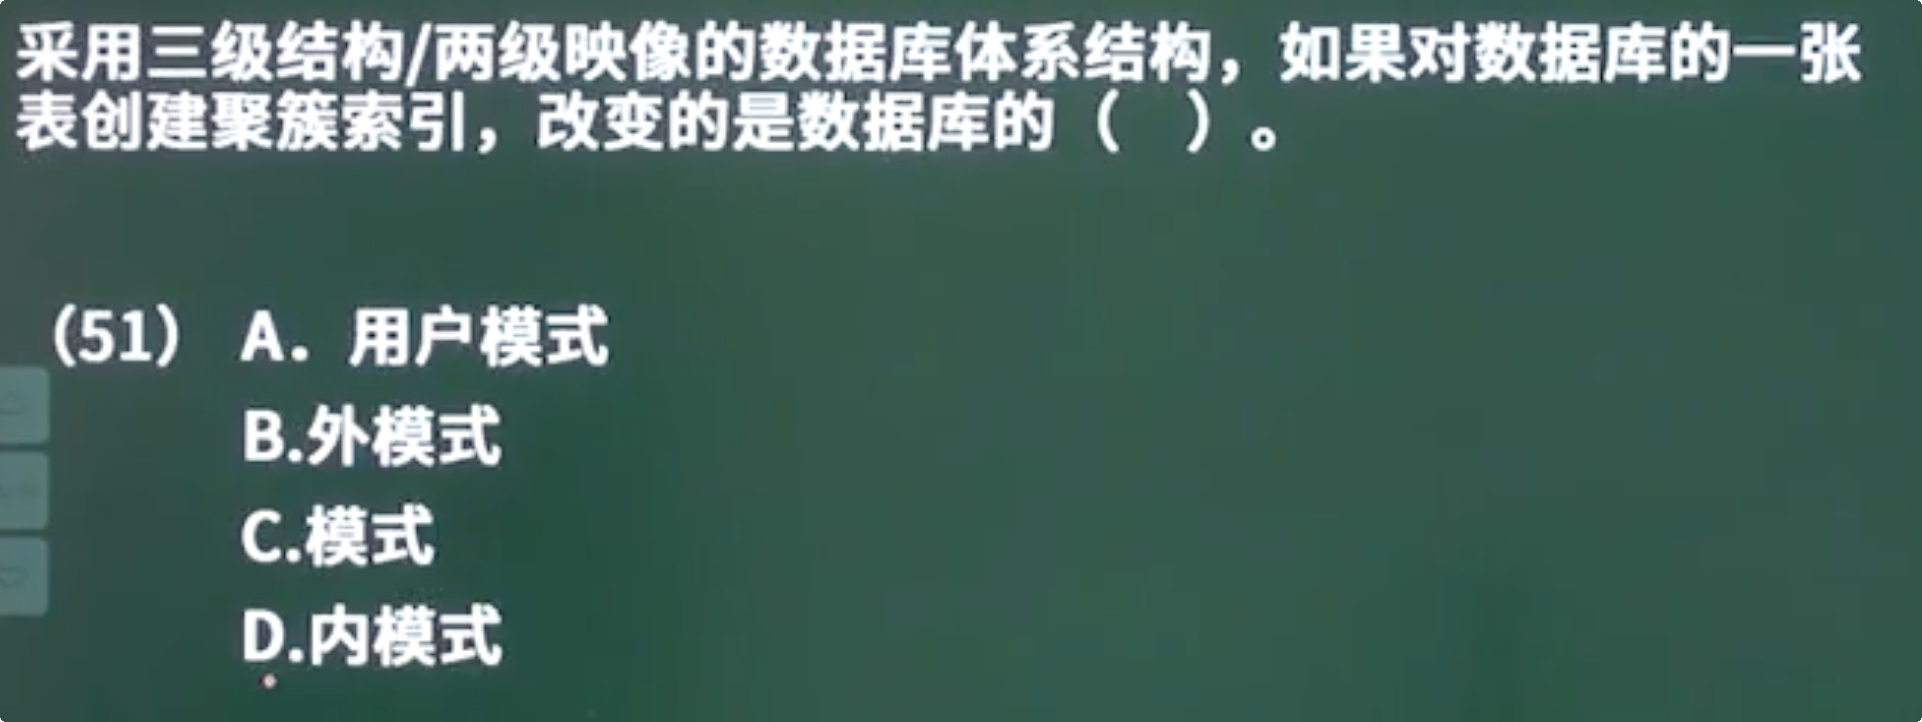
答:选D。
采用三级结构/两级映像的数据库体系结构,当对数据库的一张表创建聚簇索引时,==实际改变的是数据库的内部层次结构==,特别是数据存储的方式和访问路径。具体来说,==聚簇索引改变了数据在磁盘上的物理存储方式==,使得相邻的数据项倾向于存储在一起,从而提高了数据的访问速度。而这种对内部层次的修改不会影响到数据库的概念模式和外模式,即数据的整体逻辑结构和用户视图不会受到影响。
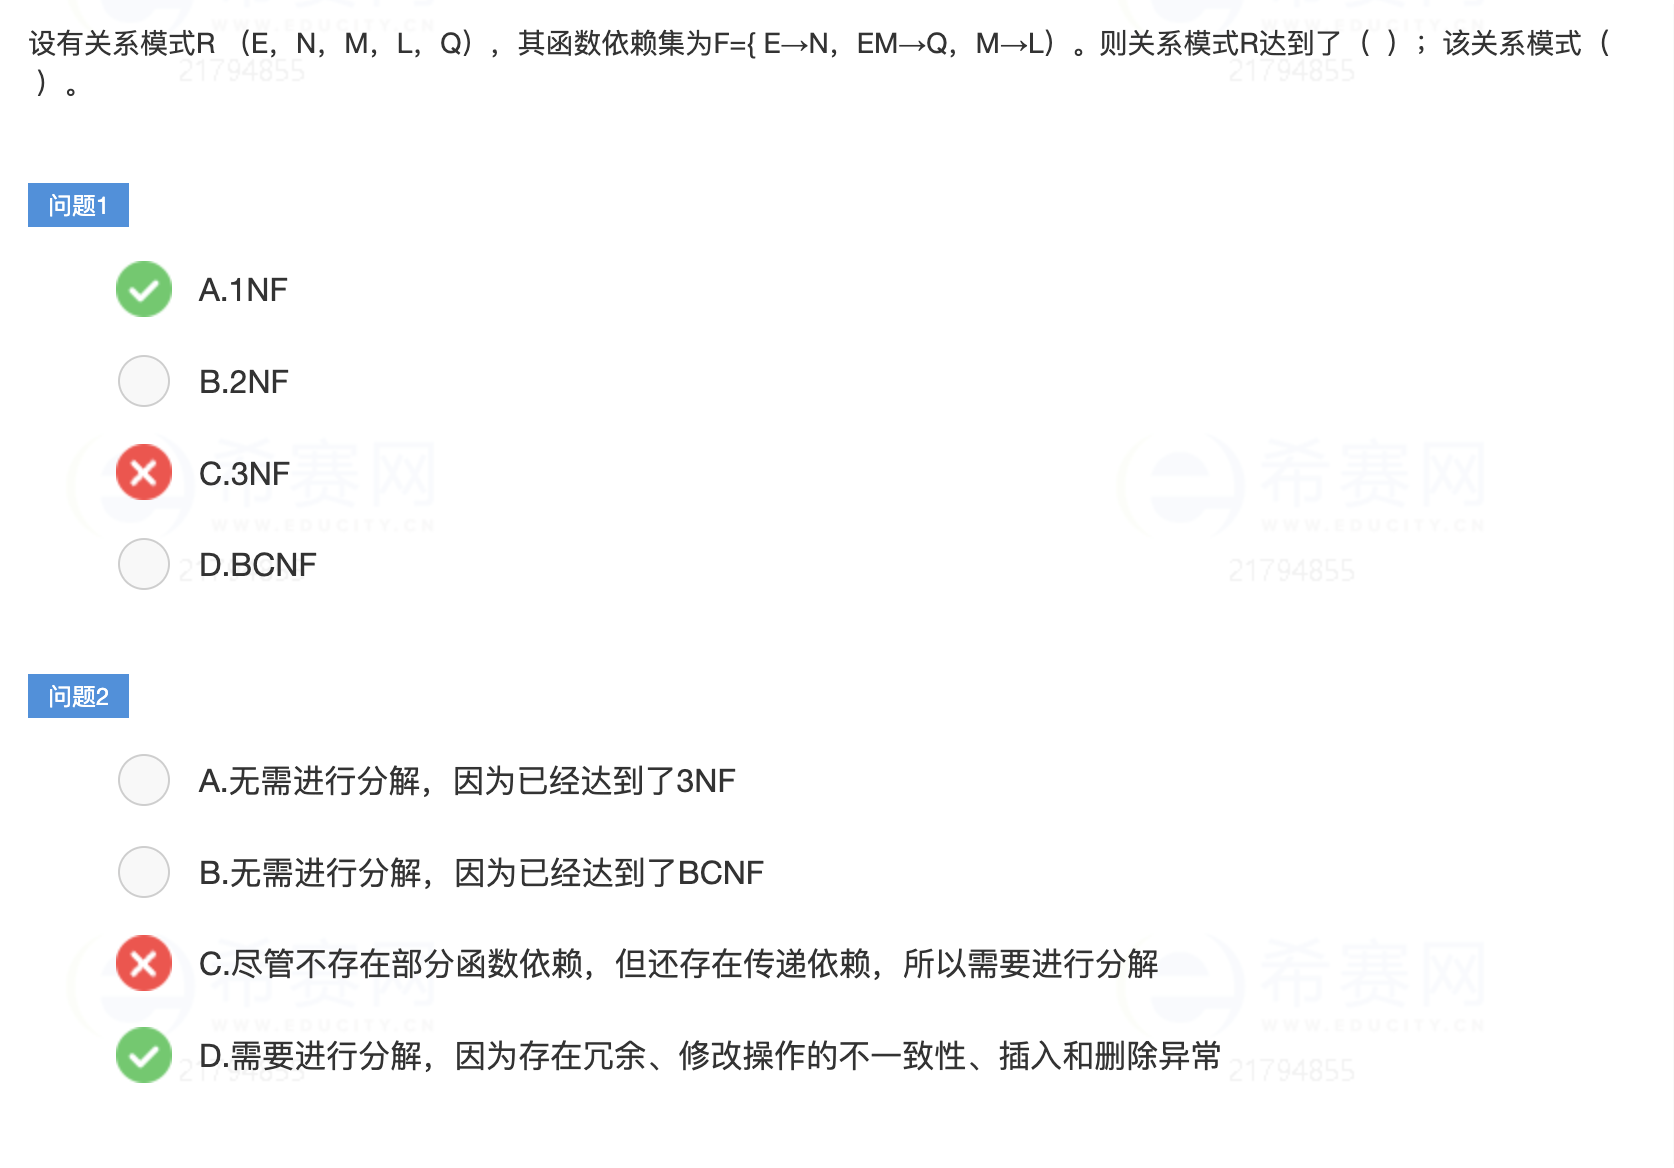
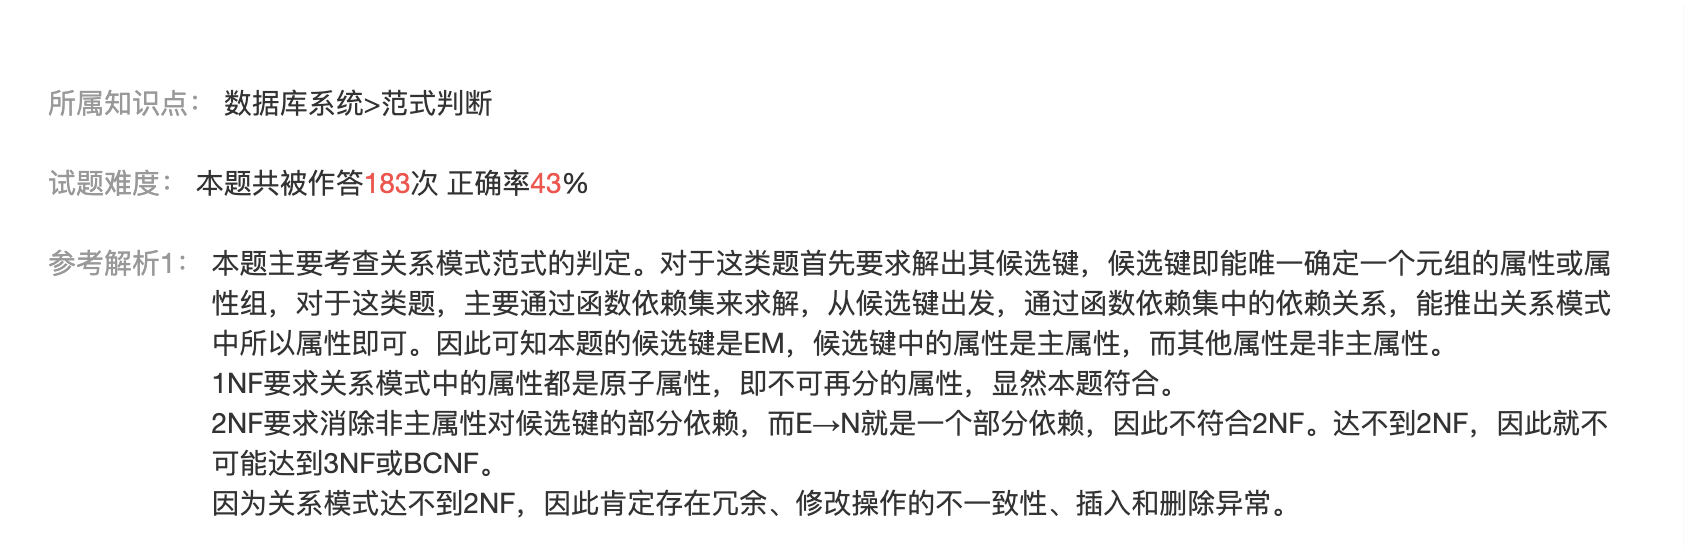
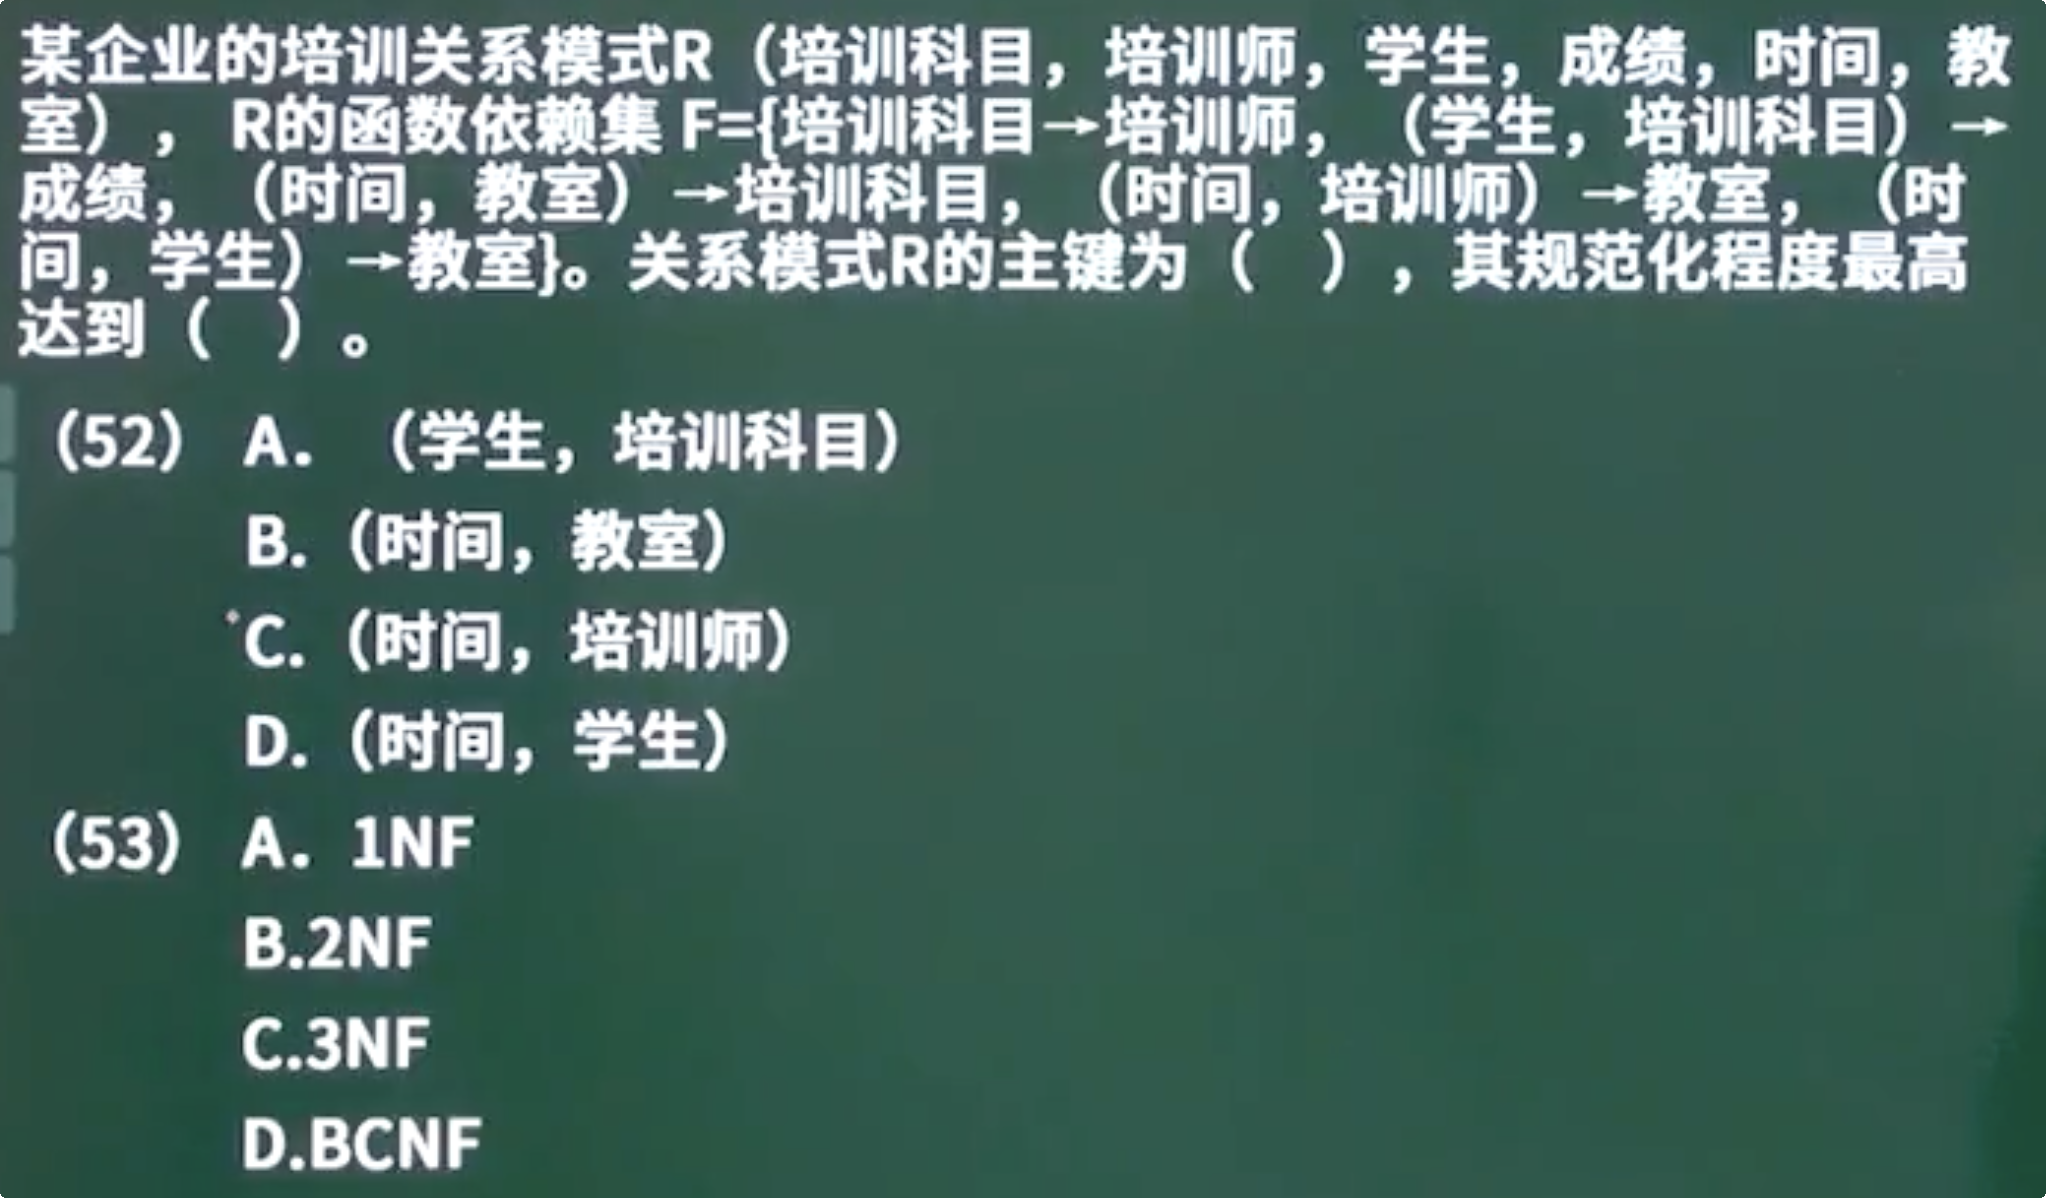
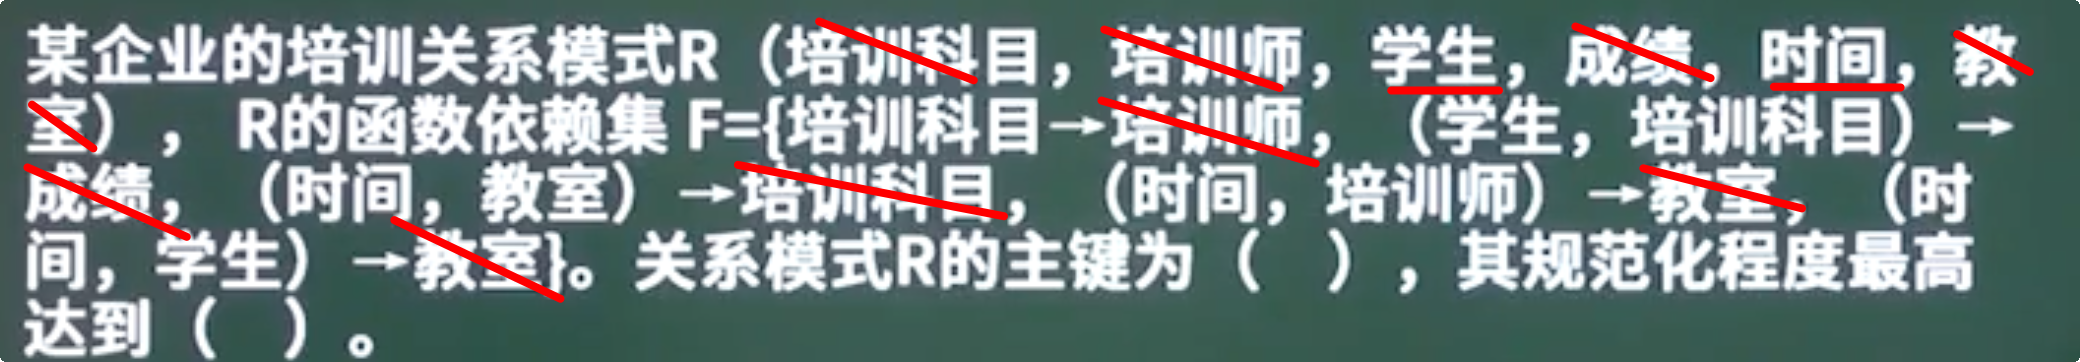
答:(52)D (53)
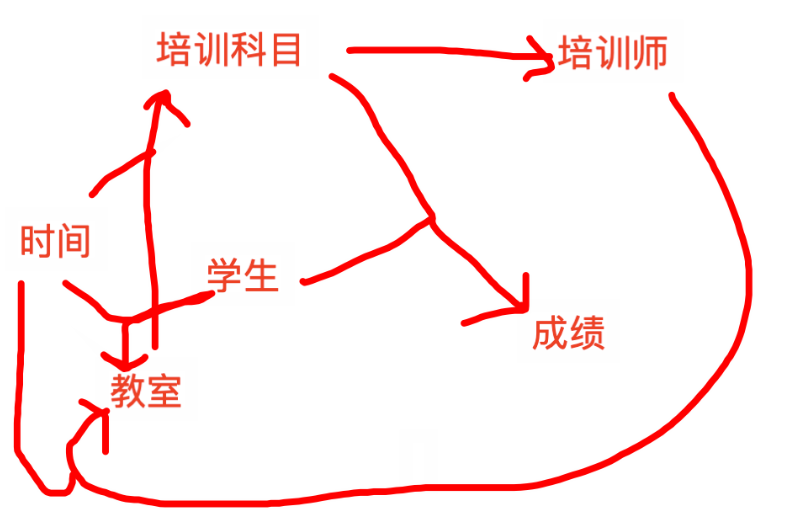
(52)主键为入度为0的属性,画图如下:
更为简单的方法,直接看那些属性没有出现在右侧,即入度为0
可得知学生和时间入度都为0。
(53)常见的范式有1NF、2NF、3NF、BCNF等
1、1NF(第一范式): 数据表中的列都是不可分割的原子数据项,每个属性不可再分。
2、2NF(第二范式): 在1NF的基础上,非主属性完全函数依赖于任何一个候选码。简单来说,就是在第一范式的基础上消除了非主属性对码的部分函数依赖。
3、3NF(第三范式): 在2NF的基础上,消除了非主属性传递依赖于任何一个候选码。这意味着除了直接依赖于码的属性外,其它属性之间不能存在传递依赖。
4、BCNF(Boyce-Codd Normal Form,博伊斯-科德范式): 是一种更高级的范式,要求所有的决定因素都必须是候选键。换句话说,它要求表中的所有字段都直接依赖于主键。
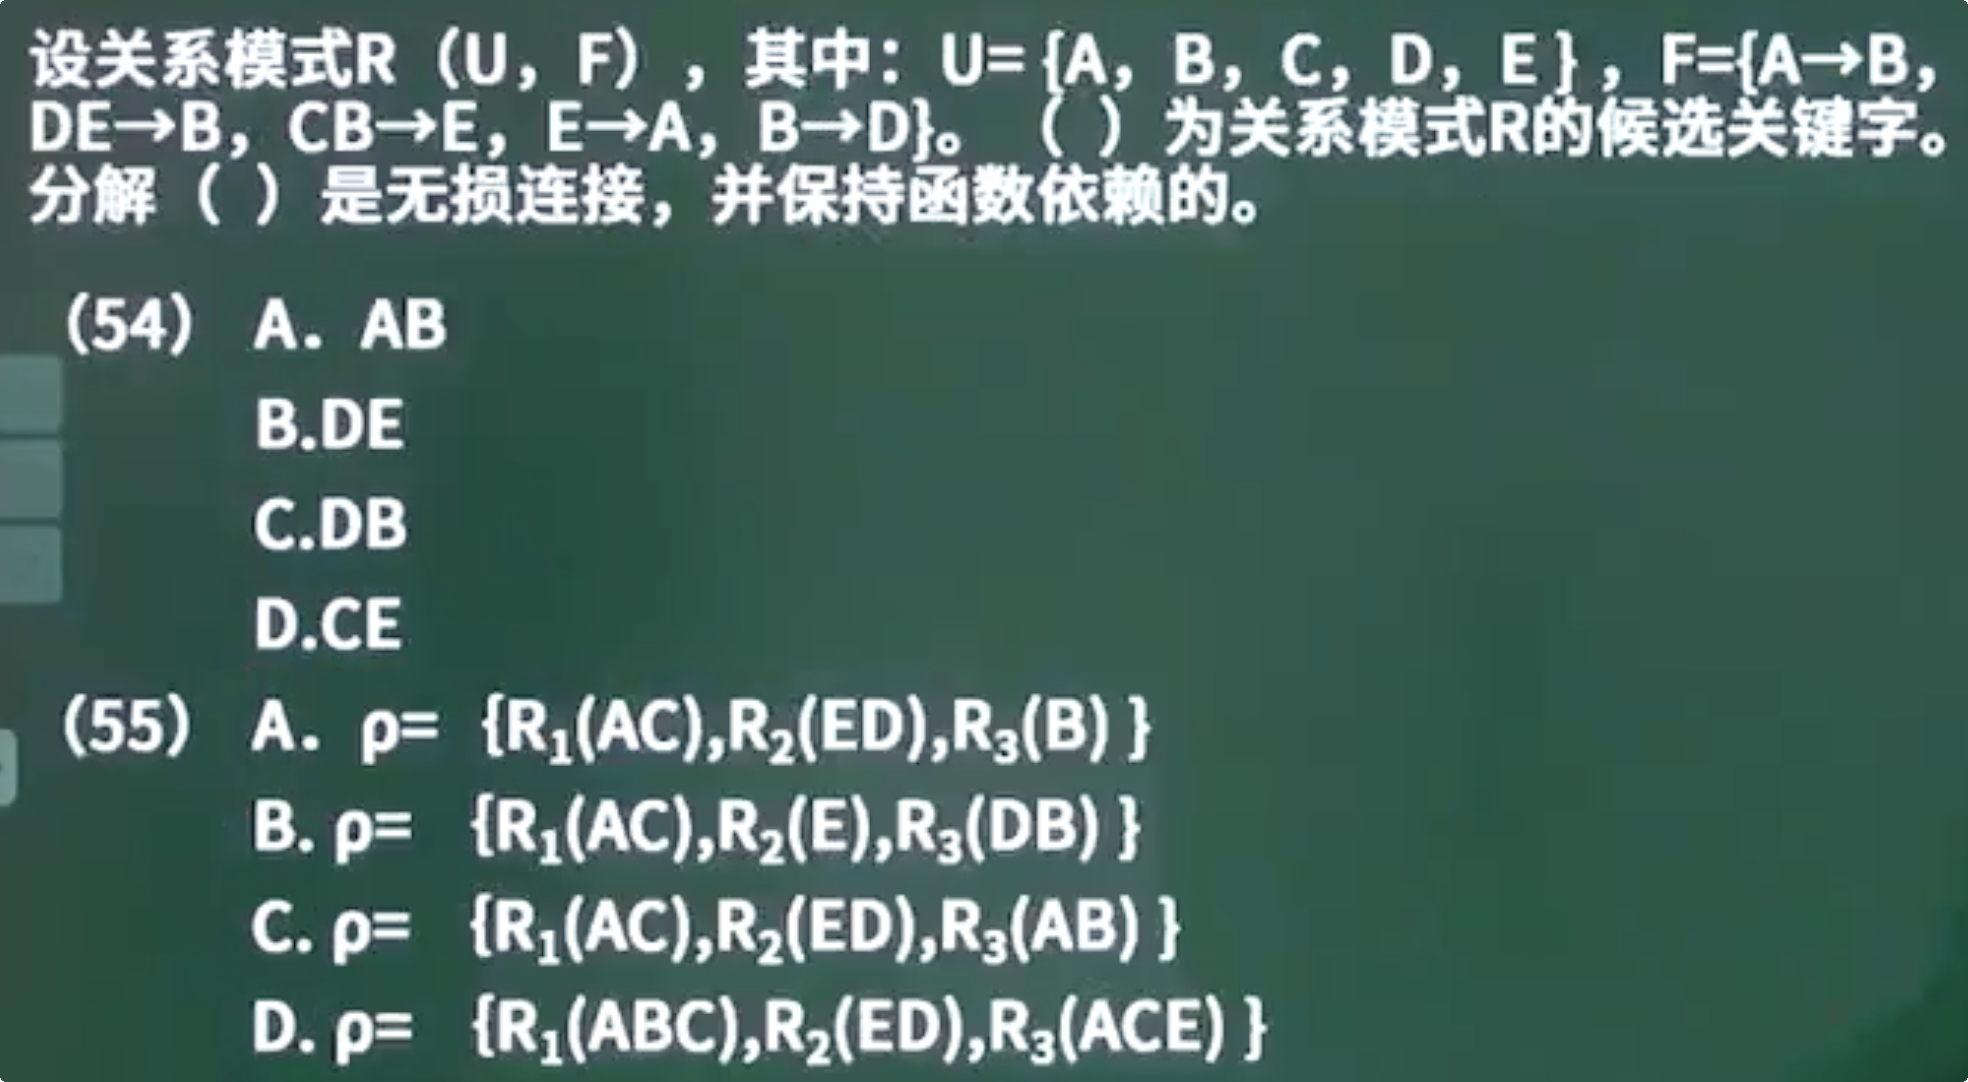
答:(54)D (55)D。
(54)首先找到未在右边出现过的属性,可以看到C属性符合,排除可得到D选项。我们已知C、E属性,E能得出A,A能得出B,B能得出D,候选关键字能遍历到所有属性,故D正确。
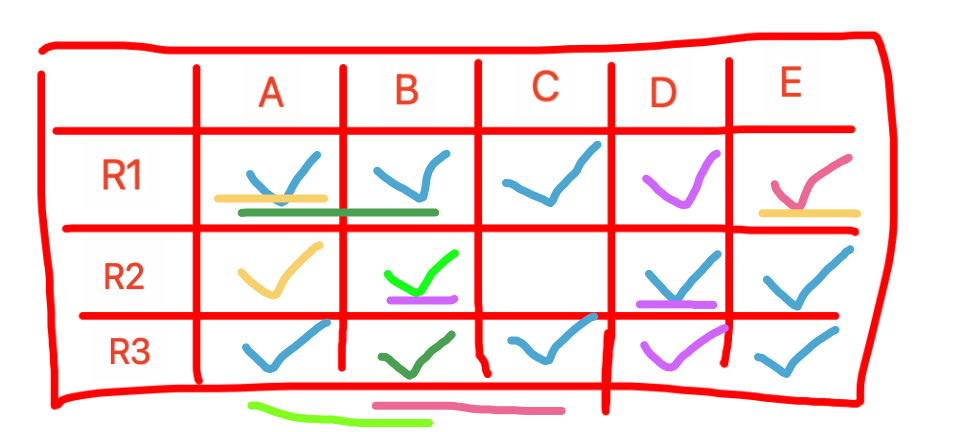
(55)画图如下,只有D选项,可以实现无损连接。
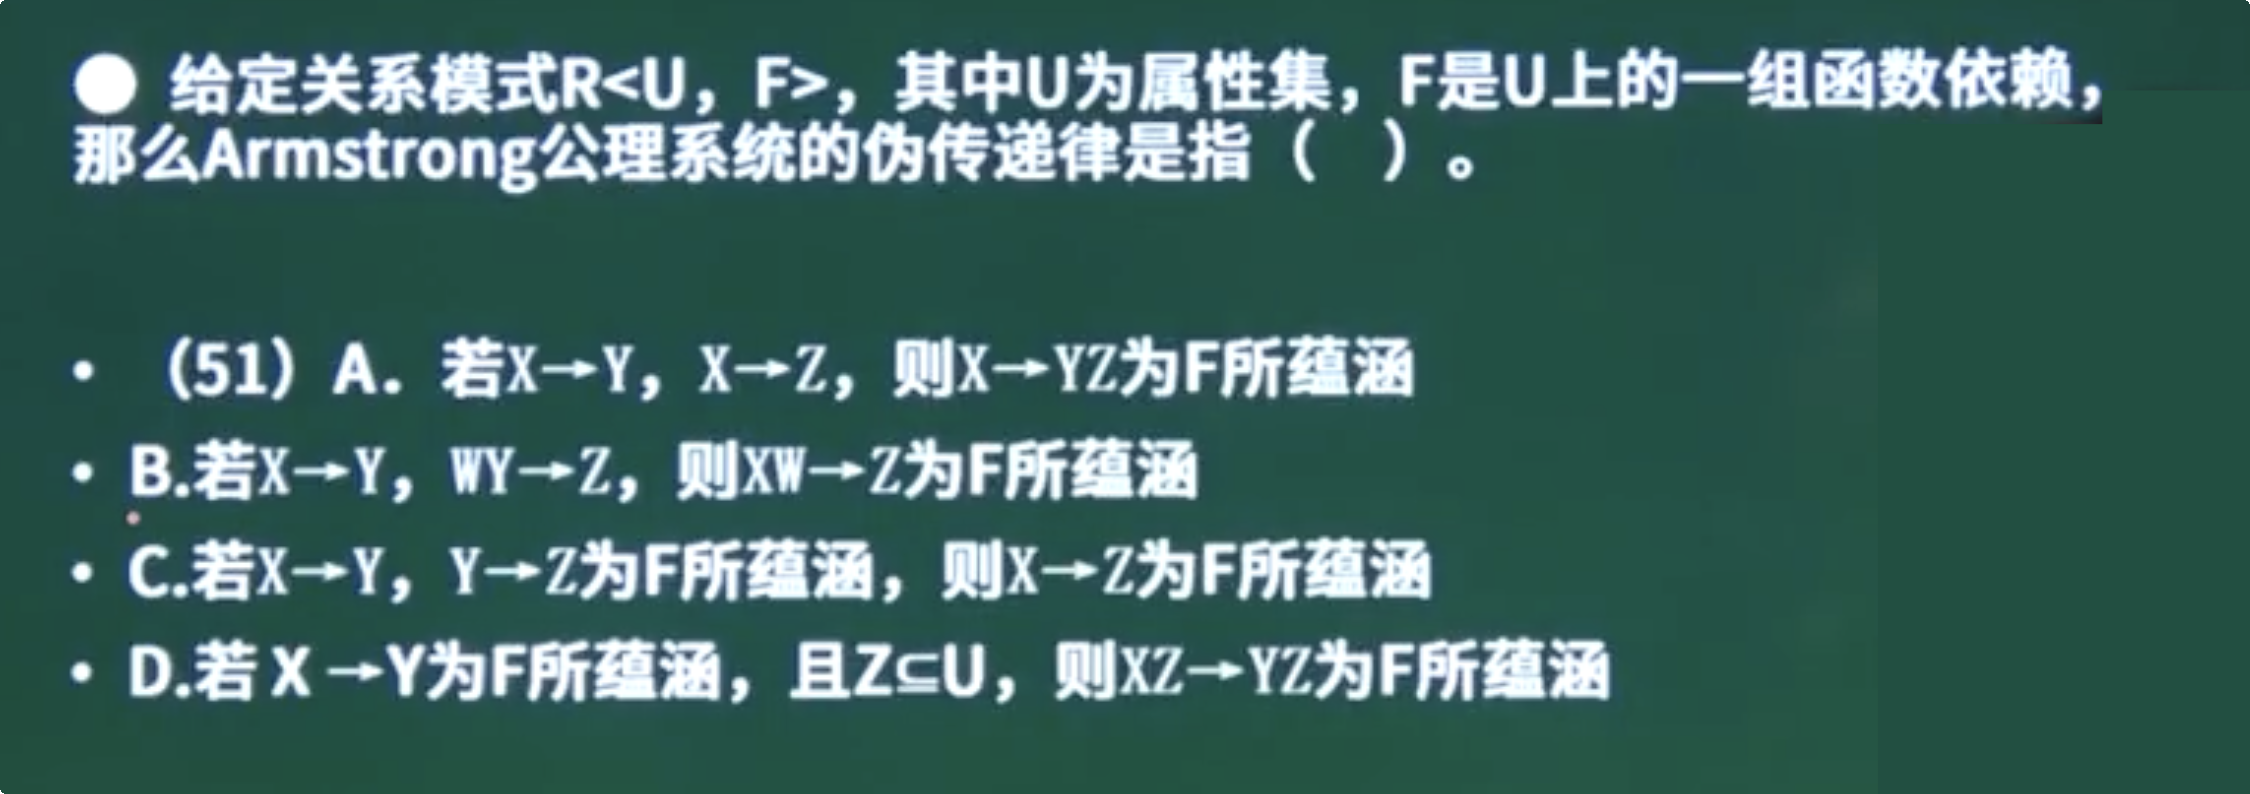
答:选B。
A选项合并规则;
B选项伪传递规则;
C选项公理规则;
D选项扩展规则。
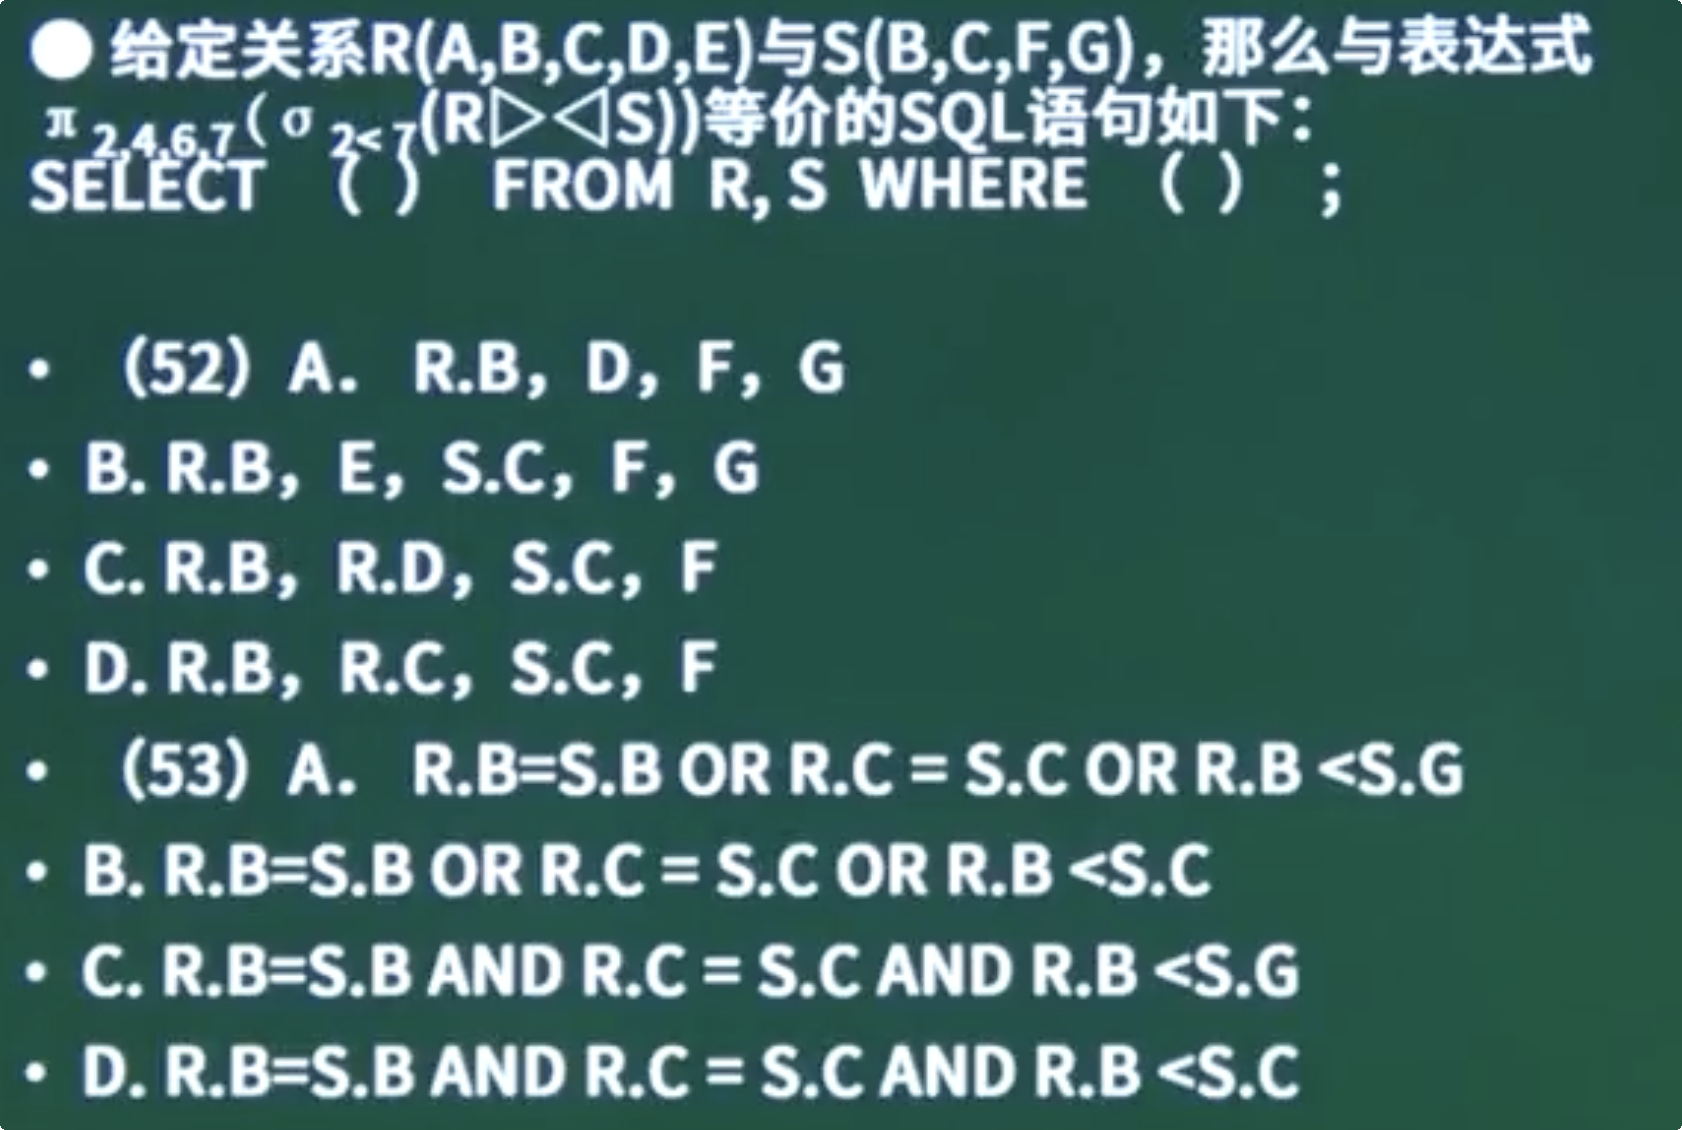
答:(52)A (53)C。
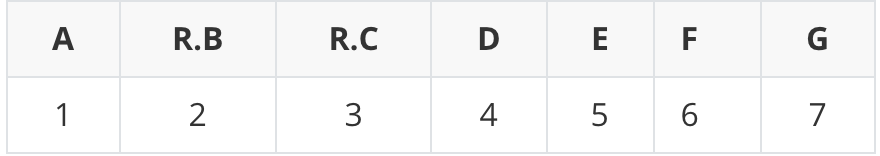
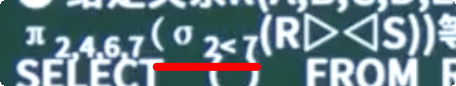
做了自然连接,故最终得到的结果是去掉重复列的结果,最终剩下的属性是A、R.B、R.C、D、E、F、G,投影所得到的属性列为2、4、6、7,我们对剩下的属性标序,如下:
即R.B、D、F、G是所查询的属性,选A。
又由表达式可知条件语句应该为R.B=S.B AND R.C=S.C AND R.B<S.G,故选C。
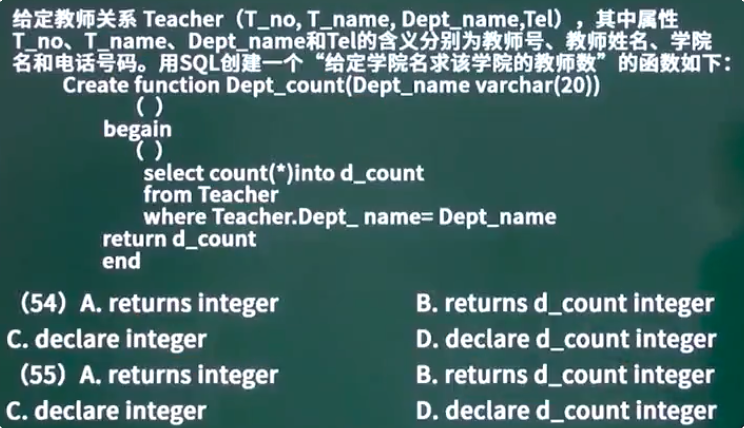
答:(54)A (55)D。
(54)整个函数返回的是教师数量,是整数值,此空需对函数返回值定义,选A。
(55)由于select查询的字段d_count没有被声明,故先声明一个字段d_count为整型,选D。
数据结构
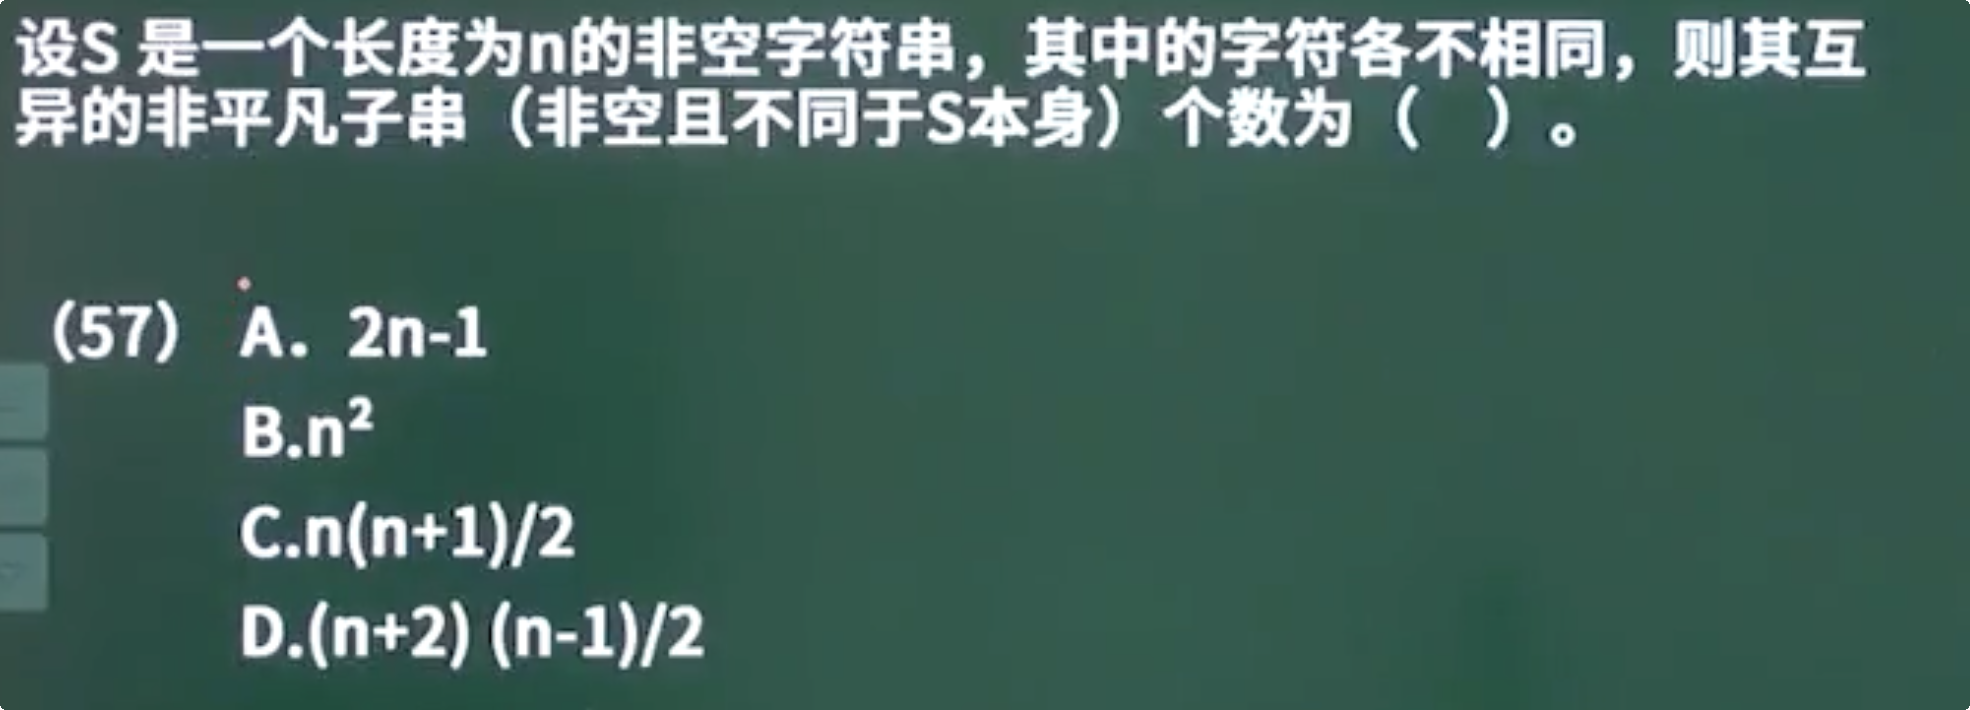
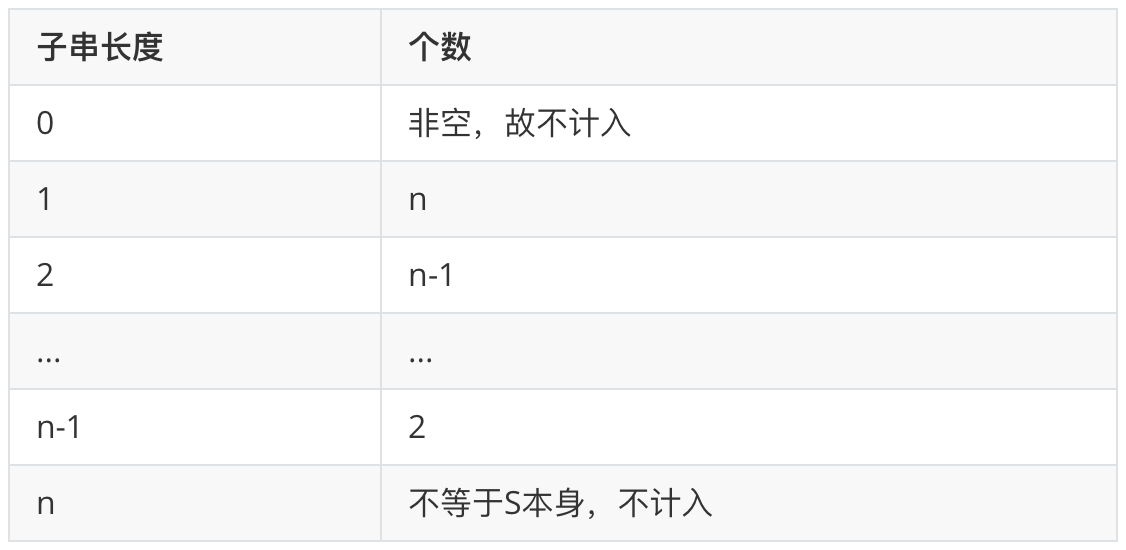
答:选D。
故互异的非平方子串个数为:。
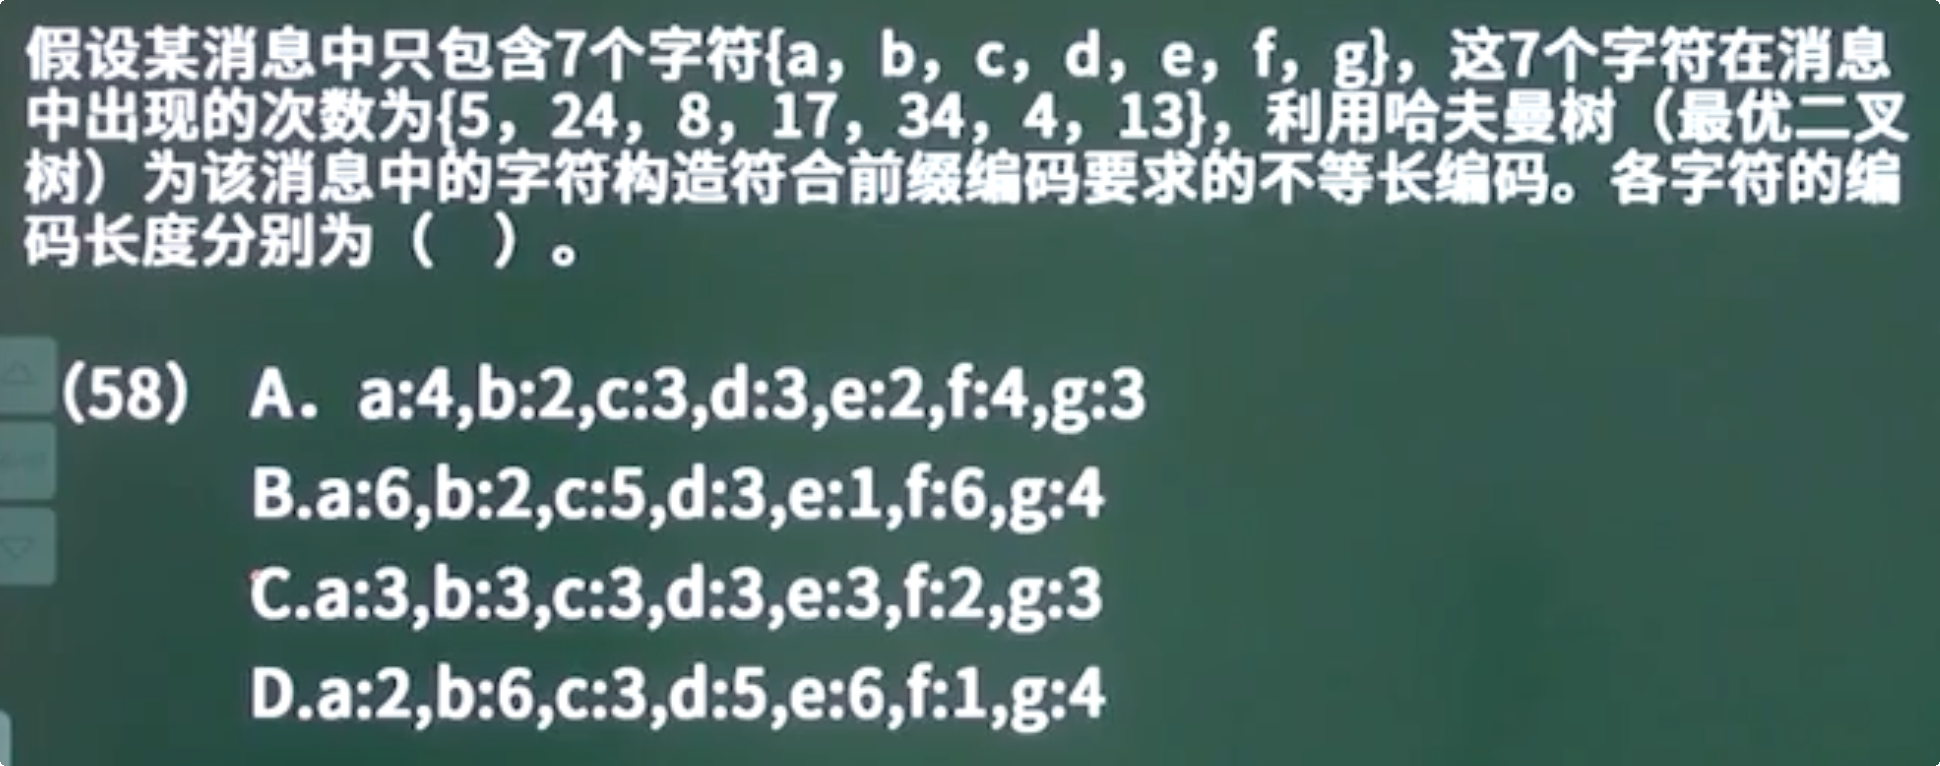
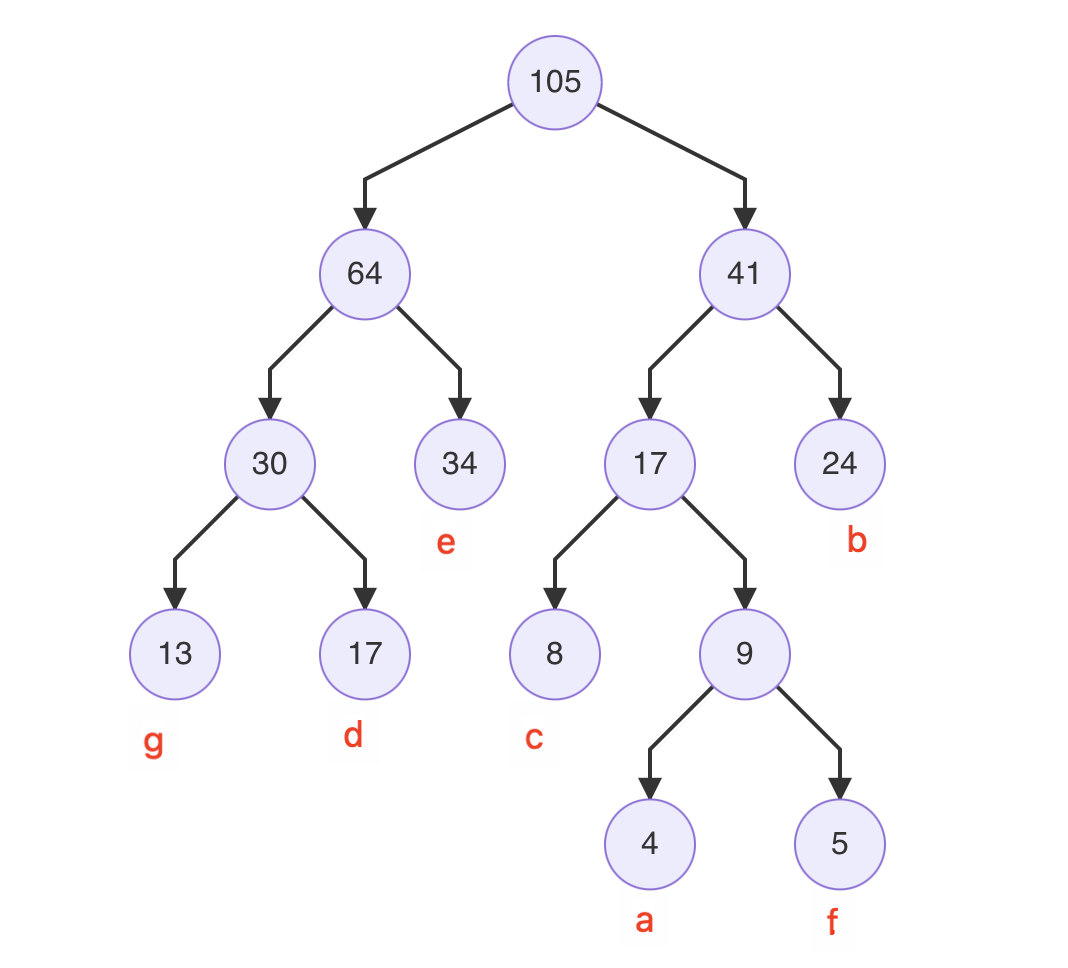
答:选A。
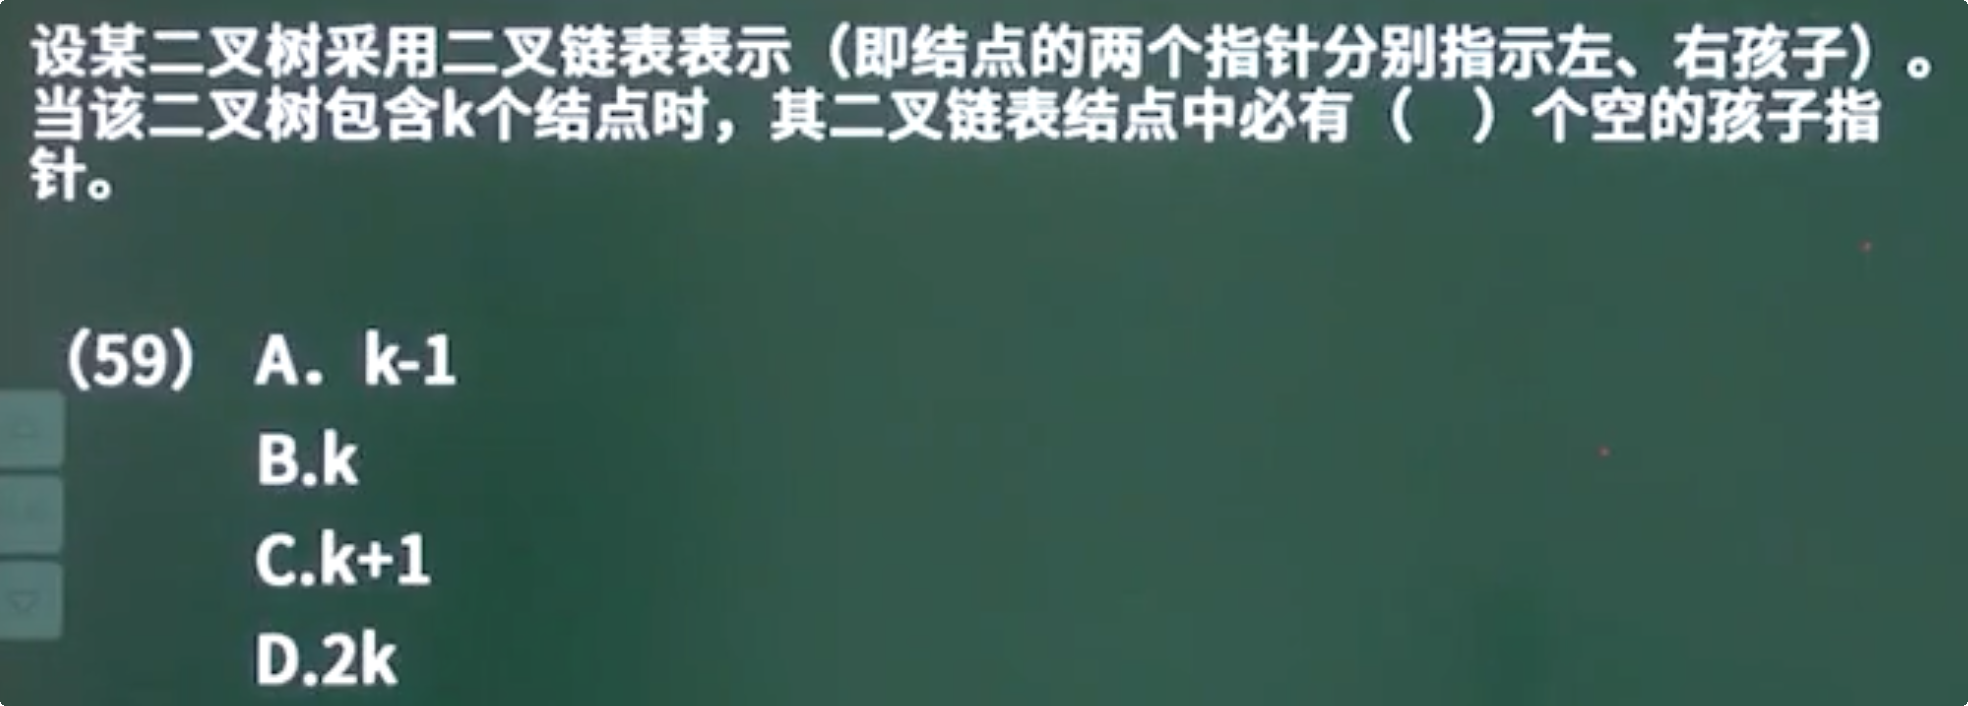
答:选C。
当二叉树包含k个结点时,总的指针数为2k(左右指针),非空指针的结点个数为k-1(除了根节点没有父结点外,其他结点都有父节点),则空指针结点的个数为:
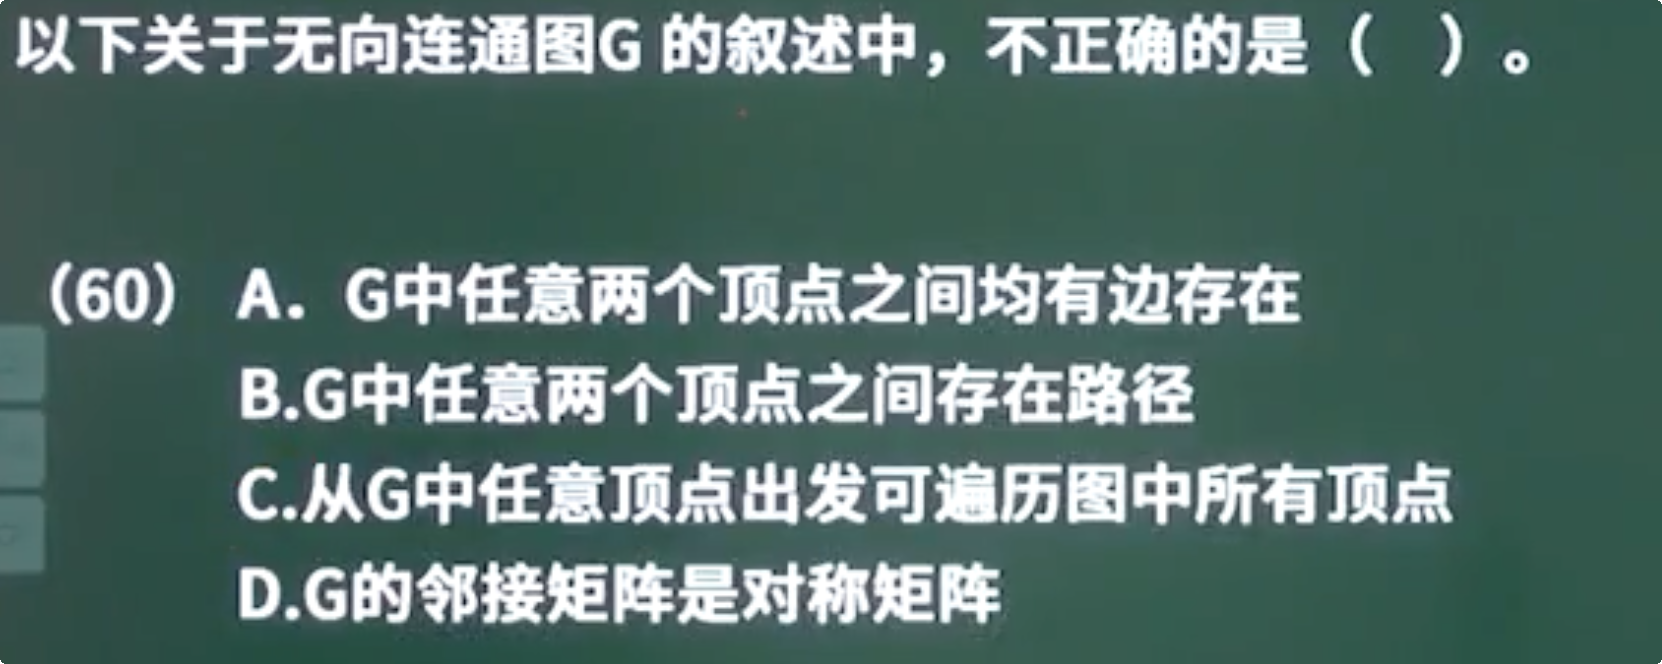
答:选A。
A、选项是无向完全图(边);
B、选项是属于无向连通图的描述(路径);
C、无向连通图可以任意顶点出发遍历到所有顶点;
D、对于无向图而言,其邻接矩阵是对称矩阵。
补充:
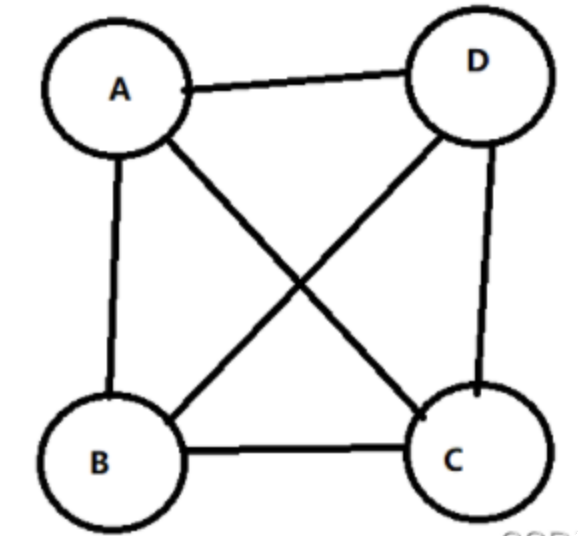
无向完全图:有n(n-1)/2 条边,如下:4个顶点有6条边
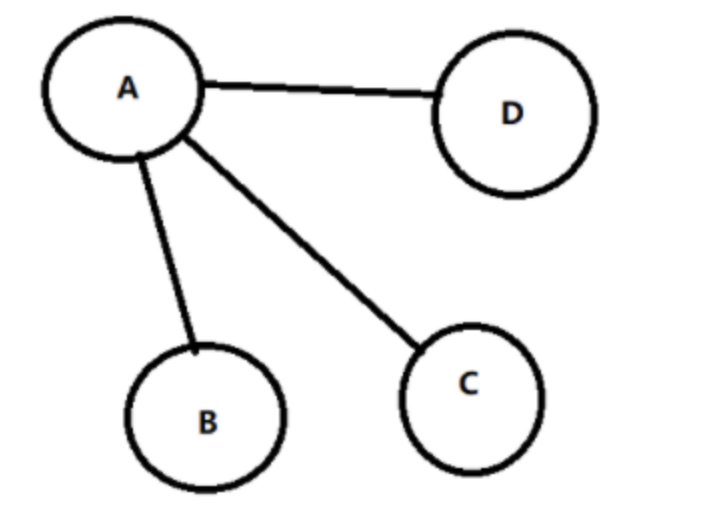
无向连通图:是指一个无向图中,任意两个顶点都是连通的。换句话说,从任意一个顶点出发,都可以通过边到达图中的其他所有顶点(一个顶点不必与另一个顶点直接相连,可以通过其它顶点到达即可)最少有n-1条边;如下:4个顶点最少需要3条边才能够连通。
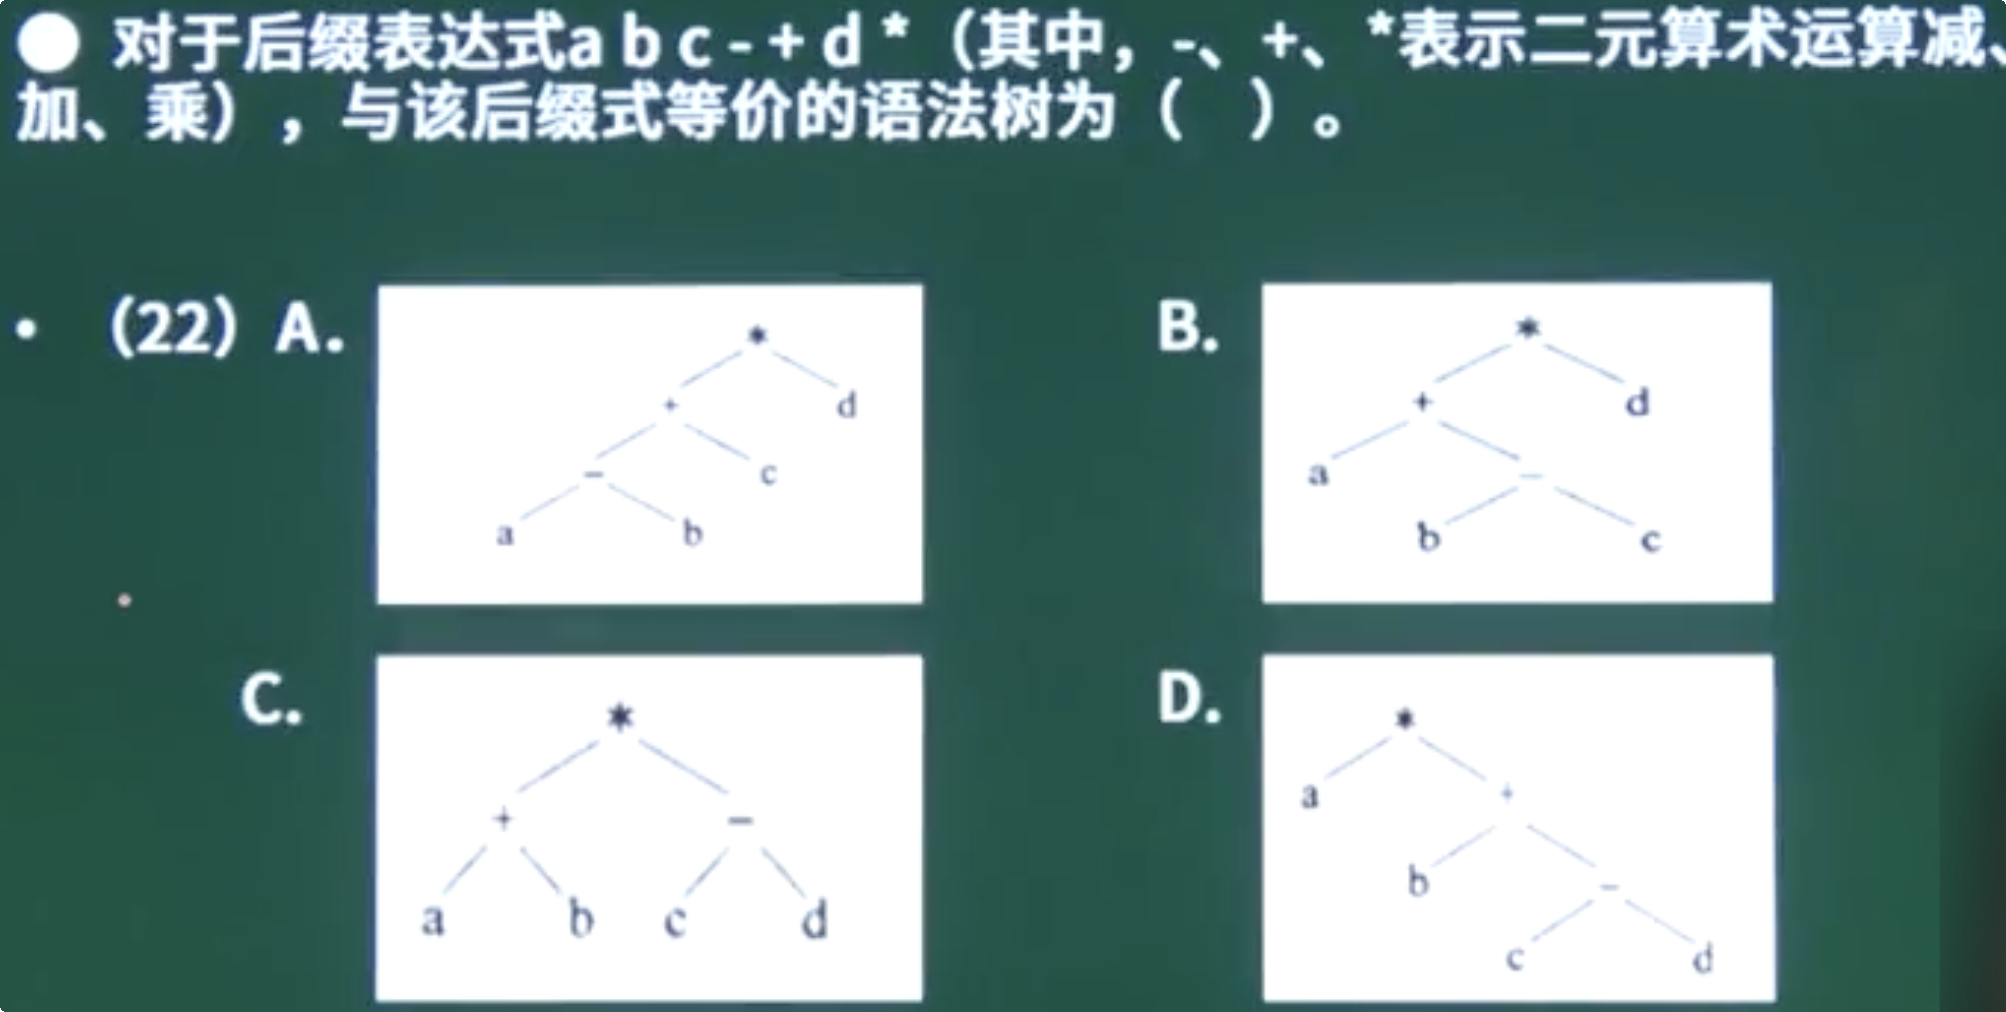
答:选B。
后缀表达式表示其后续遍历的顺序,依据图中各选项的后续遍历结果,
A:ab-c+d* B:abc-+d* C:ab+c-d* D:abcd-+*
可得知B选项符合。
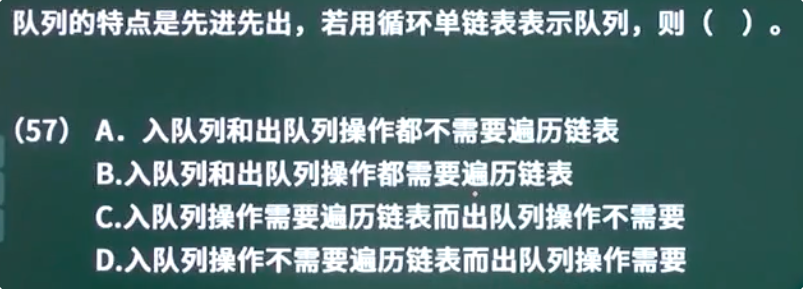
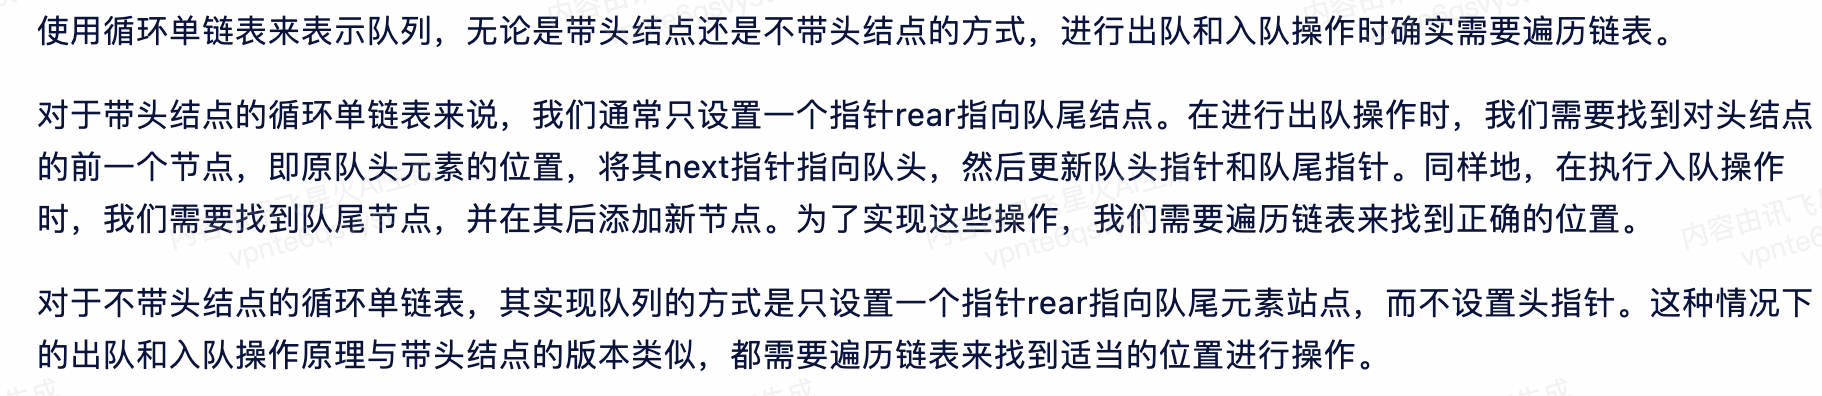
答:选B。
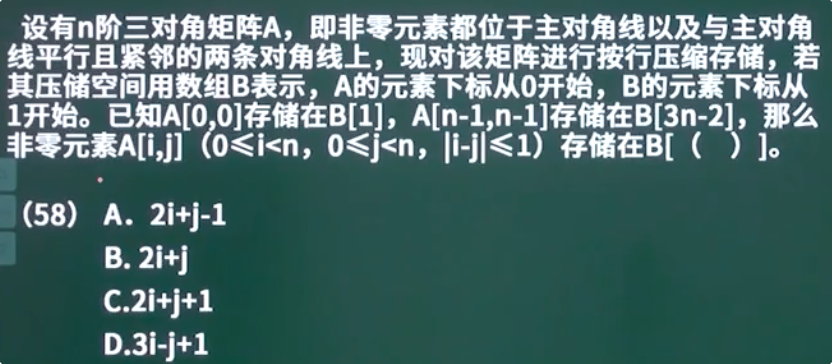
答:选C。
将i=0、j=0代入A选项,等于-1,排除;代入选项B,等于0,排除。将其代入C、D选项,得到1。将i=n-1、j=n-1代入C、D选项,分别得到3n-2和2n-1,故存储在B[2i+j+1],选C。
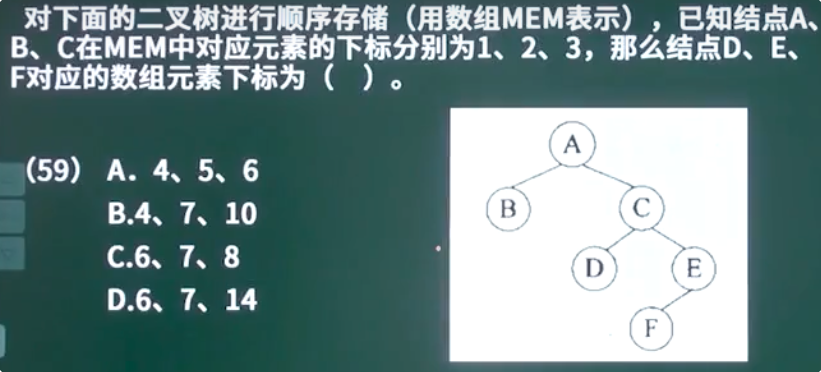
答:选D。
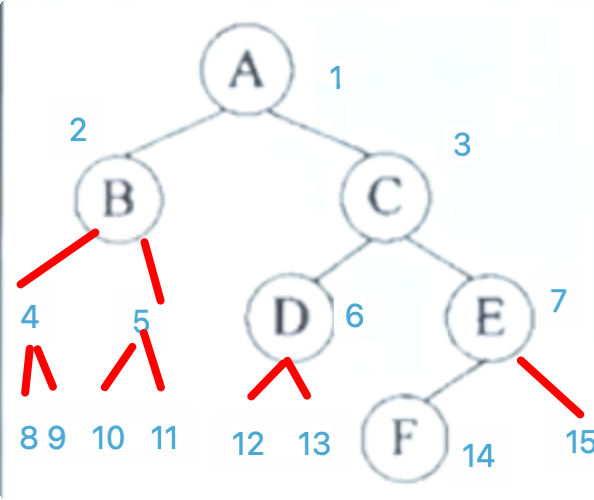
我们将其还原成一颗满二叉树,没有结点的位置设置为NULL,这样才可以通过顺序存储还原二叉树,故结点D、E、F对应的数组元素下标为6、7、14。
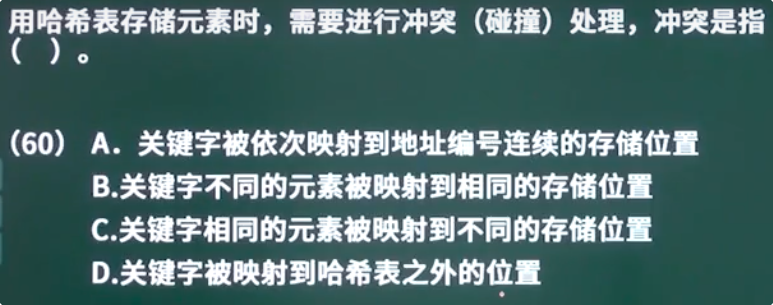
答:选B。
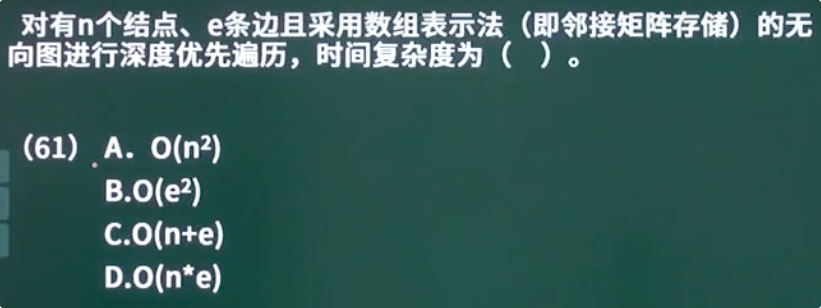
答:选A。
邻接矩阵存储的无向图,进行深度优先遍历,时间复杂度为,如果是用邻接表存储的无向图,进行深度优先遍历,时间复杂度为。
算法
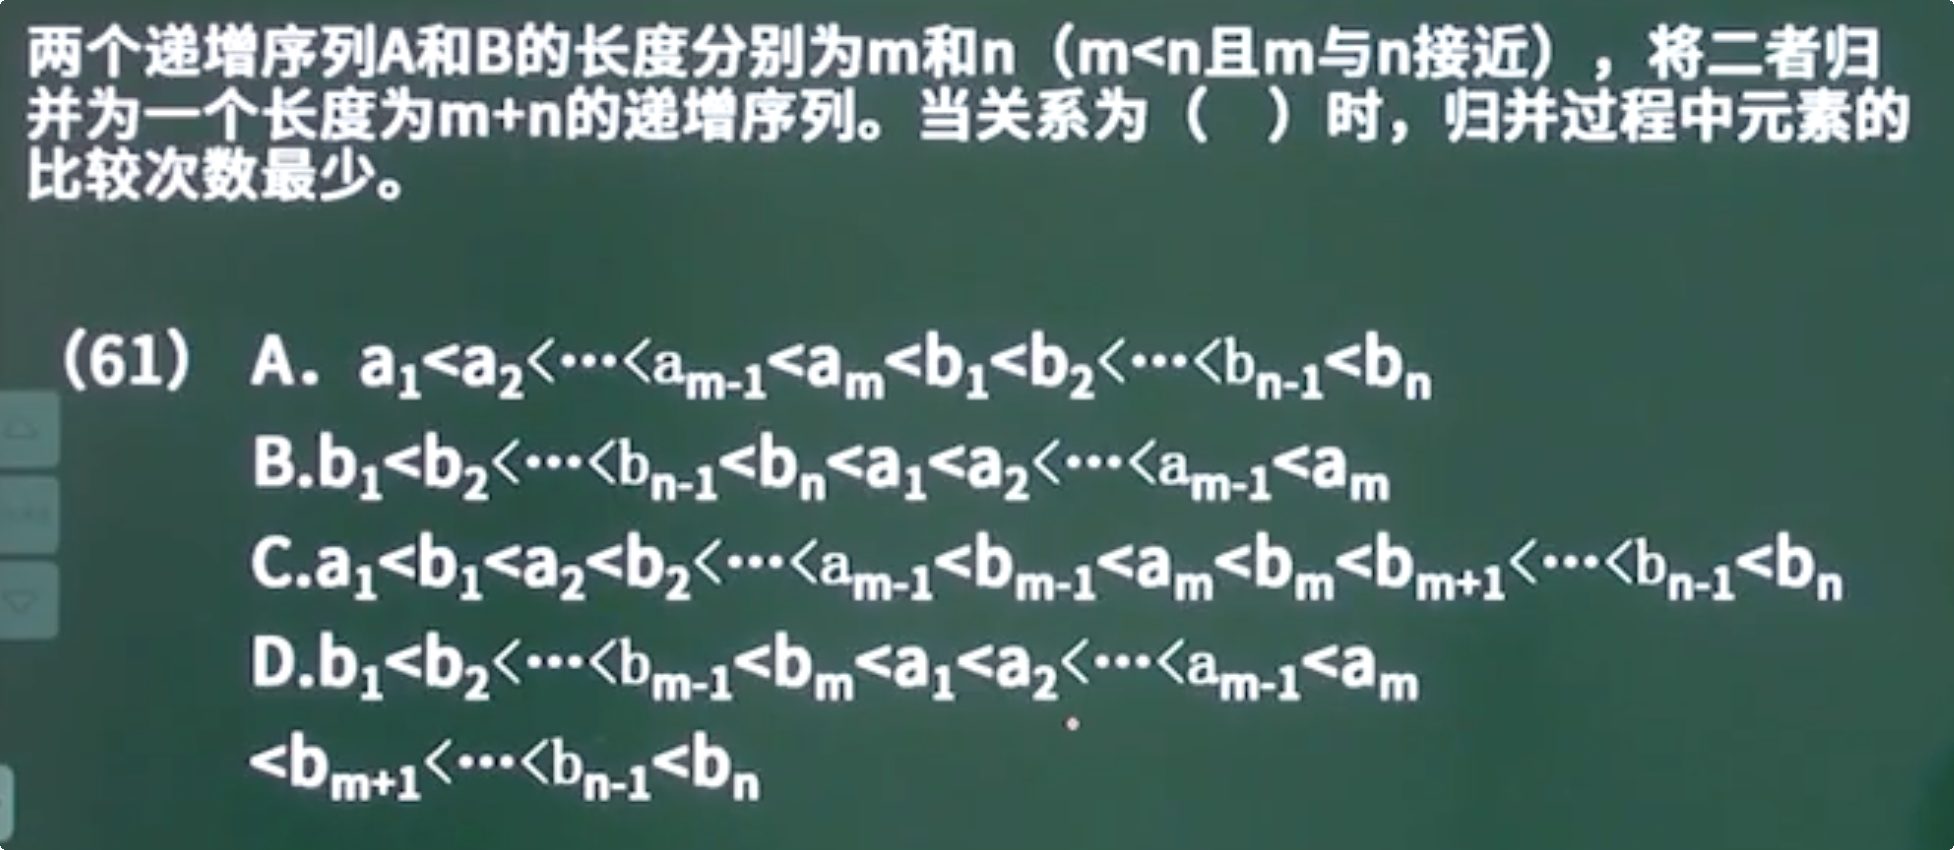
答:选A。
题中的排序算法为归并排序,要求比较次数最少,无非就是当A全小于B,或者B全小于A。对此可以先排除C、D选项;
A选项中,A的长度为m,只需要拿到比较,一共比较m次,同理,B选项中,b的长度为n,只需要拿到比较,一共比较n次,由于m<n,故选A。
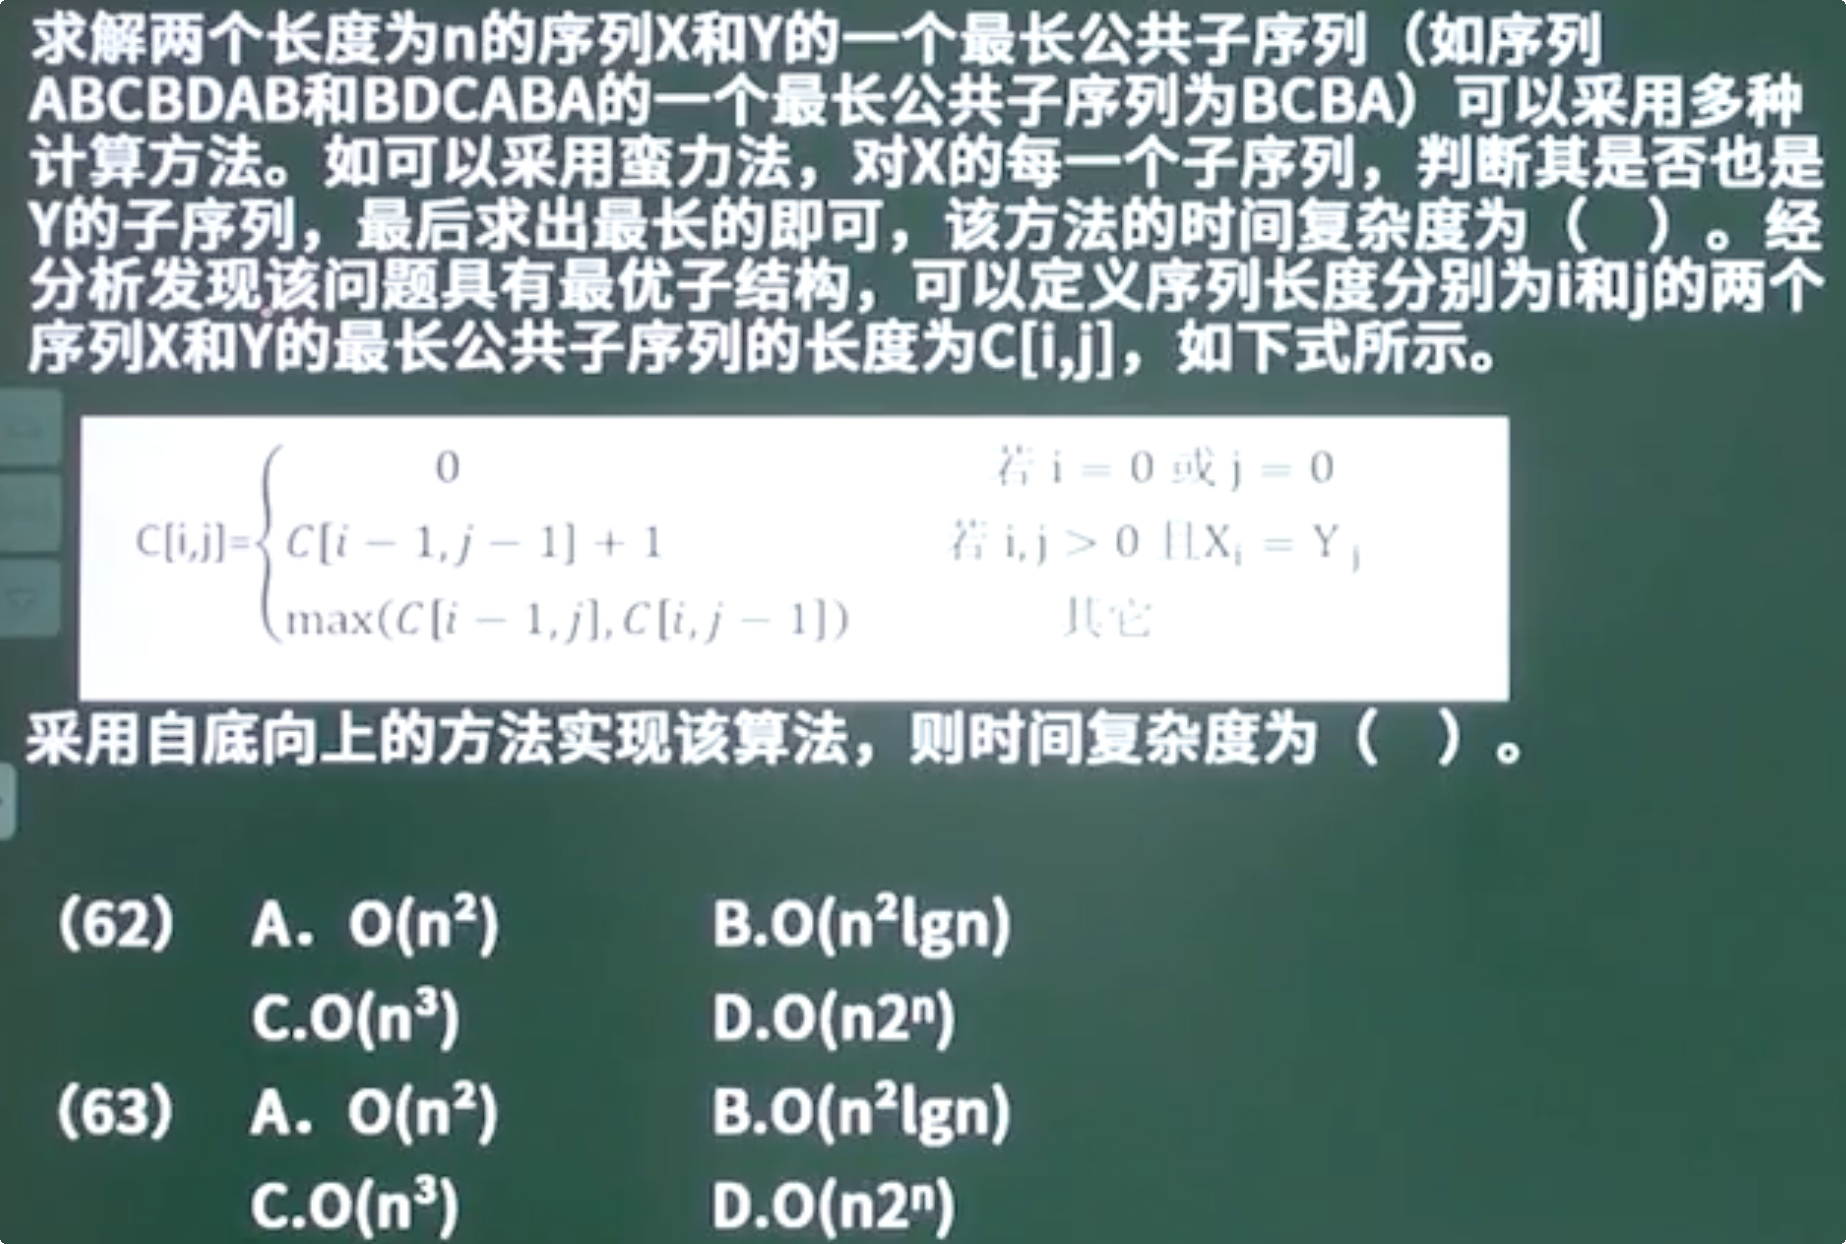
答:(62)D (63)A
(62)序列X长度为n,每个元素都可以选择是否包含在子序列中,每个元素都有两种选择,要么包含在子序列中,要么不包含在子序列中。由于有n个元素,每个元素都有两种选择,所以总共有种不同的组合方式,即个子序列。又由于序列Y也长度为n,故需将X的子序列与Y序列的每个元素比较,每个比较n次,故时间复杂度为;
(63)题中标出了具有最优子结构,可得知使用的是动态规划法,需要x和y嵌套分别遍历n次,故时间复杂度为。
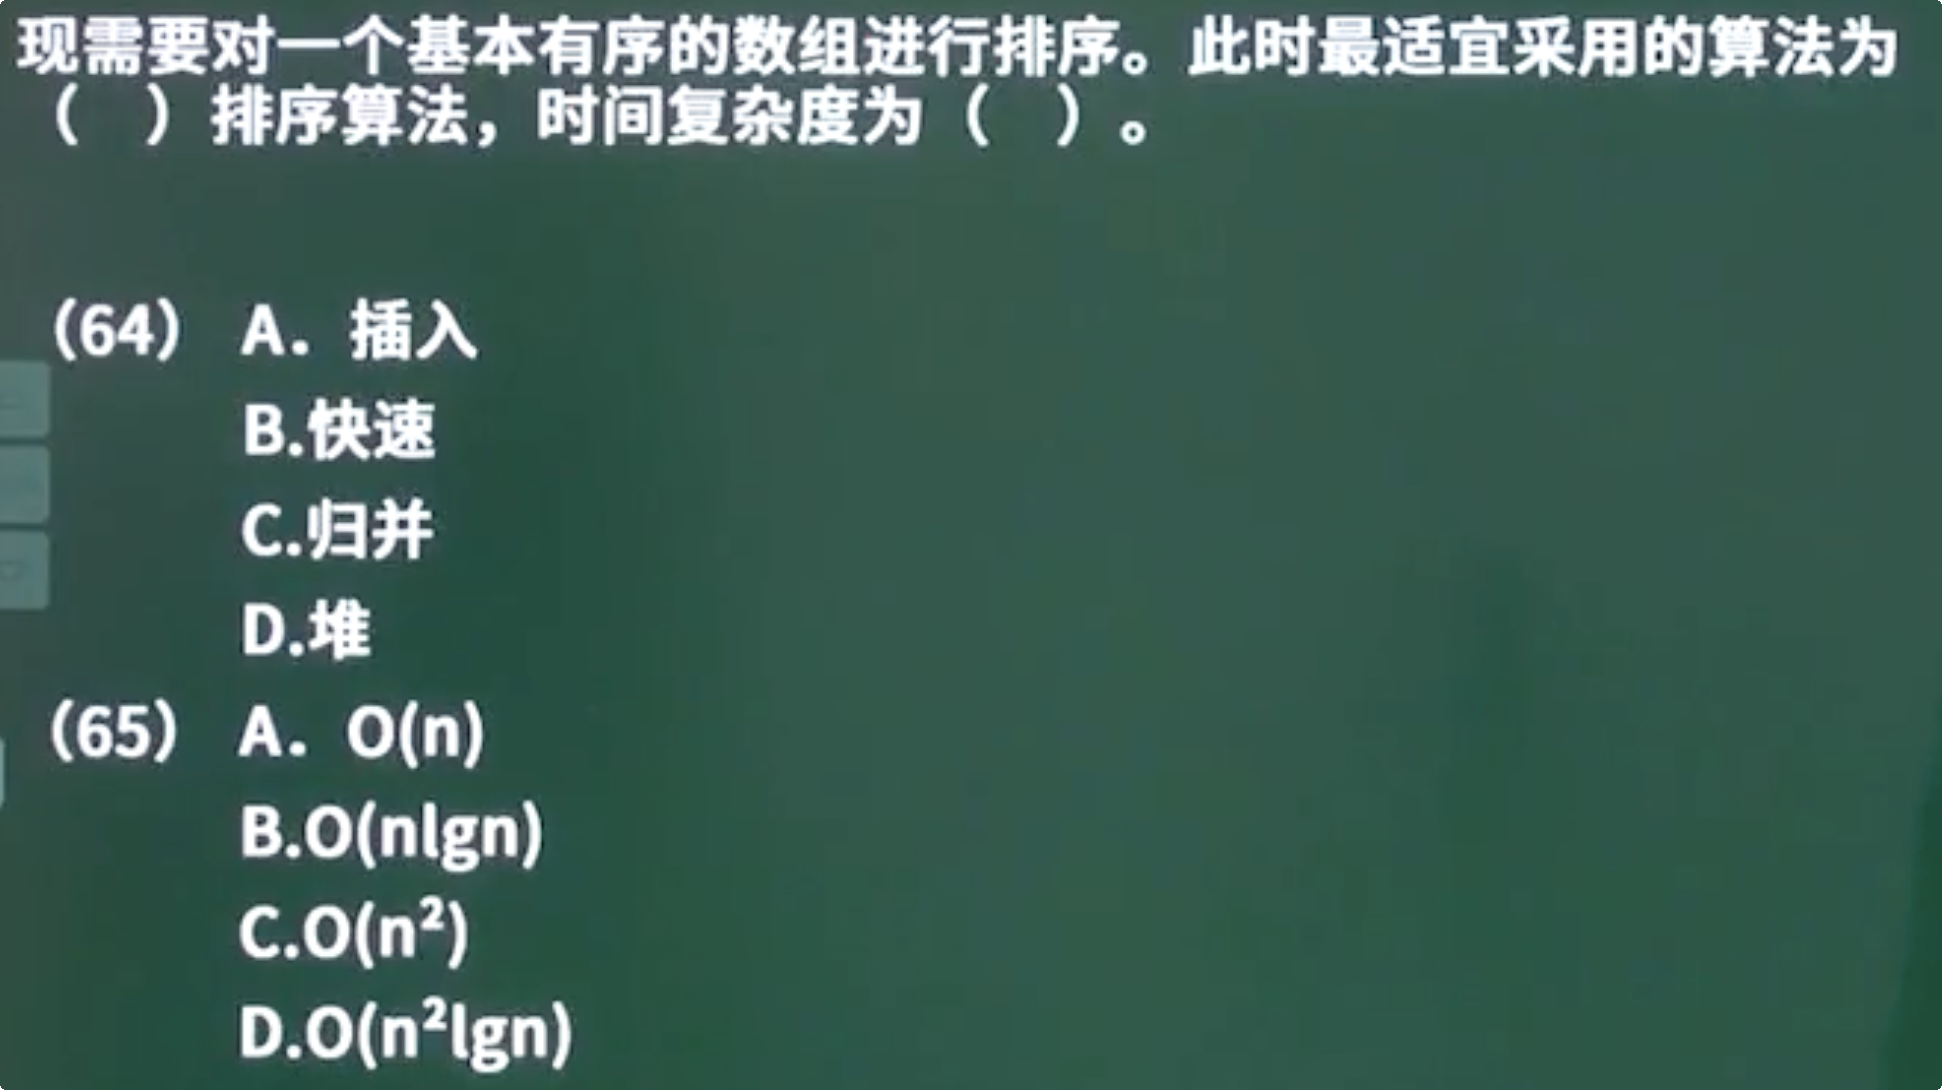
答:(64)A (65)A
插入排序(Insertion Sort)是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
插入排序的主要优点是对于部分有序的数组来说,插入排序的效率很高。另外,插入排序的一个优点就是对于少量元素的排序时,插入排序的效率非常高。但是插入排序的缺点也是显而易见的,即对于大量数据的排序时,插入排序的效率非常低。
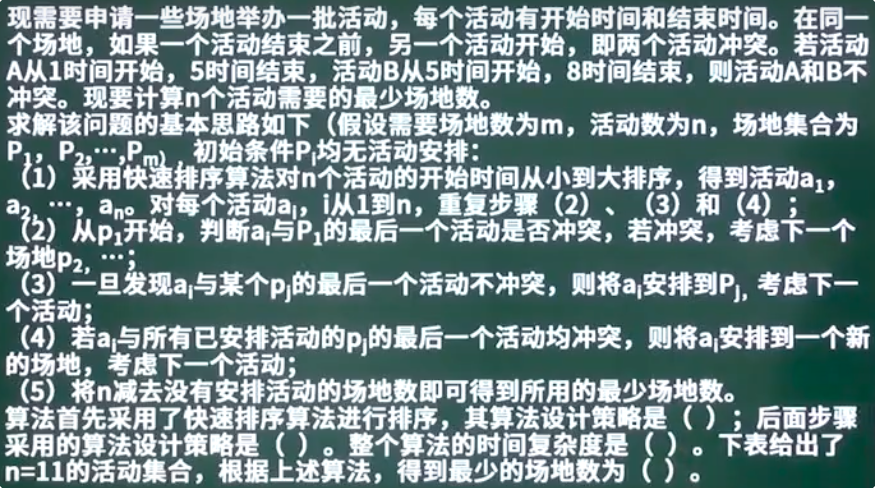
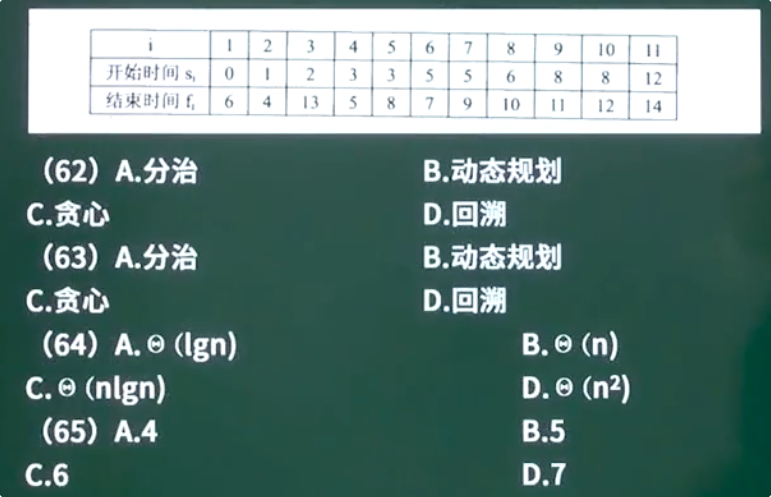
答:(62)A (63)C (64)D (65)B。
(62)快速排序的设计策略是分治法;
(63)2~5是求出最近的最少场次数;
(64)第一步做快排时的时间复杂度为,下面二到五的步骤,最坏情况每个元素都得比较,即复杂度为,故选D。
(65)将每个时间分为一组,可得到如下:
P1:0~6 6~10 12~14
P2:1~4 5~7 8~11
P3:2~13
P4:3~5 5~9
P5:3~8 8~12
法律
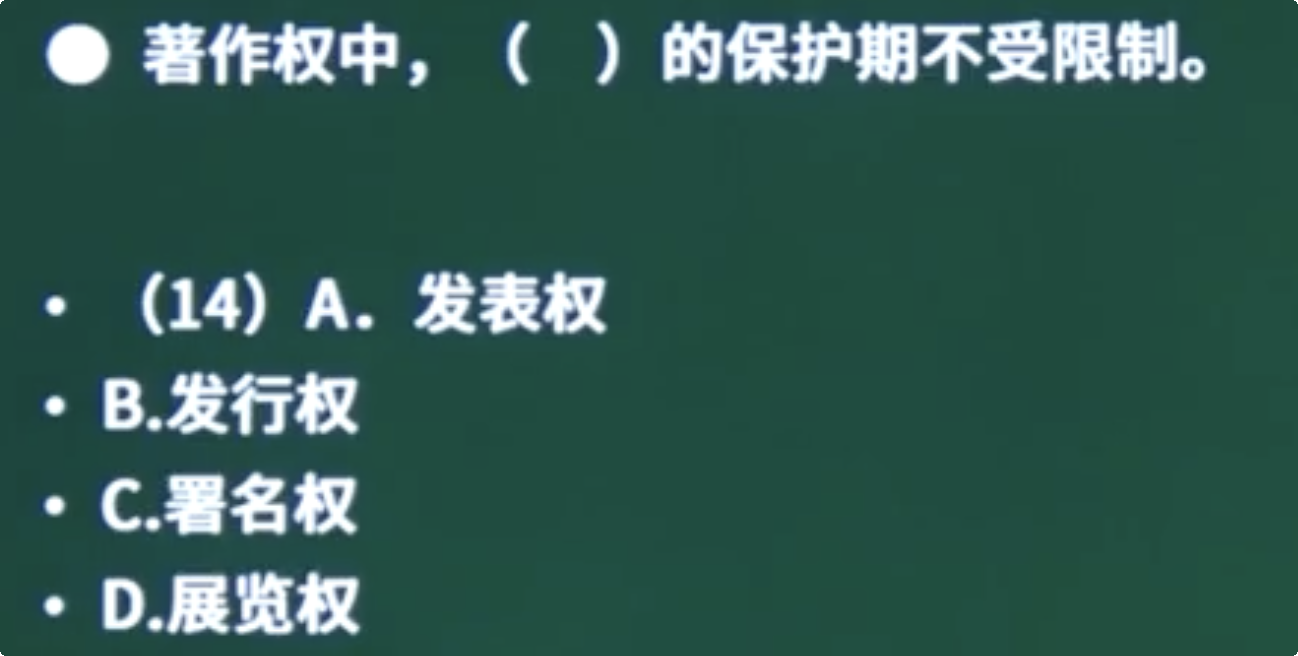
答:选C。只有署名权的保护期不受限制。
专业英语
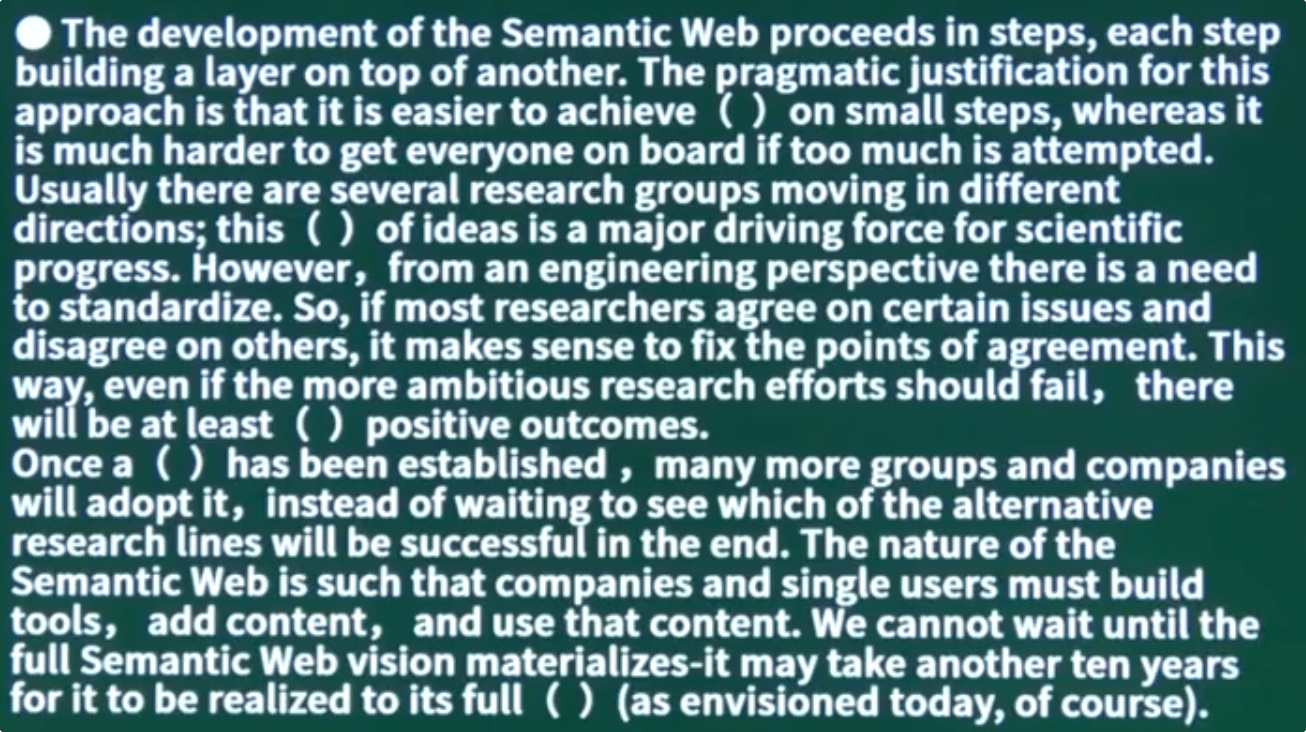
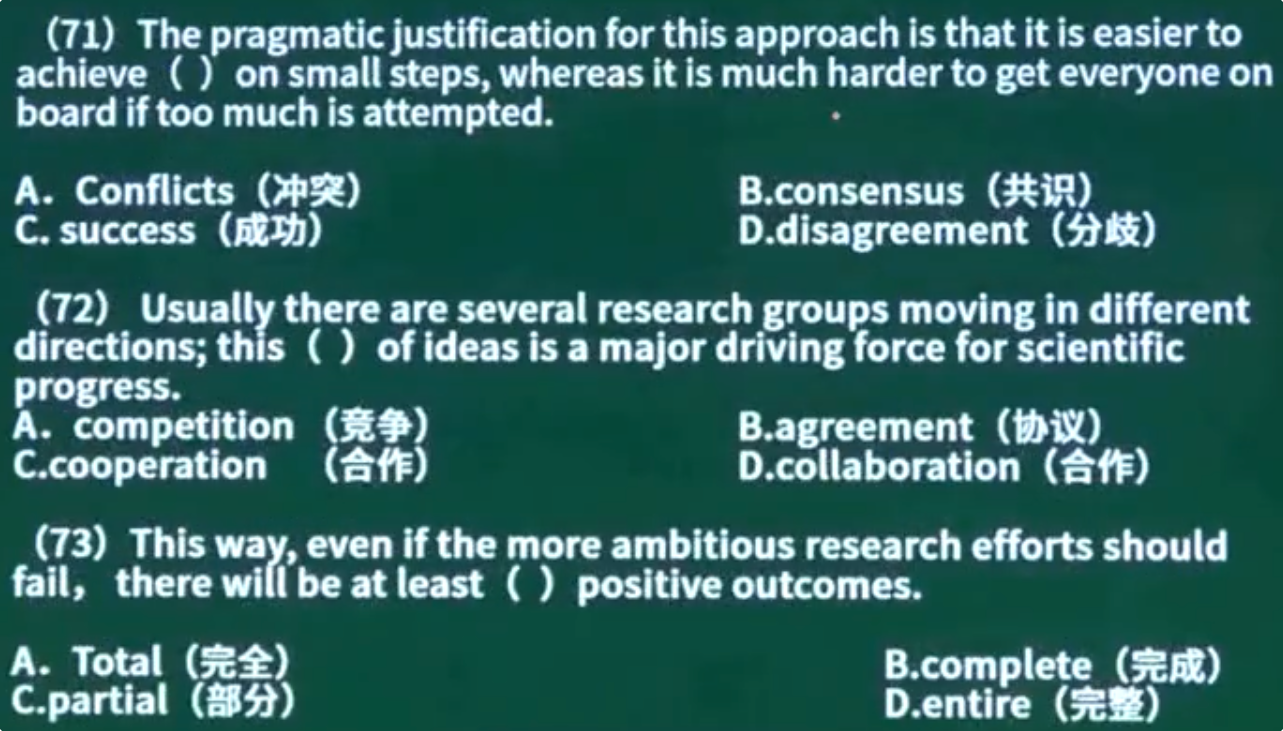
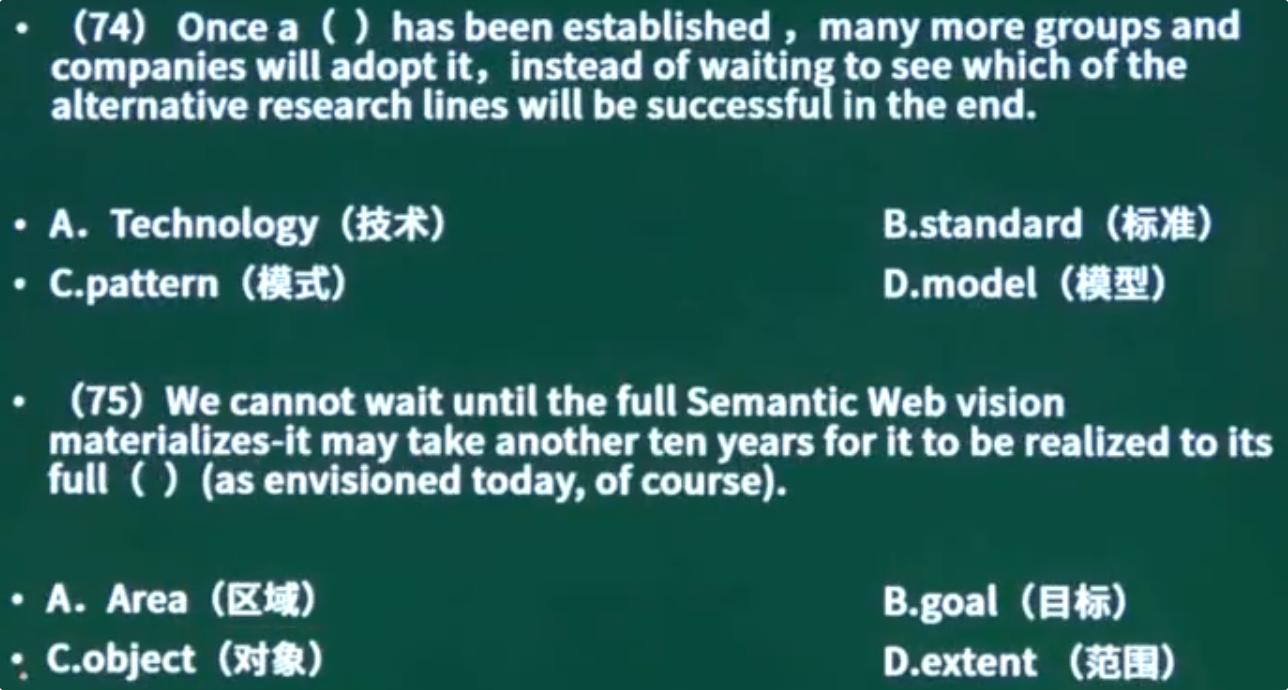
答:(71)B (72)A (73)C (74)B (75)D
(71)这种方法的实际理由是,更容易在小步骤上达成共识,然而,如果尝试太多,就很难让每个人都参与进来。
(72)经常有一些研究小组在不同的方向前进,这种思维的竞争是科学进步的主要动力。
(73)这种方式,即使更有野心的研究效果也会失败,至少也会有部分积极的结果。
(74)一旦标准被建立,会有更多小组和公司会遵从它,而不是等待着哪一个可替代的研究方向最终会取得成功。
(75)我们不能等到完整的语义网愿景实现——它可能还需要10年的时间才能实现完全的(当然,就像今天设想的那样)。
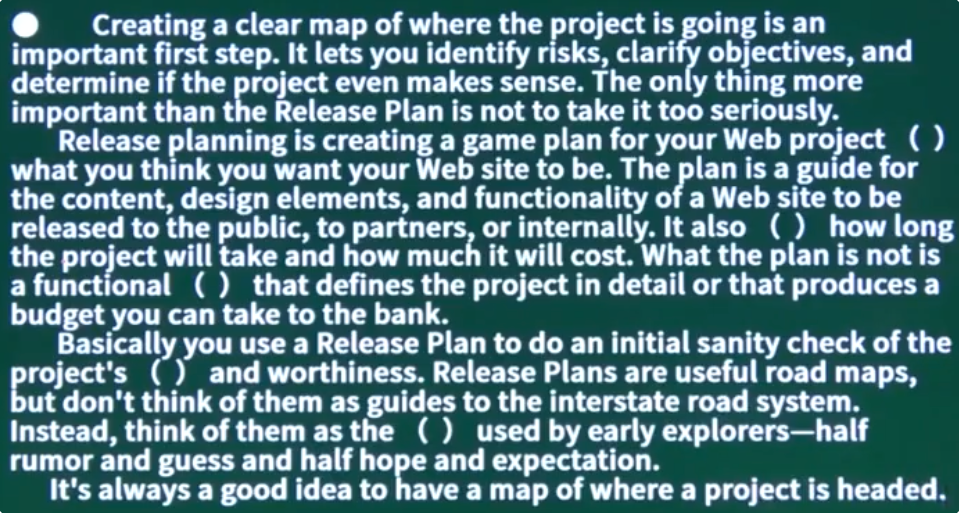
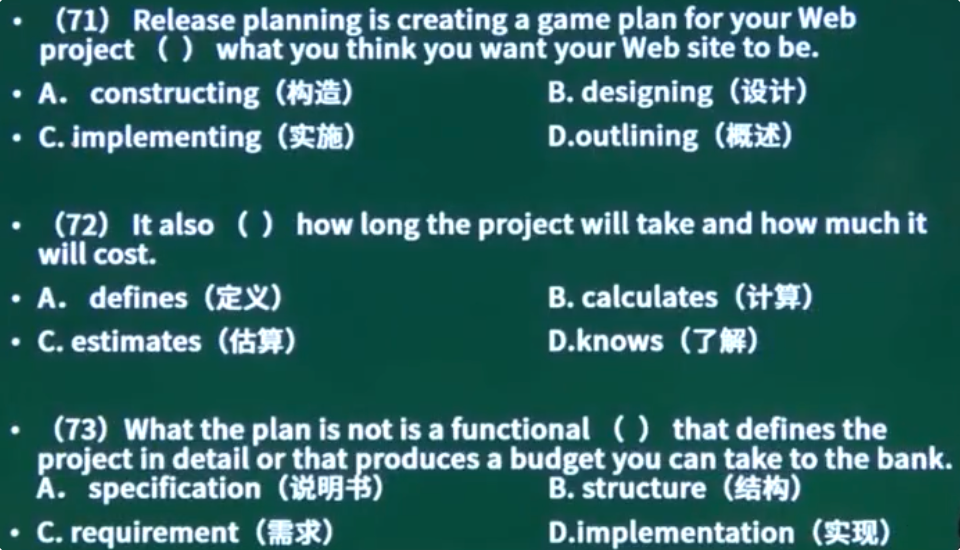
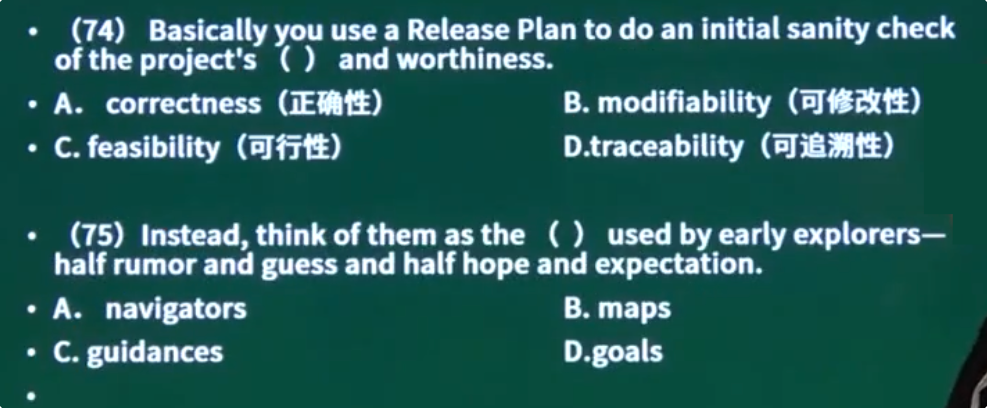
答:(71)D (72)C (73)A (74)C (75)C。
系统开发基础
软件容错技术
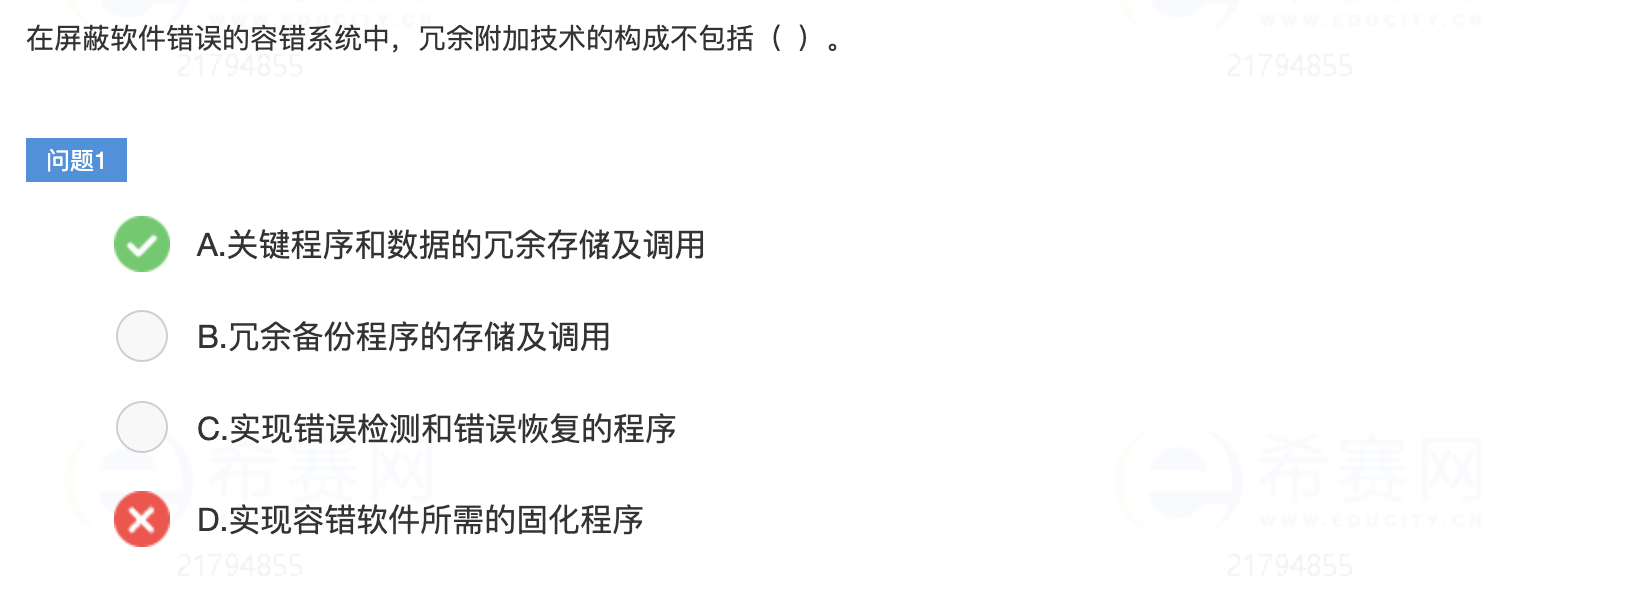
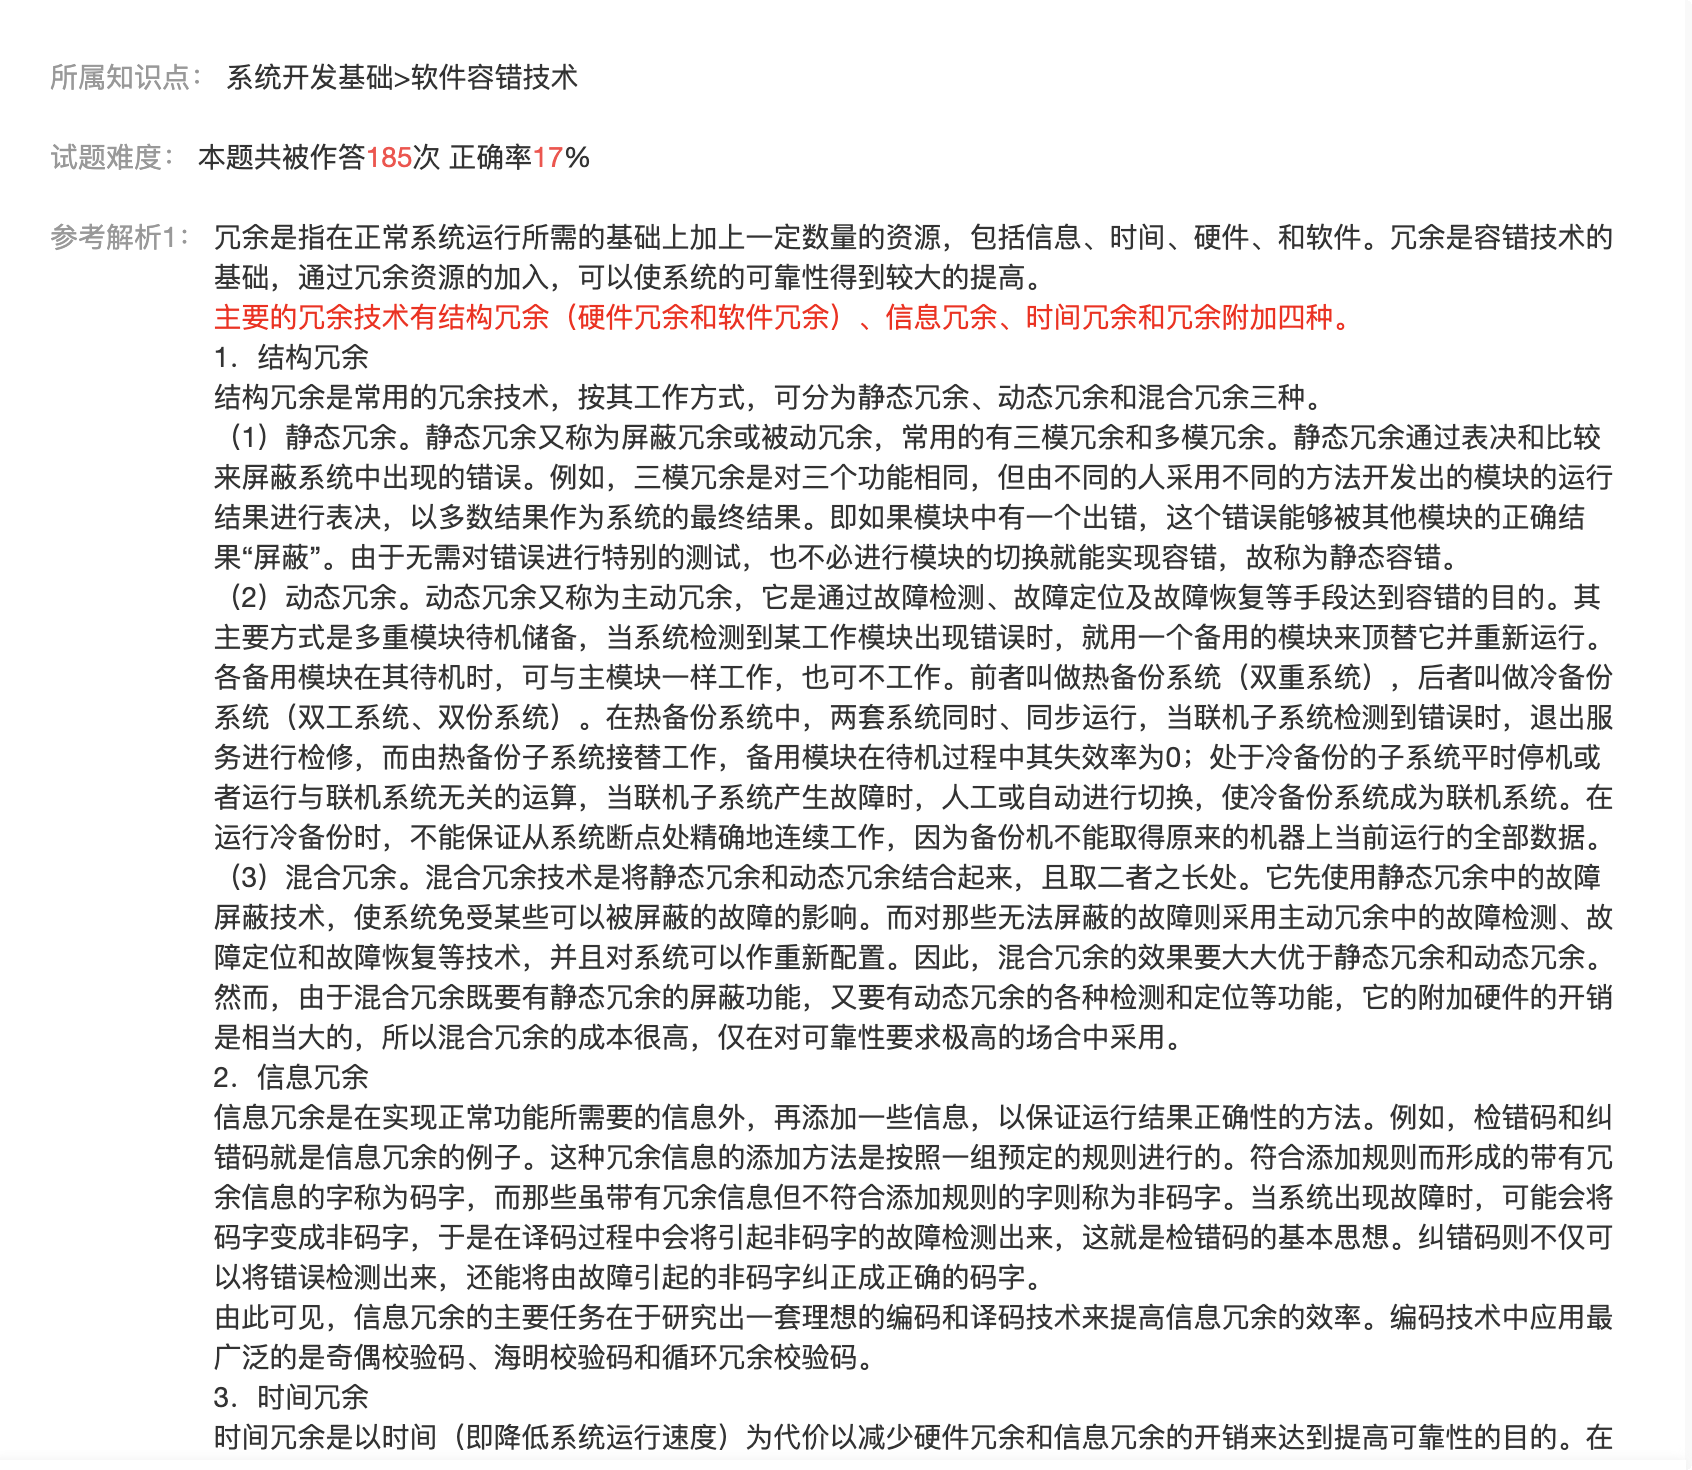
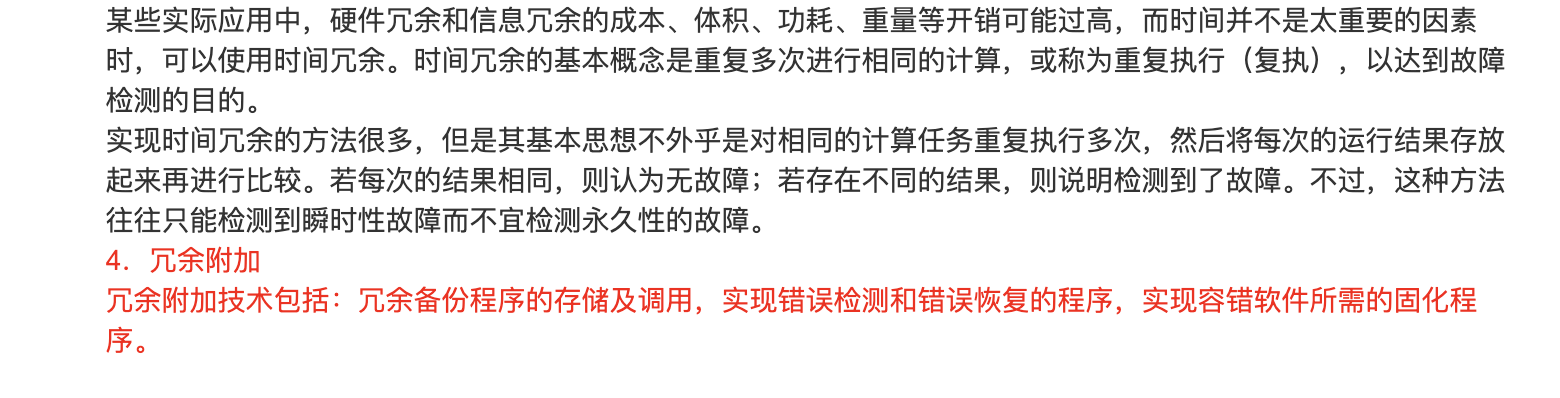
软件过程和软件改进
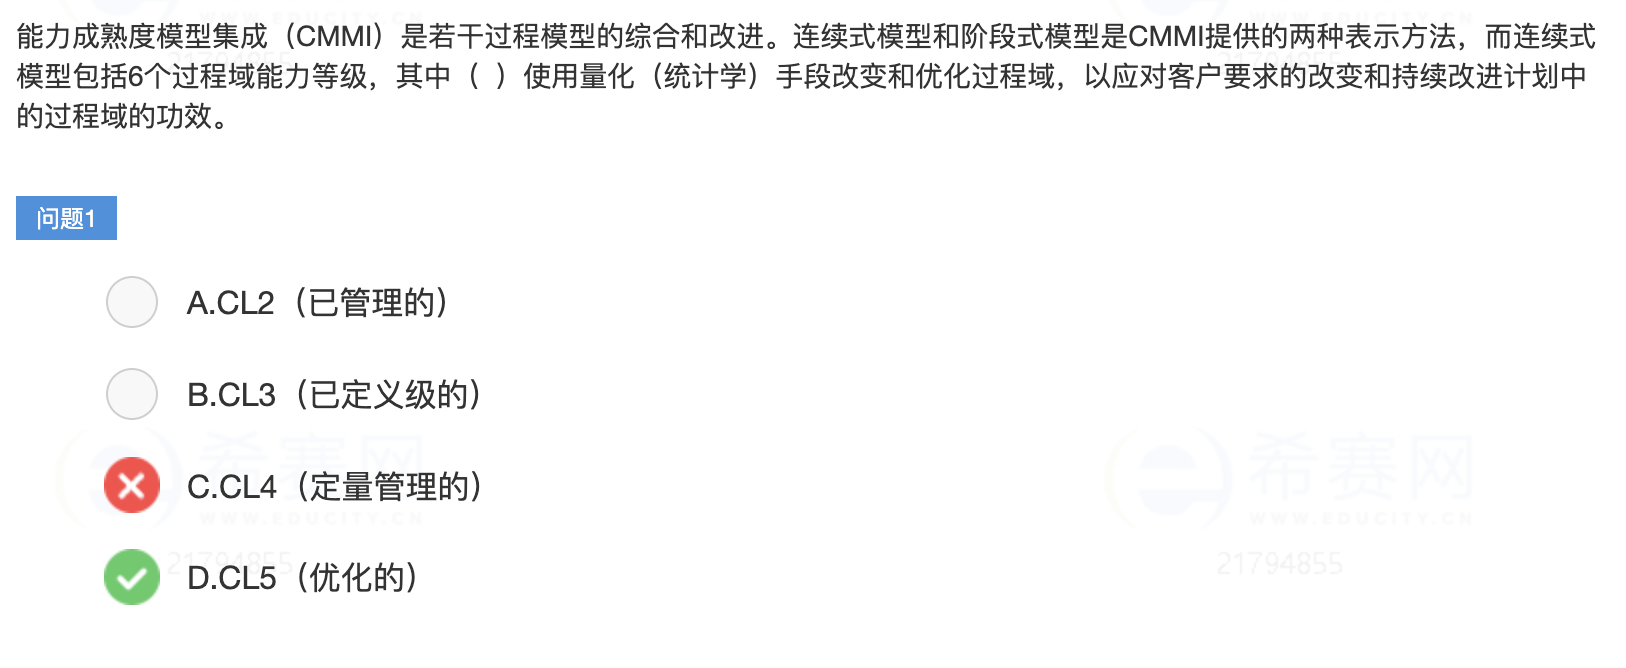
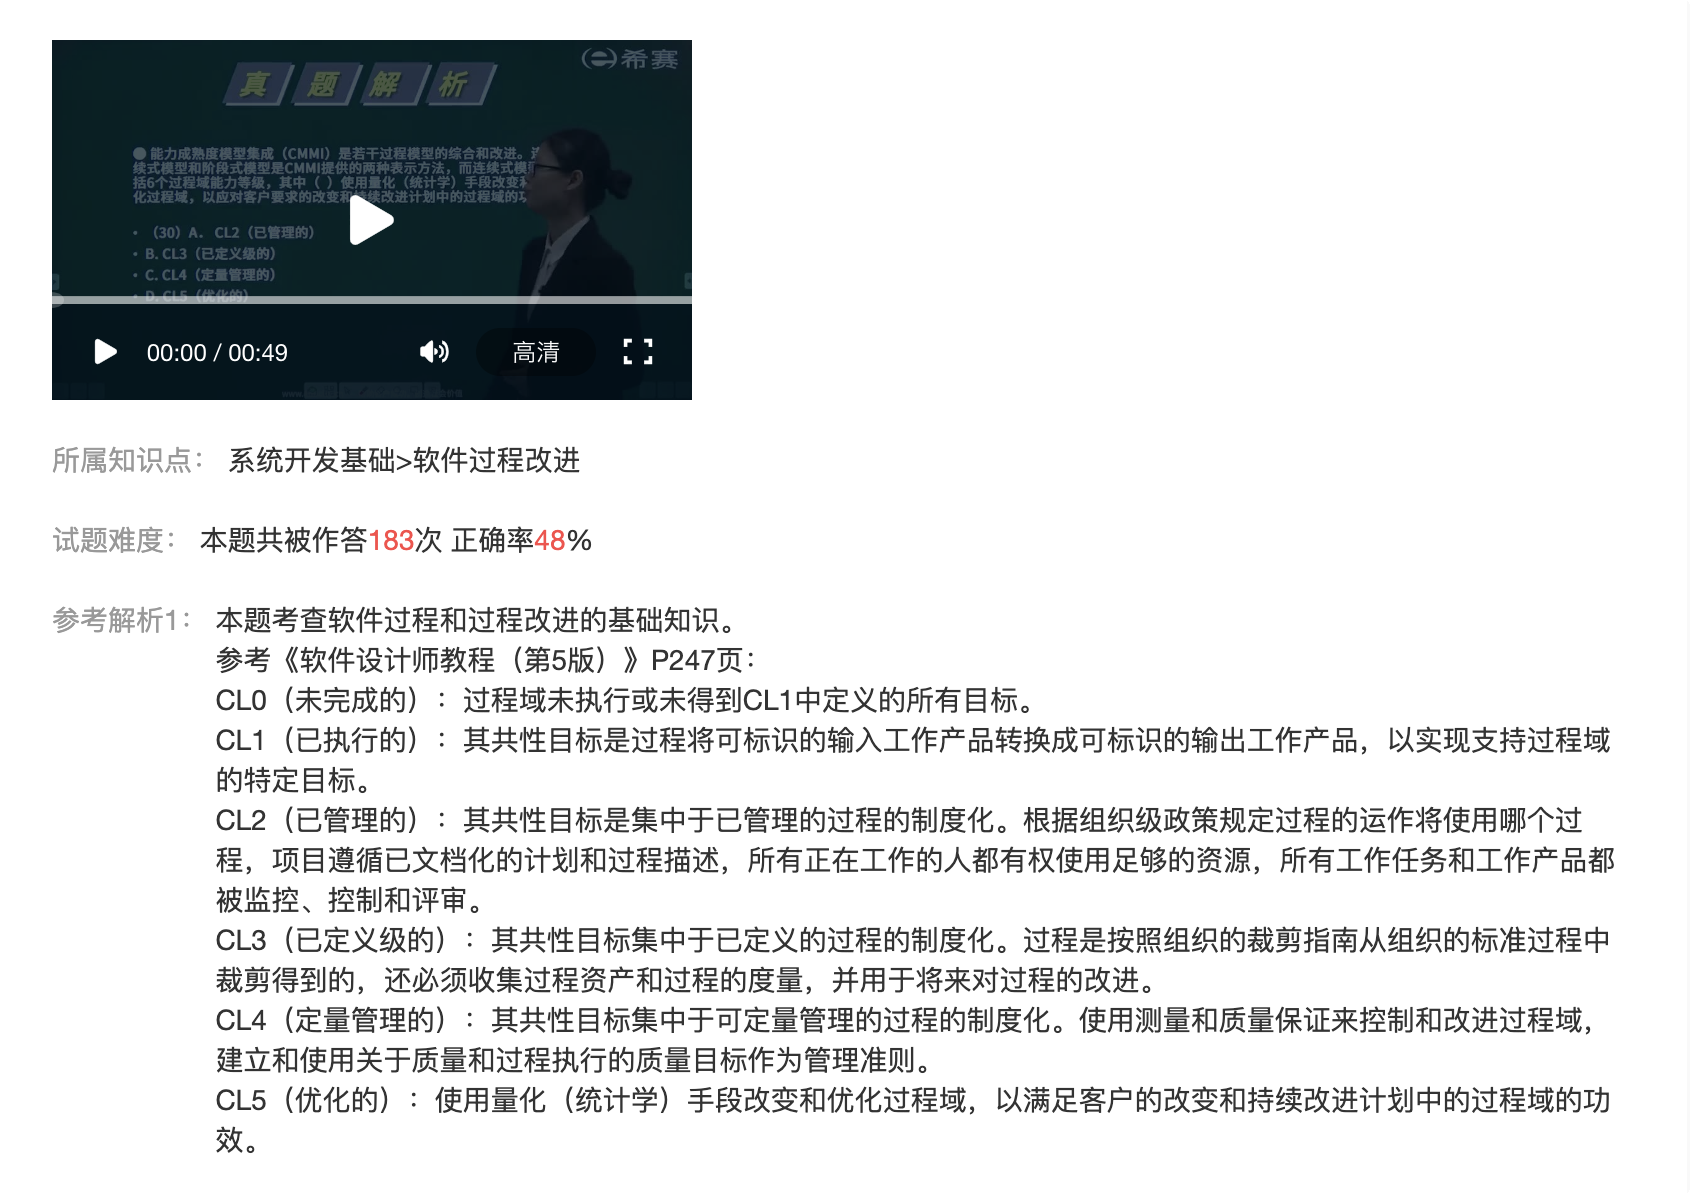
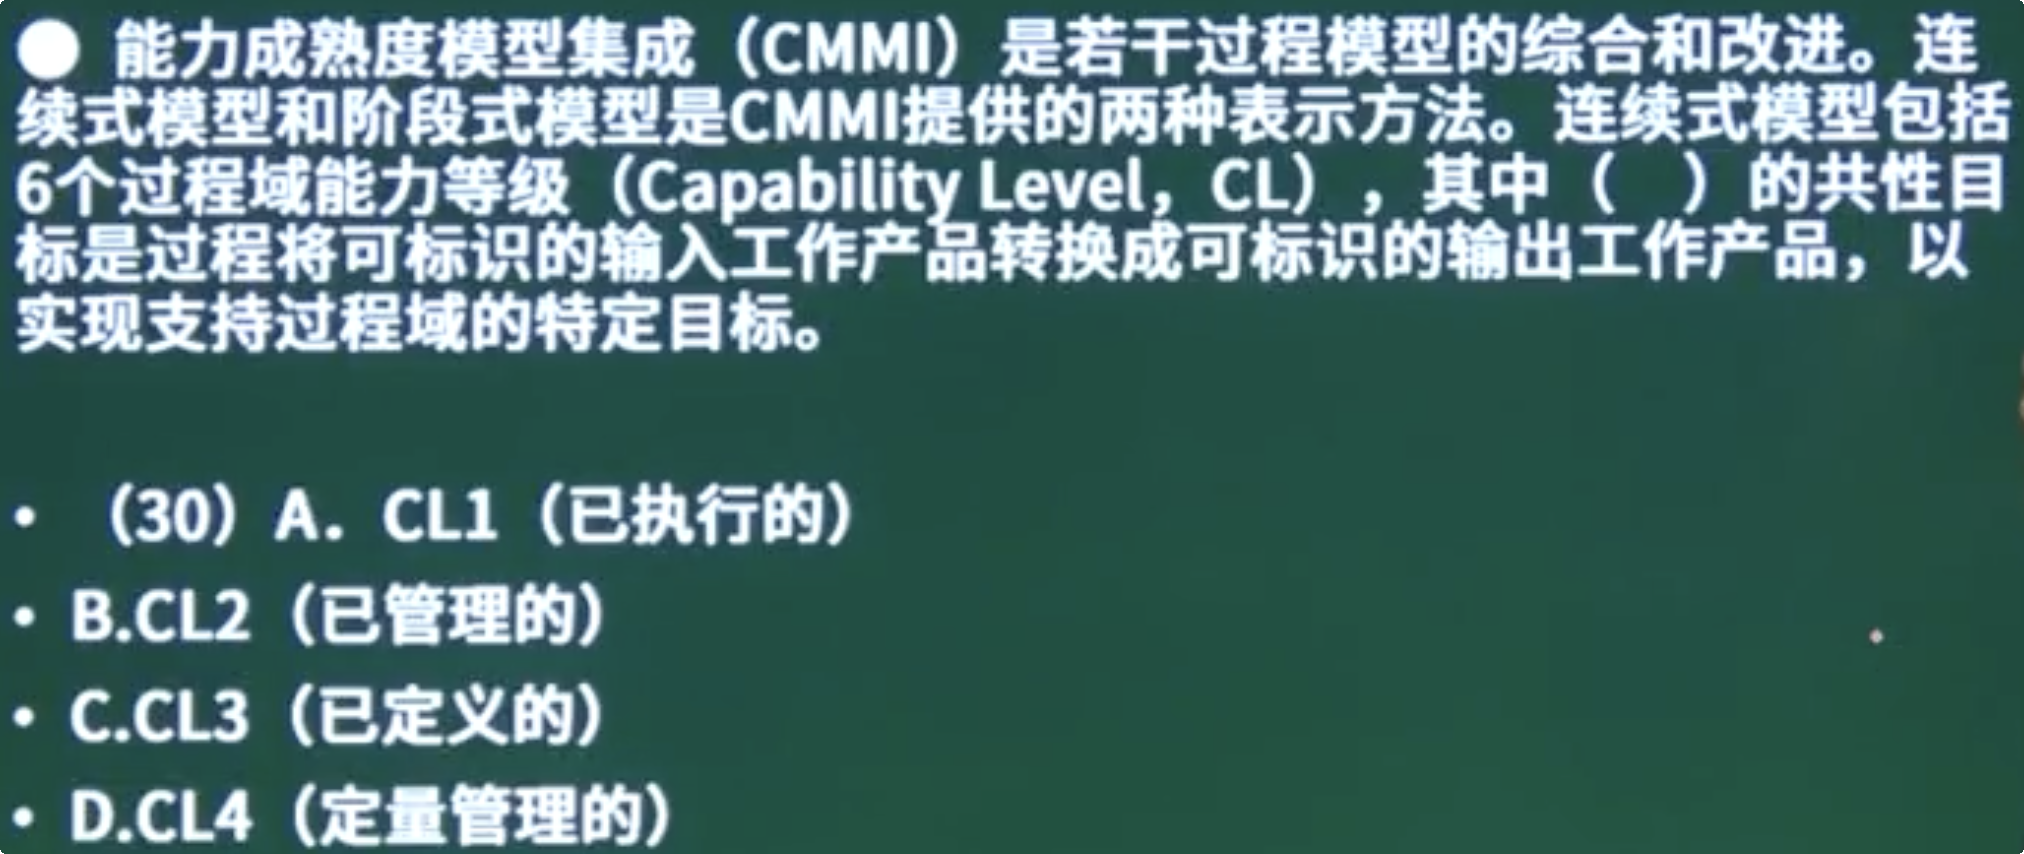
答:选A。
其它
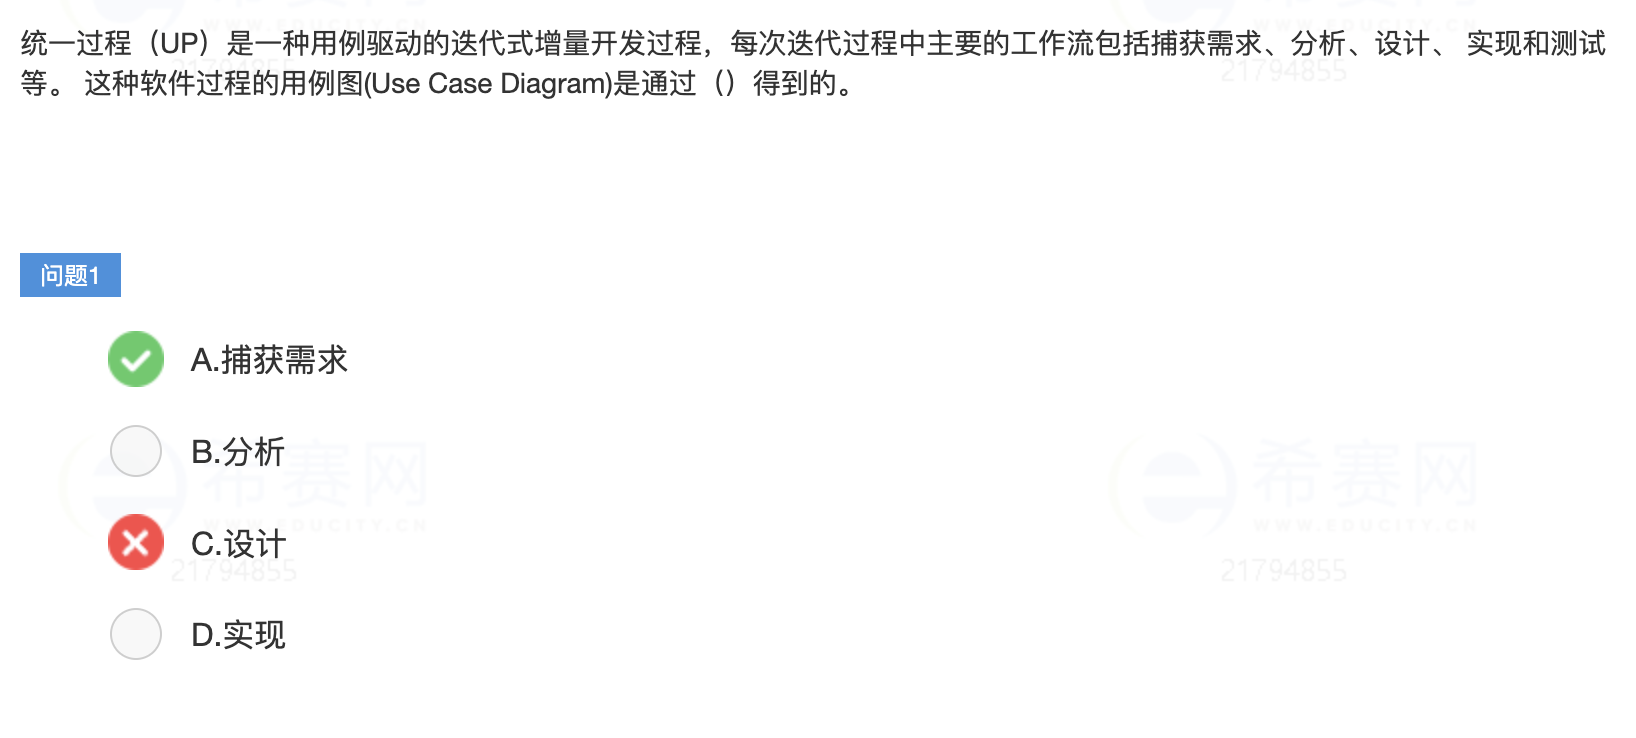
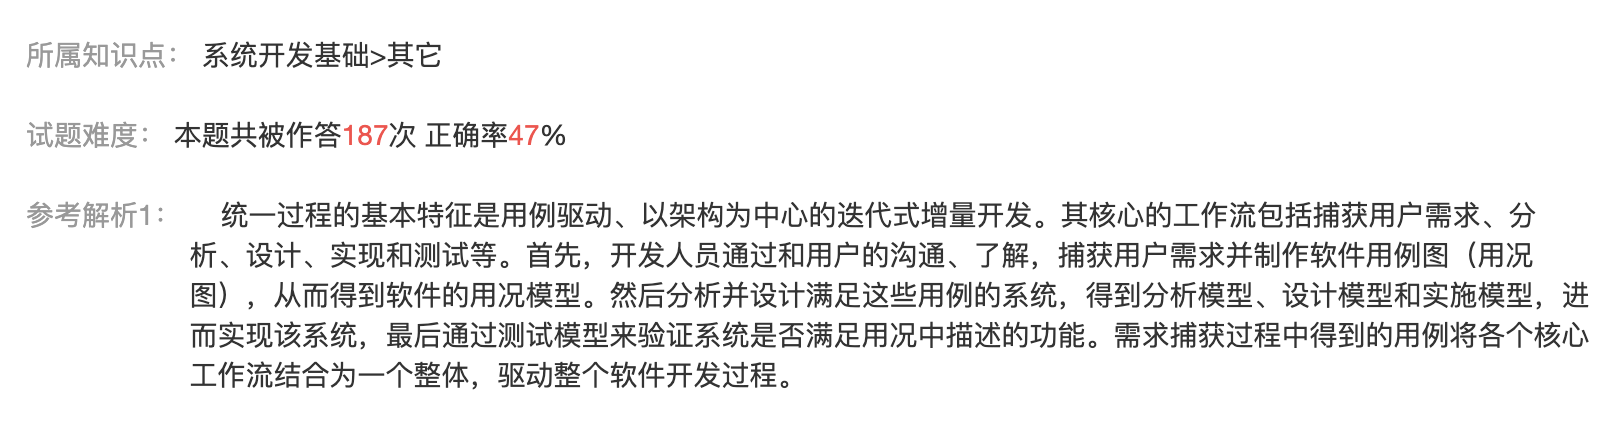
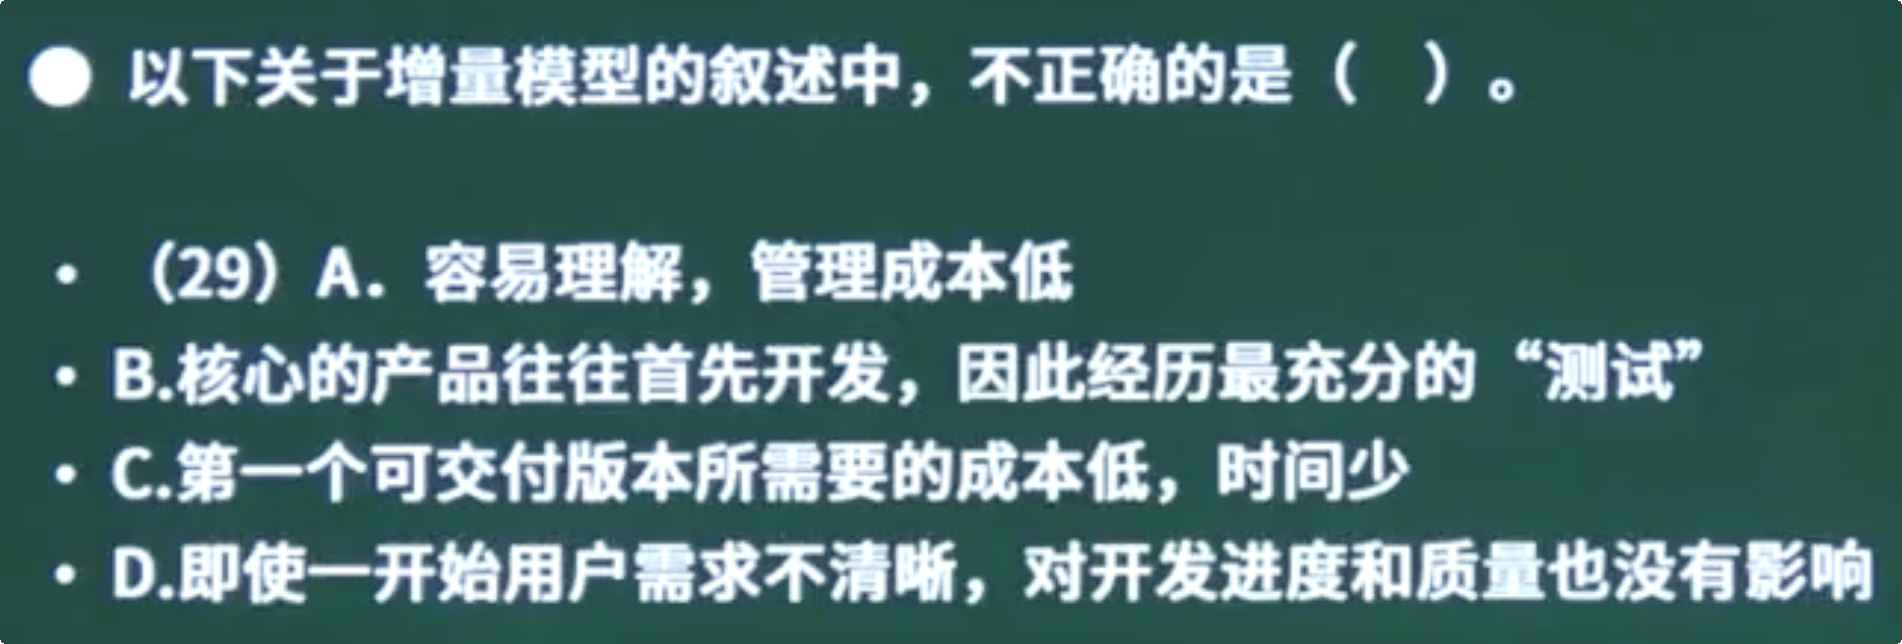
答:选A。
增量模型是有一个初始的版本,然后不断往上迭代功能,会有多个版本,增加了版本管理的成本,故A选项错误。
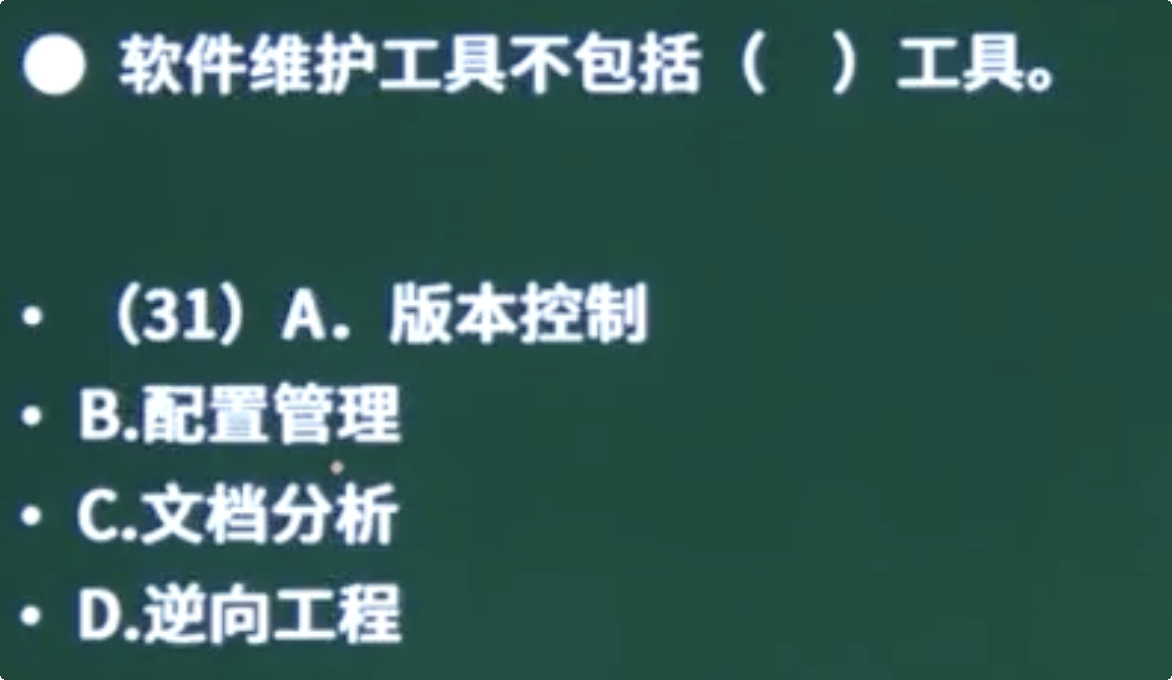
答:选B。配置管理上配置管理的支持工具。
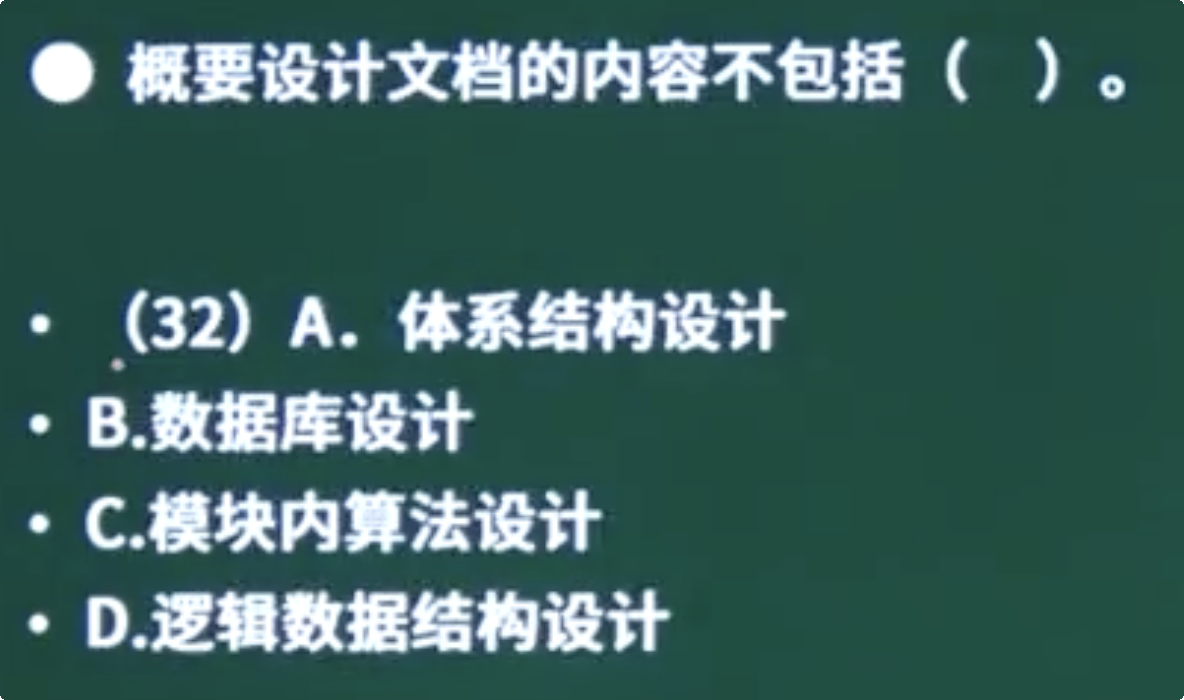
答:选C。
模块内算法设计属于详细设计的内容。
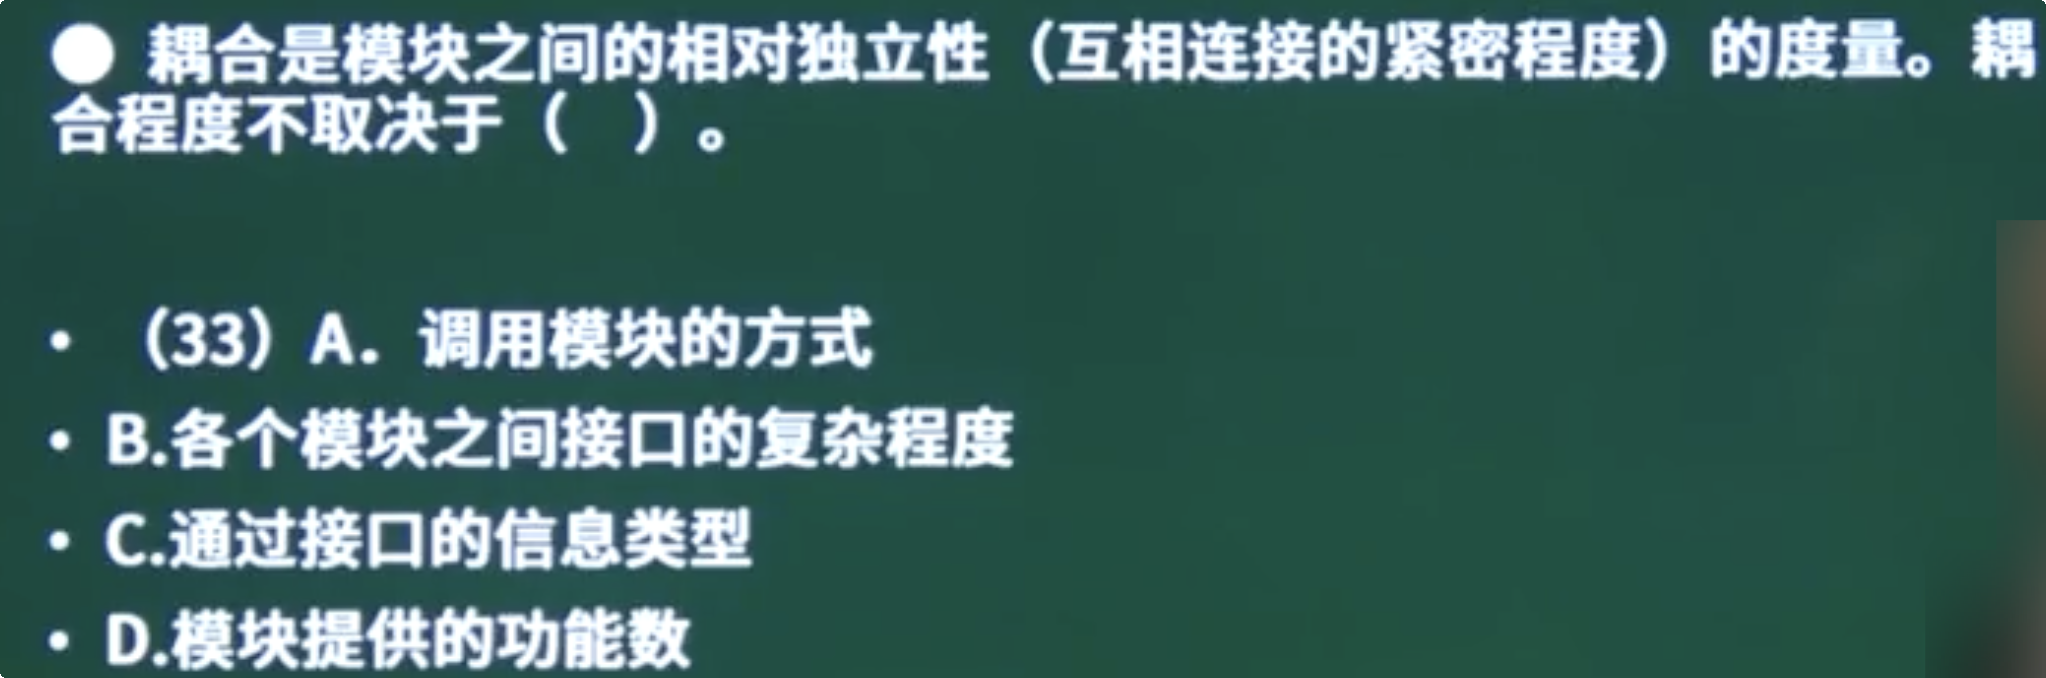
答:选D。
耦合性(Coupling),也叫耦合度,是对模块间关联程度的度量。耦合的强弱取决于模块间接口的复杂性、调用模块的方式以及通过界面传送数据的多少。模块间的耦合度是指模块之间的依赖关系,包括控制关系、调用关系、数据传递关系。
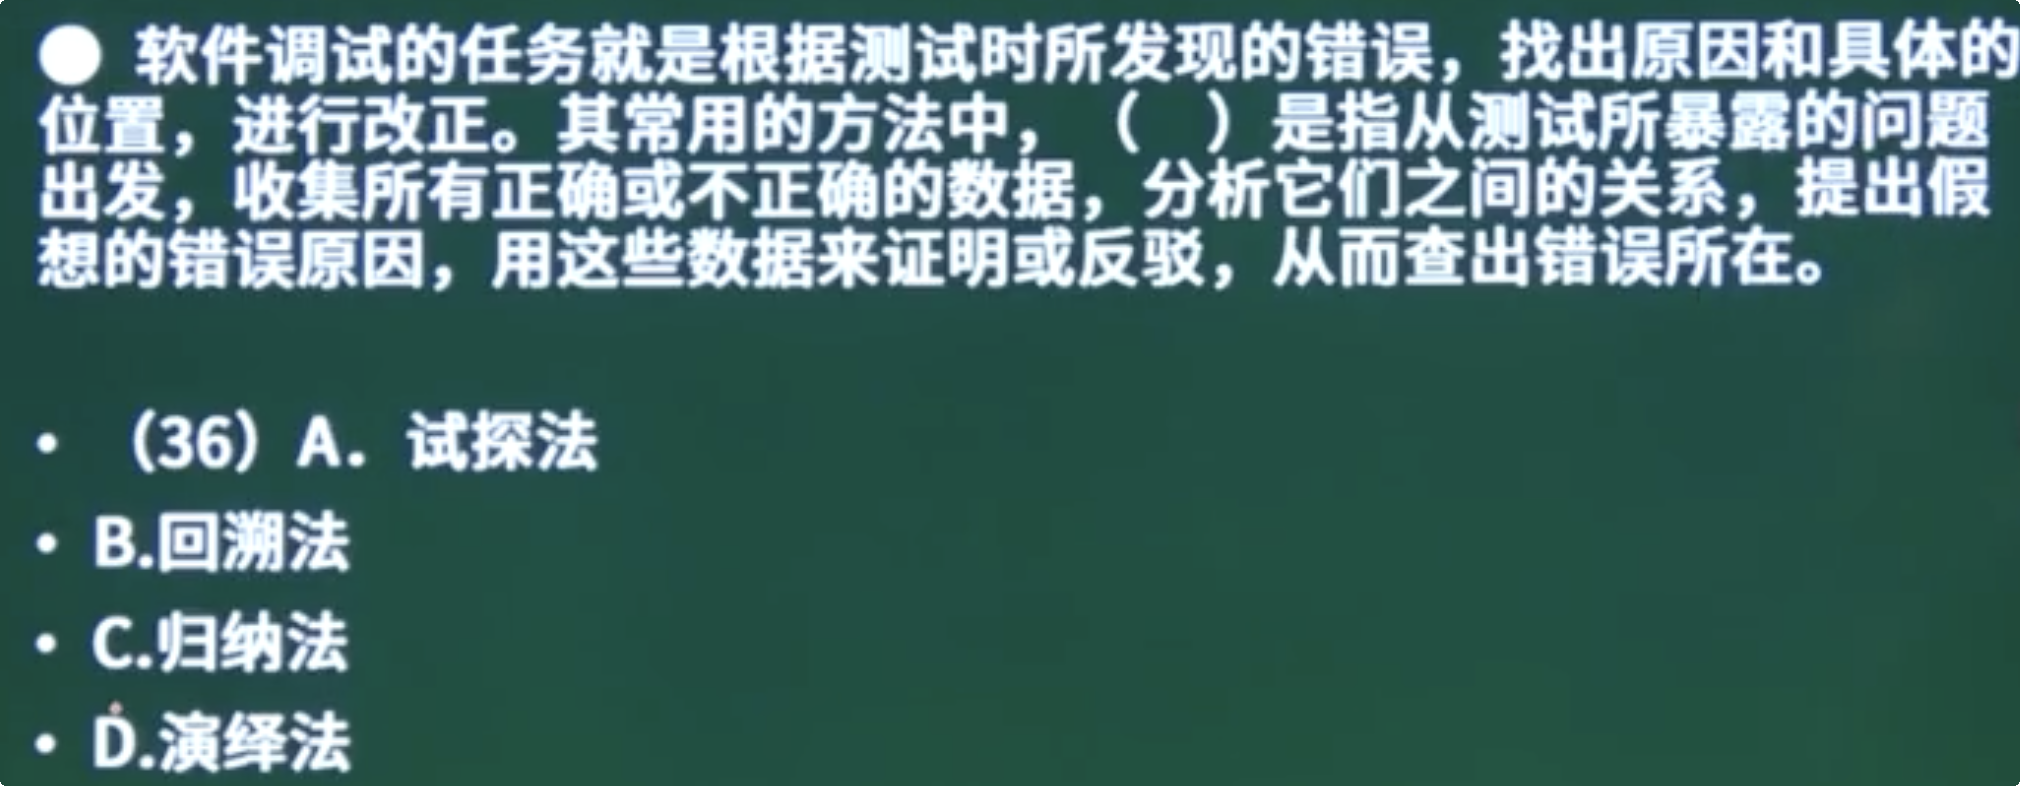
答:选C。
下午题
数据库设计
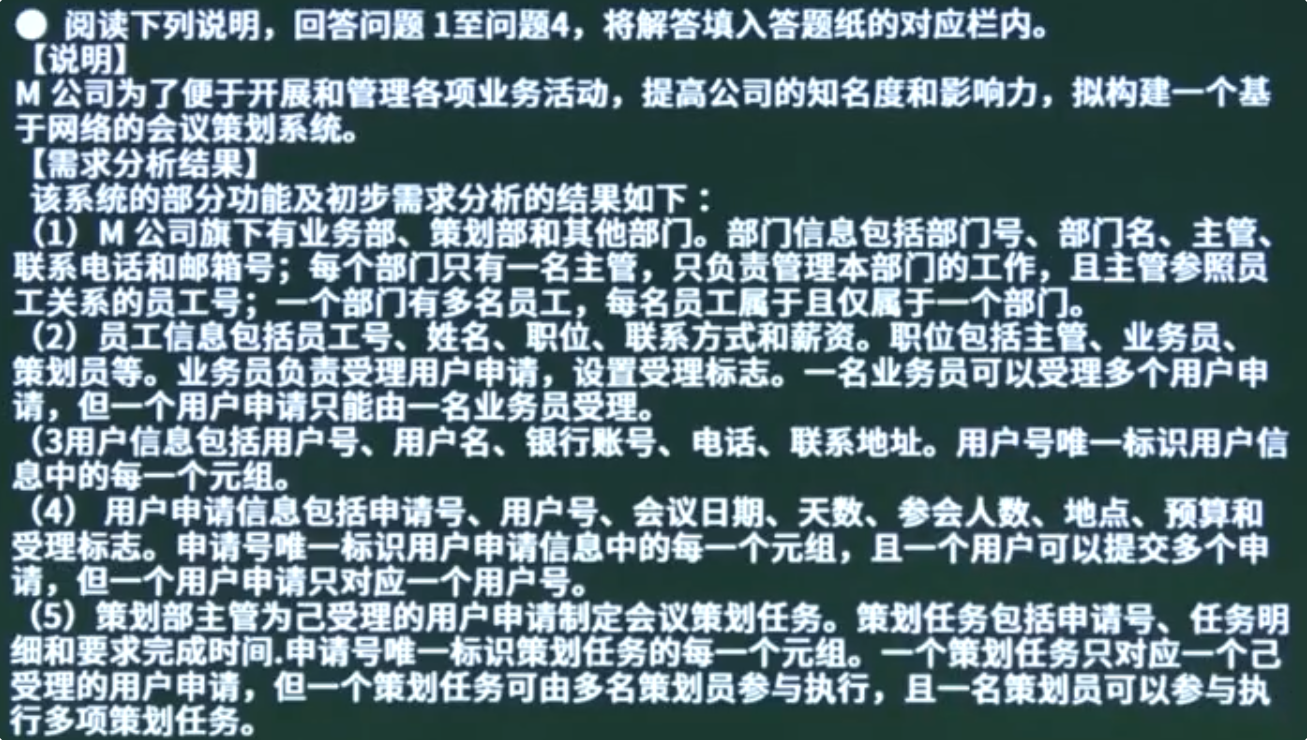
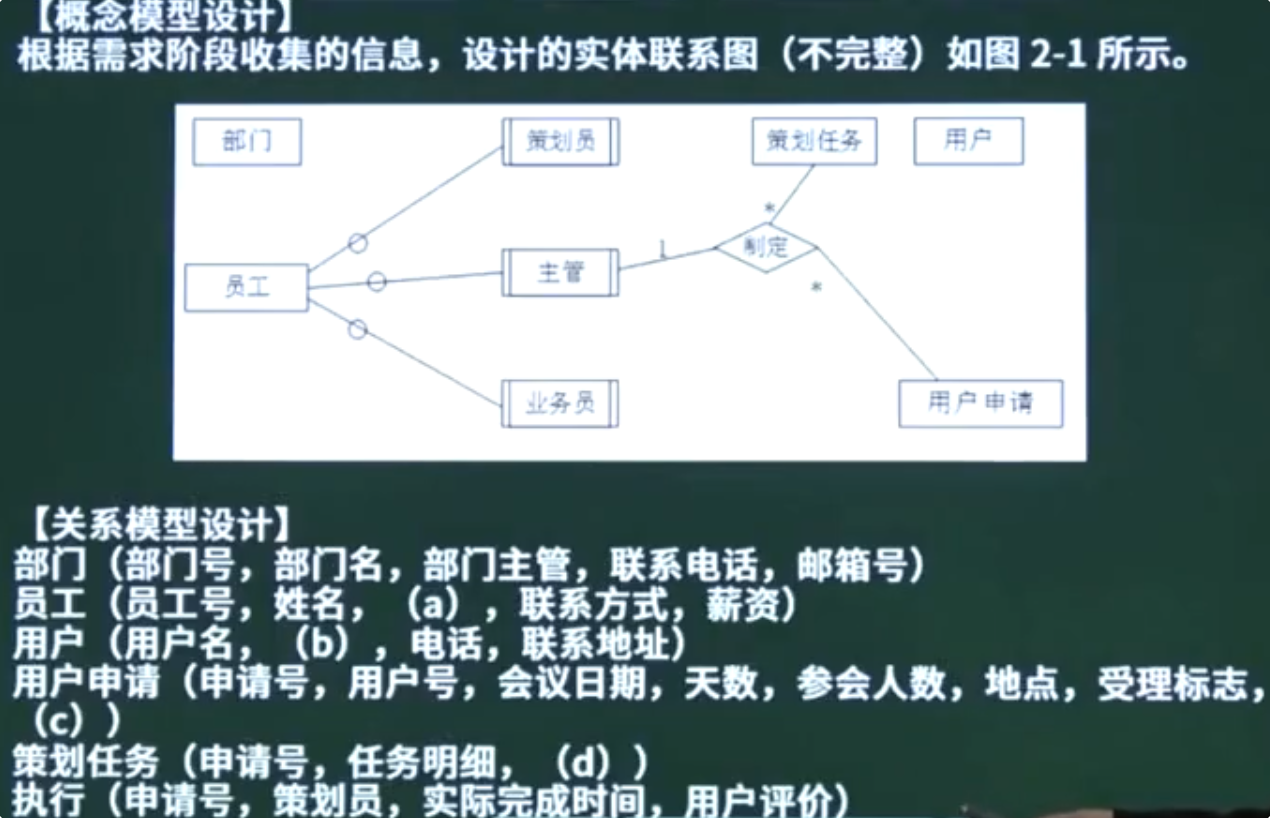
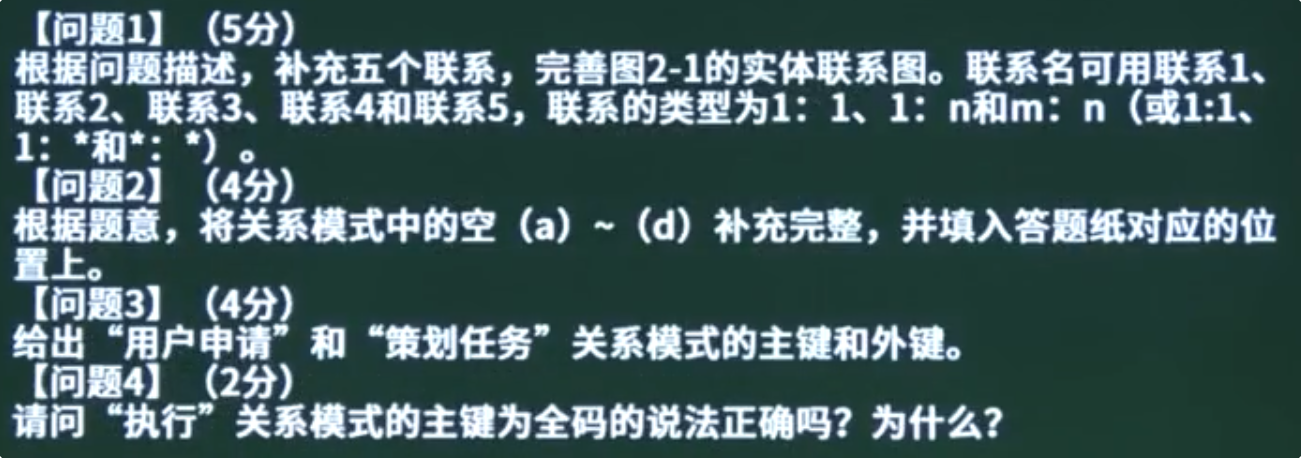
答:
问题1:
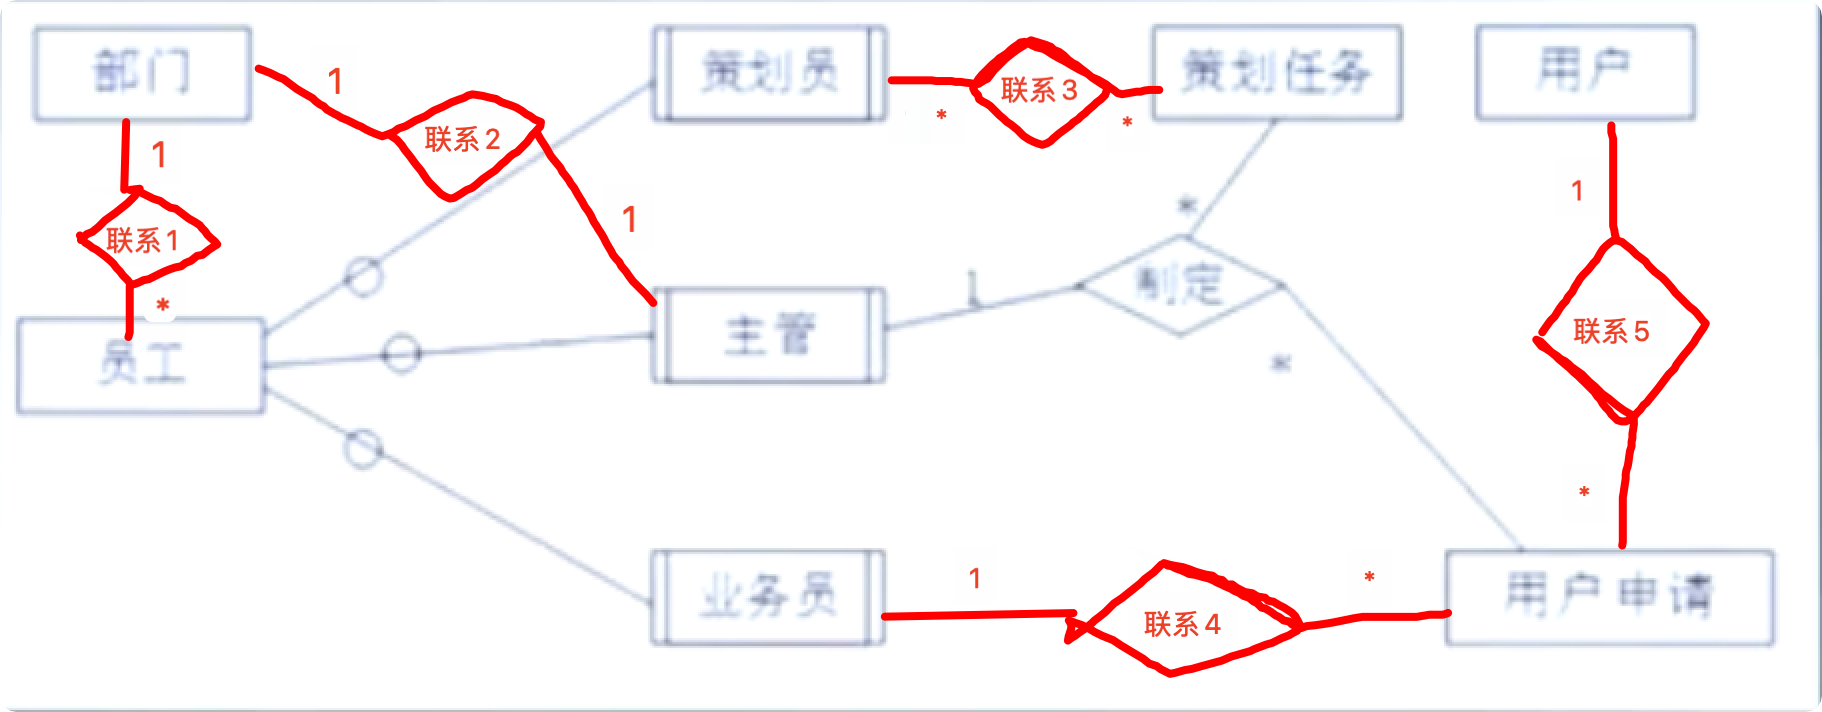
联系1:部门与员工,1:*
联系2:部门与主管:1:1
联系3:策划员与策划任务::
联系4:业务员与用户申请:1:*
联系5:用户与用户申请:1:*
问题2:
a:职位,部门号
b:用户名、银行账号
c:预算,业务员(员工号)
d:要求完成时间,主管(员工号)
问题3:
用户申请:主键:申请号 外键:用户号、业务员(员工号)
策划任务:主键:申请号 外键:申请号、主管(员工号)
问题4:
不正确,”执行“关系模式的所有属性并非全是候选码,实际完成时间和用户评价为非主属性。如果一个关系模式的所有属性都是候选码,则称为全码。
程序题
C++版
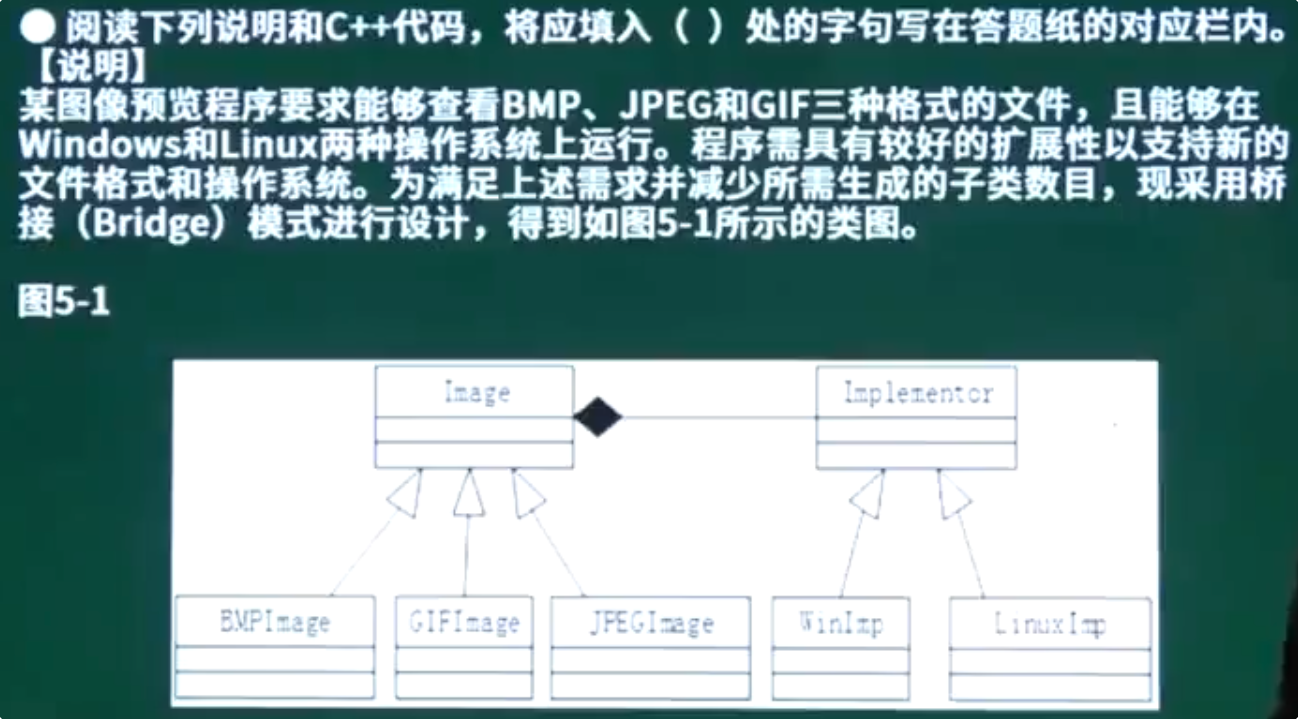
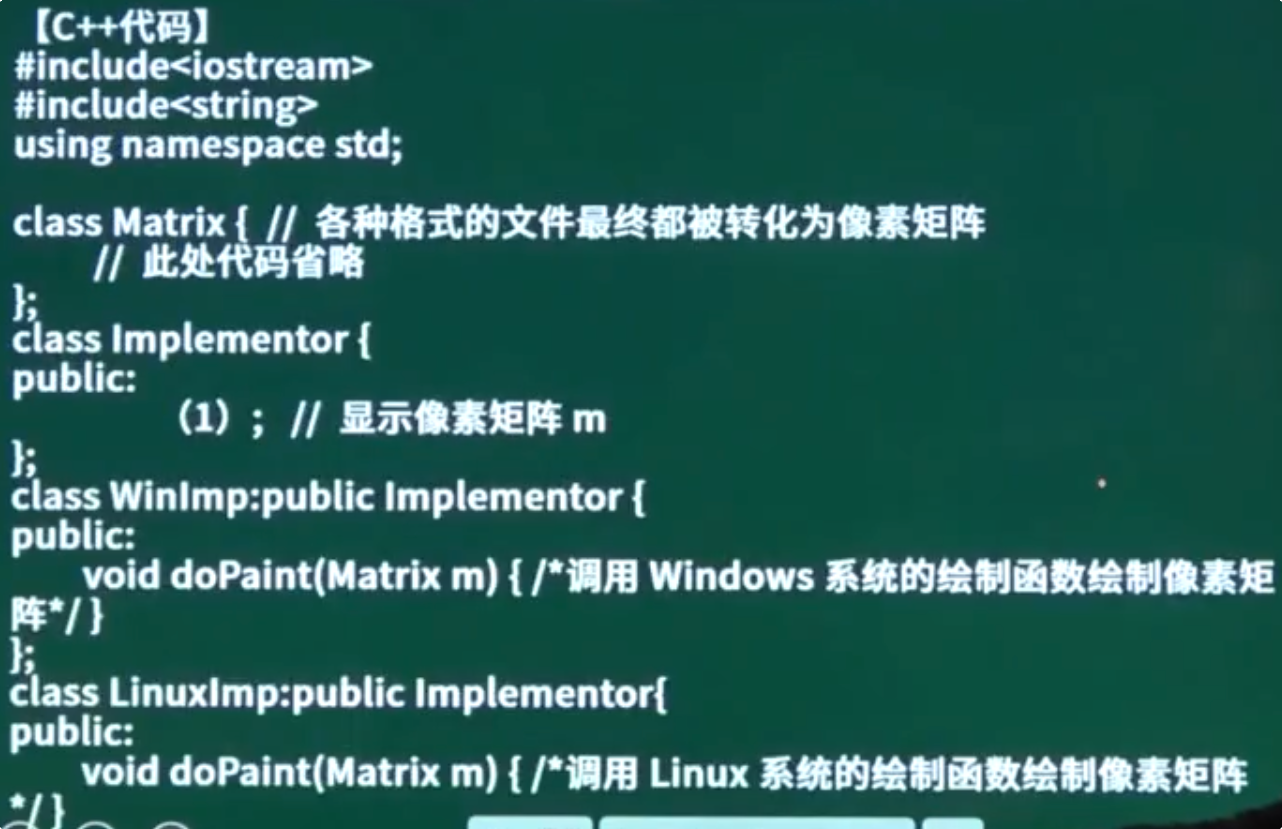
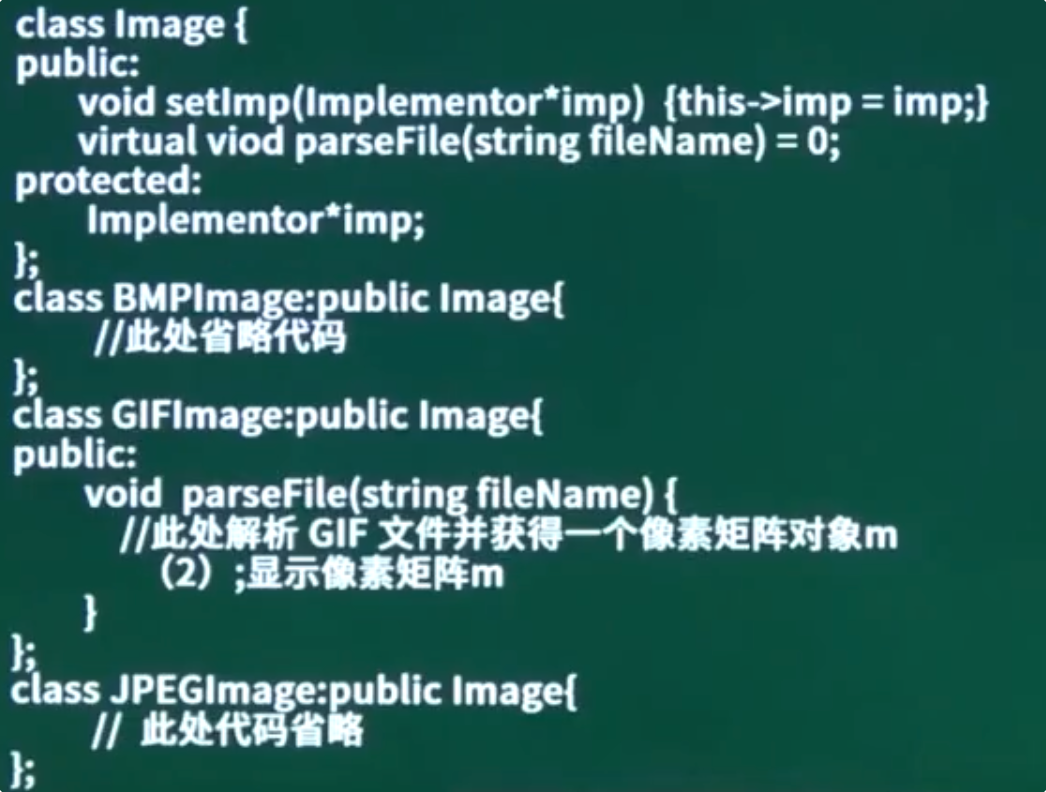
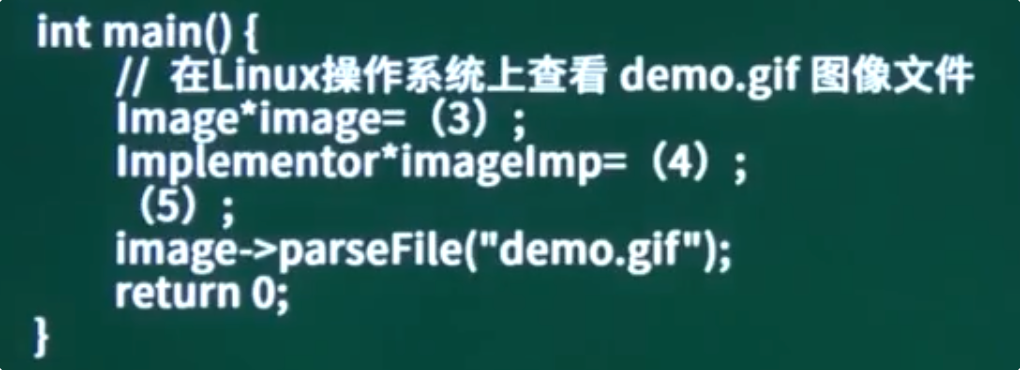
答:(1)virtual void doPaint(Matrix m)=0
(2)imp->doPaint(m)
(3)new GIFImage()
(4)new LinuxImp()
(5)image->setImp(imageImp)
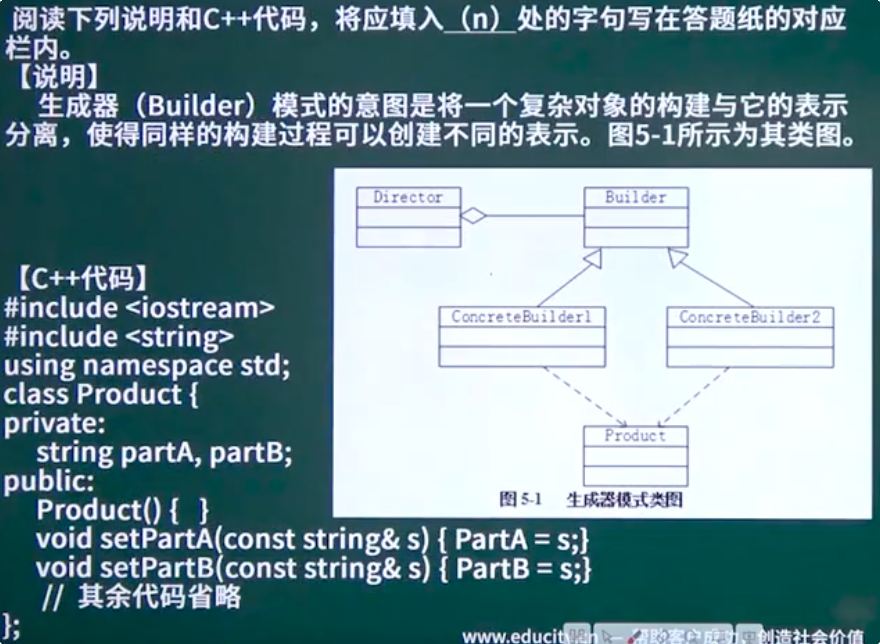
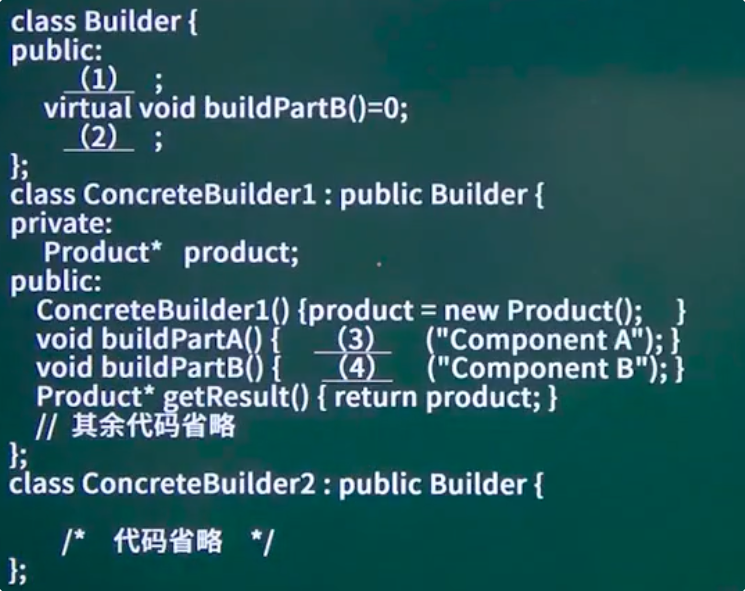
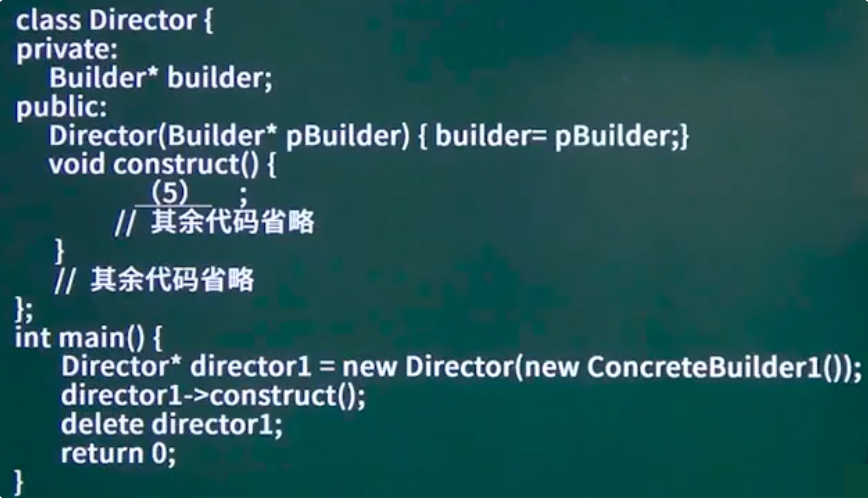
答:(1)virtual void buildPartA()=0
(2)virtual Product *getResult()=0
(3)product->setPartA
(4)product->setPartB
(5)builder->getResult()
builder->buildPartA();
builder->buildPartB();
Java版
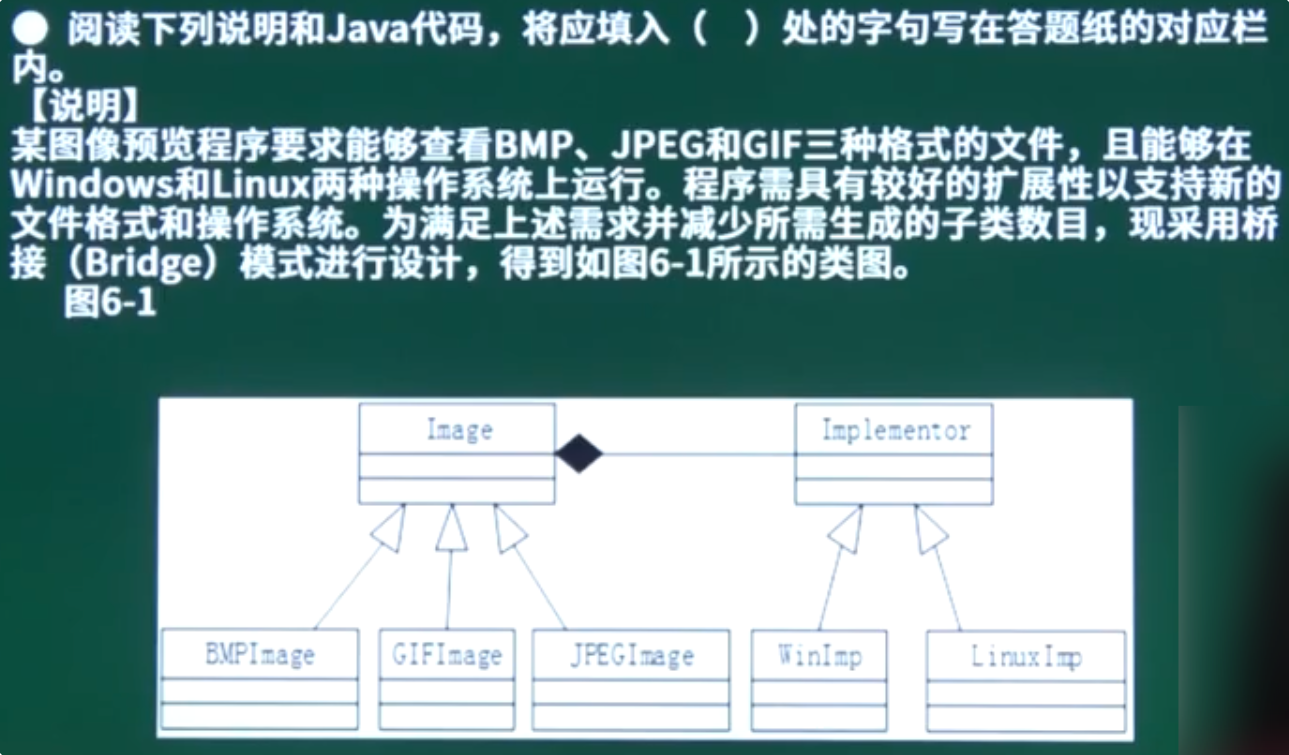
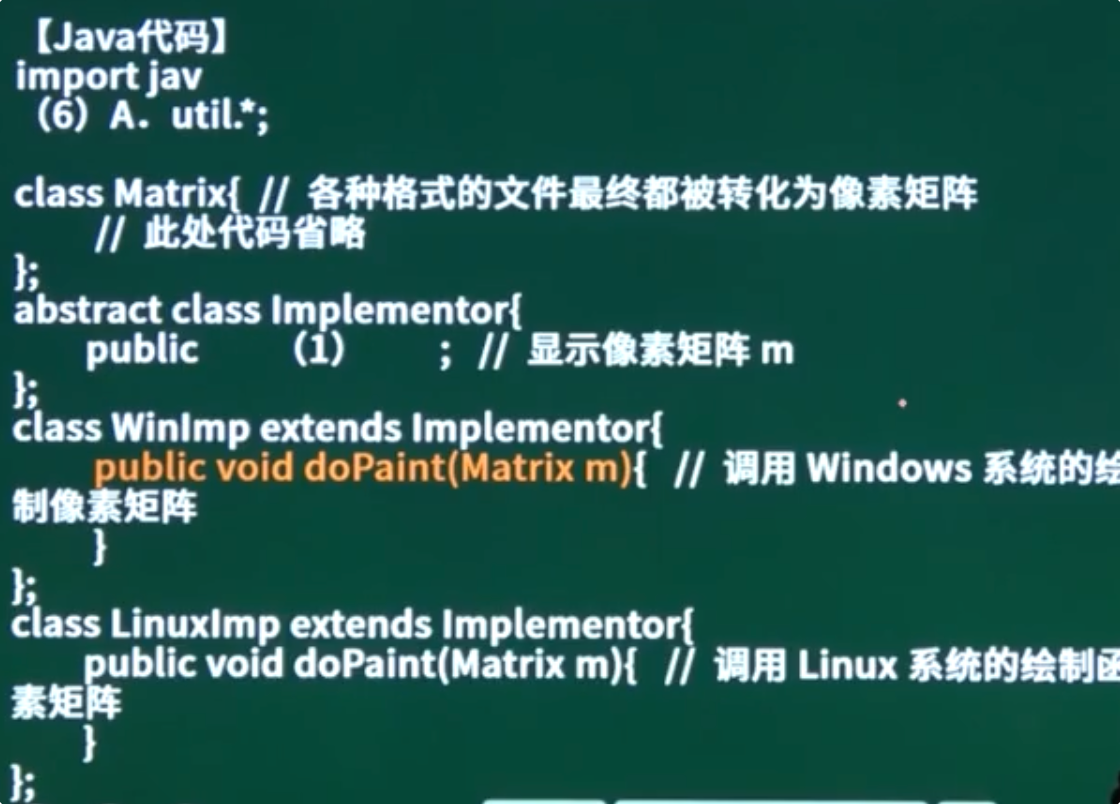
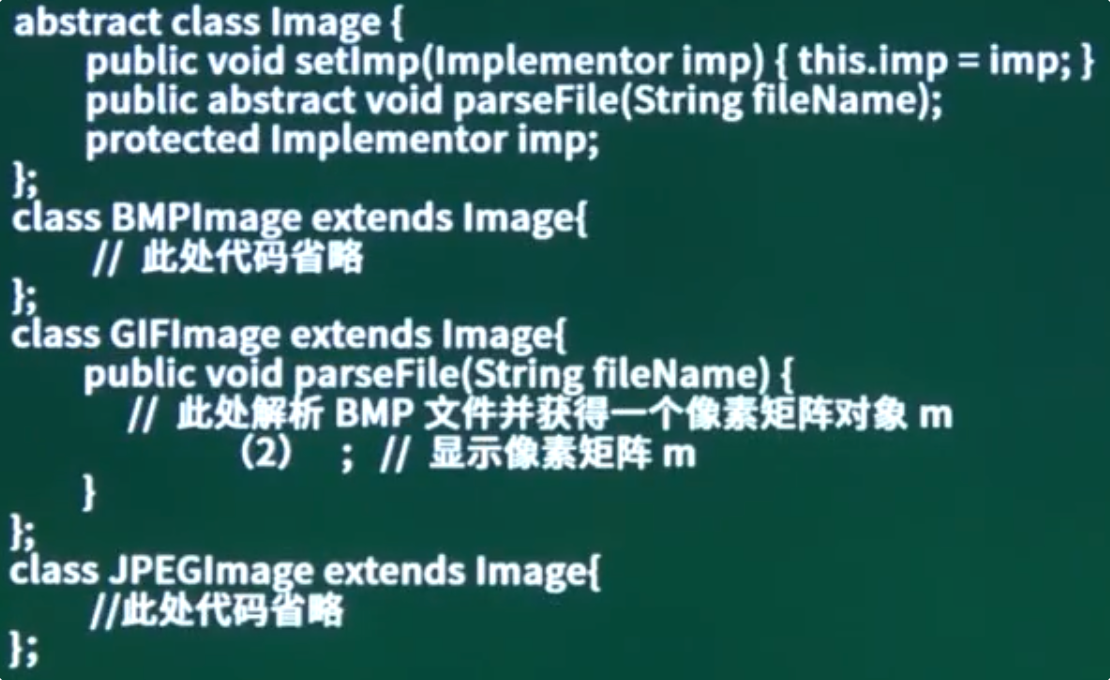
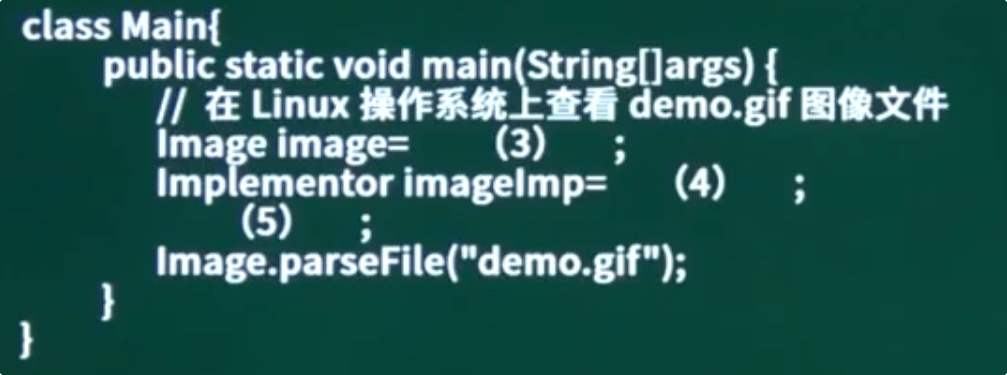
答:(1)abstract void doPaint(Matrix m)
(2)imp.doPaint(m)
(3)new GIFImage()
(4)new LinuxImp()
(5)image.setImp(imageImp)
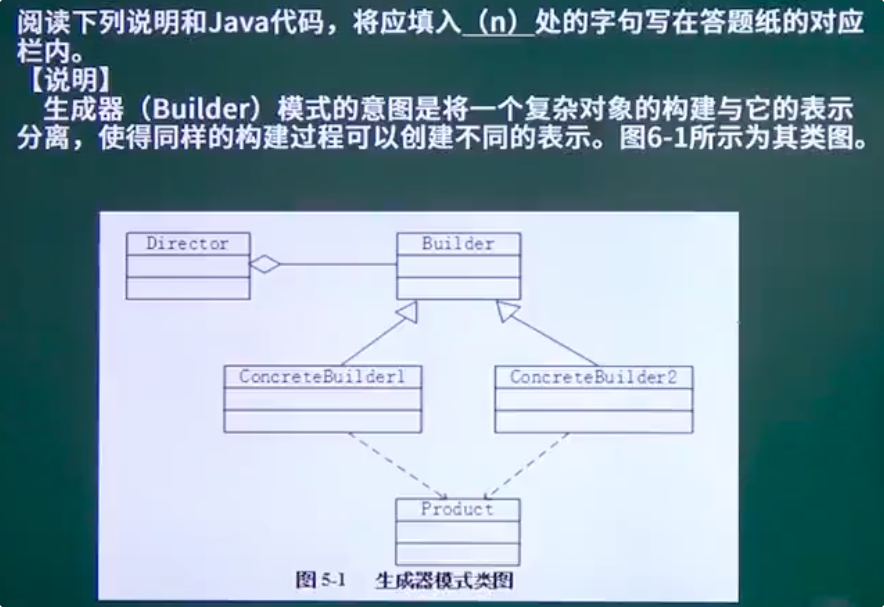
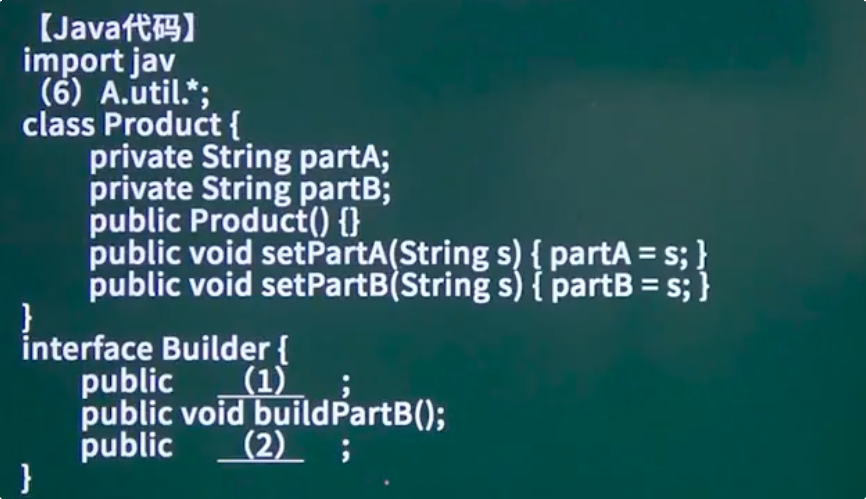
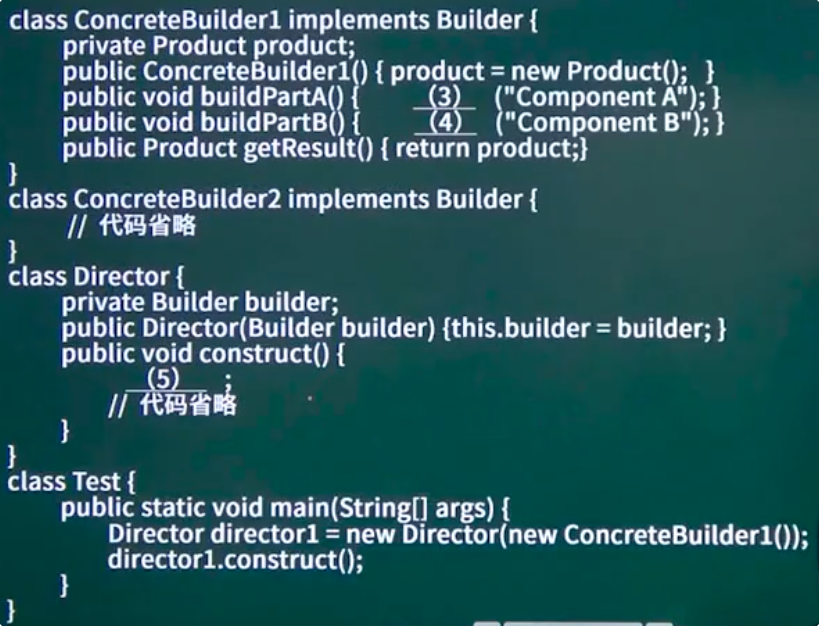
答:(1)void buildPartA()
(2)Product getResult()
(3)product.setPartA
(4)product.setPartB
(5)builder.getResult()
builder.buildPartA();
builder.buildPartB();
UML建模
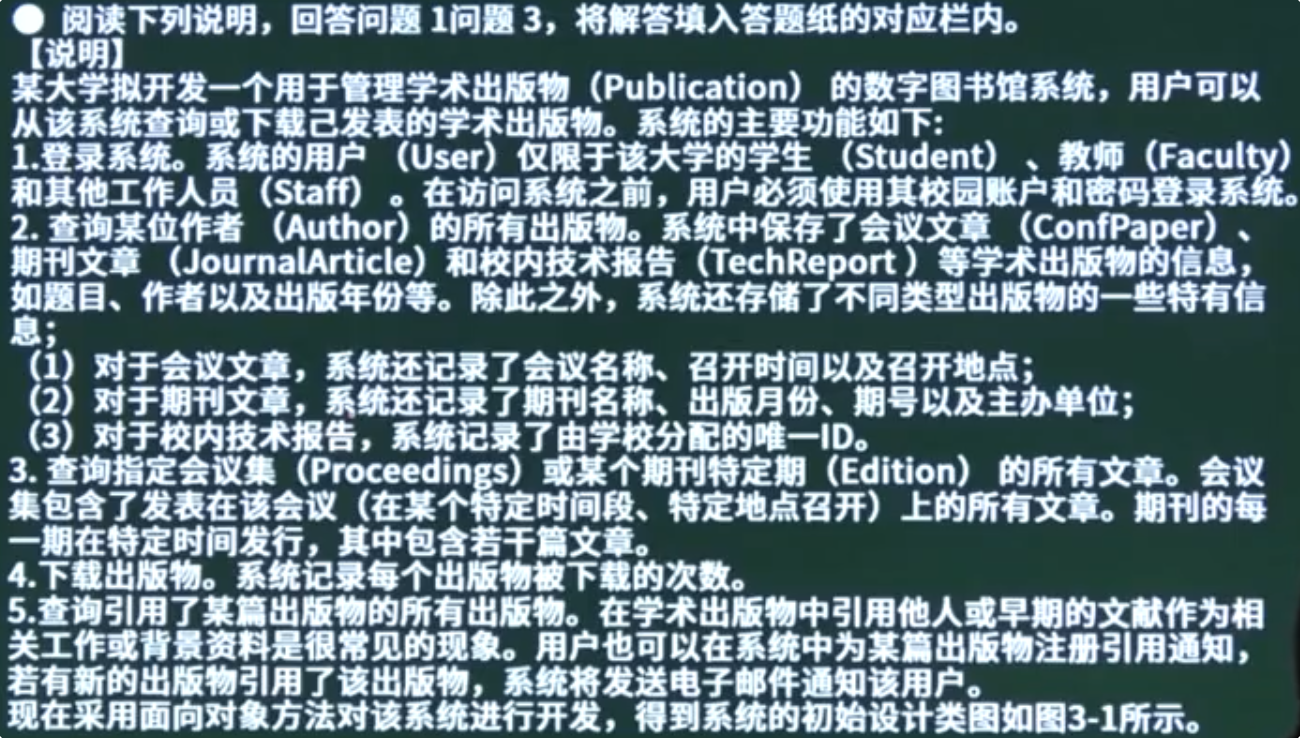
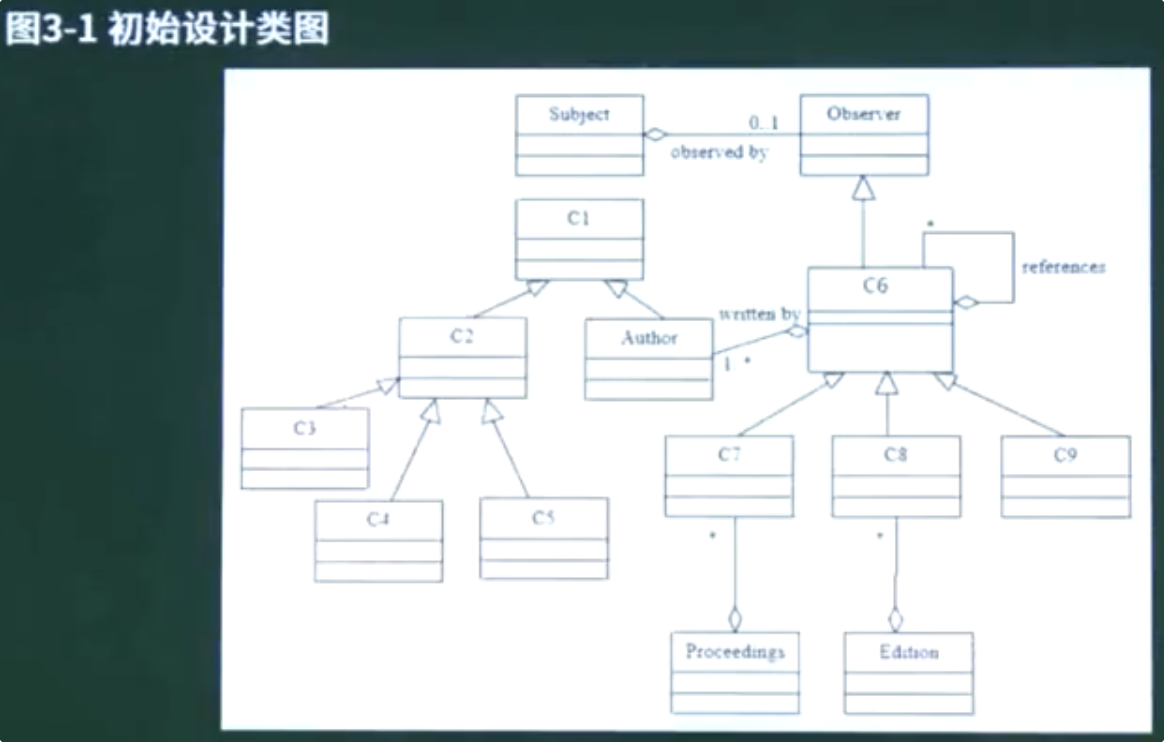
答:
问题1:
C1:Person C2:User C3:Student C4:Faculty C5:Staff C6:Publication C7:ConfPaper C8:JournalArticle C9:TechReport
问题2:
C6:题目、作者、出版年份
C7:会议名称、召开时间、召开地点
C8:期刊名称、出版月份、期号、主办单位
C9:ID
问题3:
题意可知,Subject-observer模式是一种设计模式,也称为观察者模式。它定义了一种一对多的依赖关系,让多个观察者对象同时监听某一个主题对象。
实现的是以下功能:
用户可以在系统中为某篇出版物注册引用通知,若有新的出版物引用了该出版物,系统将发送电子邮件通知该用户。
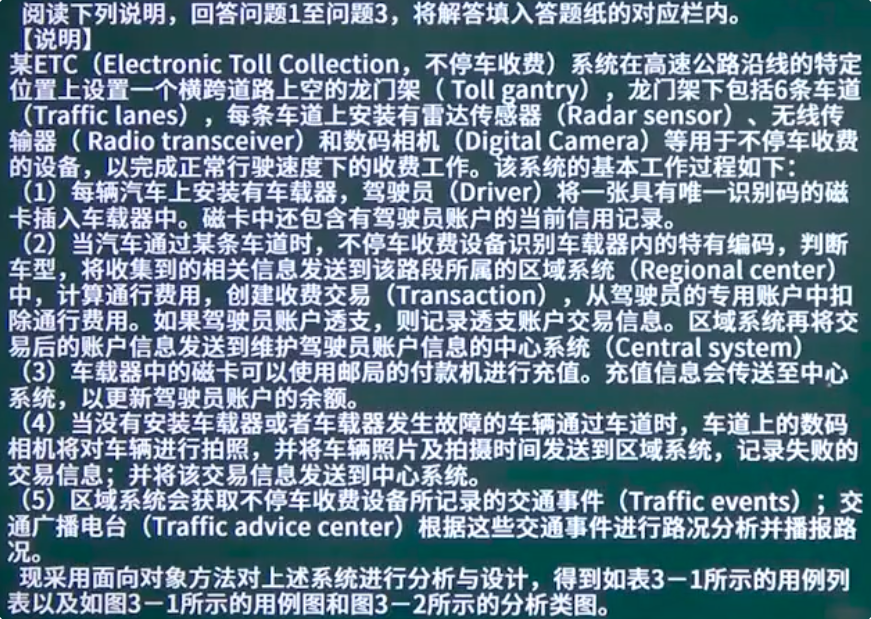
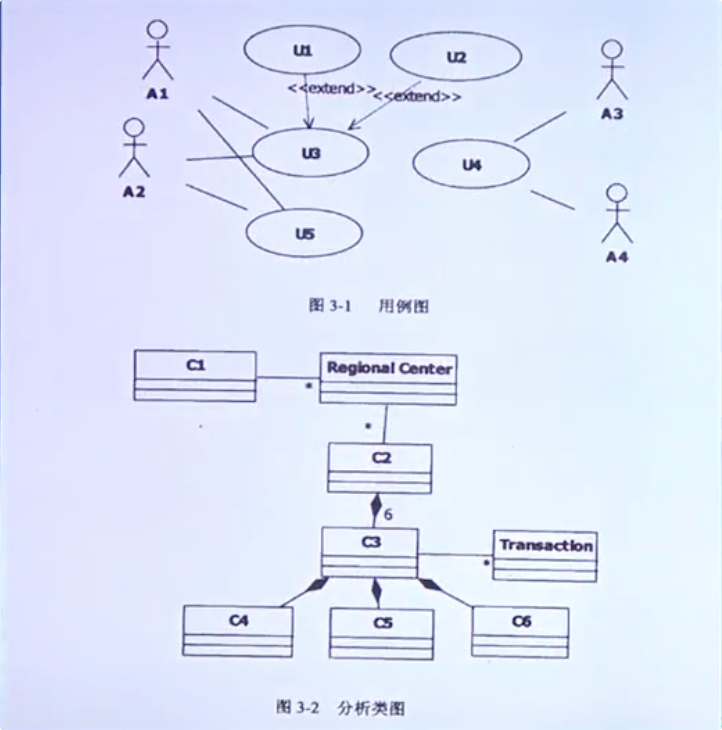
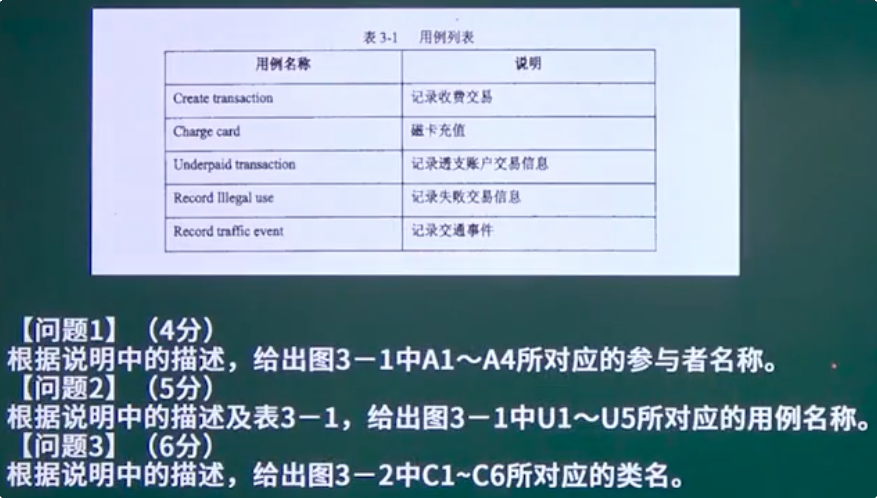
答:
问题1:
A1:中心系统,A2:驾驶员,A3:交通广播电台,A4:区域系统。
问题2:
U1:Underpaid transaction,U2:Record Illegal use,U3:Create transaction,U4:Record traffic event,U5:Charge Card。
问题3:
C1:Central system,C2:Toll gantry,C3:Traffic lanes,C4:Radio transceiver,C5:Digital Camera,C6:Radar sensor。
算法
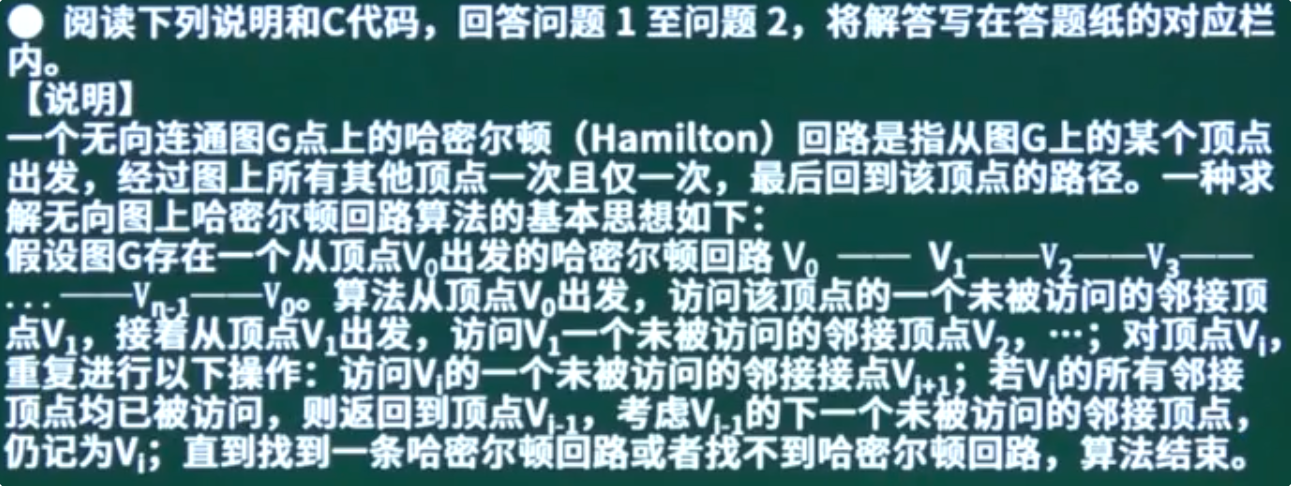
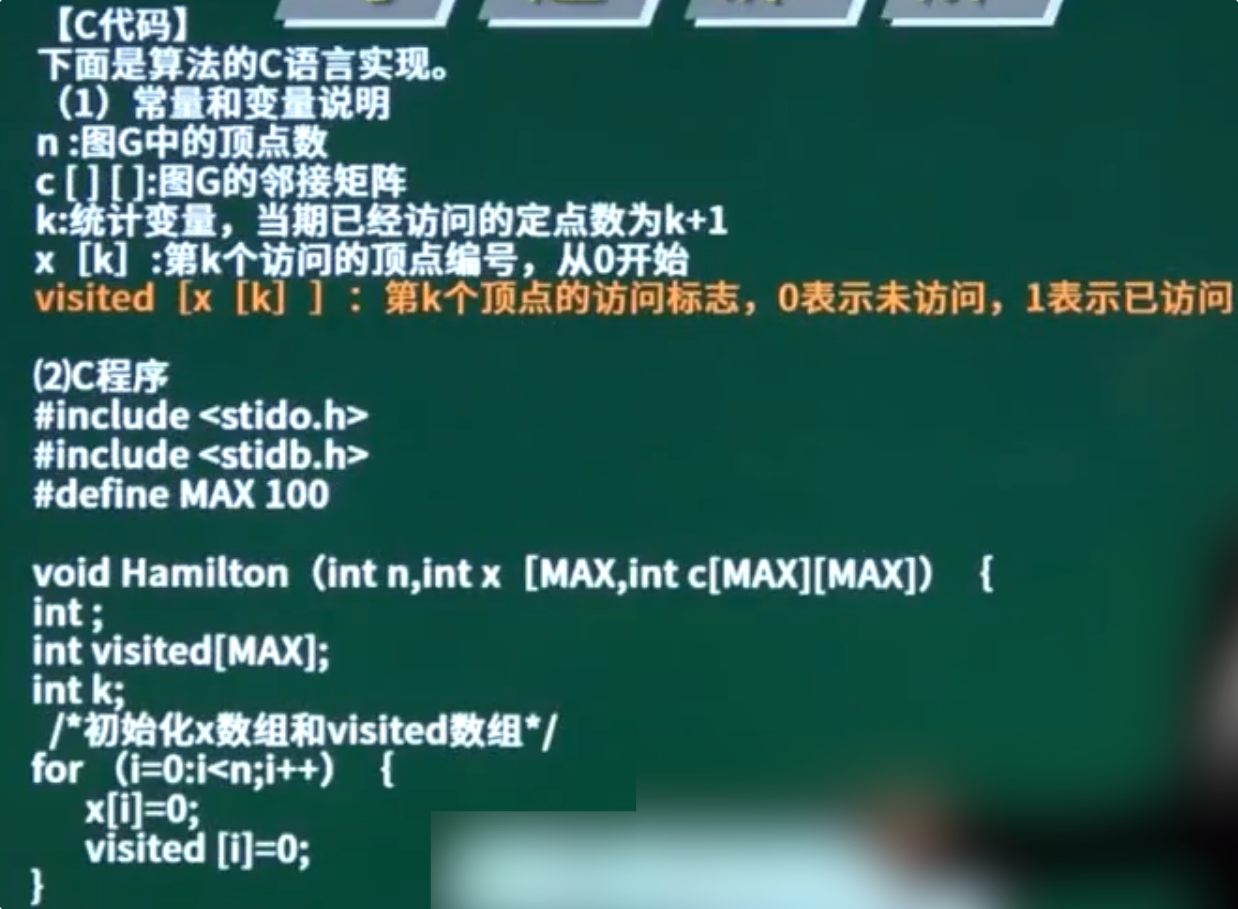
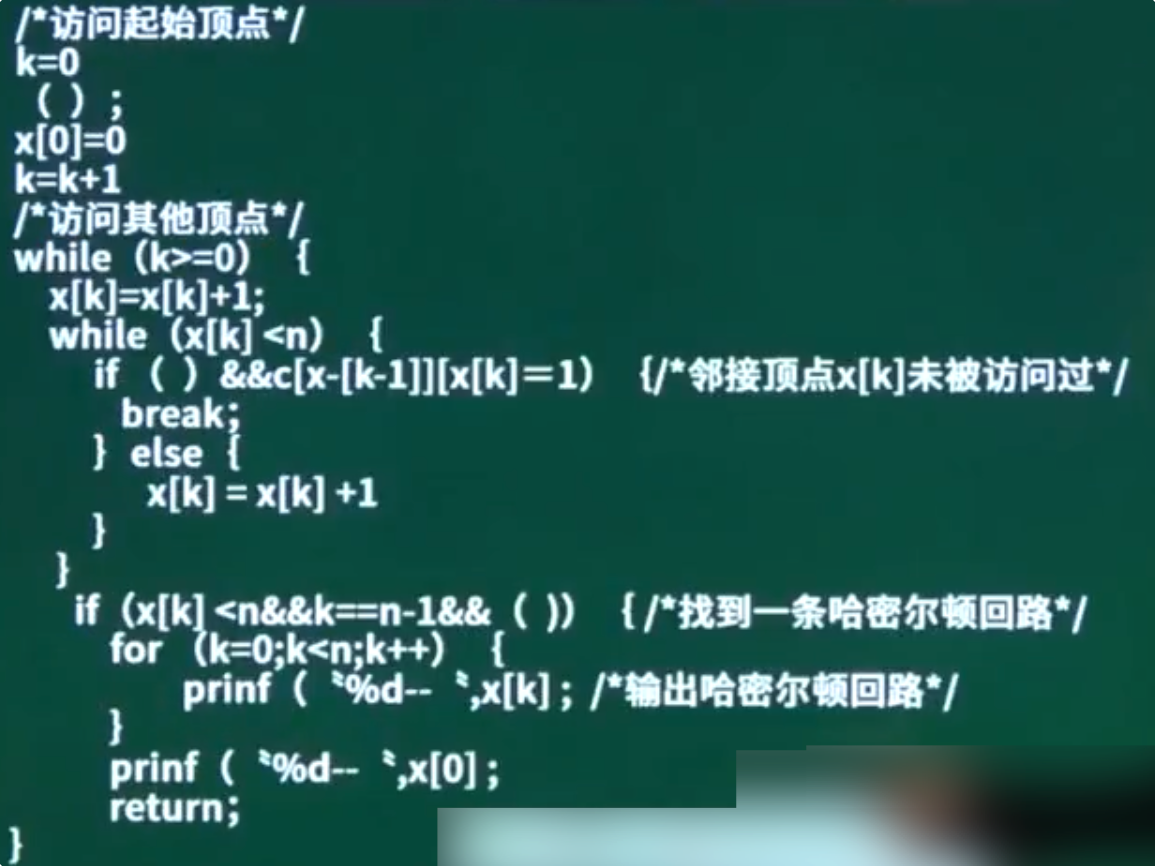
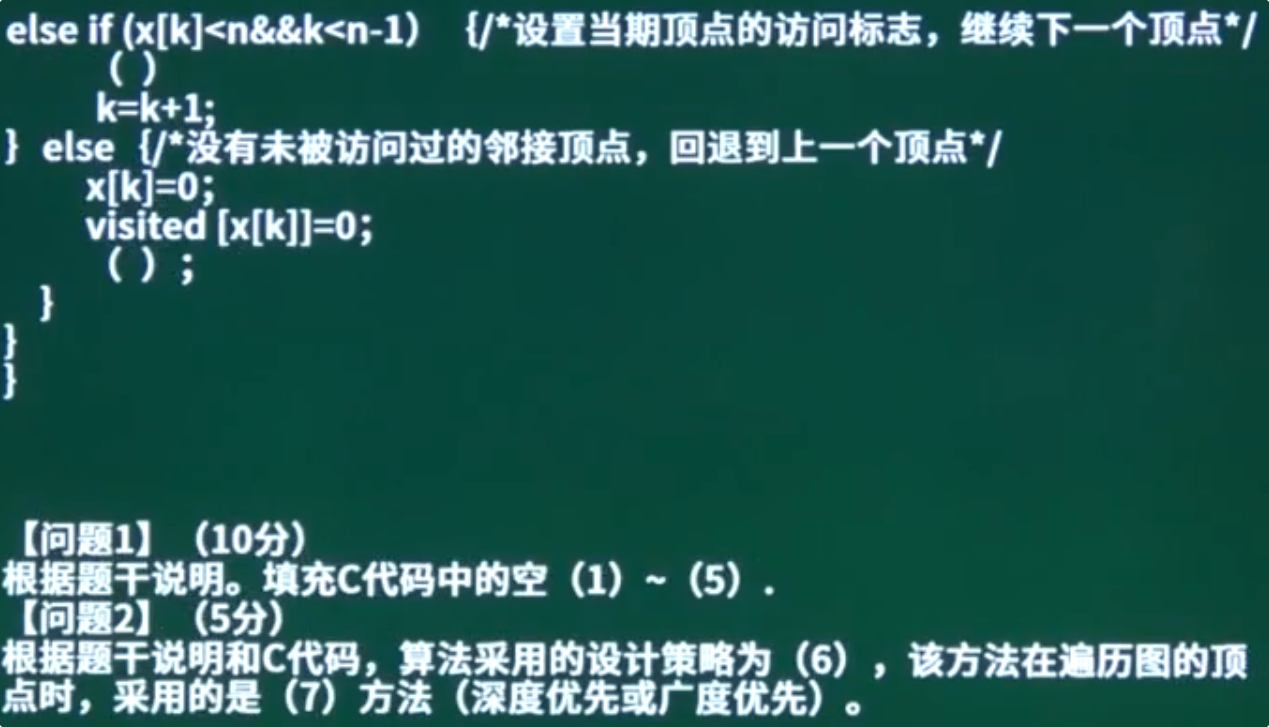
答:
问题1:
(1)visited[x[0]]=1
(2)visited[x[k]]==0
(3)c[x[k]][0]==1
(4)visited[x[k]]=1
(5)k=k-1
问题2:
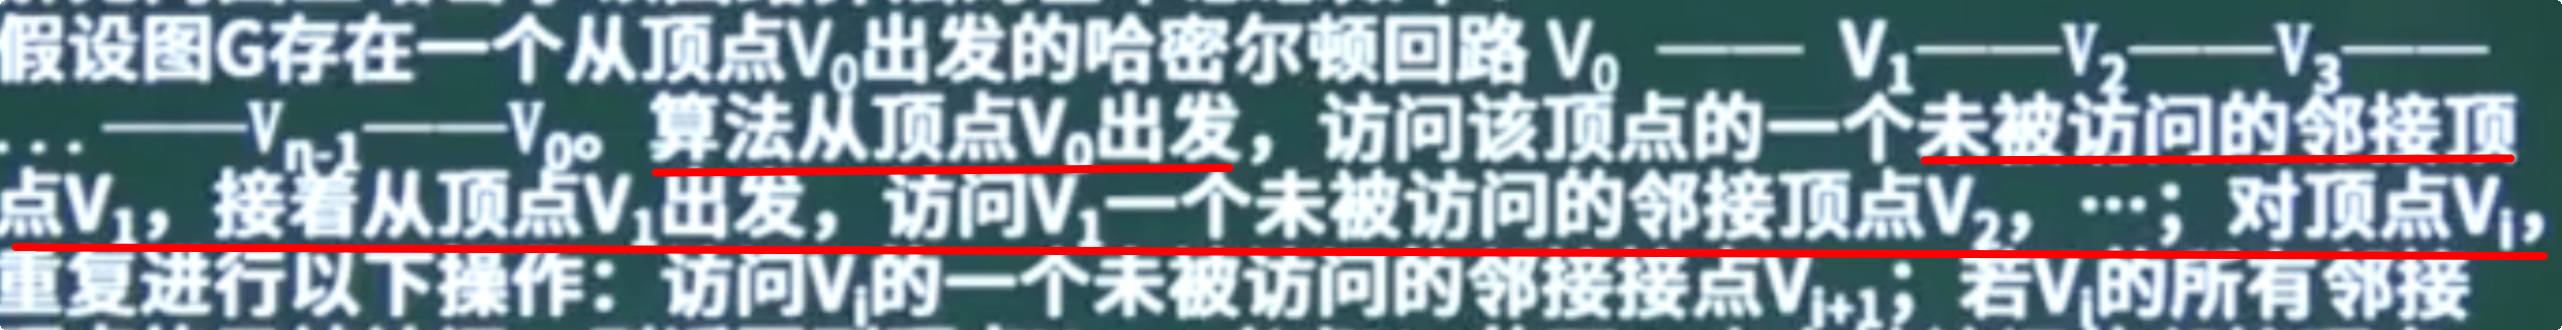
算法采用的是回溯法
由此话可知,该方法遍历图的顶点采用的是深度优先方法。
数据流图
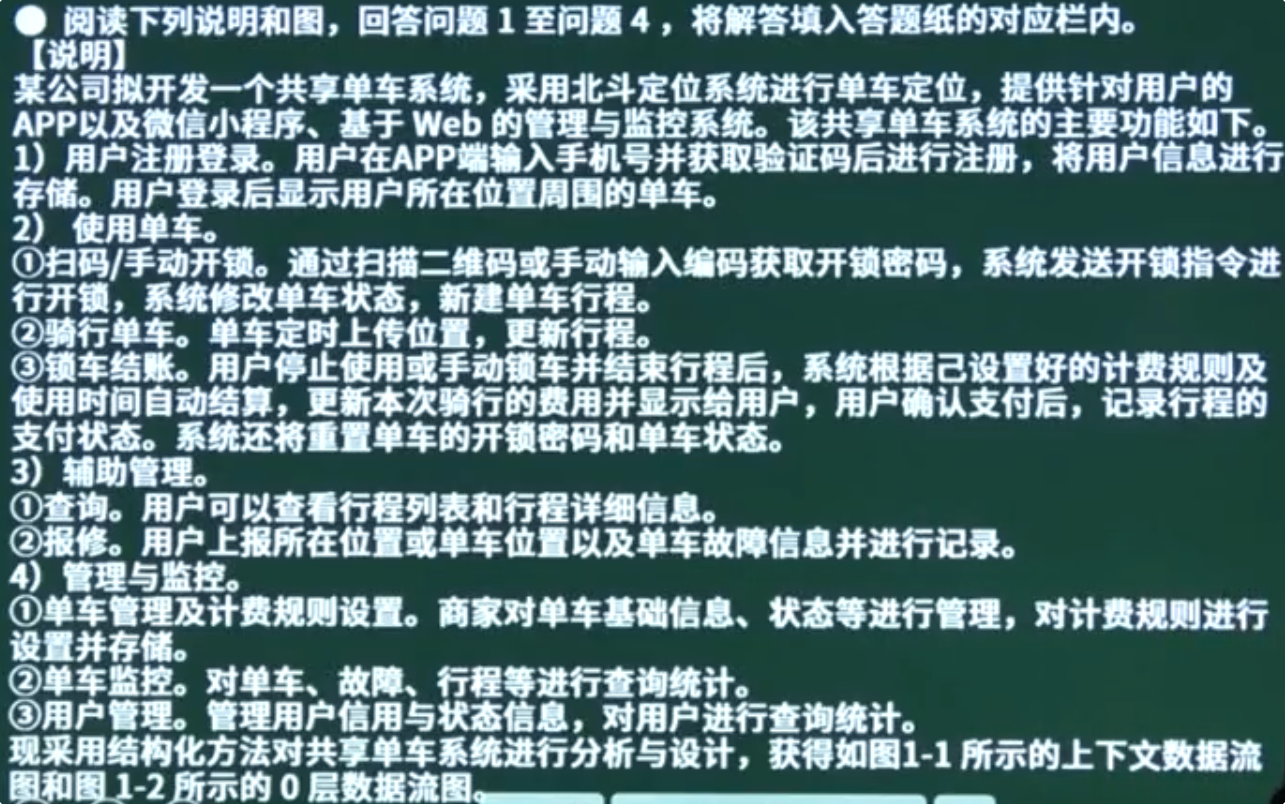
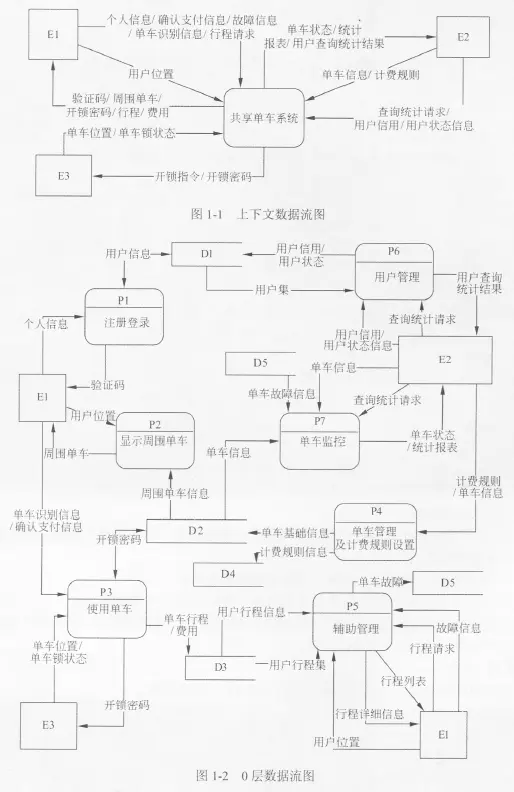
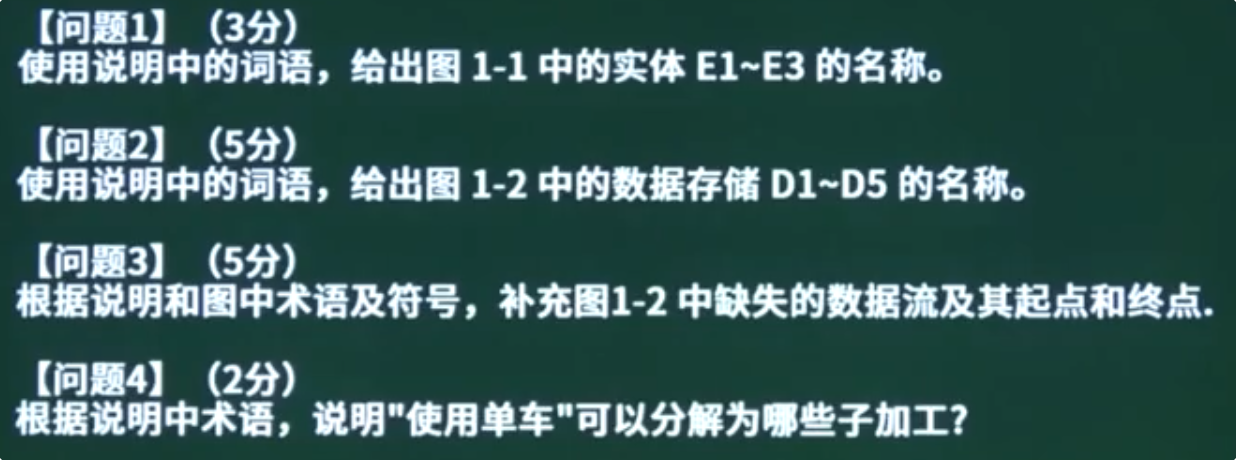
答:
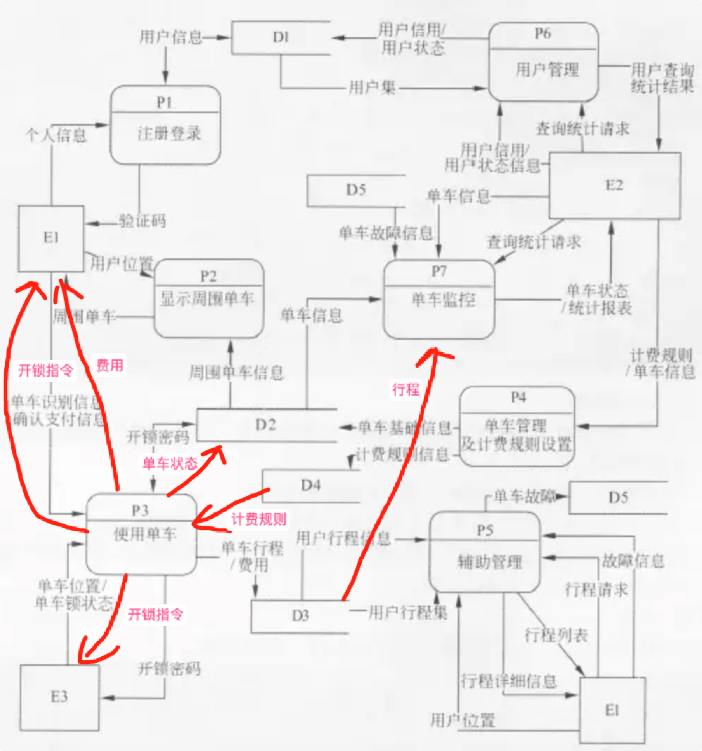
问题1:
E1:用户
E2:商家
E3:单车
问题2:
D1:用户信息存储
D2:单车信息表
D3:单车行程信息表
D4:计费规则存储
D5:单车故障信息记录表
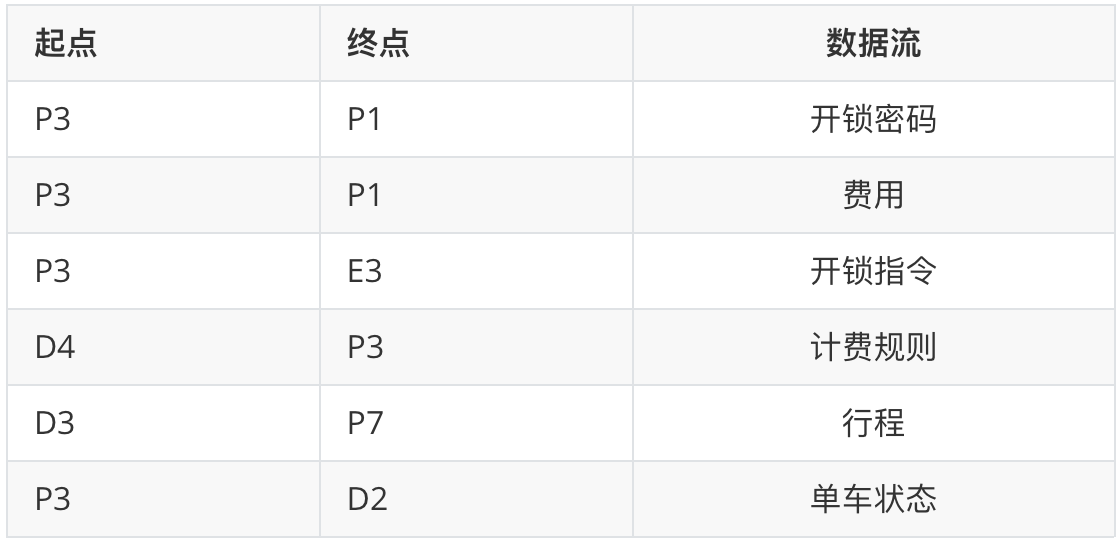
问题3:
问题4:
扫码/手动开锁,更新行程,锁车结账
(或者:扫码/手动开锁,更新行程,锁车,计算费用,重置开锁密码,用户确认支付)。