记录一次服务器磁盘爆了的问题
AI 摘要鱼粮不足,AI 今天先歇着 · 正文在下面
问题
今天想打开后台写一篇博客,发现抛出异常了,于是查看线上日志,发现了错误异常日志,如下:
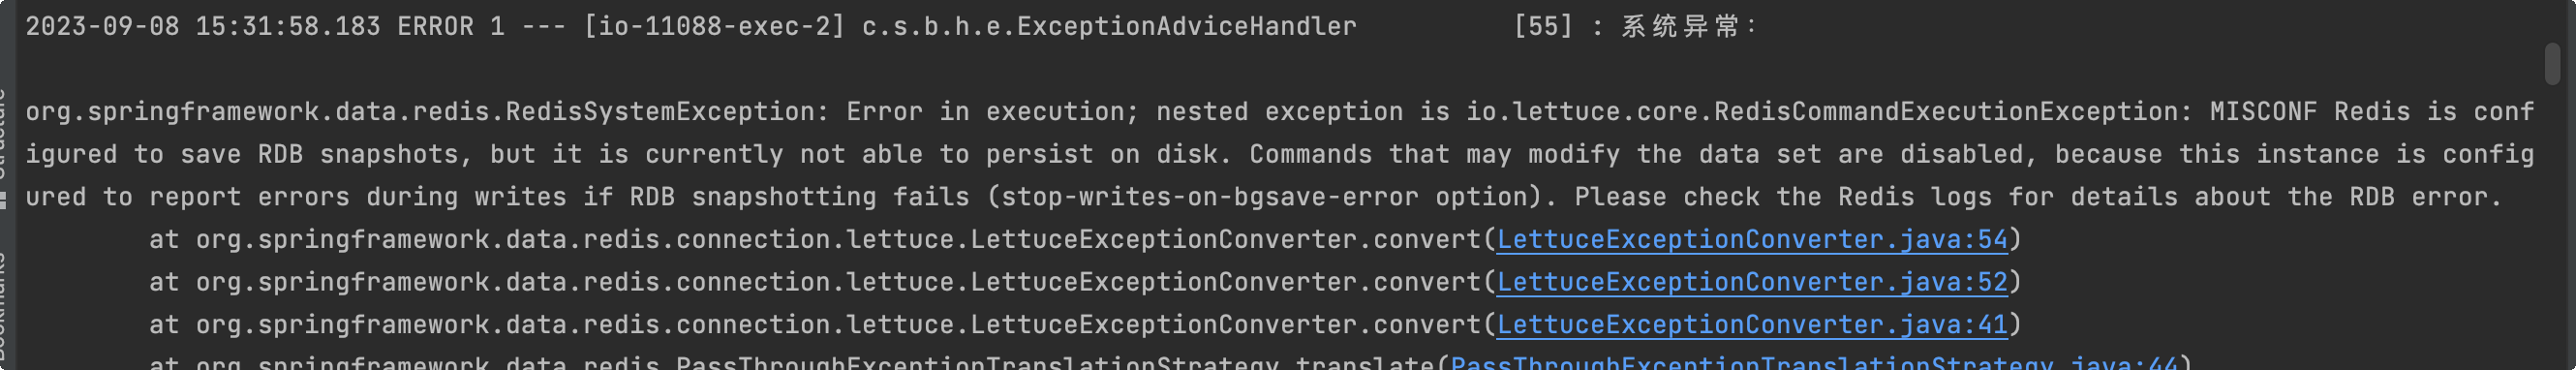
这表示redis的持久化出现了问题,一般是磁盘不够,但我这台服务器上的项目没几个业务使用到redis,于是往下查看日志,发现还有mysql的错误日志
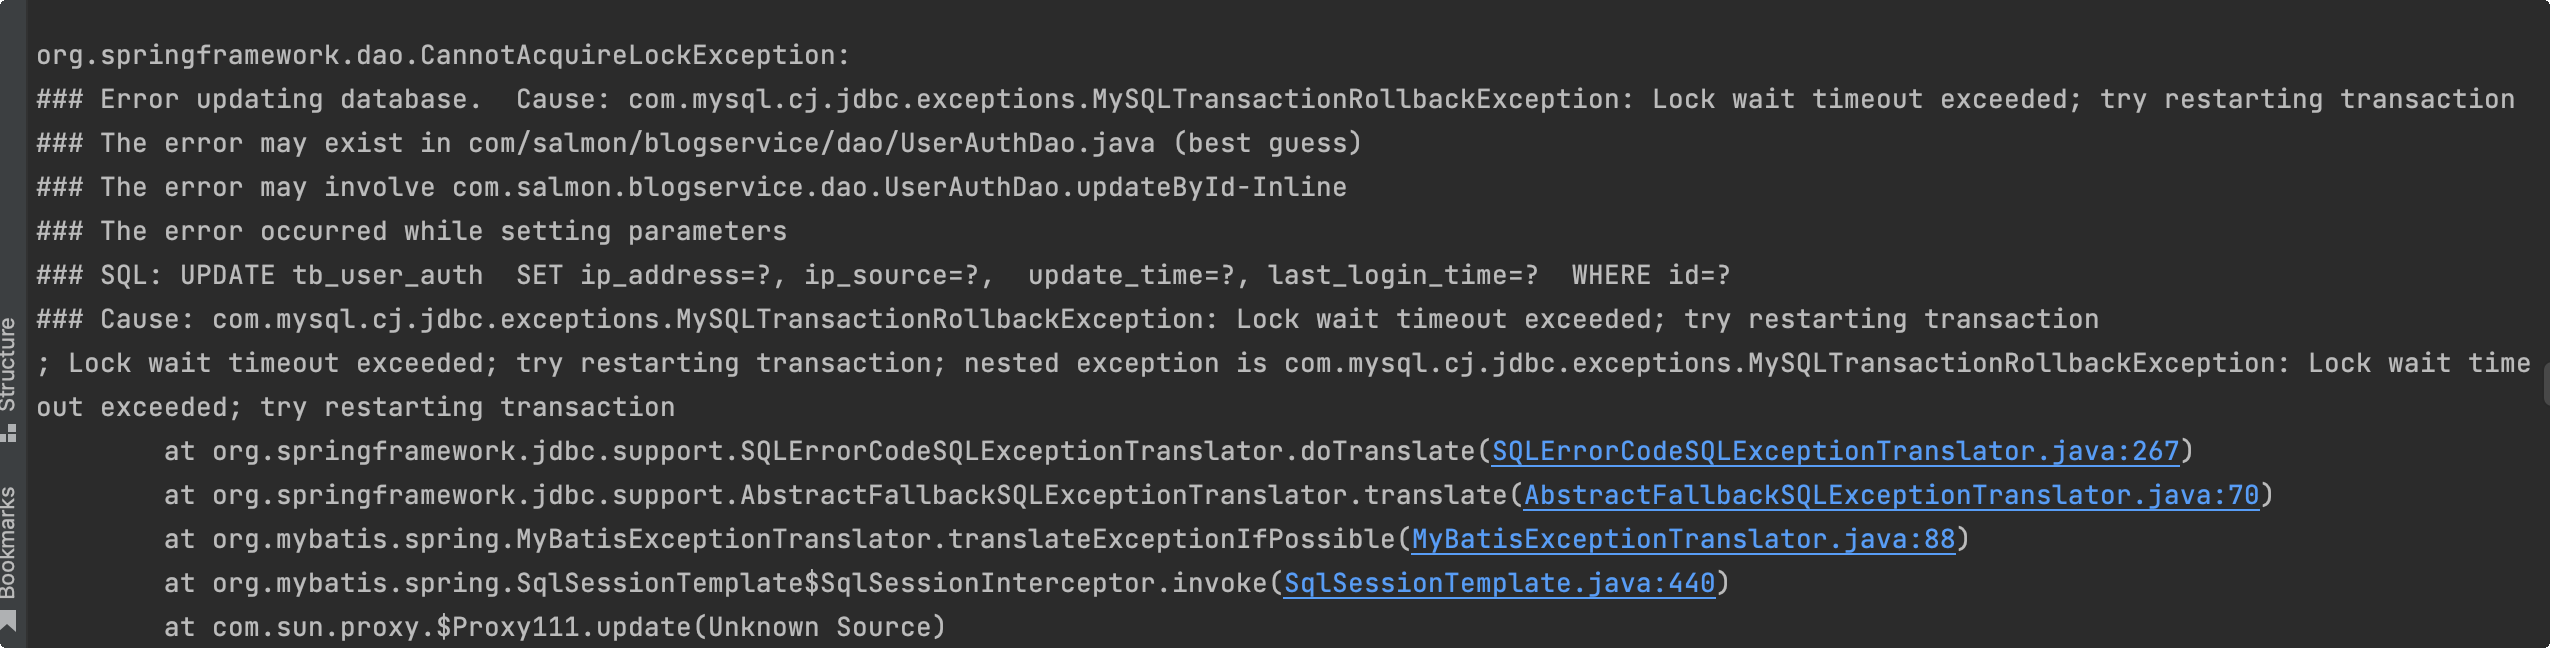
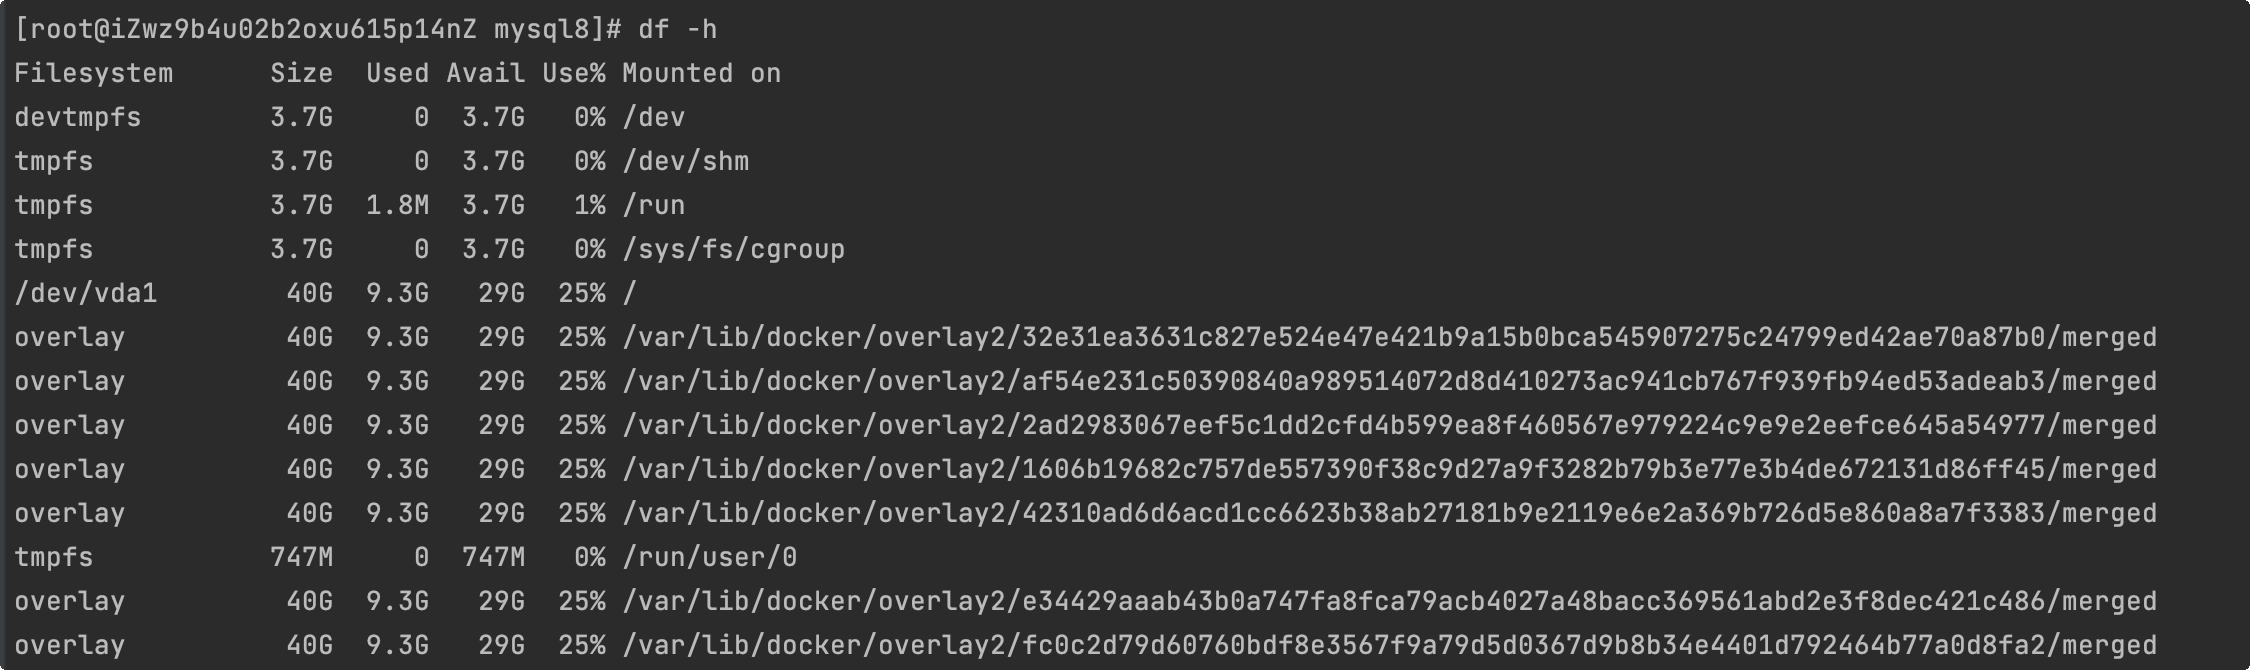
这个错大致是执行事务超时了,为什么会超时呢?昨天还好好的,想了下后,可能磁盘空间不足了,导致mysql无法写入bin_log日志,输入以下命令查看内存占用情况
sh
df -h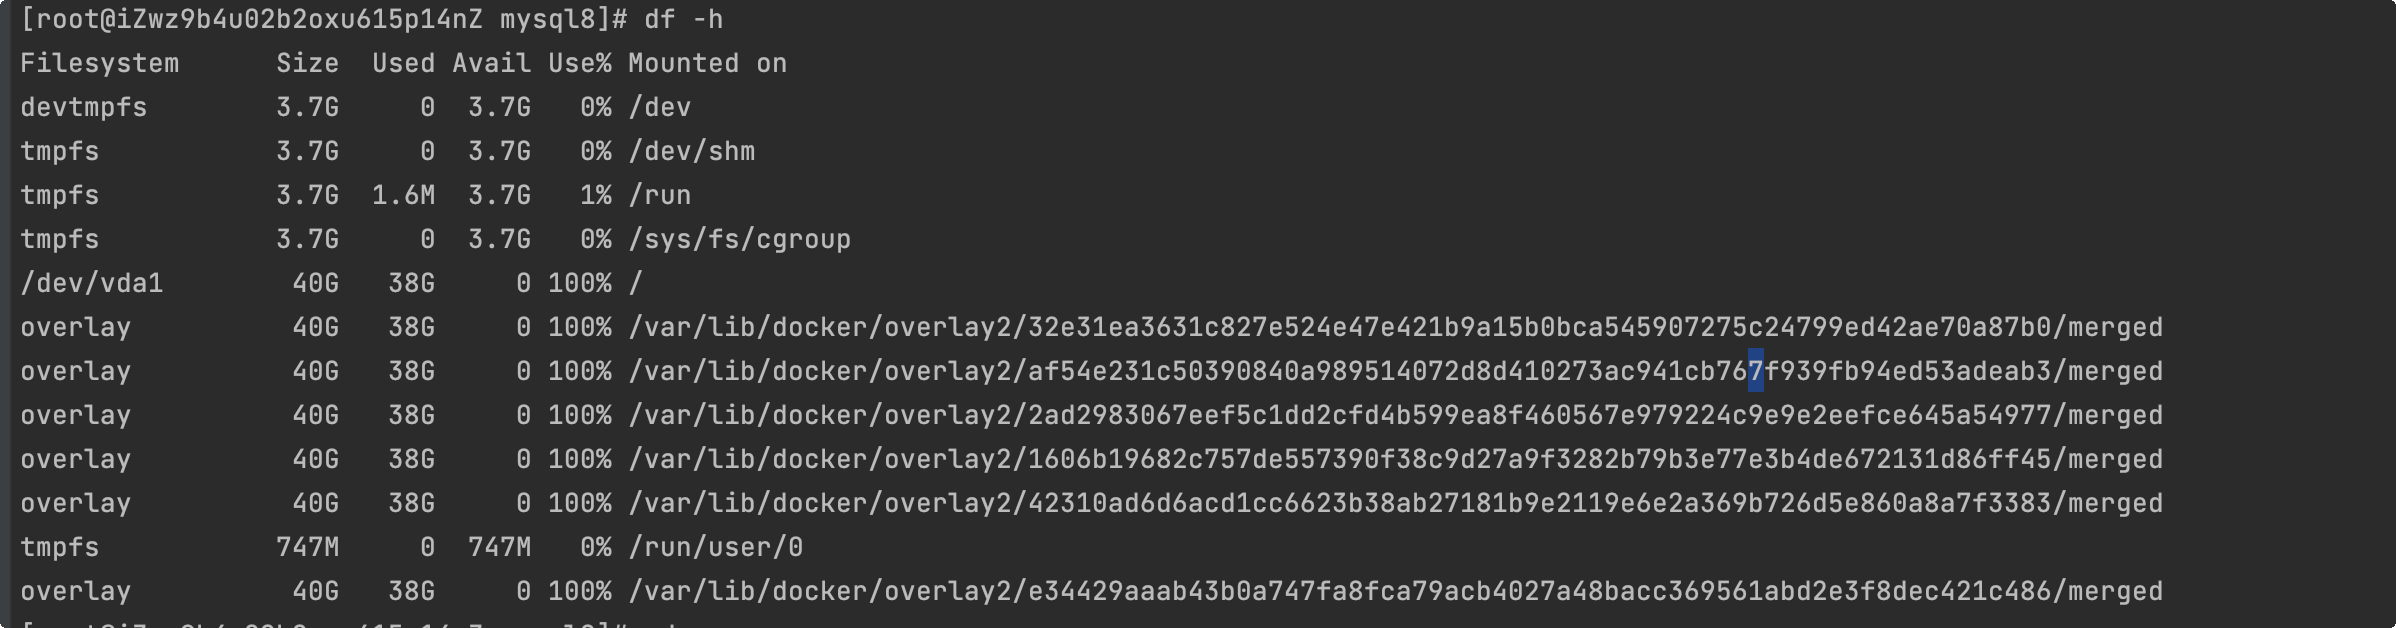
可以看到内存直接爆了,于是我查了下当前磁盘占用最多的数据,我本质猜测也是mysql的数据,毕竟这是我docker里操作最多的容器了,输入以下命令查看内存占用排名,mysql占据很多
sh
du -hs * | sort -rh | head -n 10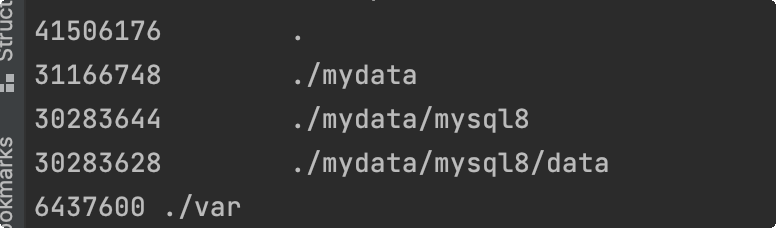
ok,定位到了是mysql的data文件占用太大,一查发现是bin_log日志占用内存过多
解决
我们进入mysql客户端,如果没有恢复数据的需要,可以直接删除全部bin_log,输入以下命令即可
sql
PURGE MASTER也可以指定某一天时间之前的bin_log删除,如下:
sql
PURGE MASTER LOGS BEFORE '2023-09-01 11:11:11';在my.cnf中增加指令,进行删除七天前的bin_log日志
sh
#设置自动清理bin_log日志
expire_logs_days=7
再此查看磁盘信息,可以看到磁盘占用正常啦~
评论
0 条—
还没有评论,来说第一句