记录一次 ClickHouse 查询从 2s 降低到 0.2s
AI 摘要salmon-ai
本文详细解析了一次 ClickHouse 慢 SQL 优化实践:从原始 2.
前言
在近期的业务实践中,我针对 ClickHouse 的慢 SQL 进行了排查和优化。这里我们将通过一个真实案例,解析 SQL 性能优化的过程,并总结优化策略,希望为有类似需求的同学提供参考。
原来的慢 SQL
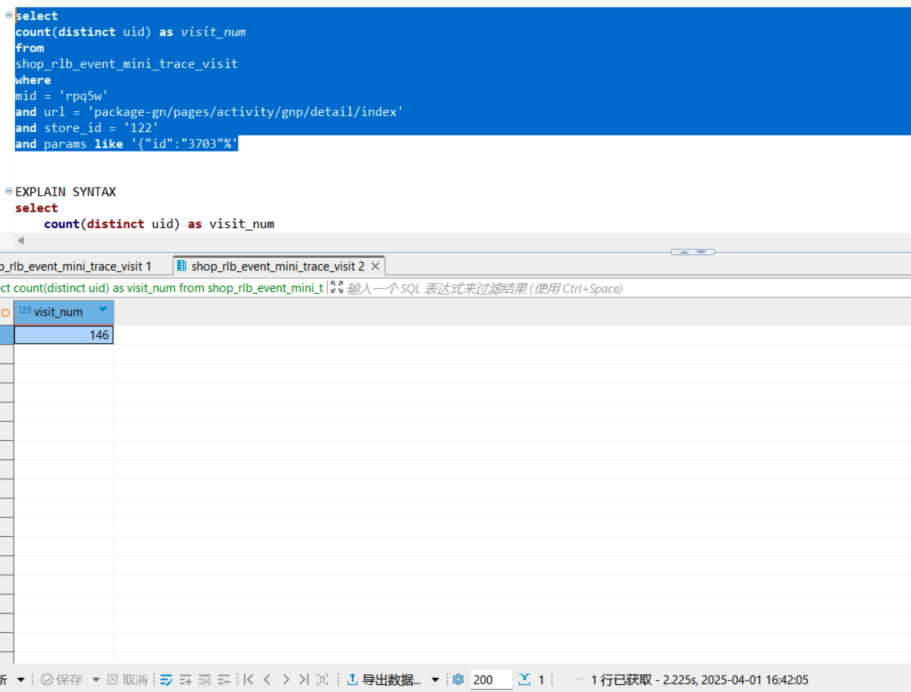
我们需要统计某个页面的访问用户数,原始 SQL 如下:
sql
select count(distinct uid) as visit_num
from shop_rlb_event_mini_trace_visit
where mid = 'rpq5w'
  and url = 'package-gn/pages/activity/gnp/detail/index'
  and store_id = '122'
  and params like '{"id":"3703"%';
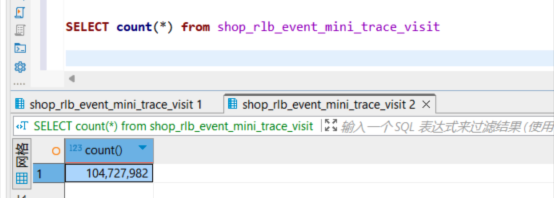
在正式环境中,该表数据量超过 1 亿行,执行上述 SQL 查询耗时约 2.2s。
调优过程
调优第一步:调整查询条件顺序
- 过程:调整
WHERE查询条件顺序和使用PREWHERE查看效果 - 结论:调整是有效果的,时间稳定在1.2s左右
sql
select count(distinct uid) as visit_num
from shop_rlb_event_mini_trace_visit
    PREWHERE params like '{"id":"3703"%'
    and mid = 'mnkfg'
    and store_id = '122'
    and url = 'package-gn/pages/activity/gnp/detail/index'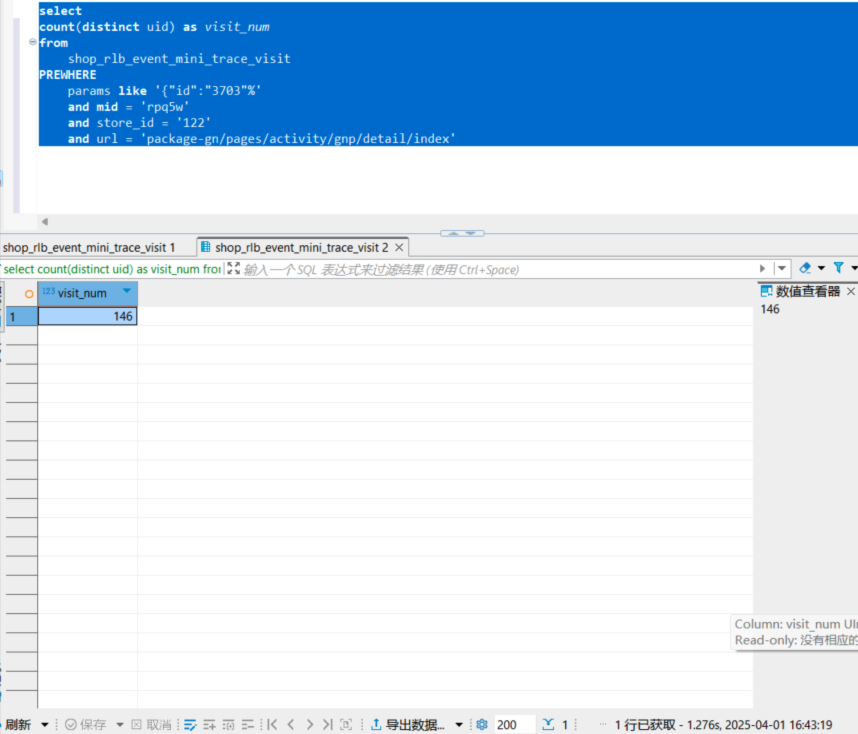
原理:
ClickHouse 在查询时,通常会先应用 PREWHERE 语句筛选出符合条件的数据,再执行 WHERE 过滤。合理调整条件顺序,并利用 PREWHERE,可以减少不必要的数据读取,加快查询速度。
调优第二步:查看执行计划
- 过程:使用执行计划,继续深入分析
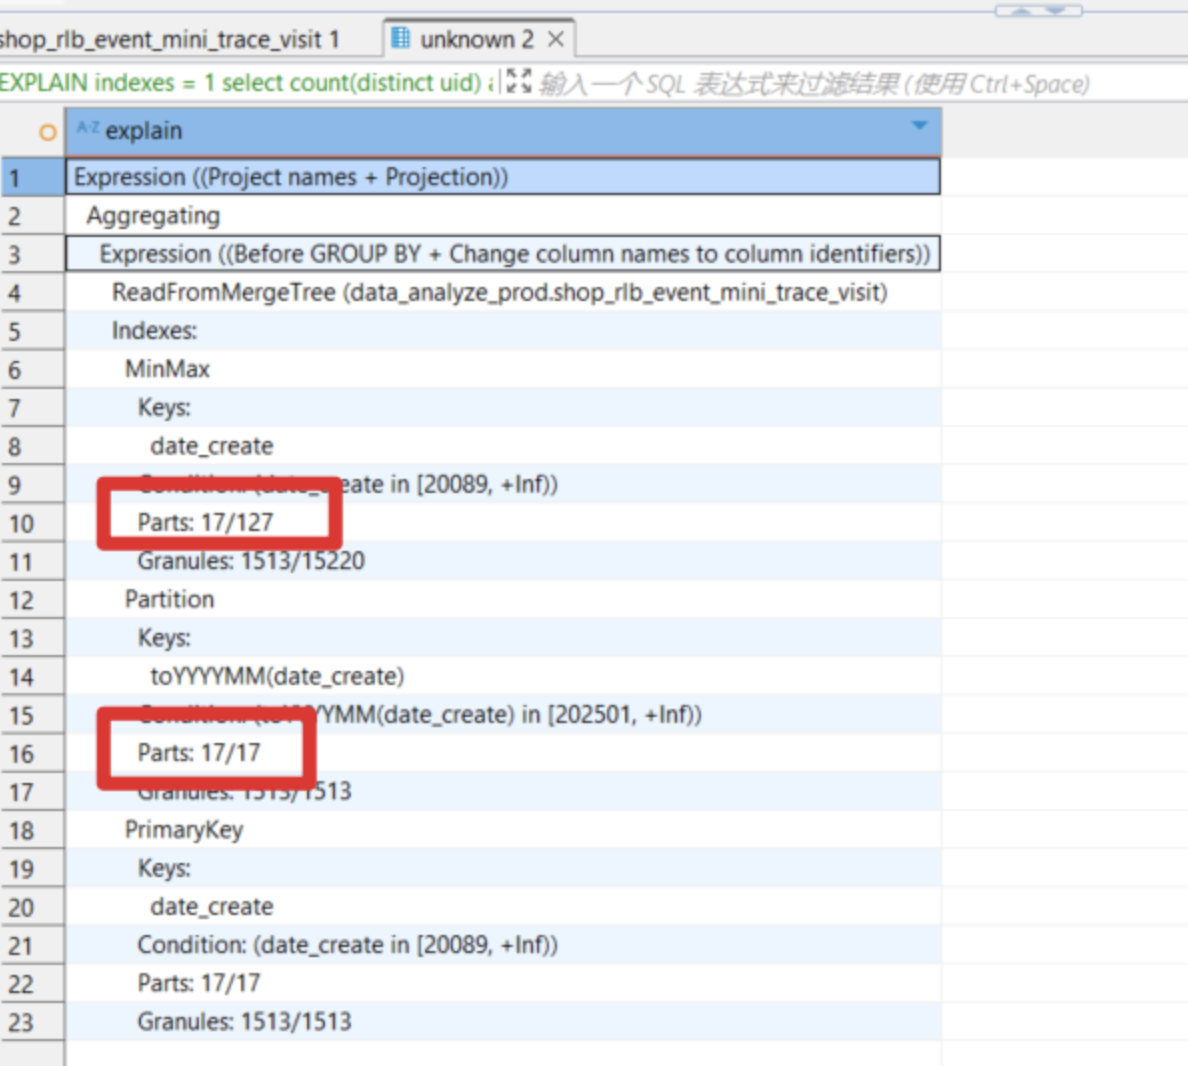
- 结论:可以看出,查询了127个分区。那么减少分区是不是就可以降低查询时间?答案是肯定的。
那么要如何减少分区查询?回归业务需求,即这条查询语句,如果可以传入时间,那么就可以减少分区的查询(我们之前已对数据表进行了全库的表分区,毋庸置疑所有表都是有按时间分区的,该表也不例外)我们先查看建表 SQL,可以看到确实是通过时间进行分区的。
sql
CREATE TABLE data_analyze_uat.shop_rlb_event_mini_trace_visit
(
    `date_create` Date,
    `mid` String,
    `url` String COMMENT '页面路径',
    `uid` String,
    `gmt_create` String,
    `store_id` String COMMENT '门店id',
    `store_number` String COMMENT '门店编号',
    `store_name` String COMMENT '门店名',
    `params` String COMMENT '参数',
    `scene` String COMMENT '场景值',
    `trace_id` String COMMENT '访问链路id',
    `model` String COMMENT '设备信息',
    `network_type` String COMMENT '网络信息',
    `wx_version` String COMMENT '平台/微信 版本信息',
    `mobile` String
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(date_create)
ORDER BY (date_create, gmt_create)
SETTINGS index_granularity = 8192使用执行计划,进行分析
sql
EXPLAIN indexes = 1
select count(distinct uid) as visit_num
from shop_rlb_event_mini_trace_visit
    PREWHERE
    params like '{"id":"3703"%'
        and mid = 'rpq5w'
        and store_id = '122'
        and url = 'package-gn/pages/activity/gnp/detail/index';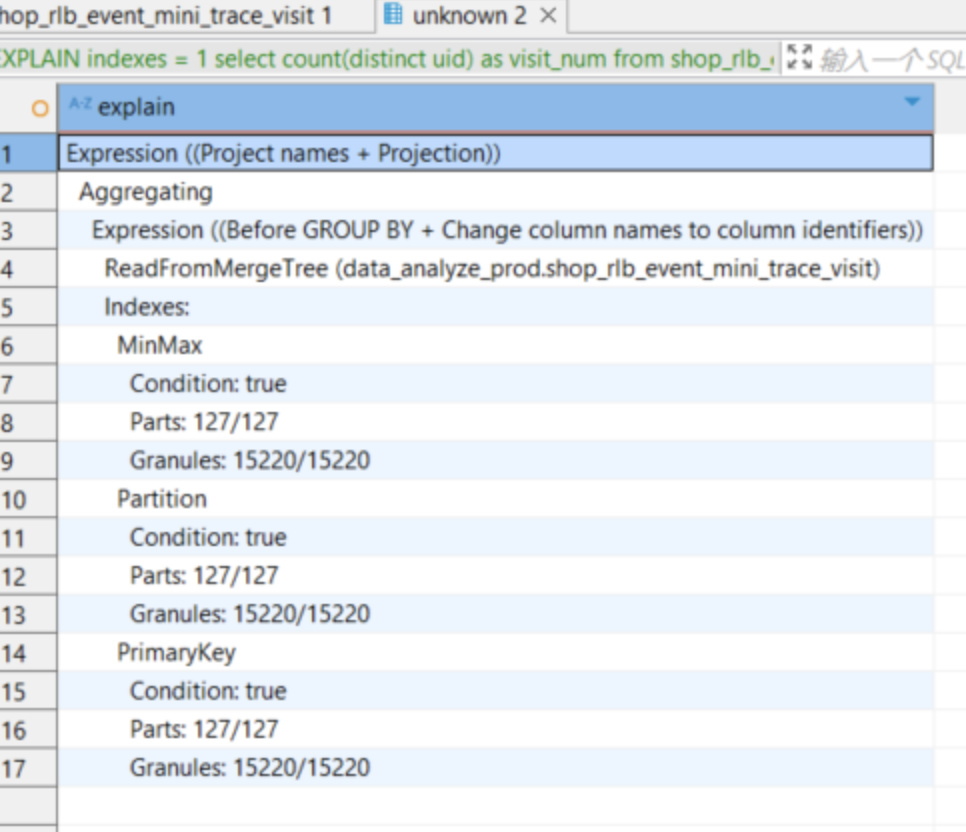
调优第三步:回归代码
- 过程:查看代码,分析业务是否可以使用日期参数过滤。
- 通过层层代码检查,发现这个统计用户数据,是根据某个活动进行查询已访问人数。
- 既然有活动,那么必然就有活动开始时间,那么就可以使用活动开始时间作为我们查询条件之一。那么我们先验证下假设有时间参数下,sql的执行情况
- 结论:有时间参数的情况下,执行耗时仅0.26s;查看执行计划,仅扫描了17个分区,比原来扫描127个分区大大减少了查询时间
sql
select count(distinct uid) as visit_num
from shop_rlb_event_mini_trace_visit
    PREWHERE
    params like '{"id":"3703"%'
        and mid = 'rpq5w'
        and store_id = '122'
        and url = 'package-gn/pages/activity/gnp/detail/index'
        and date_create >= '2025-01-01';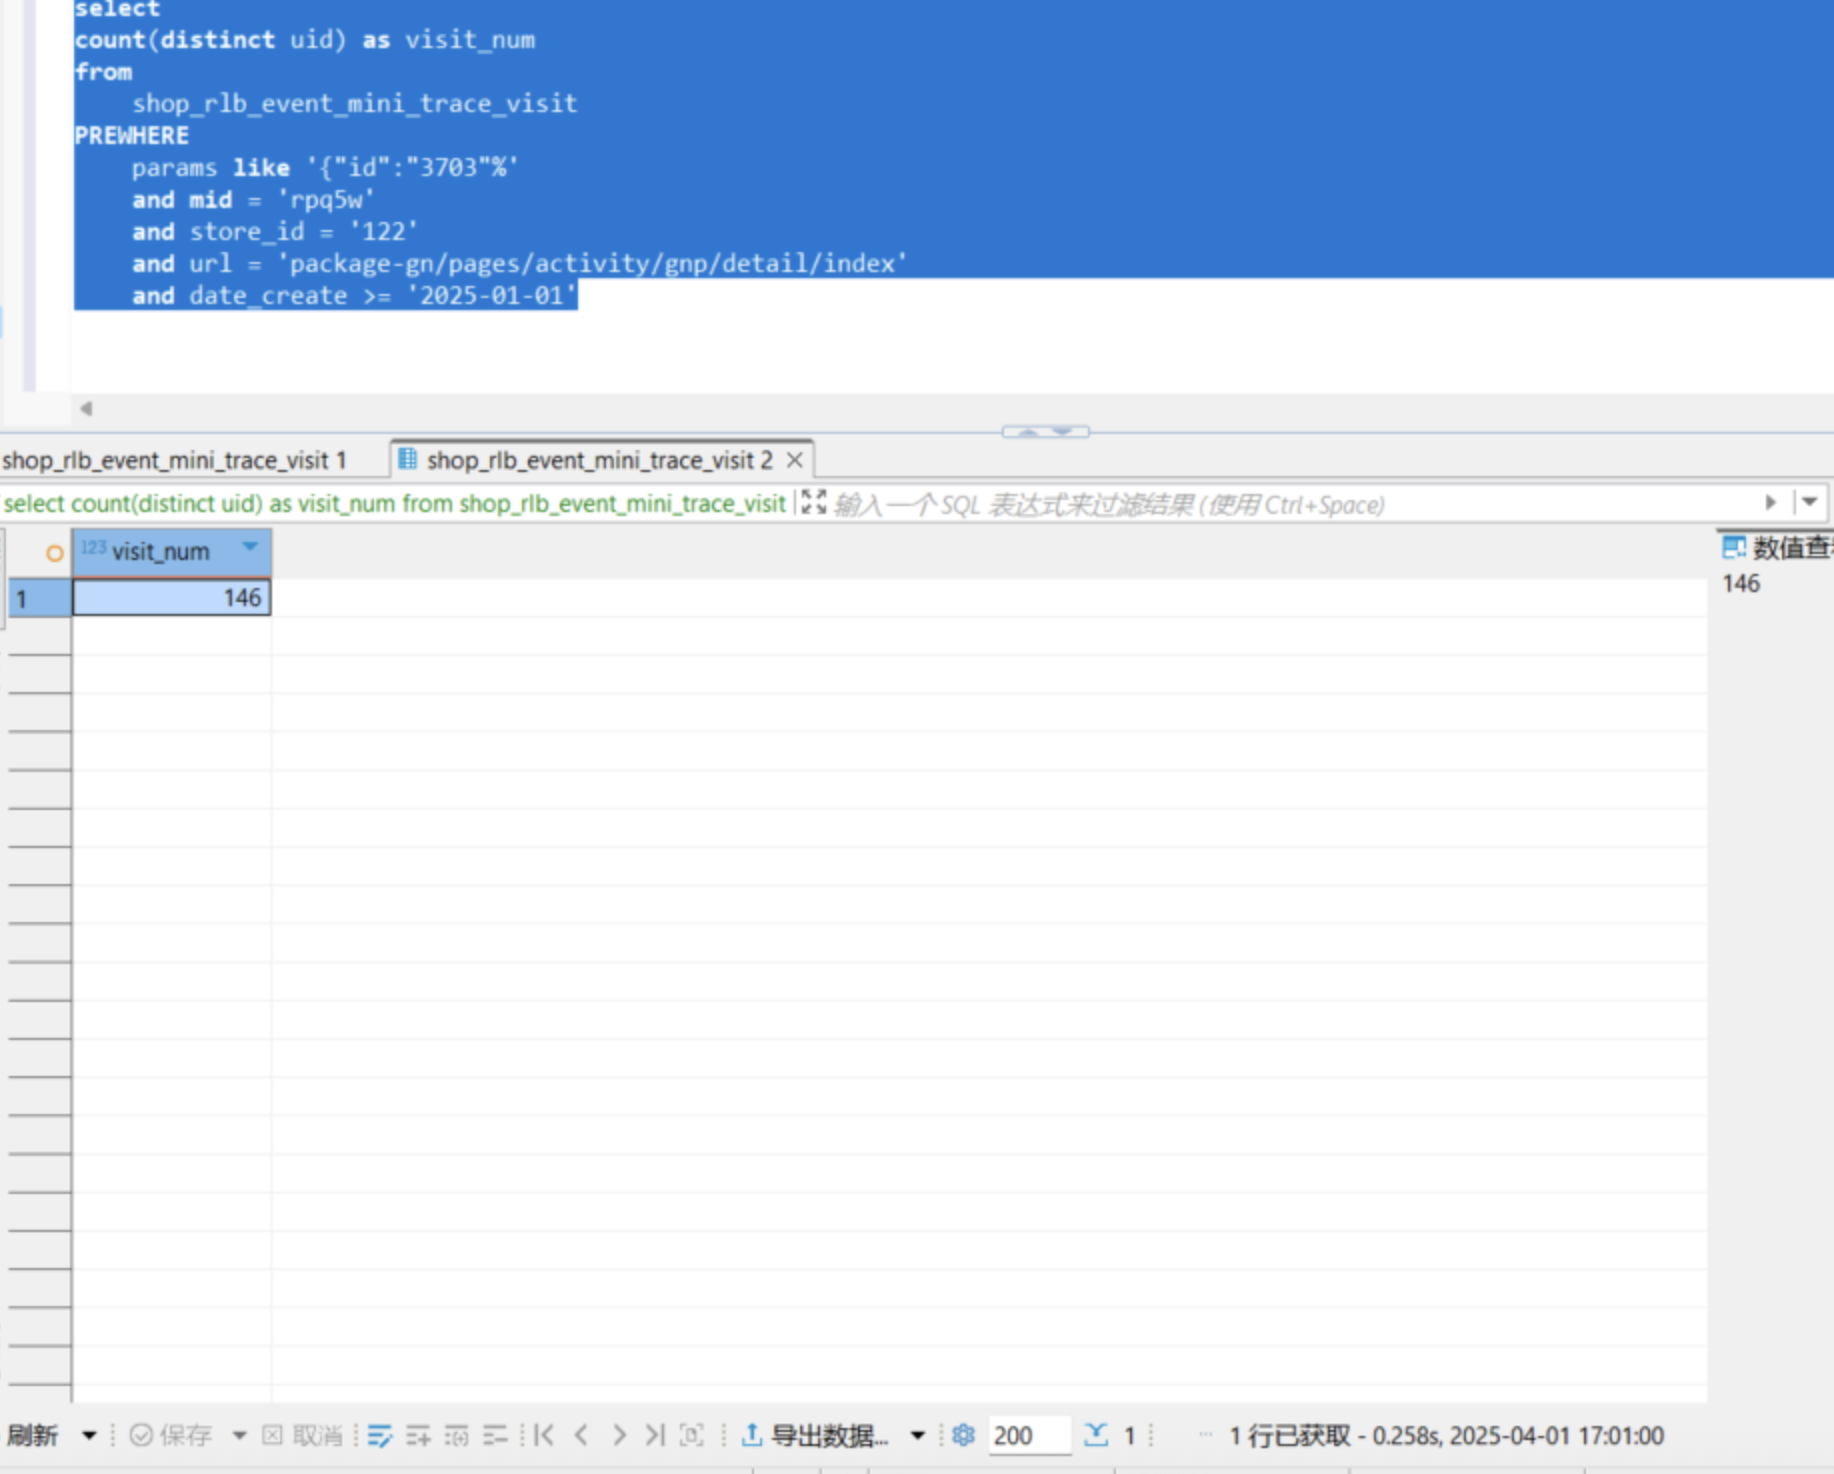
调优第四部:调整代码
加参数字段
java
# 类地址:com.xxxxx.GnTrackDataQuery

public class GnTrackDataQuery {
// 省略原有字段

/**
* 活动开始时间
*/
private String beginTime;
}
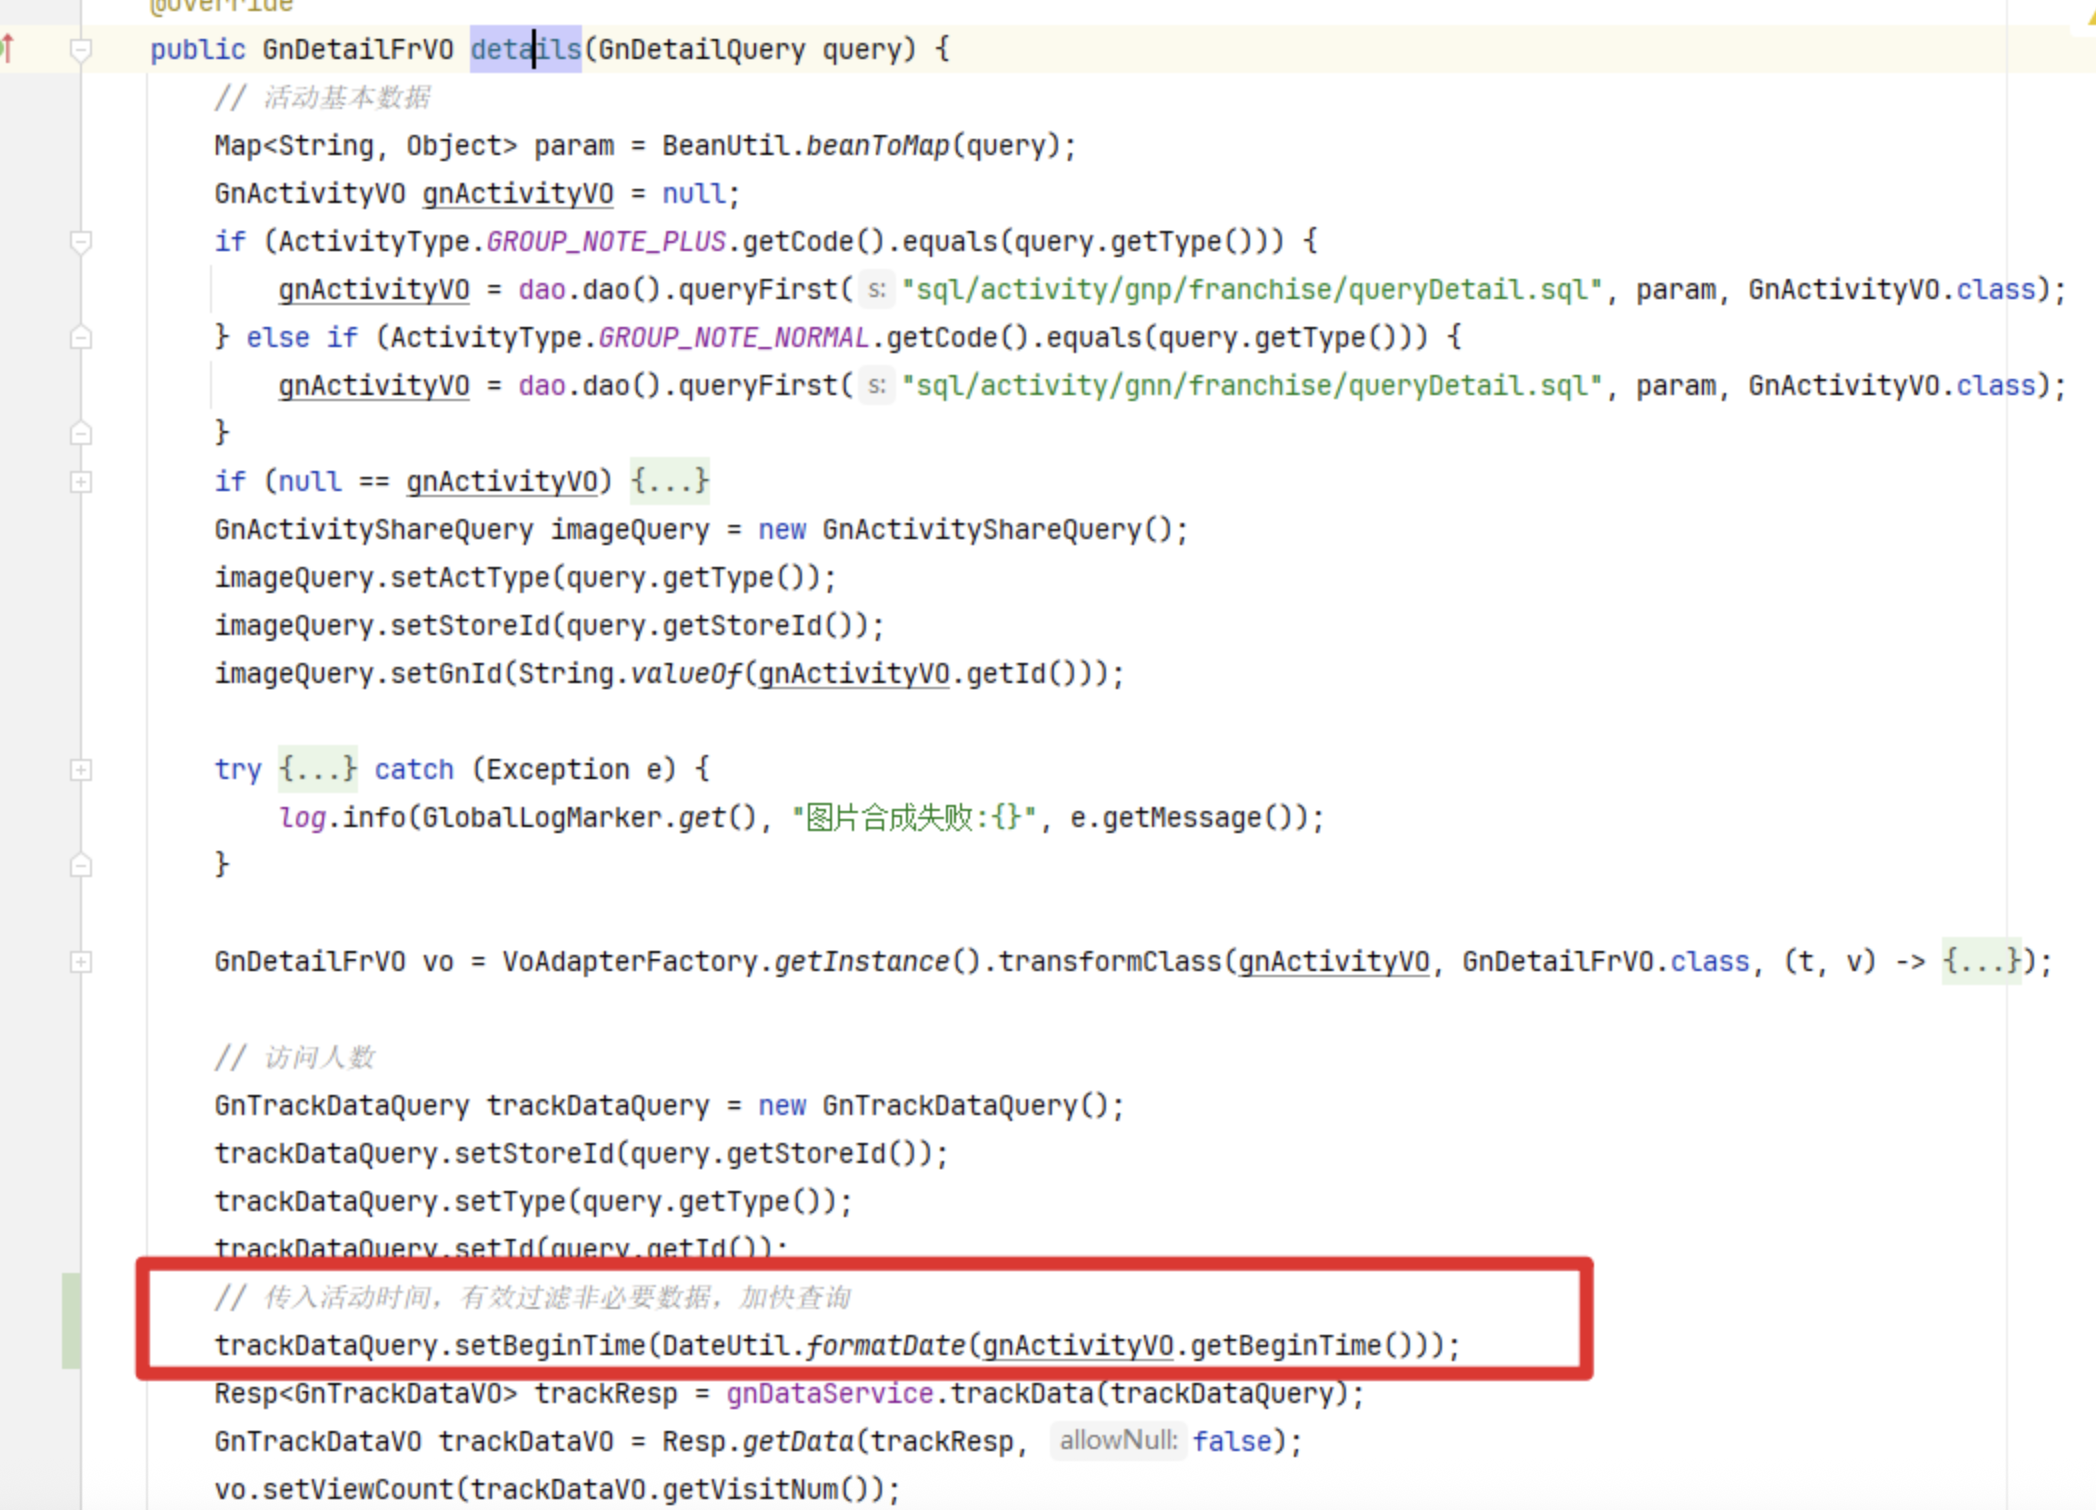
引用的代码,修改传入参数
java
# 类地址:com.xxxxx.GroupNoteFranchiseServiceImpl#details

public class GroupNoteFranchiseServiceImpl implements GroupNoteFranchiseService {
    public GnDetailFrVO details(GnDetailQuery query) {
        // 省略原有代码

      // 传入活动时间,有效过滤非必要数据,加快查询
        trackDataQuery.setBeginTime(DateUtil.formatDate(gnActivityVO.getBeginTime()));
  }
}
修改查询的sql语句
sql
-- 文件地址:sql/gn/sumGnActivity.sql

-- 修改where为PREWHERE
-- 修改参数顺序
-- 加入日期参数

select count(distinct uid) as visit_num
from shop_rlb_event_mini_trace_visit
PREWHERE params like #{content}
and mid = #{mid}
and store_id = #{storeId}
and url = #{url}
and date_create >= #{beginTime}
总结
最终经过以上分析调整,我们从最开始的2.2s降低到0.2s。性能提升超过 10 倍。优化的关键点如下:
- 调整
WHERE查询顺序,利用PREWHERE提前过滤数据。 - 使用
EXPLAIN分析执行计划,减少分区扫描。 - 结合业务逻辑,增加时间筛选条件,显著降低查询范围。
- 调整 Java 代码,确保 SQL 查询传递有效参数,避免全表扫描。
希望本次案例分析能对大家在 ClickHouse 优化中有所启发!
评论
0 条—
还没有评论,来说第一句